For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/muse-wonder-full-vs-gemini-4-argon-benchm-70ca5d3f.md.
El lanzamiento de Muse Wonder por parte de Meta incorpora dos modelos con nombres muy similares a un campo competitivo. Por eso, la primera ...
El lanzamiento de Muse Wonder por parte de Meta incorpora dos modelos con nombres muy similares a un campo competitivo. Por eso, la primera pregunta es especialmente práctica: ¿está analizando Muse Wonder o Muse Wonder Full?
Artificial Analysis informa puntuaciones de 52 para Wonder y de 56 para Wonder Full en el Intelligence Index v4.3, ambas con el máximo esfuerzo de razonamiento. El artículo de BAAI Hub se centra en que Full supera el resultado reportado de 53 puntos de Gemini 4 Argon. Esta es una comparación de benchmarks entre configuraciones específicas de modelos, y no una prueba de que cualquiera de las variantes de Wonder gane en todas las tareas del mundo real.
El anuncio oficial de Meta indica que Muse Wonder está disponible mediante la Meta Model API y Muse Code. Muse Wonder Full está disponible para los suscriptores de Muse Code. La empresa afirma que Wonder posteriormente impulsará experiencias en su asistente Muse, comenzando con los suscriptores.
| Modelo | Intelligence Index v4.3, esfuerzo máximo | Acceso de lanzamiento descrito por Meta |
|---|---|---|
| Muse Wonder | 52 | Meta Model API y Muse Code |
| Muse Wonder Full | 56 | Suscripción a Muse Code |
Estas distinciones son importantes al intentar reproducir un resultado publicado. Acceder a Wonder mediante la API no es lo mismo que evaluar Full a través del producto de programación.
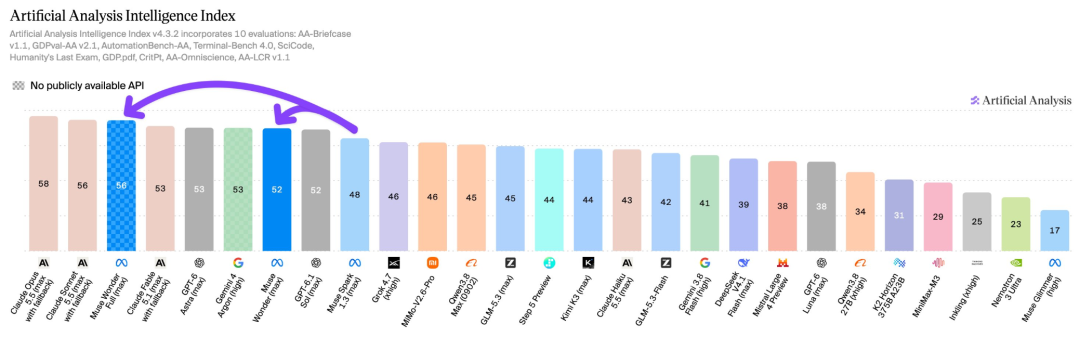
Gráfico: Artificial Analysis, reproducido y anotado en el informe de QbitAI en BAAI Hub. Refleja la comparación de la fuente en el momento de su publicación.
Artificial Analysis también informa ventanas de contexto de un millón de tokens para ambas variantes. Su análisis de lanzamiento enumera precios de la API de Wonder de 4 USD por millón de tokens de entrada, 0,20 USD por millón de tokens de entrada en caché y 20 USD por millón de tokens de salida. Full no tiene un precio por token en ese análisis porque su acceso de lanzamiento se realiza a través de un producto por suscripción.
El artículo de BAAI destaca el acceso más restringido de Gemini 4 Argon en el momento del informe. La disponibilidad puede cambiar rápidamente, por lo que este contraste histórico no debe interpretarse como una promesa sobre las reglas de acceso actuales de ninguno de los proveedores.
Meta presenta Wonder como una familia de modelos para agentes personales y profesionales. Su anuncio asigna nombres distintos a dos capacidades recurrentes.
Memoria Activa se refiere a retener información importante entre conversaciones y recuperar los detalles relevantes para una tarea nueva. Para un asistente personal, esto podría significar usar una preferencia ya establecida sin exigir al usuario que la repita cada vez.
Enfoque Activo se refiere a continuar avanzando hacia un objetivo cuando el primer intento falla. Meta describe la prueba de enfoques alternativos, la adaptación a información nueva, la solicitud de aclaraciones cuando sea necesario y la comprobación antes de realizar acciones importantes.
La programación requiere ambos tipos de comportamiento. Un agente puede necesitar conservar una restricción original mientras atraviesa varias rondas de ediciones, fallos de pruebas y revisiones. Meta afirma que los modelos Wonder se entrenaron con tareas diversas que requieren trabajo prolongado, basándose en el enfoque de escalado utilizado para Muse Spark.
La fuente contrasta sólidos benchmarks de ingeniería de software con respuestas mixtas a demostraciones de juegos en 3D. Se trata de cargas de trabajo diferentes, incluso cuando ambas requieren que el modelo escriba código.
DeepSWE 1.1 evalúa el trabajo sobre software existente, mientras que ProgramBench se refiere a crear programas desde cero. La tabla comparativa del material de lanzamiento de Meta informa 59,0 para Wonder Full y 70,5 para Claude Opus 5.5 en ProgramBench. Por lo tanto, un modelo puede liderar en un tipo de tarea de ingeniería y quedar por detrás en otro.
El informe original también describe desarrolladores que prefirieron Opus para una demostración de Unity y otro desarrollador que informó de una ejecución exitosa con Wonder Full. Son observaciones individuales con prompts, entornos y criterios de éxito diferentes. Su desacuerdo es una razón para examinar la configuración de la tarea, en lugar de promediar sus anécdotas en una clasificación universal.
Hay otra salvedad importante para las pruebas de software de larga duración: la tarjeta de modelo de Meta indica que su comparación SWE-Marathon utiliza los agentes de programación de los proveedores competidores, incluidos Codex y Claude Code. Esto hace que el resultado sea relevante para una comparación de productos de extremo a extremo, pero no es una comparación controlada en la que todos los modelos utilicen el mismo entorno de agentes.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Esto proporciona al benchmark destacado una contraparte práctica. Un modelo que produce una demostración de juego menos impresionante aún puede ser útil para una tarea de mantenimiento, y una puntuación alta en un índice no excusa una salida defectuosa.
Es la variante completa de la familia de modelos Muse Wonder de Meta. El anuncio de lanzamiento de Meta la pone a disposición de los suscriptores de Muse Code, mientras que la variante Wonder regular también cuenta con acceso mediante API.
La comparación del Intelligence Index de la fuente en el momento del lanzamiento sitúa a Wonder Full en 56 y a Gemini 4 Argon en 53. Esto describe el índice y las configuraciones específicas mostradas, no un resultado para todas las tareas o evaluaciones.
El anuncio de Meta distingue las dos vías de acceso. Enumera Wonder para la API y Muse Code, y Full para los suscriptores de Muse Code.
La cobertura de lanzamiento de Artificial Analysis enumera 4 USD por millón de tokens de entrada, 0,20 USD para entrada en caché y 20 USD para salida. Son precios informados en el momento de la publicación, así que consulte las condiciones de facturación del proveedor antes de la implementación.
La Memoria Activa se refiere a recuperar información útil de conversaciones anteriores. El Enfoque Activo se refiere a la ejecución sostenida, incluido probar otro enfoque cuando una tarea encuentra un obstáculo.
Muestran una debilidad en esas tareas y configuraciones específicas. El rendimiento más amplio de programación también incluye mantenimiento de repositorios, depuración, uso de herramientas y cumplimiento de requisitos en flujos de trabajo más largos.
Las sólidas puntuaciones de lanzamiento de Wonder Full lo convierten en una opción relevante para trabajo exigente con agentes. El modelo Wonder regular tiene una puntuación y una vía de acceso diferentes, por lo que el nombre de la variante debe acompañar cualquier afirmación sobre rendimiento.
Use las clasificaciones de benchmarks para seleccionar un candidato de prueba y, después, compare el modelo exacto en el trabajo que necesita que complete.
Empieza con una sola frase y obtén un sitio completo en minutos.



