
Podría estar acercándose otra ola de lanzamientos de modelos, según un artículo de QbitAI publicado el 21 de octubre. Su análisis aborda un modelo Claude aún no publicado, un modelo de Google llamado Carbon y un identificador GPT-6.1 Terra encontrado, según se informa, en una configuración de evaluación de Microsoft.
Se trata de distintos tipos de evidencia. Las impresiones de evaluadores privados, un nombre en el código y los resultados de evaluaciones publicados no deben tratarse como pruebas equivalentes del lanzamiento de un producto. El avance confirmado más claro de este resumen es el trabajo publicado por separado por OpenAI sobre lenguajes de programación con menor nivel de soporte.
Según los informes, un modelo Claude no publicado va más allá de los errores individuales
QbitAI atribuye su información sobre Claude a The Information. Según ese informe, un usuario inicial describe una mejor capacidad de razonamiento y una mayor habilidad para inferir el objetivo que hay detrás de una solicitud.
El ejemplo de programación se centra en el diagnóstico de la causa raíz: en lugar de abordar únicamente un error reportado, el modelo supuestamente reconoce una fuente más amplia de fallos similares y pregunta si el usuario quiere resolver esa clase de problema. Preguntar antes de ampliar el alcance de un cambio es una parte relevante del ejemplo, especialmente en un repositorio donde una corrección más amplia podría afectar a comportamientos no relacionados.
El informe también describe respuestas menos convencionales a preguntas abiertas. Su ejemplo de selección de acciones es una anécdota sobre la generación de un enfoque nuevo, no una prueba de rendimiento de inversión. No se proporcionan rendimientos validados, un índice financiero de referencia ni un algoritmo de trading listo para implementarse.
La identidad del modelo sigue sin resolverse en la fuente. Nombres como Fable y Opus aparecen como posibilidades, no como nombres de lanzamiento confirmados. Tampoco existe una evaluación reproducible que establezca la magnitud de la mejora afirmada.
Gemini Carbon y los límites de los comentarios internos
La siguiente parte se refiere al supuesto modelo interno Carbon de Google. El informe proporcionado afirma que mejora con respecto a Argon en programación y que mantiene un buen rendimiento en tareas visuales, como analizar vídeos o examinar el comportamiento de interfaces front-end.
También indica que los empleados probaron Carbon mediante una plataforma interna de programación llamada Jetski y compararon favorablemente la experiencia con Opus 5.5. Se trata de impresiones informales obtenidas en un entorno interno. Las diferencias en las instrucciones, el acceso a herramientas y las condiciones de prueba impiden establecer una clasificación general de modelos.
QbitAI describe Argon, Barium y Carbon como nombres internos de desarrollo, y afirma que una versión Barium-B terminó convirtiéndose en el modelo presentado públicamente como Argon. Esa historia de nombres se incluye aquí como parte del relato de la fuente; una etiqueta interna por sí sola no establece la línea exacta de entrenamiento de un modelo público.
El artículo analiza después una publicación en redes sociales que menciona la auto-mejora recursiva, o RSI. Interpreta el momento de la publicación como una posible pista sobre Carbon. Una publicación social no demuestra que Carbon se haya entrenado mediante RSI, ni la fuente proporciona una descripción técnica de un sistema de ese tipo. Su explicación relacionada con datos de entrenamiento de YouTube tampoco está respaldada por una divulgación verificada sobre el entrenamiento en los materiales consultados para este artículo.
El nombre GPT-6.1 Terra aparece en una captura de una evaluación
El artículo proporcionado muestra una publicación de Lumina en la que se describe una solicitud de extracción de Microsoft que supuestamente sustituye la configuración de evaluación de GPT-5.6 Terra por la de GPT-6.1 Terra. La captura adjunta muestra gpt-6.1-terra como modelo juez predeterminado.
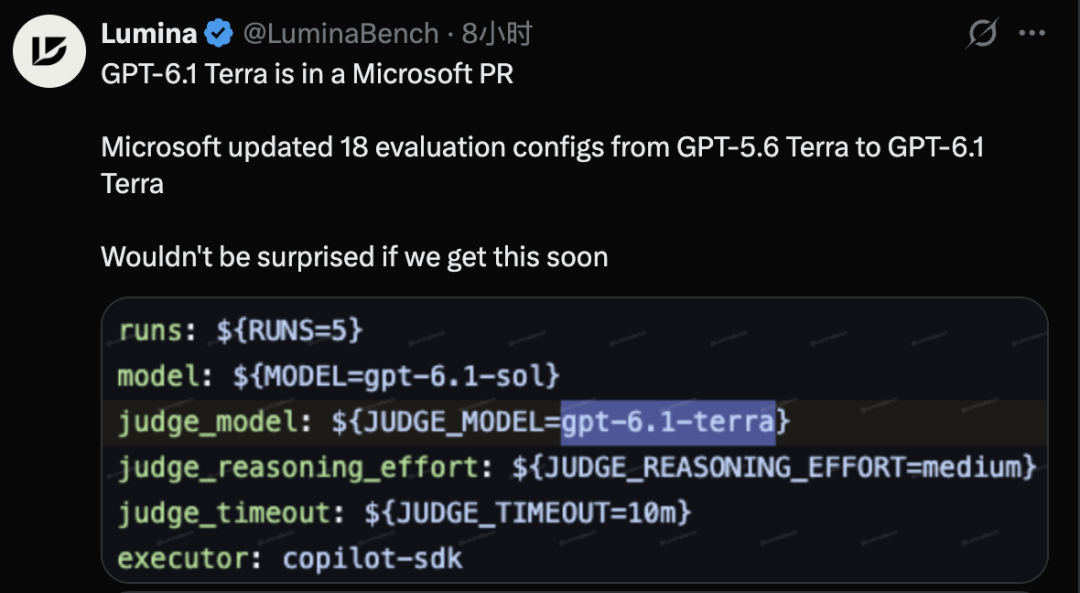
Captura de la fuente: publicación de Lumina reproducida por QbitAI y BAAI Hub.
Una cadena de configuración es una evidencia útil de que se ha utilizado un nombre. No demuestra que exista un endpoint disponible públicamente, un precio, una fecha de lanzamiento ni un nivel de capacidades. El catálogo público de modelos de OpenAI consultado para este artículo no incluía una entrada confirmada para GPT-6.1 Terra.
La fuente utiliza este hallazgo para cuestionar la teoría de que GPT-6.1 Sol fuera simplemente Terra con otro nombre. Ni una captura de pantalla ni las especulaciones sobre los nombres bastan para reconstruir las decisiones de entrenamiento o de producto de los modelos.
Algunas reacciones del artículo son despectivas; otras sugieren que un modelo más barato podría permitir una integración más amplia de ChatGPT y los flujos de trabajo de programación. Esa estrategia de producto sigue siendo una interpretación de este informe, no un plan de lanzamiento confirmado ni una garantía de acceso mediante un nivel gratuito.
Avances confirmados en COBOL y otros lenguajes con pocos recursos
El anuncio de investigación de OpenAI del 19 de octubre describe dos evaluaciones: crear software compatible con SQLite en 20 lenguajes y migrar COBOL conservando su comportamiento. Aquí, “con pocos recursos” se refiere a la relativa escasez de código y documentación disponibles para el entrenamiento, no a la importancia de un lenguaje ni a sus requisitos informáticos.
Crea un sitio de presentacion y capta leads en minutos
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
En la evaluación de migración de COBOL, GPT-6.1 Sol alcanza el 86,6 % con un nivel bajo de razonamiento, frente al 5,4 % de GPT-5.6 Sol con la misma configuración. OpenAI informa de un 97,9 % con un nivel de razonamiento más alto. Estos son resultados obtenidos en su evaluación, no tasas de éxito prometidas para migraciones bancarias arbitrarias.
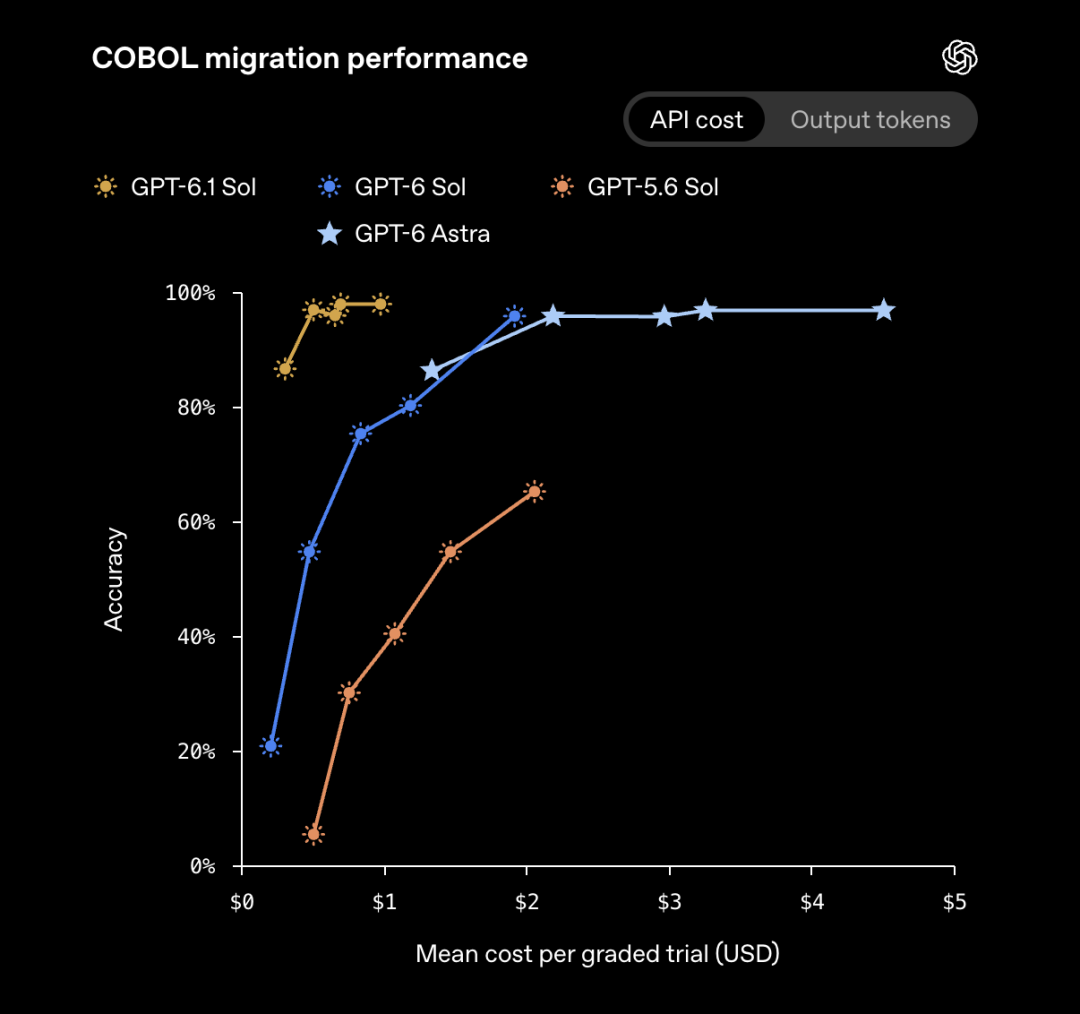
Crédito del gráfico: OpenAI, reproducido en el artículo proporcionado.
La conservación del comportamiento es importante porque un programa puede compilarse y aun así modificar el redondeo, el tratamiento de registros o los resultados observables. Al aplicar una migración a un sistema real, siguen siendo necesarias la revisión de expertos y las pruebas representativas.
La fuente concluye anticipando nuevos lanzamientos de modelos chinos, incluidos Kimi, GLM y MiniMax, después de la renovada actividad de DeepSeek. No proporciona un calendario completo y confirmado de lanzamientos, por lo que esas expectativas deben mantenerse abiertas y no presentarse como lanzamientos programados.
Preguntas frecuentes
¿Se ha identificado oficialmente el nuevo modelo Claude?
El artículo proporcionado no establece su nombre público definitivo. Sus descripciones de capacidades proceden de una prueba privada divulgada por terceros, no de una especificación de lanzamiento verificada.
¿Gemini Carbon es un lanzamiento público confirmado?
La fuente describe un modelo interno y los comentarios de empleados. No proporciona una fecha de lanzamiento público verificada ni un endpoint de Carbon accesible.
¿La publicación sobre RSI demuestra que Carbon puede mejorarse a sí mismo?
No. Ninguna evidencia técnica del informe proporcionado demuestra esa afirmación. El artículo relaciona un comentario en redes sociales con los informes sobre el modelo, lo que sigue siendo una inferencia.
¿GPT-6.1 Terra está disponible mediante la API de OpenAI?
El hallazgo en el código no demuestra la disponibilidad de la API. El catálogo oficial consultado para este artículo no confirmó un lanzamiento público de GPT-6.1 Terra.
¿Qué puntuación obtuvo GPT-6.1 Sol en la migración de COBOL?
OpenAI informa de un 86,6 % con un nivel bajo de razonamiento y un 97,9 % con un nivel más alto. Estas cifras describen las condiciones de su evaluación, no una garantía universal de migración.
¿Pueden implementarse inmediatamente las migraciones de código heredado generadas por IA?
La generación o compilación exitosa no basta para demostrar que el comportamiento sea equivalente. Los equipos aún necesitan pruebas que cubran las reglas de negocio, los formatos de datos y las dependencias del sistema, además de una revisión experta.
Herramientas relacionadas
- Claude: plataforma de asistente de Anthropic, distinta de la identidad no confirmada del modelo descrito en este informe.
- Gemini: servicio público de asistente de Google, independiente de las pruebas internas mencionadas.
- Catálogo de modelos de OpenAI: documentación oficial para comprobar los identificadores de modelos publicados.
Enlaces relacionados
- Artículo proporcionado de QbitAI en BAAI Hub: fuente del resumen de informes sobre modelos y de las capturas de pantalla.
- Investigación de OpenAI sobre lenguajes con pocos recursos: fuente principal de las cifras de evaluación de COBOL.
- Catálogo de modelos publicado por OpenAI: referencia para comprobar los modelos disponibles, en lugar de inferir su disponibilidad a partir de filtraciones.
- Primera referencia social citada por QbitAI: referencia social original incluida por el artículo proporcionado; sus afirmaciones subyacentes no fueron autenticadas de forma independiente aquí.
- Segunda referencia social citada por QbitAI: otra referencia proporcionada por el artículo, no un anuncio oficial de lanzamiento.
Resumen
El resumen apunta a posibles nuevos modelos de Claude y Gemini, así como a un identificador Terra en código de evaluación. Su marca definitiva, disponibilidad y rendimiento comparativo siguen siendo inciertos según la evidencia disponible.
El resultado confirmado es más limitado: OpenAI ha publicado mejores puntuaciones de evaluación para lenguajes heredados, mientras que las afirmaciones de lanzamiento que rodean esta información aún requieren confirmación oficial.


