For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/nvidia-aspire-v1-0-robot-debugging-skills-a8a0a489.md.
NVIDIA ha lanzado ASPIRE V1.0, un marco de robótica que convierte los fallos de ejecución en material para el siguiente intento. Un agente d...
NVIDIA ha lanzado ASPIRE V1.0, un marco de robótica que convierte los fallos de ejecución en material para el siguiente intento. Un agente de programación escribe un programa de control para robots, lo ejecuta, inspecciona lo ocurrido y corrige el código. Las correcciones validadas pueden convertirse en entradas reutilizables de una biblioteca de habilidades.
ASPIRE significa Agentic Skill Programming through Iterative Robot Exploration (programación agentiva de habilidades mediante exploración robótica iterativa). Su idea central es que la experiencia puede acumularse como conocimiento operativo recuperable, sin necesidad de codificar cada mejora en nuevos pesos del modelo mediante entrenamiento.
El lanzamiento también destaca la importancia del modelo de razonamiento subyacente. QbitAI informa de una mejora notable después de que el equipo conectara GPT-6 Astra. Los materiales actuales de NVIDIA muestran resultados sólidos con varios modelos de vanguardia, manteniendo el motor de ejecución y el mecanismo de habilidades.
Un agarre fallido no revela por sí solo la causa. Es posible que el objeto se haya localizado de forma incorrecta, que el candidato de agarre no sea adecuado, que el brazo no pueda alcanzar el objetivo o que el movimiento planificado colisione con el entorno.
El motor de ejecución de ASPIRE registra evidencias relacionadas con las llamadas de percepción, planificación, agarre y control. Esto incluye observaciones, entradas y salidas, así como evidencias visuales cuando están disponibles. El agente puede inspeccionar la parte pertinente de este registro multimodal en lugar de tratar el fallo final como su única fuente de información.
El ciclo de trabajo es sencillo:
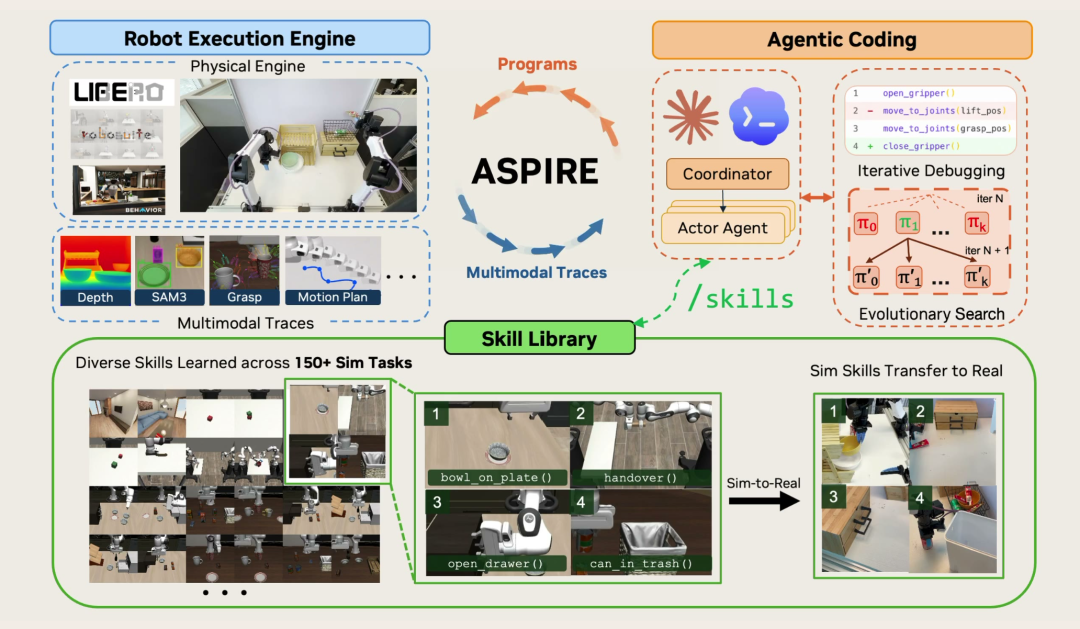
Diagrama del método ASPIRE, atribuido al equipo de investigación y reproducido en el informe de origen.
El marco también explora programas alternativos mediante búsqueda evolutiva. En lugar de ajustar repetidamente un único enfoque fallido, los agentes pueden probar distintas secuencias, planificadores o estrategias de agarre y conservar después los enfoques que superen las comprobaciones de ejecución.
Por ejemplo, recoger un objeto situado a baja altura puede requerir cambiar la posición del robot, cambiar de brazo o probar otro planificador de movimiento. El resultado útil es tanto un programa corregido como una explicación de las circunstancias en las que se aplica la corrección.
Una solución puntual ayuda con una tarea. Una habilidad recuperable puede ayudar con tareas posteriores que compartan la misma dificultad subyacente.
ASPIRE destila las correcciones validadas en conocimiento robótico basado en texto. Para una tarea futura, el agente recupera las entradas pertinentes y las utiliza como orientación contextual al crear un programa nuevo. Esto es distinto de limitarse a reproducir una trayectoria anterior con coordenadas fijas.
La fuente describe una biblioteca presentada en pantalla con más de 90 habilidades, que cubren más de 150 tareas en 18 categorías. Estas categorías abarcan percepción, agarre, navegación, búsqueda de objetos, manipulación con dos brazos y recuperación. NVIDIA describe el explorador público como una muestra representativa, no como un inventario exhaustivo.
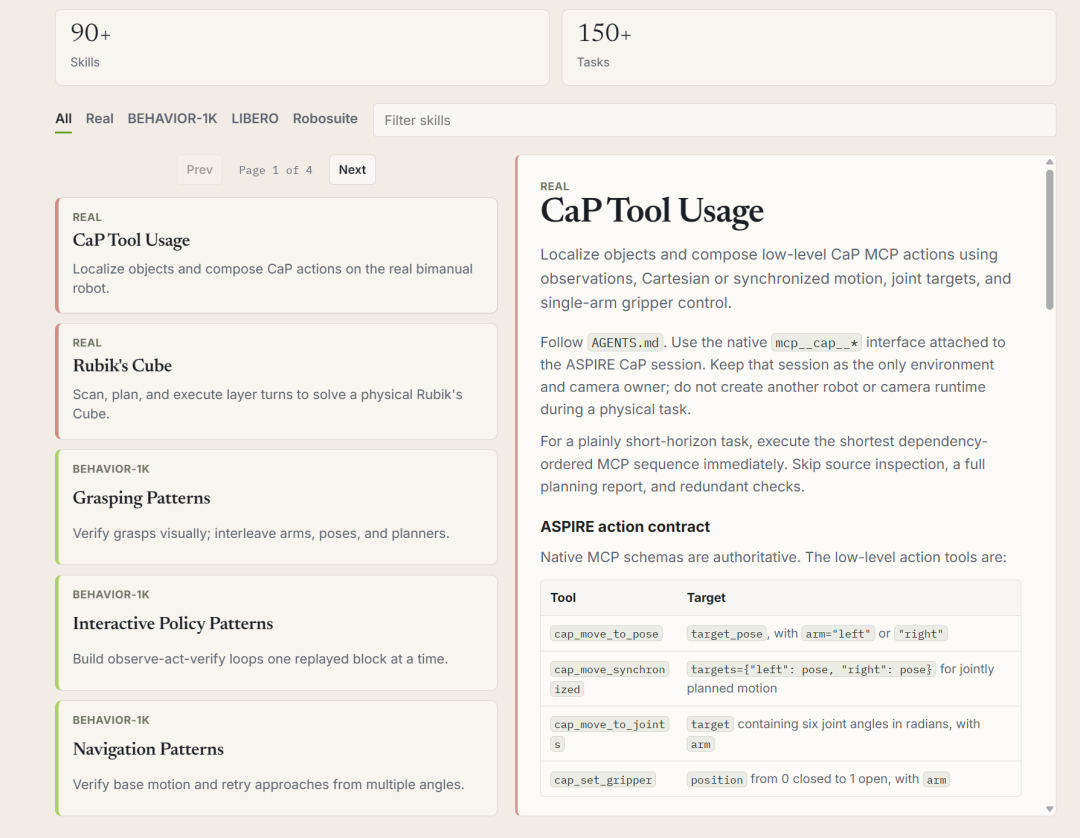
Interfaz de la biblioteca de habilidades mostrada en el informe de origen.
El proyecto informa de un 31 % de éxito sin entrenamiento previo en tareas representativas inéditas y de larga duración, frente al 4 % de métodos anteriores que empleaban un razonamiento considerable durante la prueba y varios reintentos. Este resultado corresponde a una configuración de evaluación concreta; no es una tasa de éxito universal para tareas domésticas nuevas.
Los investigadores también informan de una transferencia inicial entre distintas configuraciones robóticas, de la simulación a robots reales. Recuperar una habilidad aplicable descubierta en simulación redujo la cantidad de tokens necesaria para obtener el primer programa exitoso en un robot real y mejoró el éxito de ese programa en tareas no vistas durante el entrenamiento. Esto no demuestra que todas las habilidades simuladas se transfieran sin cambios a todos los robots o API.
El informe original describe cómo el equipo sustituyó su backend anterior, Claude Opus 4.6, por GPT-6 Astra y observó un gran salto en los resultados de simulación. El anuncio de Jim Fan también señala que Claude Opus 5.5 superó ligeramente a Astra y que Sonnet 5.5 ofrecía una relación favorable entre coste y capacidad, con un coste de unos 12 dólares por tarea en esa comparación.
La página oficial actual del proyecto informa de estos resultados principales con Claude Opus 5.5:
| Evaluación | Resultado informado por el proyecto | Alcance |
|---|---|---|
| LIBERO-Pro | 99 % de éxito promedio | Las 80 tareas evaluadas |
| Robosuite | 100 % de éxito en tareas representativas | Tareas seleccionadas, no toda la batería |
| BEHAVIOR-1K | 100 % de éxito en tareas representativas | Tareas seleccionadas, no las 1.000 actividades |
La fuente identifica siete tareas representativas de Robosuite y dos de BEHAVIOR-1K. Esos denominadores son importantes: no debe describirse el resultado como si ASPIRE hubiera resuelto todo BEHAVIOR-1K.
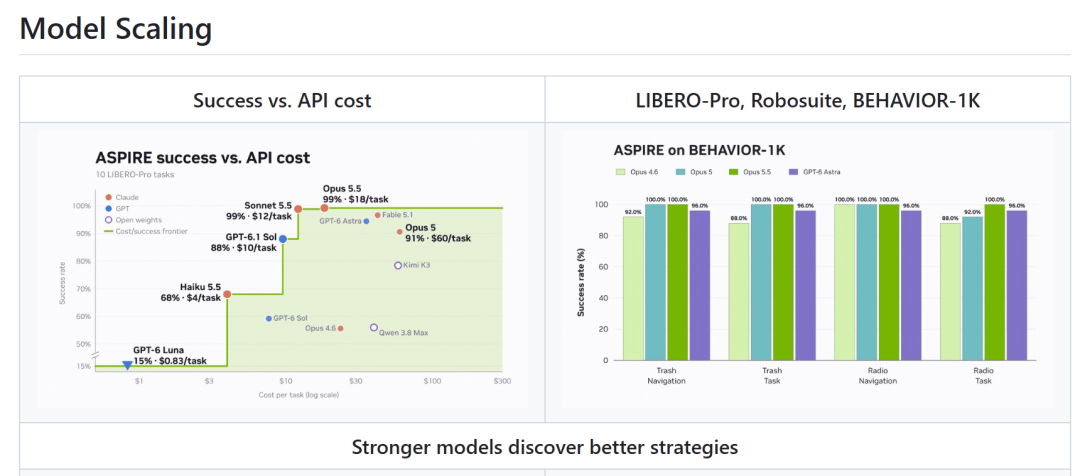
Comparación del escalado de modelos de ASPIRE, tal como aparece en el informe.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Un experimento independiente de escalado de modelos en el repositorio evalúa 10 tareas de LIBERO-Pro e informa de tasas de éxito de entre el 15 % y el 99 % según el modelo. Este experimento no debe confundirse con el resultado de las 80 tareas.
La idea práctica es que las herramientas de percepción, las interfaces de control y las habilidades acumuladas pueden seguir siendo útiles aunque cambie el modelo. El proyecto presenta esto como una versión robótica del patrón más amplio según el cual un razonamiento general más potente mejora un sistema de agentes existente.
El repositorio público incluye código, configuraciones, habilidades para agentes y guías de reproducción de experimentos. El material del proyecto propiedad de NVIDIA y las contribuciones están disponibles bajo Apache 2.0; los componentes de terceros conservan sus propias condiciones.
El repositorio distingue entre los experimentos de simulación y la operación con robots reales. La configuración de simulación requiere preparar el equipo anfitrión, lo que incluye CUDA, uv y acceso a los pesos de SAM3, cuyo acceso está restringido. Reproducir un experimento también requiere elegir la batería, el conjunto de tareas, la secuencia de semillas y las rutas de salida, en lugar de dar por supuesto que un único comando genérico recrea todos los resultados publicados.
Importante: el README indica que el código Python generado tiene acceso completo a las importaciones y que los procesos de prueba y los supervisores no constituyen un entorno aislado de seguridad. Las indicaciones oficiales recomiendan usar un equipo anfitrión aislado y establecer autorizaciones y controles independientes para el hardware físico. Una ejecución satisfactoria en simulación no basta para preparar una operación real sin supervisión.
El proyecto también enumera limitaciones aún sin resolver: detección fiable del éxito, reinicios seguros, supervisión de seguridad, calibración, una API de primitivas fija, búsqueda costosa y una gestión incompleta de la memoria de habilidades a largo plazo. A medida que crece la colección, las entradas de la biblioteca pueden quedar obsoletas o ser demasiado específicas.
El informe concluye con un desarrollo independiente de World Labs. Su publicación oficial confirma que ha comenzado el despliegue gradual del acceso beta a Atlas, con una demostración centrada en el control preciso de la trayectoria de cámara.
QbitAI también informa de resultados de 1440p de un minuto de duración, reconstrucción a partir de imágenes o vídeos de teléfono, salidas de nubes de puntos y Gaussian splats, y simulación RGB/profundidad para robótica. La breve publicación oficial disponible para este artículo no confirmó de forma independiente esas especificaciones detalladas.
La generación de entornos y el aprendizaje de habilidades robóticas podrían ser líneas de investigación complementarias. Las fuentes revisadas aquí no anuncian una integración entre ASPIRE y Atlas; por tanto, esa combinación sigue siendo una posibilidad sugerida por el informe, no un flujo de trabajo publicado.
ASPIRE es un marco de robótica que utiliza agentes de programación para escribir, ejecutar y depurar programas de control para robots. Guarda conocimientos validados como habilidades reutilizables para tareas posteriores.
El proyecto pone el énfasis en perfeccionar habilidades y acumular conocimiento operativo, en lugar de actualizar mediante gradientes el modelo subyacente. Un modelo de vanguardia cuyos pesos permanecen congelados puede recuperar esas habilidades y utilizarlas al escribir programas nuevos.
No. El resultado del 100 % corresponde a tareas representativas seleccionadas de BEHAVIOR-1K, no a toda la colección de actividades. La cifra del 99 % de LIBERO-Pro tiene otro alcance: 80 tareas evaluadas.
El proyecto evalúa varios modelos de vanguardia y describe el marco como independiente del agente de programación. El éxito y el coste siguen dependiendo del modelo, la tarea y la configuración del experimento; la compatibilidad por sí sola no garantiza resultados equivalentes.
Los investigadores informan de indicios iniciales de que algunas habilidades descubiertas en simulación reducen el esfuerzo de depuración en robots reales con distintas configuraciones físicas y API. La operación física sigue requiriendo calibración, supervisión, reinicios seguros y verificación de resultados.
El proyecto oficial afirma explícitamente que todavía no es un sistema autónomo de aprendizaje en el mundo real. Su README también distingue el uso en simulación de los controles operativos necesarios para el hardware real.
ASPIRE conecta los registros de ejecución de robots con un ciclo de programación y depuración, y después guarda las correcciones validadas como conocimiento reutilizable. El lanzamiento permite inspeccionar ese flujo de trabajo mediante el código, las guías de ejecución y un explorador de habilidades.
Sus resultados muestran un escalado prometedor de los modelos y una transferencia inicial de habilidades, con límites importantes en cuanto a la cobertura de los benchmarks y el despliegue físico. El ciclo de habilidades reutilizables es la contribución central; los resultados casi perfectos en benchmarks seleccionados no eliminan la necesidad de realizar evaluaciones controladas en el mundo real.
Empieza con una sola frase y obtén un sitio completo en minutos.



