For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/nvidia-vera-rubin-at-ocp-2026-mgx-1-2-dsx-6b3d7f12.md.
A medida que las fábricas de IA crecen desde infraestructuras de megavatios hacia instalaciones de escala gigavatio, el desafío ya no se lim...
A medida que las fábricas de IA crecen desde infraestructuras de megavatios hacia instalaciones de escala gigavatio, el desafío ya no se limita a incorporar aceleradores más rápidos en un centro de datos. La distribución eléctrica, la refrigeración líquida, las redes, la capacidad de mantenimiento, el comportamiento de la red eléctrica y los diseños de racks interoperables deben escalar de forma conjunta.
En la Cumbre Global 2026 del Open Compute Project en San José, NVIDIA anunció un conjunto de alianzas, especificaciones abiertas y contribuciones de software diseñadas para crear una base más común para la infraestructura de IA de próxima generación.
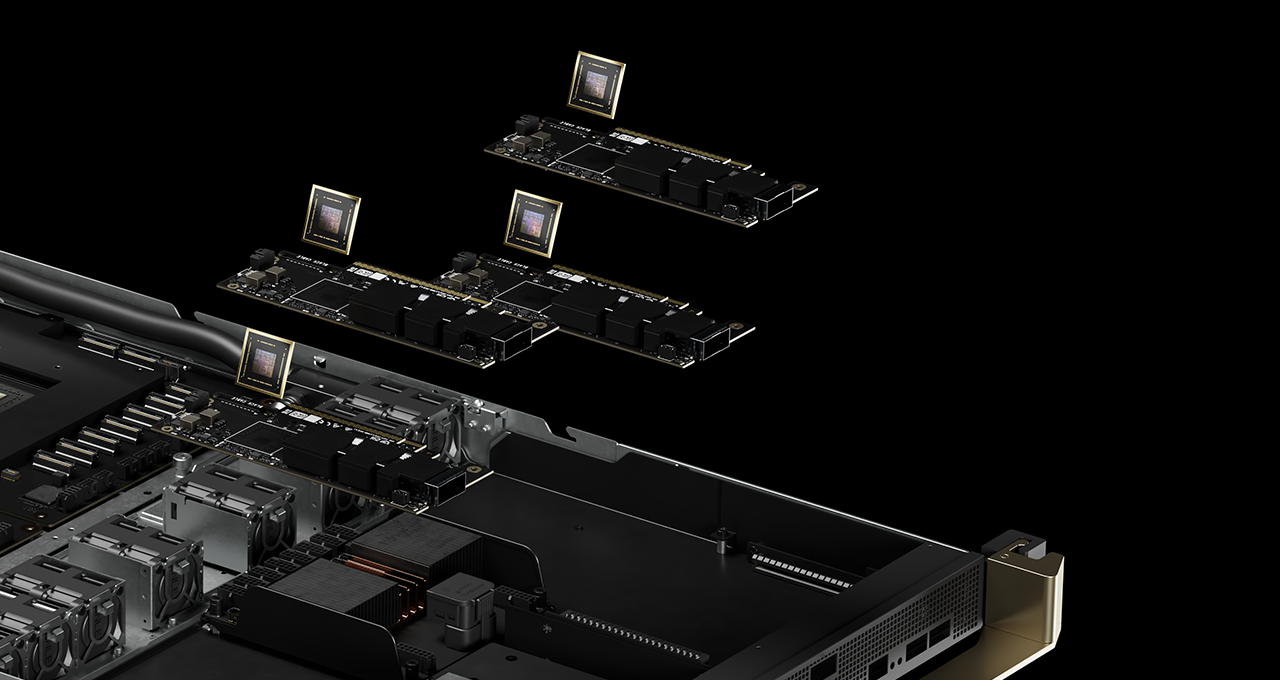
La pieza central es NVIDIA Vera Rubin. NVIDIA aportó diseños clave de racks y bandejas de cómputo de Vera Rubin a OCP a través de la arquitectura abierta NVIDIA MGX, lo que permite a los fabricantes de sistemas y socios de infraestructura trabajar a partir de un diseño de referencia compartido en lugar de construir cada capa de forma independiente.
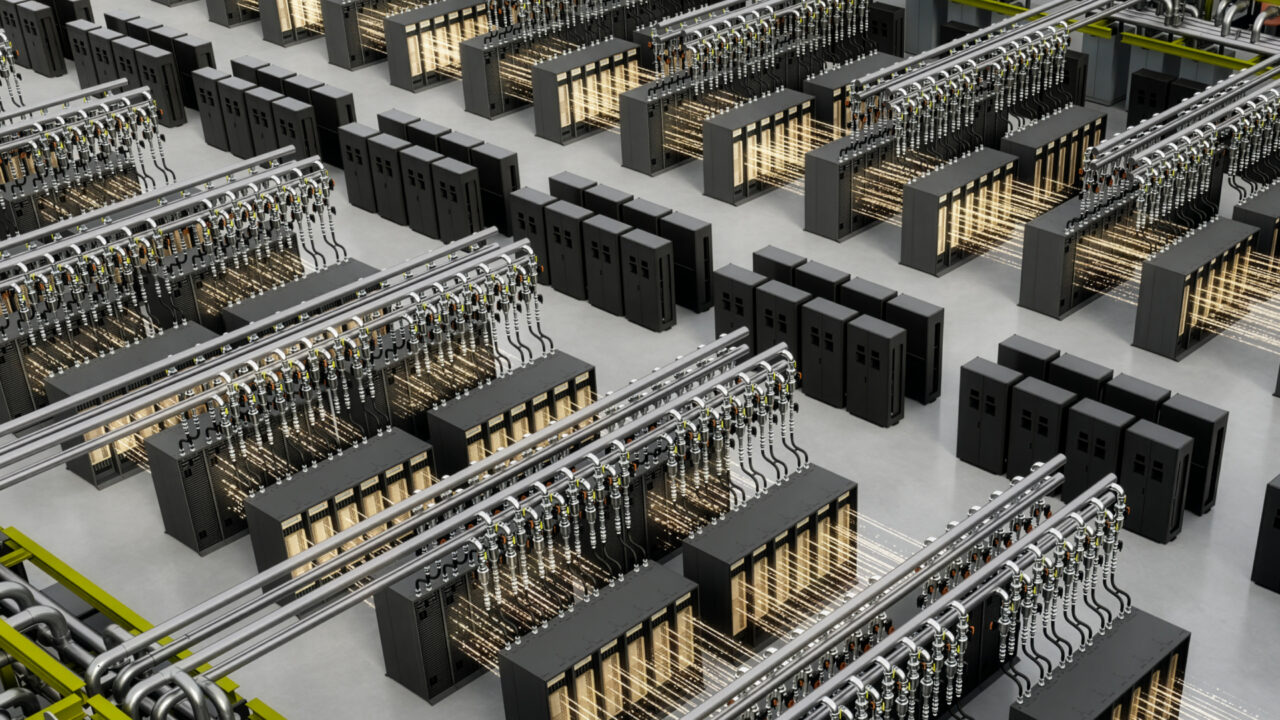
Los anuncios abarcan tres capas conectadas de la fábrica de IA:
El resultado es un impulso más amplio hacia una infraestructura abierta y repetible que los socios puedan fabricar, implementar y mantener a escala global.
En la Cumbre Global de OCP 2026, NVIDIA y sus socios del ecosistema anunciaron varias iniciativas de infraestructura en torno a Vera Rubin.
Los anuncios clave incluyen:
En el evento, Ian Buck, vicepresidente de Hyperscale y High-Performance Computing de NVIDIA, describió la infraestructura abierta como una parte cada vez más importante para escalar fábricas de IA en todo el mundo.
El hilo conductor de los anuncios es el codiseño. El cómputo, las redes, la energía, la refrigeración y el software se están tratando como partes de un único sistema, en lugar de capas aisladas.
NVIDIA se unió a otros participantes de la industria para contribuir al diseño de referencia de centro de datos de IA MGX de tercera generación a través de la Open DC Initiative de OCP.
La especificación actualizada MGX 1.2 amplía la arquitectura para fábricas de IA de mayor potencia y refrigeración líquida.
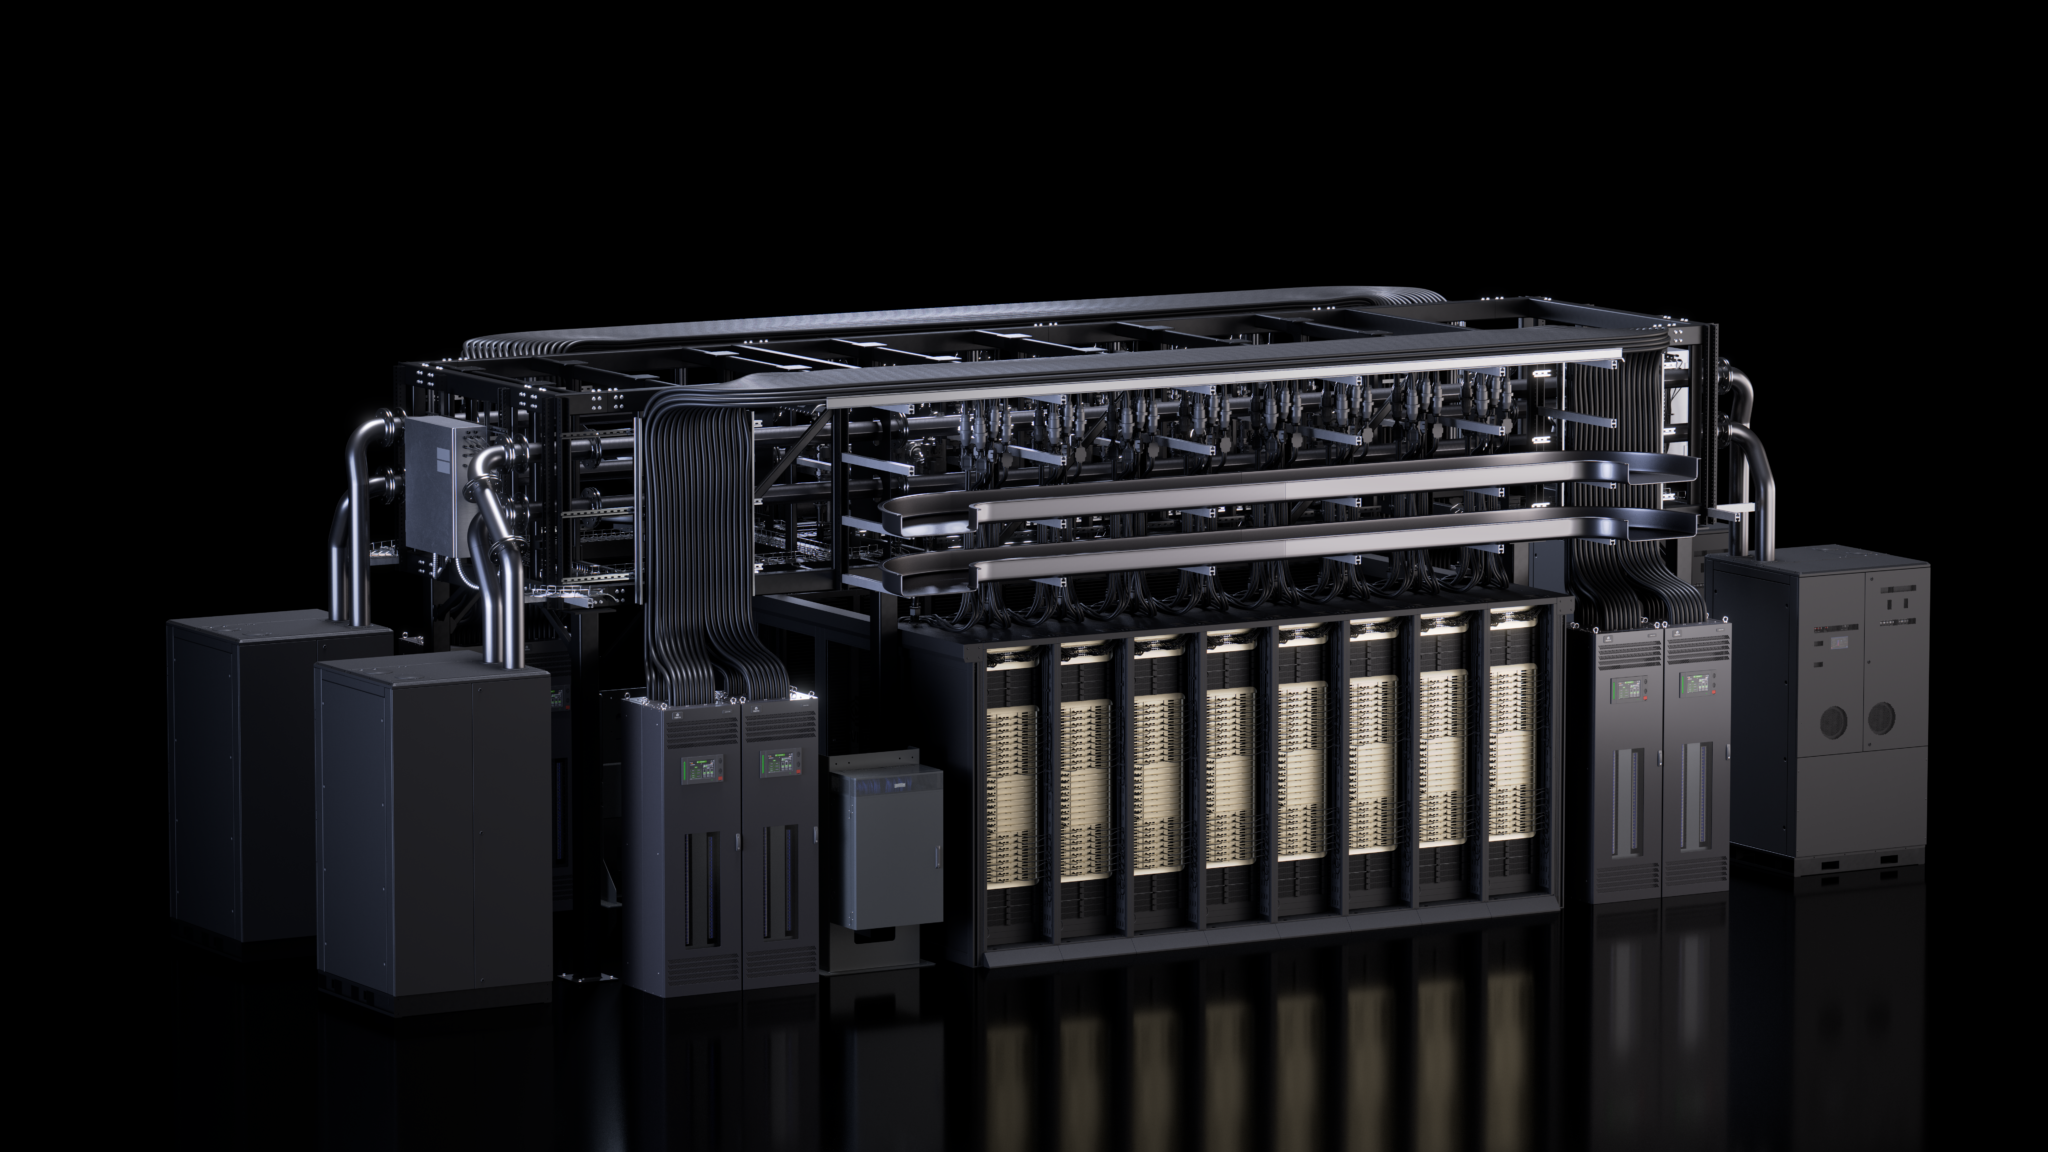
Entre las principales incorporaciones se encuentran:
NVIDIA afirma que la arquitectura puede admitir implementaciones de racks de hasta 250 kW, al tiempo que mejora la capacidad de mantenimiento y la reutilización de infraestructura.
MGX es una arquitectura de referencia modular, en lugar de un único diseño fijo de servidor.
Esto proporciona a los OEM, ODM y socios de infraestructura una base mecánica, eléctrica y de refrigeración común, al tiempo que permite distintas combinaciones de CPU, GPU, redes y almacenamiento.
Para Vera Rubin, esto significa que los socios pueden construir sobre un diseño conocido a escala de rack en vez de partir de una plataforma propietaria en cada ocasión.
La plataforma Vera Rubin NVL72 combina:
Posteriormente, puede escalar horizontalmente mediante NVIDIA Quantum-X800 InfiniBand o Spectrum-X Ethernet.
NVIDIA también está extendiendo los mismos principios de diseño MGX a un rack de CPU Vera dedicado.
Mientras que Vera Rubin NVL72 está diseñado para entrenamiento e inferencia a gran escala, el rack de CPU Vera se dirige a cargas de trabajo de agentes con uso intensivo de CPU, tales como:
La idea más amplia es mantener la infraestructura física coherente incluso cuando distintas partes de la carga de trabajo de IA requieren diferentes recursos de cómputo.
La plataforma DSX AI Factory de NVIDIA está diseñada para coordinar cómputo, redes, energía, refrigeración, instalaciones y software como un único sistema optimizado.
En el centro de la capa de software se encuentra DSX OS, que NVIDIA describe como una capa operativa abierta para operaciones repetibles de fábricas de IA.
En OCP, NVIDIA amplió DSX OS con cuatro componentes de código abierto.
NVIDIA Config Manager automatiza la configuración de switches a escala.
Su propósito es ayudar a los operadores a implementar, validar y mantener tejidos de red consistentes con una configuración manual mínima.
NVIDIA Cluster Readiness Engine somete a pruebas de estrés a clústeres de GPU mediante simulaciones de cargas de trabajo antes de que comience el entrenamiento de producción.
El objetivo es detectar problemas de hardware o infraestructura con la suficiente antelación para evitar costosos fallos de trabajos de entrenamiento.
NVIDIA Rack Management Service proporciona una abstracción de hardware y una capa operativa a nivel de rack.
En lugar de tratar cada servidor de forma independiente, el software considera los racks como unidades operativas de primera clase para la gestión de firmware y el control de infraestructura a gran escala.
Cluster API Provider para NVIDIA Infrastructure Controller está diseñado para acelerar el aprovisionamiento bare-metal y la incorporación de inquilinos.
NVIDIA afirma que el objetivo es transformar hardware de IA sin configurar en clústeres listos para producción en horas, en lugar de días.
Estos componentes se desarrollaron a partir de la experiencia de NVIDIA en la operación de DGX Cloud y están destinados a facilitar la integración de capacidades de fábrica de IA en plataformas cloud multiinquilino.
Las grandes instalaciones de IA necesitan más que un diseño de rack compartido. Las instalaciones, los sistemas de refrigeración, la arquitectura de energía y el comportamiento de la red eléctrica también necesitan expectativas comunes.
En OCP, NVIDIA se unió a AMD, Google y Meta para publicar una especificación abierta actualizada de centros de datos para infraestructura de IA de próxima generación.
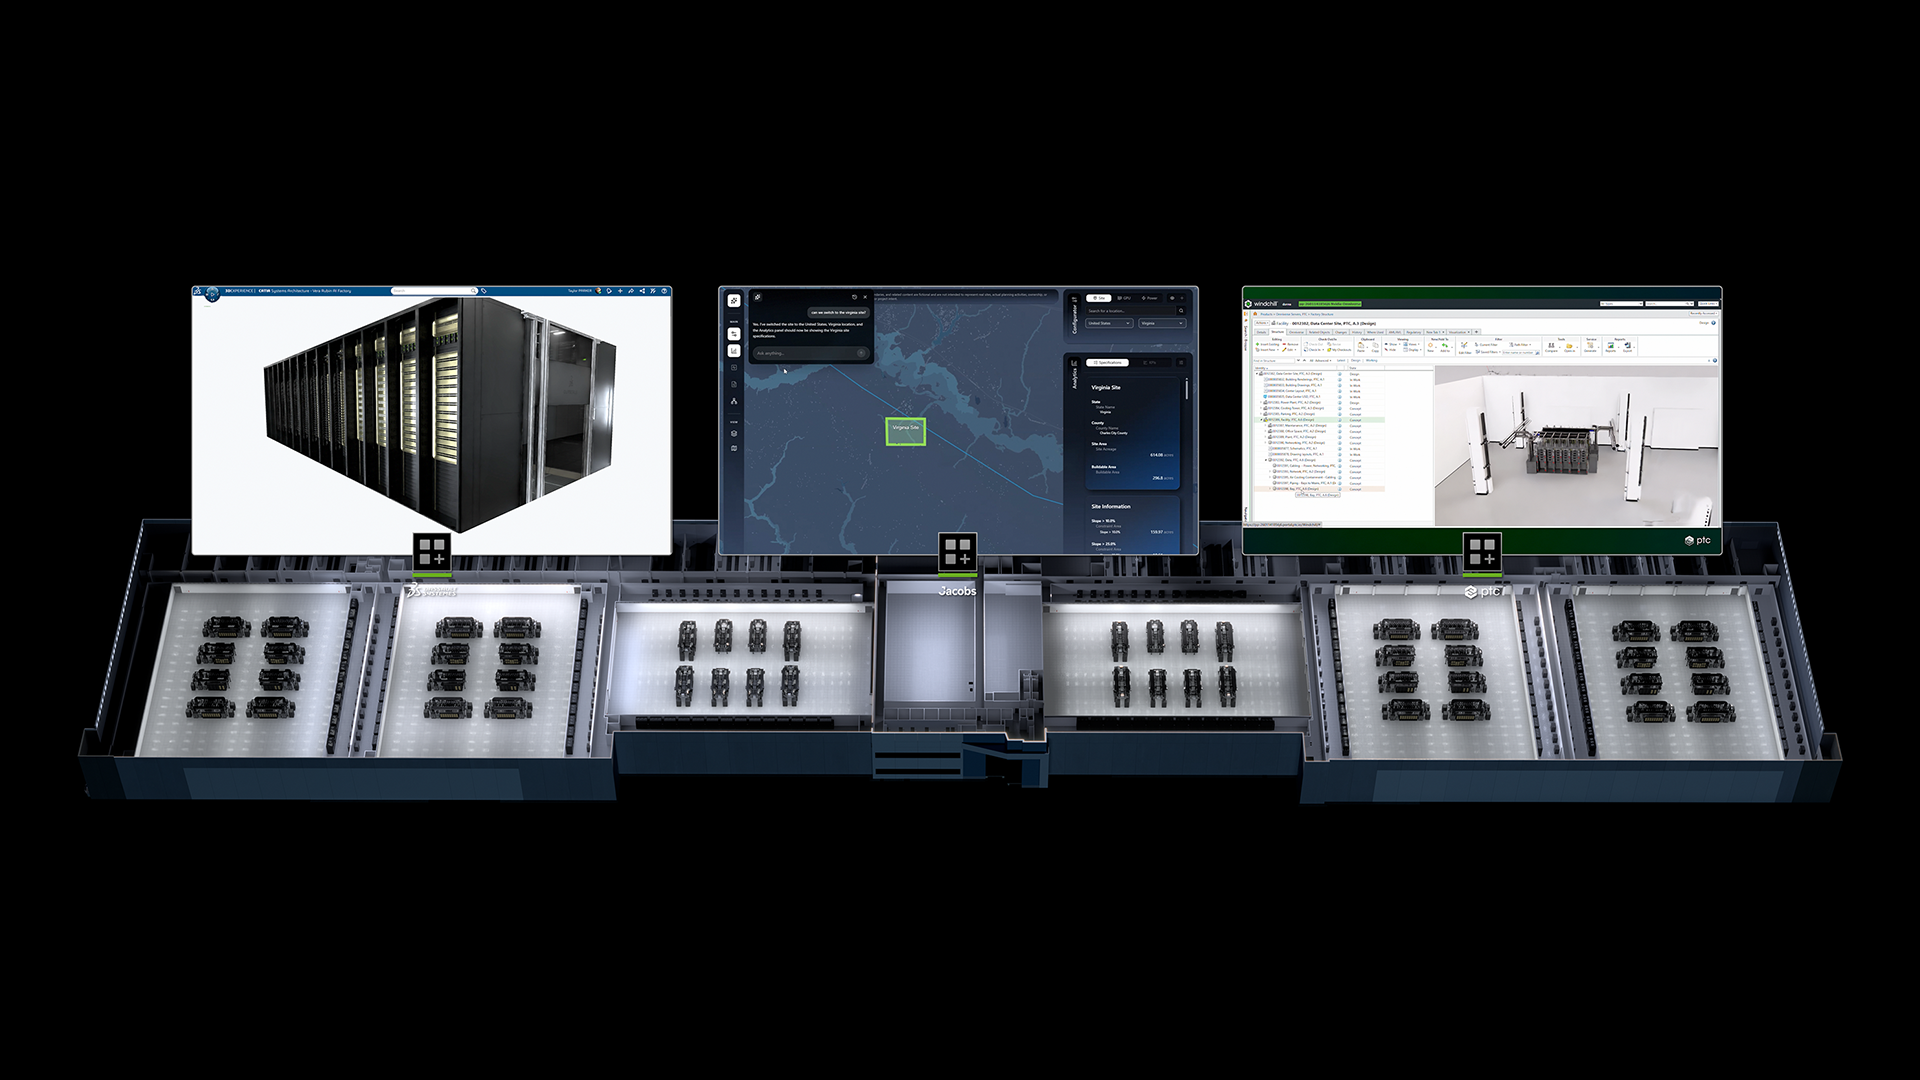
La Open Data Center Specification v0.7 define un plano común para el diseño de instalaciones de fábricas de IA.
Cubre áreas que incluyen:
El propósito es ofrecer a fabricantes, proveedores de colocación y operadores un objetivo común, en lugar de exigirles esperar una especificación propietaria independiente de cada cliente.
Google, Meta, Microsoft y NVIDIA también publicaron una OCP Grid Resilience Specification.
Esta especificación define cómo debe comportarse la infraestructura de IA de gran escala durante perturbaciones de la red eléctrica.
El objetivo de diseño es que las instalaciones de IA puedan:
Esto es cada vez más importante a medida que las instalaciones de IA alcanzan un tamaño en el que los cambios repentinos en el consumo eléctrico pueden afectar a la red circundante.
NVIDIA afirma que sus diseños de referencia DSX proporcionan una vía de implementación desplegable desde estos estándares abiertos hasta infraestructura real de fábrica de IA.
La densidad de potencia se está convirtiendo en una de las mayores limitaciones en el diseño de fábricas de IA.
A medida que crecen los clústeres de entrenamiento, inferencia y razonamiento, la distribución tradicional de menor voltaje requiere cantidades cada vez mayores de cobre, cableado y equipos de conversión.
En OCP, Visionbay.ai presentó planes para K-1, una plataforma de fábrica de IA basada en una arquitectura de 800 VDC y diseñada teniendo en cuenta futuras implementaciones de Vera Rubin.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
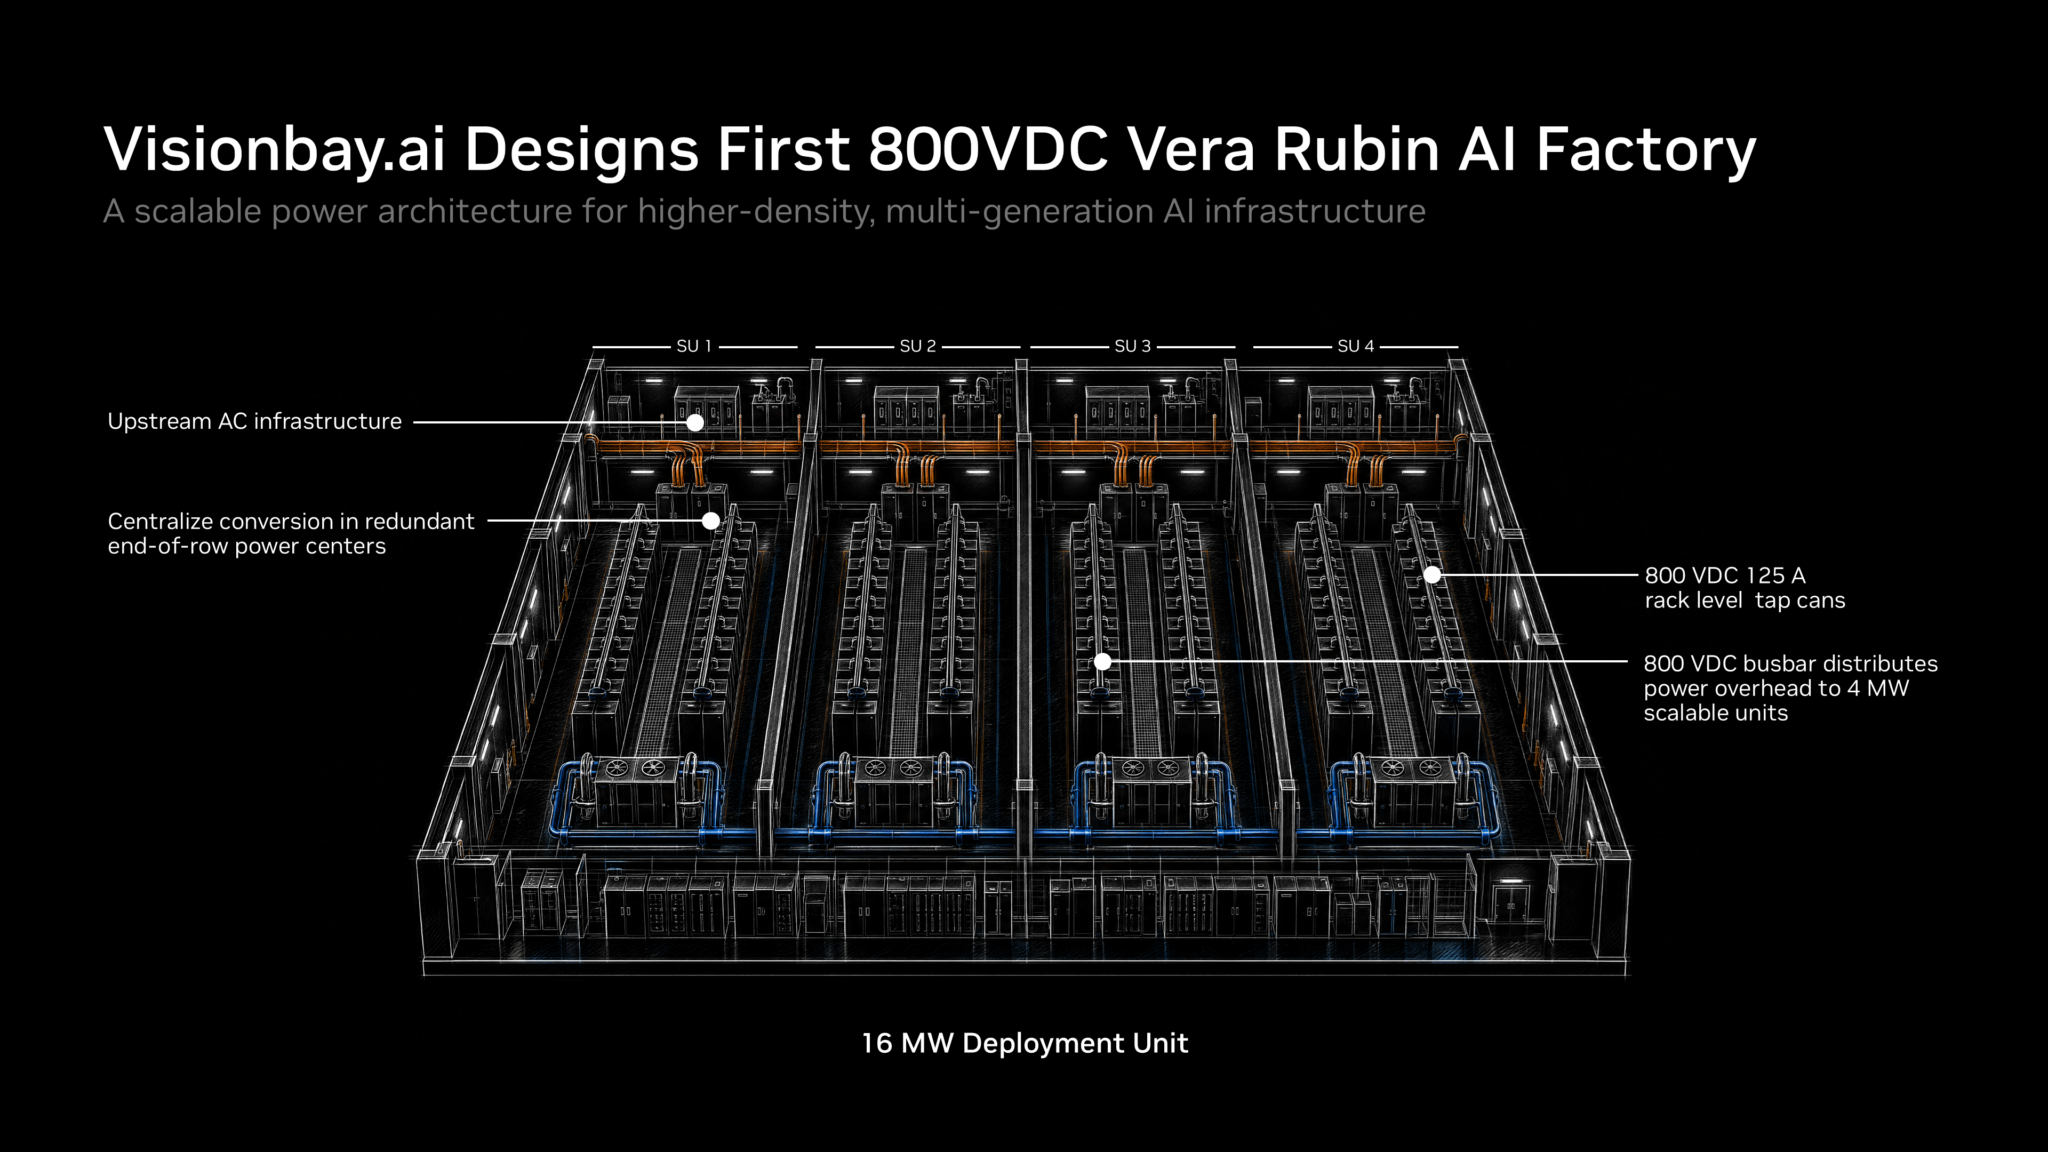
El diseño combina la arquitectura de referencia de 800 VDC de NVIDIA con tecnologías de energía y térmicas de Vertiv.
La arquitectura está destinada a acercar la distribución de corriente continua de alto voltaje a la capa de cómputo.
En lugar de convertir y distribuir repetidamente energía de menor voltaje mediante una gran cantidad de cobre, K-1 utiliza centros de energía a nivel de clúster que centralizan la conversión de CA a CC y después distribuyen 800 VDC más cerca de los racks.
Según NVIDIA, este enfoque puede:
La plataforma también está diseñada para una adopción gradual, en vez de exigir que una instalación completa migre a 800 VDC de una sola vez.
Esto ofrece a los operadores una vía para introducir corriente continua de alto voltaje donde aporte mayor valor, preservando a la vez la compatibilidad con la infraestructura existente.
En OCP, Meta y NVIDIA anunciaron otro paso en su colaboración de redes.
Meta está adoptando switches Ethernet NVIDIA Spectrum-6 de 102,4 Tb/s para fábricas de IA Vera Rubin más grandes que funcionan sobre infraestructura de red abierta.
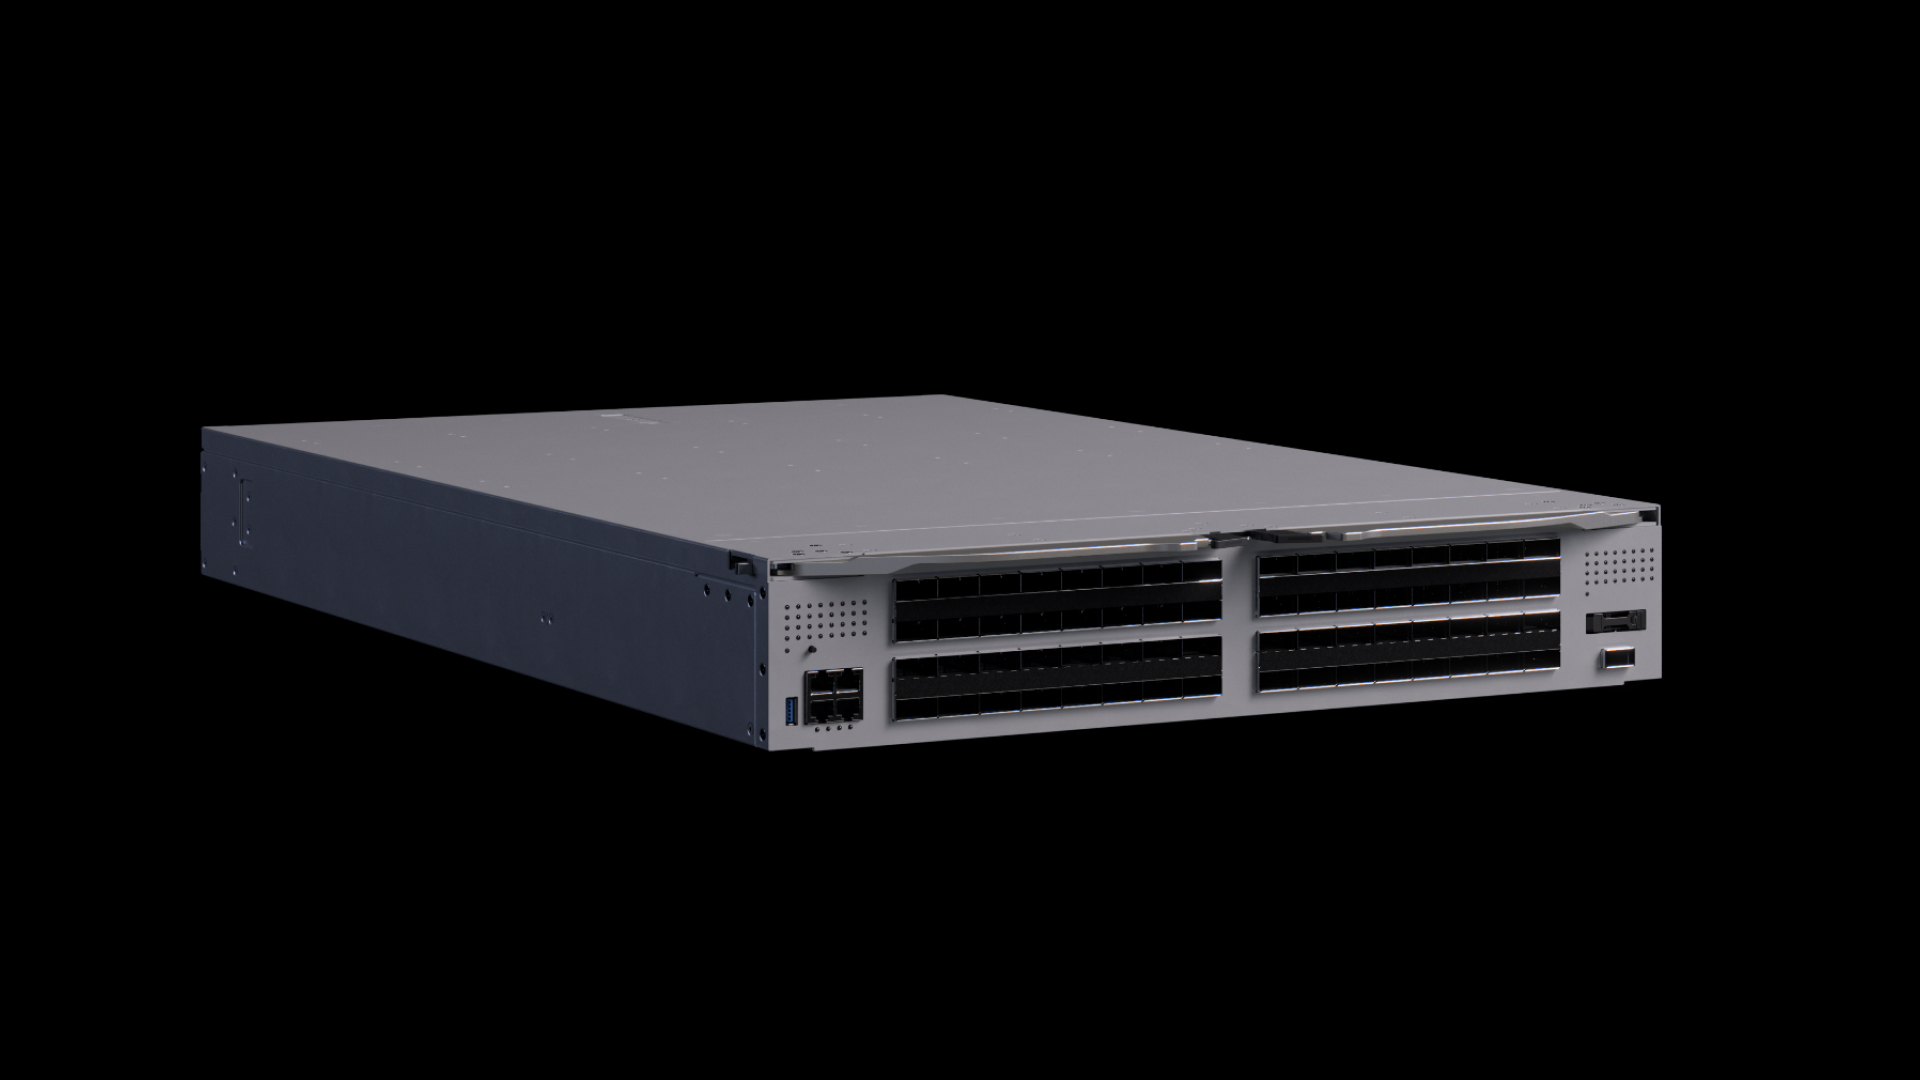
Spectrum-6 ofrece:
El switch de Meta basado en Spectrum-6 se llama N-IceCube.
Está diseñado para instalarse en IcePack, el rack de red refrigerado por líquido de 100T de Meta.
N-IceCube ejecuta FBOSS, el sistema operativo de red de código abierto de Meta.
FBOSS utiliza la Switch Abstraction Interface (SAI), un estándar de OCP que proporciona una interfaz independiente del proveedor para controlar el hardware de los switches.
Esto permite a Meta utilizar un plano de control de software conocido al mismo tiempo que adopta silicio de conmutación Spectrum-6.
Una parte importante de la colaboración es la tecnología Spectrum-X Multiplane.
Mediante switches Spectrum-6 y SuperNIC ConnectX-9, Multiplane distribuye en hardware el tráfico de GPU a través de hasta ocho planos de red independientes.
El diseño está destinado a admitir fábricas de IA con más de 100.000 GPU, al tiempo que reduce el número de niveles de switches necesarios.
Las múltiples rutas también mejoran la resiliencia.
Si un componente de red falla, el tráfico puede trasladarse a los planos restantes. La carga de trabajo puede continuar con un ancho de banda reducido en lugar de perder todo el tejido de red.
El resultado es una arquitectura de red destinada a ser altamente escalable y más fácil de operar en condiciones reales de producción.
A medida que los clústeres de IA se hacen más grandes, la propia conexión óptica física se convierte en un factor limitante.
NVIDIA y Cisco anunciaron planes para Ultra-Dense Small Form Factor Pluggable (USFP), un nuevo módulo transceptor óptico enchufable diseñado para redes de IA de próxima generación.
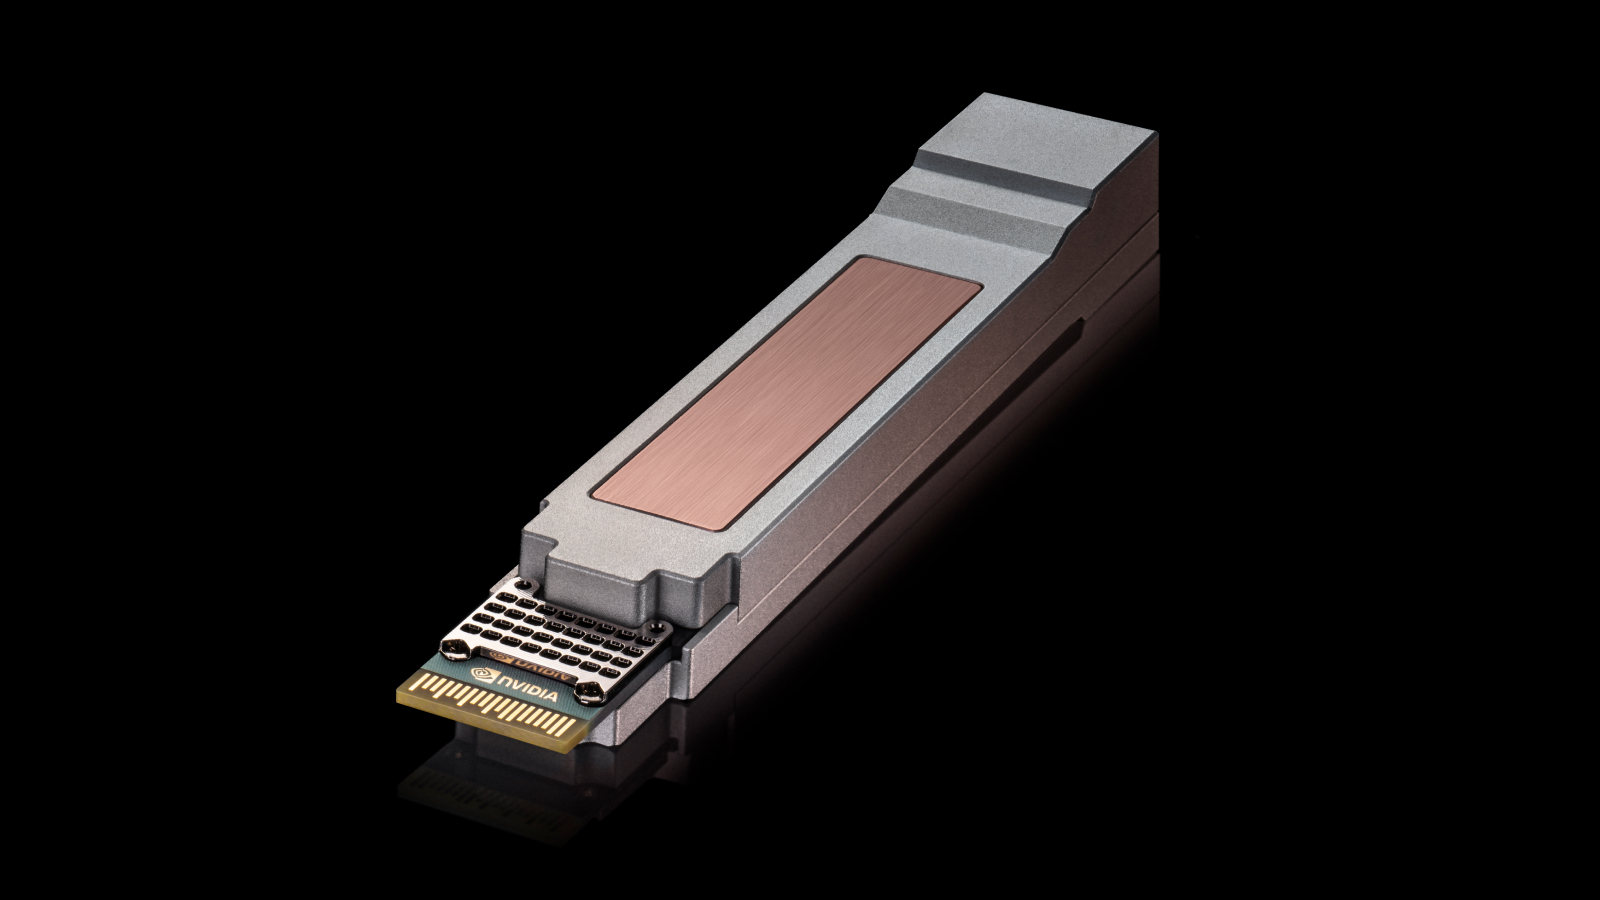
USFP está diseñado para proporcionar una vía hacia redes de 400 Gb/s por carril mientras mantiene aproximadamente la misma huella que el factor de forma OSFP, ampliamente utilizado para 200 Gb/s por carril.
El diseño previsto incluye:
El objetivo es conectar más recursos de cómputo sin añadir niveles de red adicionales que aumenten la latencia, el consumo energético y la complejidad operativa.
NVIDIA y Cisco están trabajando con TE Connectivity y Amphenol en jaulas, conectores y módulos, y planean impulsar USFP mediante un esfuerzo multisource liderado por la comunidad.
Esto mantiene el diseño alineado con el tema más amplio de interoperabilidad de OCP, en lugar de un ecosistema óptico de un solo proveedor.
NVIDIA y Google también anunciaron que Falcon Transport será compatible con futuras SuperNIC NVIDIA ConnectX-10 y DPU BlueField.
Falcon es un protocolo de transporte diseñado para comunicaciones fiables y de alto rendimiento a través de redes Ethernet, especialmente bajo congestión.
Incluye soporte para:
La colaboración combina la aceleración de hardware de NVIDIA con el software DOCA para implementar Falcon, manteniendo disponibles para las aplicaciones las interfaces de programación RDMA estándar.
Esto es importante porque proporciona al hardware de red de NVIDIA y Google una capa de transporte común, al tiempo que permite al software seguir utilizando API RDMA conocidas.
En grandes tejidos de IA, Falcon puede distribuir el tráfico entre rutas, adaptarse a la congestión y recuperarse de la pérdida de paquetes sin exigir que las aplicaciones gestionen directamente esos detalles.
NVIDIA aportó diseños clave de racks y bandejas de cómputo Vera Rubin a OCP mediante la arquitectura abierta MGX y participó en nuevos estándares de instalaciones, red eléctrica y redes. También lanzó cuatro nuevos componentes de infraestructura de código abierto para DSX OS.
MGX 1.2 es una arquitectura de referencia actualizada a escala de rack para cómputo acelerado de alta densidad. Añade refrigeración líquida blind-mate, una barra colectora de 5.000 A, soporte nativo de 19 pulgadas, bahías de E/S configurables y soporte para racks de hasta 250 kW.
Los componentes recientemente destacados son NVIDIA Config Manager, Cluster Readiness Engine, Rack Management Service y Cluster API Provider para NVIDIA Infrastructure Controller. Cubren la configuración de red, las pruebas de salud de clústeres, las operaciones a nivel de rack y el aprovisionamiento bare-metal.
La distribución de corriente continua a mayor voltaje puede reducir la cantidad de cobre, cableado y equipos de conversión necesarios a medida que aumenta la potencia de los racks. El diseño de NVIDIA está destinado a admitir futuros racks de IA de clase megavatio y permitir una adopción gradual en instalaciones existentes.
Spectrum-6 es la plataforma de switches Ethernet de NVIDIA de 102,4 Tb/s para fábricas de IA. Proporciona redes de 200 Gb/s por carril y está siendo adoptada por Meta como parte de su arquitectura N-IceCube y Spectrum-X Multiplane.
USFP es un nuevo factor de forma de módulo óptico enchufable desarrollado por NVIDIA y Cisco para redes de 400 Gb/s por carril. Está diseñado para aumentar la densidad de ancho de banda y la eficiencia energética, preservando la capacidad de mantenimiento de la óptica enchufable.
Falcon es el protocolo Ethernet de alto rendimiento de Google. Se espera que las futuras SuperNIC ConnectX-10 y los DPU BlueField lo admitan mediante aceleración de hardware de NVIDIA y software DOCA, preservando las interfaces de programación RDMA.
Sí. NVIDIA anunció en mayo de 2026 que Vera Rubin estaba alcanzando la producción a gran escala, con socios globales de sistemas y cadena de suministro fabricando sistemas a escala.
En la Cumbre Global de OCP 2026, NVIDIA expandió Vera Rubin desde una plataforma de cómputo hacia un plano de infraestructura más abierto. MGX 1.2 estandariza una mayor parte del diseño de racks, refrigeración y energía, mientras que DSX OS incorpora herramientas de código abierto para configurar, validar y operar grandes clústeres de IA.
El ecosistema circundante avanza en la misma dirección. Las nuevas especificaciones de instalaciones y red eléctrica de OCP definen cómo deben construirse las grandes fábricas de IA y cómo deben comportarse durante perturbaciones de energía. El diseño de 800 VDC de Visionbay aborda la creciente densidad de rack, mientras que Meta, Cisco y Google amplían la pila de red mediante Spectrum-6, USFP y Falcon Transport.
El tema central es la interoperabilidad: Vera Rubin se está convirtiendo no solo en una plataforma de GPU, sino en una arquitectura de referencia compartida que abarca cómputo, redes, energía, refrigeración y operaciones.
Empieza con una sola frase y obtén un sitio completo en minutos.



