For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/openai-28-day-sprint-day-1-gpt-6-speed-bo-37dfc44c.md.
OpenAI comenzó octubre con un compromiso público inusual de Thibault “Tibo” Sottiaux, quien lidera el trabajo en los productos Codex y ChatG...
OpenAI comenzó octubre con un compromiso público inusual de Thibault “Tibo” Sottiaux, quien lidera el trabajo en los productos Codex y ChatGPT.
Durante 28 días, el equipo afirmó que cada día haría una de dos cosas: lanzar una mejora clara que fuera relevante para la mayoría de los usuarios de Codex o ChatGPT Work, o realizar un restablecimiento completo de uso.
La primera entrega llegó el 5 de octubre de 2026. OpenAI afirmó que había optimizado la velocidad de respuesta predeterminada de GPT-6 Astra y GPT-6.1 Sol en aproximadamente un 50% para usuarios con suscripción en los productos de OpenAI y socios compatibles que utilizan Sign in with ChatGPT.
Esto parece una mejora sencilla. Sin embargo, la reacción fue más compleja.
El anuncio de velocidad coincidió con otros tres cambios relevantes para los usuarios avanzados: OpenAI introdujo un nuevo formato de publicidad visual para ChatGPT, publicó su plan de marcas de agua de texto para la UE y modificó la economía de sus suscripciones Pro de gama alta. Un nuevo informe de SemiAnalysis sostuvo después que las suscripciones de Anthropic proporcionan actualmente un valor equivalente de API sustancialmente mayor para algunos niveles habituales de modelos.
El resultado fue un primer día que se pareció menos a una celebración clara y más a una instantánea de las concesiones que OpenAI intenta gestionar: modelos más rápidos, mayores costes de infraestructura, nueva monetización, cumplimiento normativo y usuarios que comparan cada límite y cada token con los productos de la competencia.
El sprint de 28 días comenzó con una regla sencilla.
Tibo afirmó que, durante los siguientes 28 días, OpenAI lanzaría una mejora claramente relevante para la mayoría de los usuarios de Codex y Work o proporcionaría un restablecimiento completo.
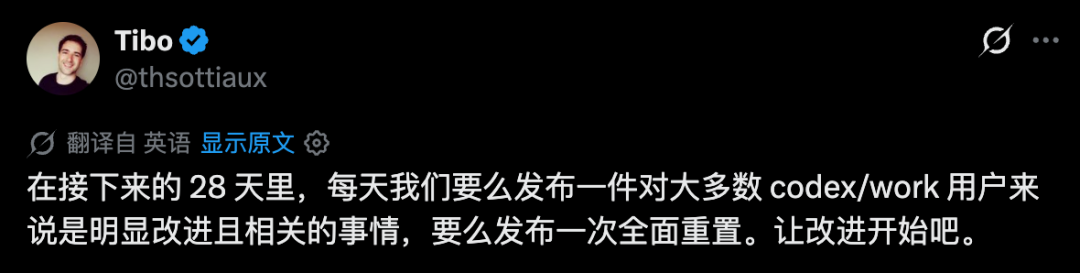
El equipo también delimitó sus prioridades inmediatas a algunas áreas:
El compromiso llegó tras un periodo de frustración especialmente visible por la velocidad de los modelos, las interrupciones del servicio y los cambios en las asignaciones de uso.
Para el Día 1, OpenAI eligió el rendimiento de inferencia.
El primer lanzamiento fue una optimización de la velocidad predeterminada para GPT-6 Astra y GPT-6.1 Sol.
El actual Centro de ayuda de OpenAI describe la mejora como un aumento aproximado del 50% en la velocidad de generación de texto con el ajuste de velocidad predeterminado.
El cambio se aplica cuando los modelos se utilizan mediante una suscripción de ChatGPT en productos de OpenAI o en aplicaciones de socios compatibles que se autentican con Sign in with ChatGPT, incluidos ejemplos como OpenCode, Pi, Amp y Devin.
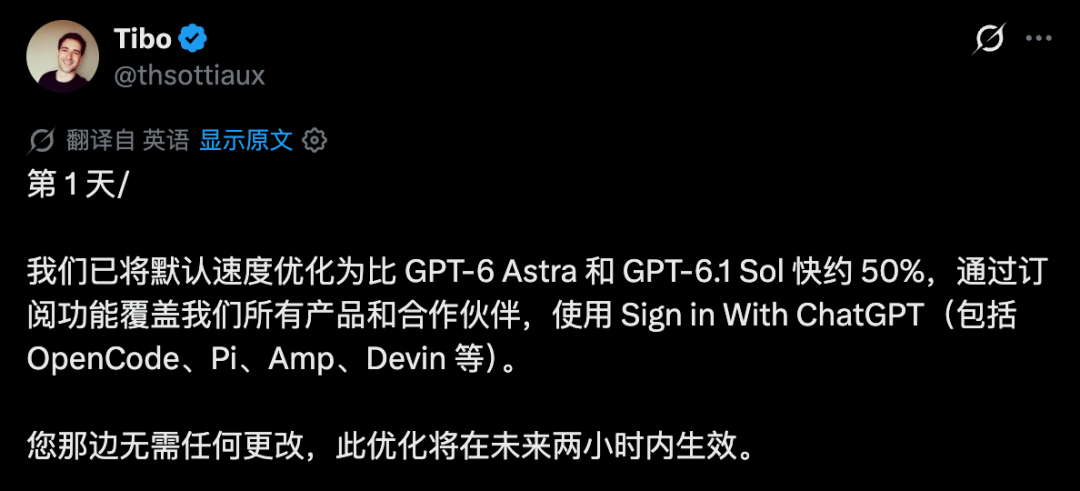
El usuario no necesita activar Fast ni Ultrafast para recibir esta optimización de velocidad predeterminada.
El rastreador de la comunidad de OpenAI describió el cambio como un avance de la tasa de salida predeterminada desde aproximadamente 30 tokens por segundo hacia 50 tokens por segundo.
Esta cifra requiere una aclaración importante: una generación de tokens más rápida no significa que una tarea completa de Codex o Work termine un 50% antes.
Las tareas agénticas suelen dedicar tiempo a actividades como:
Si la generación de texto del modelo es solo una parte de la tarea total, la latencia de extremo a extremo puede mejorar mucho menos que el porcentaje del titular.
GPT-6.1 Sol ya había recibido quejas por latencia poco después de su lanzamiento del 29 de septiembre.
La fuente de BAAI señala que algunos usuarios consideraron que incluso las respuestas en modo Fast eran más lentas de lo esperado durante periodos de alta carga. Tibo reconoció públicamente una carga inusualmente alta y afirmó que se estaba restaurando el rendimiento del servicio, con restablecimientos de uso ofrecidos a los usuarios de pago afectados.
Esto ayuda a explicar por qué la optimización de inferencia se convirtió en el primer elemento del programa de 28 días.
OpenAI no añadía un modelo nuevo en el Día 1. Hacía que los modelos que las personas ya utilizaban se sintieran más rápidos.
El anuncio de velocidad no fue la única novedad de OpenAI que llegó esa semana.
El 5 de octubre, OpenAI anunció un nuevo formato de anuncio visual para ChatGPT.
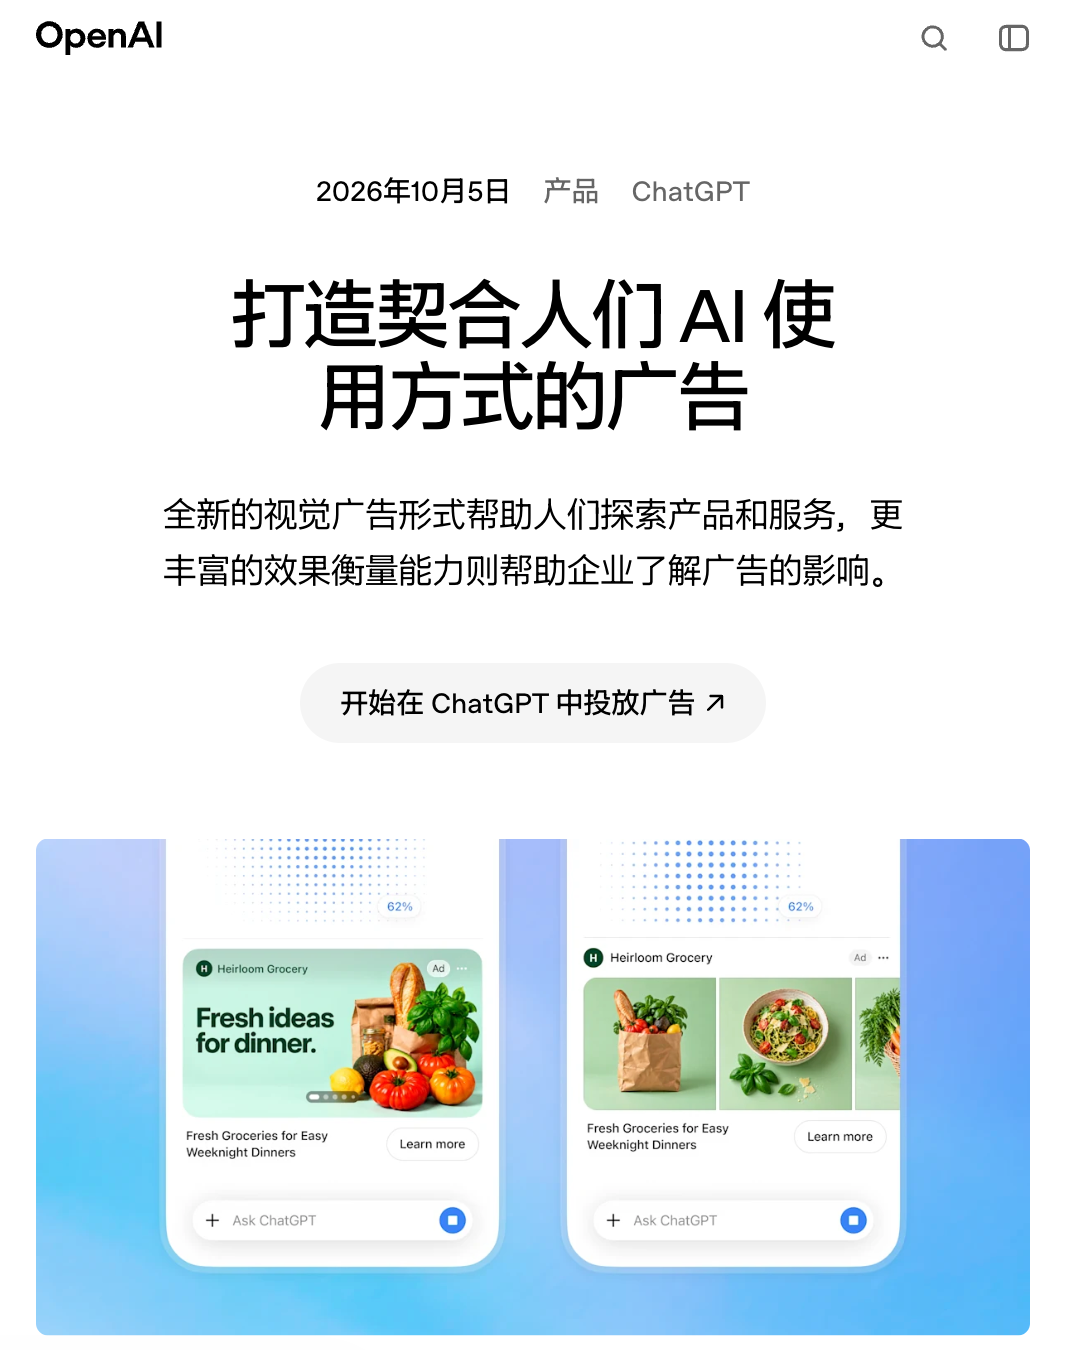
El formato está diseñado para mostrar inspiración de productos, uso de productos u otras imágenes de marca mientras las personas exploran productos y servicios en ChatGPT.
La primera prueba es más limitada de lo que sugieren algunos titulares.
OpenAI indica que el despliegue inicial:
La empresa también afirma que los anuncios estarán claramente etiquetados y permanecerán separados de la imagen que se está generando.
Según OpenAI, la publicidad no influye en las respuestas de ChatGPT.
El anuncio va más allá de una nueva unidad visual.
OpenAI está construyendo una infraestructura más amplia de medición publicitaria con socios de atribución, datos de conversión, incrementalidad e idoneidad de marca.
Entre los socios mencionados por OpenAI se incluyen servicios como:
OpenAI afirma que ChatGPT llega ahora a 1.200 millones de personas cada semana, lo que convierte la publicidad en un modelo de negocio adicional significativo junto con las suscripciones.
Los principios declarados por la empresa siguen siendo que las respuestas deben mantenerse independientes, las conversaciones de los usuarios deben permanecer privadas frente a los anunciantes y las personas deben conservar el control sobre su experiencia publicitaria.
Un segundo anuncio se centró en la procedencia, no en la monetización.
OpenAI publicó su plan para cumplir con los requisitos de transparencia de la Ley de IA de la UE mediante la introducción de una marca de agua estadística de texto llamada textGrain.
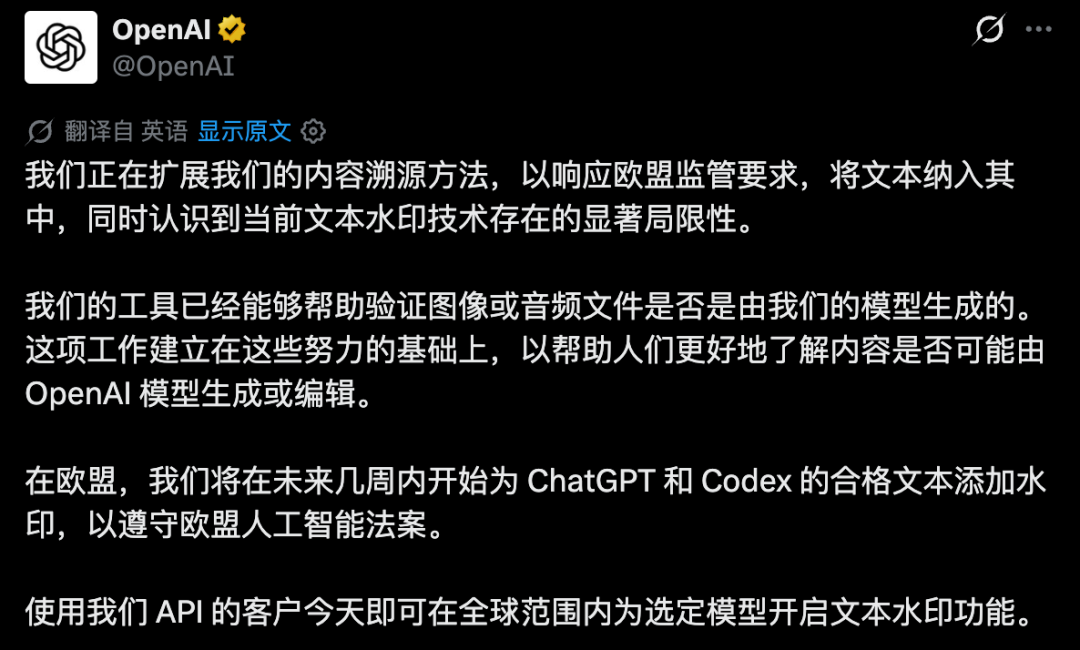
La marca de agua no es un carácter Unicode oculto, un espacio invisible ni una etiqueta de metadatos.
En cambio, textGrain afecta sutilmente la manera en que el modelo elige entre posibles palabras o fragmentos de palabras. A lo largo de un pasaje suficientemente largo, esas elecciones crean una señal estadística que un detector puede buscar.
OpenAI tiene dos rutas distintas de despliegue:
| Ruta de producto | Estado de la marca de agua |
|---|---|
| ChatGPT y Codex en la UE | Se desplegará durante las próximas semanas para resultados de texto elegibles |
| API de OpenAI en todo el mundo | Opción voluntaria para modelos seleccionados; desactivada de forma predeterminada |
| Detector público | No estará disponible de forma general en el lanzamiento |
| Acceso para investigadores y expertos | Disponible previa solicitud, caso por caso |
El artículo fuente relaciona correctamente la medida con la Ley de IA de la UE, pero es importante no describir la marca de agua como una configuración global predeterminada de ChatGPT en el lanzamiento.
OpenAI afirma explícitamente que el despliegue inicial de ChatGPT y Codex es solo para la UE.
OpenAI es inusualmente directa sobre lo que la marca de agua no puede demostrar.
Una marca de agua detectada no determina:
La ausencia de una marca de agua detectada tampoco prueba la autoría humana.
La propia evaluación de OpenAI muestra el motivo. Con una tasa objetivo de falsos positivos del 1%, la detección se vuelve más sólida con pasajes más largos y sin restricciones, mientras que el texto corto, muy condicionado, traducido o editado puede ser mucho más difícil de clasificar.
La empresa informa de que sustituir incluso una fracción moderada de palabras por sinónimos puede debilitar significativamente la señal.
Por lo tanto, textGrain es una señal de procedencia, no un detector infalible de autoría.
Si los anuncios y las marcas de agua resultaron molestos para algunos usuarios, la economía de las suscripciones fue más directamente relevante para los desarrolladores que utilizan intensamente Codex y flujos de trabajo agénticos.
El 5 de octubre, la firma independiente de investigación sobre semiconductores e infraestructura de IA SemiAnalysis publicó un informe que mide los límites prácticos de los principales planes de suscripción de IA.
El informe intenta estimar el valor equivalente de API en lugar de limitarse a comparar precios mensuales.
SemiAnalysis mide la rapidez con la que avanzan los medidores de uso de las suscripciones bajo cargas de trabajo controladas, estima cuántos tokens caben dentro de las ventanas de uso de un plan y convierte después esos límites en un valor utilizando los precios de API correspondientes.
Esta metodología es útil, pero sigue siendo un marco analítico creado por SemiAnalysis, no una valoración oficial de los planes por parte de OpenAI o Anthropic.
SemiAnalysis sostiene que las suscripciones de consumo están muy subvencionadas frente al uso directo de API.
Para Anthropic, su modelo aproximado estima que las suscripciones representan alrededor del 10% de los ingresos mientras consumen más del 40% del cómputo de inferencia.
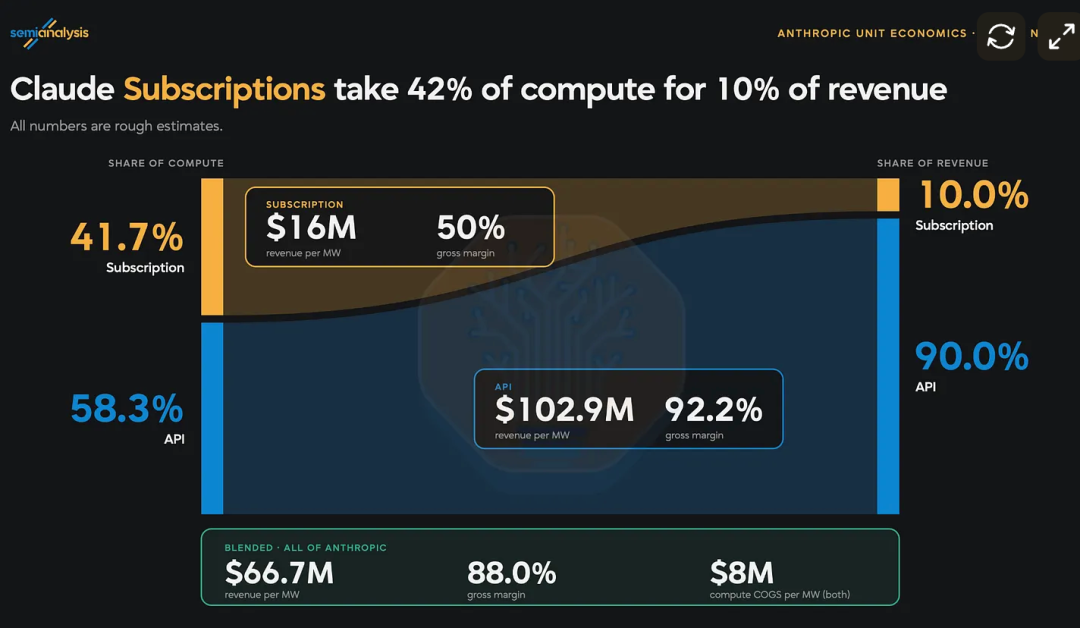
La firma estima que esto reduce los ingresos combinados por megavatio en aproximadamente 36 millones de dólares frente a una combinación de cargas de trabajo con mayor peso de API.
La economía exacta son estimaciones, no divulgaciones financieras de la empresa.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Pero la presión más amplia es fácil de entender: las suscripciones mensuales planas fomentan un uso intensivo, mientras que la inferencia de modelos de frontera sigue siendo costosa.
Esto crea una tensión continua entre límites de uso generosos y márgenes sostenibles.
OpenAI ofrece ahora tres niveles mensuales Pro:
| Plan | Precio mensual | Astra Ultrafast |
|---|---|---|
| Pro 100 | 100 USD | No |
| Pro 200 | 200 USD | No |
| Pro 500 | 500 USD | Sí |
Pro 500 se lanzó el 29 de septiembre e incluye el mayor uso agrupado de los tres planes Pro, además de acceso a Astra Ultrafast en ChatGPT Work y Codex.
OpenAI también redujo la asignación incluida para las suscripciones Pro 200 adquiridas recientemente. Los clientes elegibles para la protección de condiciones anteriores pueden conservar la asignación previa hasta el 29 de octubre de 2026.
Este cambio es real y está documentado por OpenAI.
Lo que SemiAnalysis añade es una medición de cuánto uso práctico del modelo parecen contener esos niveles.
Según la firma, el plan Pro 200 actualizado de OpenAI proporciona aproximadamente la mitad del valor equivalente de API anterior según su metodología de prueba.
El informe también señala que el nuevo nivel de 500 USD ofrece solo alrededor de un 21% más de uso de GPT-6 Astra que el antiguo nivel de 200 USD con condiciones anteriores, aunque Pro 500 añade el beneficio independiente de Astra Ultrafast.
Esto hace difícil evaluar el nuevo plan de 500 USD con una sola cifra: su valor depende en parte de si al usuario le importa el máximo rendimiento, no solo el volumen de tokens.
El gráfico más comentado compara GPT-6.1 Sol con Claude Opus 5.5 bajo una carga de trabajo agéntica.
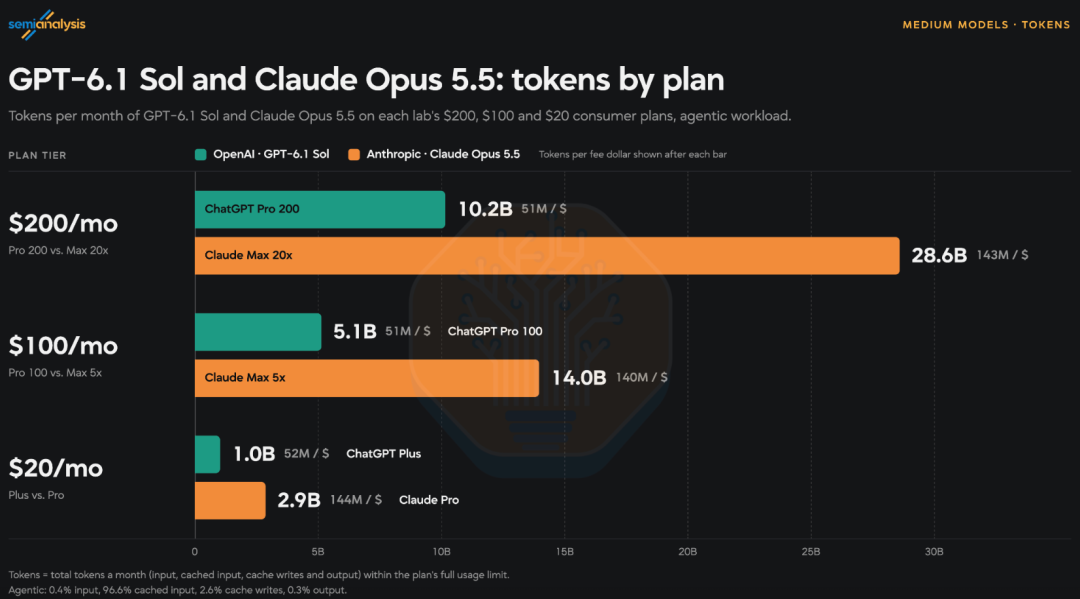
SemiAnalysis concluye que Anthropic ofrece aproximadamente 5 veces el valor equivalente de API en esta comparación de nivel medio.
Eso no significa que cada suscripción de Claude sea cinco veces mejor para cada usuario.
El resultado depende de:
La propia SemiAnalysis señala que la eficiencia de tokens es difícil de medir de forma fiable y que el valor equivalente de API puede ser engañoso si los precios de API no se corresponden claramente con la utilidad práctica.
Aun así, el informe da a los desarrolladores una razón concreta para comparar suscripciones según la carga de trabajo real, en lugar de hacerlo únicamente por las etiquetas de marketing.
Tras el anuncio de velocidad del Día 1, algunos usuarios comenzaron a medir por sí mismos el nuevo rendimiento predeterminado.
Un resultado ampliamente compartido mostró que GPT-6.1 Sol Standard promediaba alrededor de 31,7 tokens por segundo durante un periodo de medición, con una ventana corta más reciente cercana a valores de entre treinta y treinta y nueve tokens por segundo.
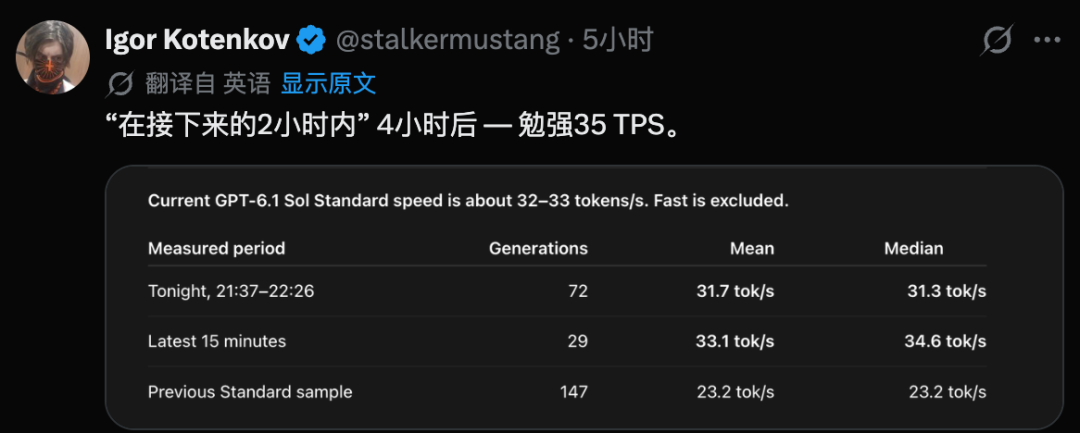
Esto estaba por debajo de la cifra aproximada de 50 tokens por segundo asociada al anuncio del despliegue.
Esto no significa necesariamente que la optimización haya fallado.
La velocidad observada puede variar según:
El propio Centro de ayuda de OpenAI afirma que actualmente el soporte no puede verificar la mejora de velocidad para una cuenta individual.
Por lo tanto, la afirmación oficial debe interpretarse como una optimización a nivel de plataforma, no como un rendimiento fijo garantizado para cada solicitud.
Otra reacción en el artículo fuente fue más escéptica: algunos usuarios sostuvieron que GPT-6.1 Sol ya se había ralentizado considerablemente después de su lanzamiento, por lo que el aumento de velocidad del Día 1 parecía restaurar rendimiento perdido en lugar de introducir una capacidad realmente nueva.
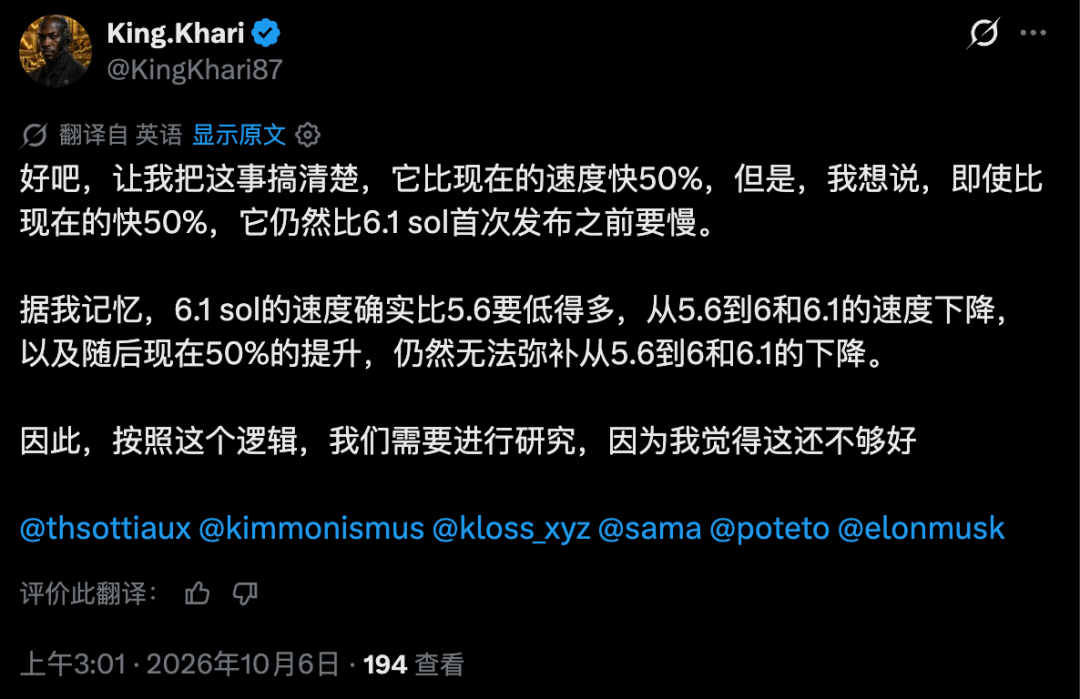
Ese argumento es difícil de demostrar con datos públicos porque no existe un único gráfico histórico oficial del rendimiento de inferencia por usuario antes y después de cada evento de carga.
Lo confirmado es que OpenAI reconoció una carga inusualmente alta en torno a GPT-6.1 Sol y posteriormente lanzó una optimización de inferencia destinada a mejorar la velocidad predeterminada de generación de texto.
La reacción de los usuarios sigue siendo relevante porque explica por qué una mejora técnicamente significativa del rendimiento no generó automáticamente una respuesta positiva.
Los usuarios evalúan una actualización frente a su experiencia anterior, no solo frente al punto de referencia actual de la empresa.
Por sí sola, una tasa de respuesta predeterminada más rápida es una mejora directa de la experiencia de uso.
Pero el Día 1 llegó en medio de varios cambios superpuestos:
Esto hizo que la reacción fuera menos sobre una optimización de inferencia y más sobre lo que los usuarios creen que OpenAI está priorizando.
Para los desarrolladores, la cuestión central es práctica:
¿Los modelos se vuelven más rápidos y más útiles con la suficiente rapidez como para compensar límites más estrictos, niveles más caros y una experiencia de producto más comercializada?
No existe una respuesta única.
Un usuario que valora Astra Ultrafast, Codex Cloud o el ecosistema más amplio de herramientas de OpenAI puede hacer un cálculo muy distinto al de un desarrollador que optimiza exclusivamente los tokens de modelo por cada dólar de suscripción.
El programa de 28 días crea un ciclo de retroalimentación inusualmente público.
En vez de anunciar una gran hoja de ruta y pedir a los usuarios que esperen, OpenAI se obliga a producir mejoras visibles a un ritmo diario o a compensar a los usuarios con un restablecimiento.
El primer día se centró en la velocidad de inferencia.
Para el 8 de octubre, el desafío ya había avanzado más allá del Día 1, con actualizaciones posteriores que incluyeron Auto Review gratuito, simplificación de límites de tasa de API, un complemento de reuniones, la beta pública de la API Decisions, restablecimientos y GPT-6 con Intelligent UI.
Este artículo sigue centrado en la instantánea del Día 1 porque ese es el tema del informe original de BAAI.
La prueba más importante es lo que sumen los 28 días completos.
Si el programa ofrece mejoras que los usuarios realmente puedan percibir en la programación cotidiana y el trabajo de conocimiento, la optimización de velocidad parecerá un primer paso razonable.
Si las actualizaciones posteriores parecen cosméticas mientras los límites y los precios siguen siendo el principal foco de atención, será más difícil revertir el escepticismo observado en el Día 1.
Durante 28 días, Tibo Sottiaux de OpenAI afirmó que el equipo lanzaría cada día una mejora clara relevante para la mayoría de los usuarios de Codex y ChatGPT Work o realizaría un restablecimiento completo. El programa comenzó a principios de octubre de 2026.
OpenAI describe la optimización del Día 1 como un aumento aproximado del 50% en la velocidad predeterminada de generación de texto. Esto no significa que cada tarea completa de Work o Codex termine un 50% antes, porque el uso de herramientas, la navegación, el razonamiento y los servicios externos también consumen tiempo.
No. OpenAI afirma que la mejora se aplica al ajuste de velocidad predeterminado. Fast y Ultrafast son niveles de servicio y opciones de producto independientes.
OpenAI afirma que la prueba inicial de anuncios visuales comenzará más adelante en octubre de 2026 en Estados Unidos, durante la generación de imágenes para usuarios Free y Go. Los anuncios estarán etiquetados y separados de la imagen generada.
No. OpenAI planea añadir marcas de agua textGrain al texto elegible de ChatGPT y Codex en la Unión Europea durante las próximas semanas. Los clientes de la API de todo el mundo pueden optar por activarlas para modelos seleccionados, pero la marca de agua está desactivada de forma predeterminada en la API.
Pro 500 es el nivel Pro de OpenAI de 500 USD al mes. Incluye el mayor uso agrupado entre los planes Pro y acceso a Astra Ultrafast en ChatGPT Work y Codex.
Sí. OpenAI documenta una asignación incluida menor para las nuevas suscripciones Pro 200, mientras que los usuarios elegibles con condiciones anteriores pueden mantener la asignación previa hasta el 29 de octubre de 2026.
Esa es una conclusión de SemiAnalysis para comparaciones específicas de modelos y cargas de trabajo mediante su metodología de valor equivalente de API. No debe tratarse como una medida universal de la calidad o utilidad de un modelo para todos los usuarios.
OpenAI comenzó su sprint de lanzamientos de 28 días para Codex y ChatGPT Work con una mejora real de infraestructura: GPT-6 Astra y GPT-6.1 Sol ahora generan texto aproximadamente un 50% más rápido con el ajuste de velocidad predeterminado en productos de suscripción y socios compatibles con Sign in with ChatGPT.
La reacción moderada tiene más sentido al considerar todo lo demás que ocurría al mismo tiempo. OpenAI está probando anuncios visuales, desplegando marcas de agua de texto para la UE, reestructurando las asignaciones de uso de Pro y vendiendo un nuevo nivel de 500 USD con Astra Ultrafast, mientras SemiAnalysis sostiene que Anthropic ofrece actualmente mucho más valor equivalente de API en varias comparaciones habituales de suscripciones.
Por tanto, el debate del primer día no trata realmente de tokens por segundo. Trata de la propuesta de valor completa que los usuarios evalúan ahora: calidad del modelo, velocidad, límites, precio, herramientas, privacidad, publicidad y fiabilidad.
El Día 1 hizo los modelos más rápidos; los 27 días restantes determinarán si OpenAI puede hacer que la experiencia global de Codex y Work se sienta significativamente mejor.
Empieza con una sola frase y obtén un sitio completo en minutos.



