La serie GPT-5.6 de OpenAI incluye tres niveles de modelos: Sol, Terra y Luna. En lugar de ofrecer un único modelo para todas las cargas de ...

La serie GPT-5.6 de OpenAI incluye tres niveles de modelo: Sol, Terra y Luna.
En lugar de ofrecer un solo modelo para todas las cargas de trabajo, OpenAI diferencia la serie según capacidad, coste y rendimiento:
OpenAI presentó por primera vez la serie en junio de 2026 y la lanzó por completo el 9 de julio. El artículo original de AIBase se publicó el 30 de julio, destacando las mejoras de eficiencia detrás de este lanzamiento: mejor rendimiento por token, niveles de modelo de menor coste y optimizaciones de infraestructura y ciclo de agente diseñadas para reducir el coste total de completar trabajos reales.
Este enfoque es crucial. Para los sistemas de IA en producción, la métrica relevante es cada vez menos lo inteligente que parece un modelo de forma aislada, sino cuánto trabajo útil puede completar dados un tiempo, recursos informáticos y presupuesto determinados.
OpenAI describe Sol, Terra y Luna como niveles de capacidad persistentes, no como sufijos temporales.
El número de generación identifica la serie GPT-5.6, mientras que los nombres distinguen los niveles esperados de rendimiento y coste.
| Modelo | Posicionamiento | Precio de entrada API | Precio de salida API | Ventana de contexto | Salida máxima |
|---|---|---|---|---|---|
| GPT-5.6 Sol | Modelo insignia para trabajos complejos y especializados | 5 USD por millón de tokens | 30 USD por millón de tokens | 1.050.000 tokens | 128.000 tokens |
| GPT-5.6 Terra | Equilibrio entre inteligencia y coste | 2,50 USD por millón de tokens | 15 USD por millón de tokens | 1.050.000 tokens | 128.000 tokens |
| GPT-5.6 Luna | Cargas de trabajo de alto rendimiento sensibles al coste | 1 USD por millón de tokens | 6 USD por millón de tokens | 1.050.000 tokens | 128.000 tokens |
Las tres páginas de modelo indican una fecha límite de conocimiento del 16 de febrero de 2026 y admiten entrada de texto e imagen, así como salida de texto.
El alias de API gpt-5.6 enruta a GPT-5.6 Sol.
Sol es el nivel más potente de GPT-5.6 de OpenAI.
OpenAI lo posiciona para:
En el Artificial Analysis Coding Agent Index v1.1, OpenAI informa que GPT-5.6 Sol obtiene una puntuación de 80 en modo de razonamiento máximo, en comparación con 77,2 de Claude Fable 5 en la misma tabla.
OpenAI también afirma que, en esa comparación, Sol utiliza menos de la mitad de los tokens de salida y menos de la mitad del tiempo, mientras que su coste estimado de tarea es menor.
Esto no significa que Sol sea superior en todos los puntos de referencia. La propia tabla de lanzamiento de OpenAI muestra que los modelos competidores lideran en algunas evaluaciones. El argumento más consistente de GPT-5.6 es el rendimiento por token y por dólar, no el liderazgo absoluto en cada categoría de tarea.
Terra es el modelo intermedio de la serie.
OpenAI describe su capacidad como comparable al nivel de GPT-5.5, mientras que sus tarifas son:
Esto equivale a la mitad del precio de 5 USD / 30 USD correspondiente al nivel insignia anterior.
Por lo tanto, Terra es adecuado para equipos que necesitan una potente capacidad de razonamiento y agente, pero sin necesidad de recurrir a Sol para cada solicitud.
Los ejemplos típicos incluyen:
El modelo admite la misma ventana de contexto de 1,05 millones de tokens y una salida máxima de 12,8 millones de tokens que Sol.
Luna está diseñado para cargas de trabajo donde el rendimiento y el coste son los más críticos.
Sus precios de API son:
Esto supone un 80 % menos que Sol tanto en precios de entrada como de salida.
OpenAI describe Luna como su modelo GPT-5.6 más rápido y asequible. Es adecuado para cargas de trabajo como:
El precio más bajo no significa que Luna sea solo un modelo práctico sin razonamiento. Sigue admitiendo las funciones de razonamiento de GPT-5.6 y el ecosistema de herramientas de OpenAI, pero su límite de capacidad es inferior al de Sol.
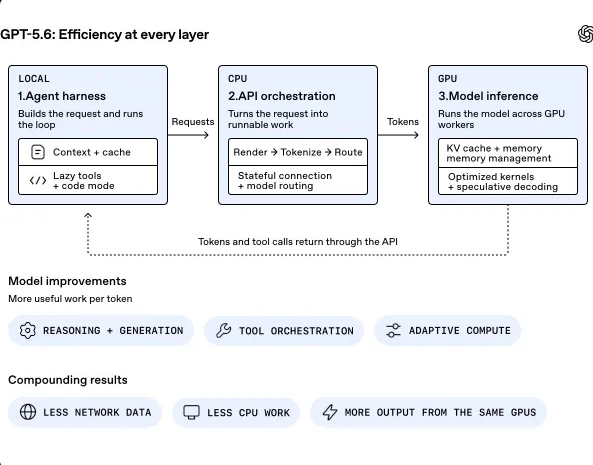
El artículo de AIBase enfatiza que GPT-5.6 no es solo una mejora en la calidad del modelo.
El objetivo de ingeniería más amplio es aumentar la cantidad de trabajo útil producido por cada token y reducir la sobrecarga adicional de la ejecución del agente.
Los materiales oficiales de lanzamiento de OpenAI respaldan esta dirección más amplia.
La compañía afirma que GPT-5.6 ha sido entrenado para completar trabajos útiles con menos tokens de salida, y su guía para desarrolladores sugiere que, al migrar desde GPT-5.5 o GPT-5.4, se pruebe el mismo nivel de esfuerzo de razonamiento, generalmente reduciendo un nivel.
Esto es importante porque el precio anunciado por token es solo una parte del coste del agente.
Un flujo de trabajo de múltiples pasos puede consumir presupuesto a través de:
Por lo tanto, un modelo que requiere menos pasos, incluso si su tarifa nominal por token parece similar, puede resultar más barato en la práctica.
El artículo original destaca el rendimiento del agente de codificación de Sol.
Tabla de referencia actual de OpenAI
Informe:
| Evaluación de codificación | GPT-5.6 Sol | GPT-5.6 Terra | GPT-5.6 Luna | GPT-5.5 |
|---|---|---|---|---|
| Índice de inteligencia de codificación de análisis de IA v1.1 | 80 | 77,4 | 74,6 | 76,4 |
| SWE-Bench Pro | 64,6% | 63,4% | 62,7% | 59,4% |
| DeepSWE v1.1 | 72,7% | 69,6% | 67,2% | 67,0% |
| Terminal-Bench 2.1 | 88,8% | 87,4% | 84,7% | 85,6% |
Estos datos provienen de la tabla de lanzamiento publicada por OpenAI y deben leerse en el contexto del marco de evaluación y la configuración específicos.
Por ejemplo, los resultados de las pruebas de referencia pueden variar según los siguientes factores:
OpenAI también señala que algunas de sus comparaciones de costos y latencia se basan en estimaciones fuera de línea del comportamiento de producción, y no en facturación directa de cada servicio competidor.
La lección práctica es que los modelos deben probarse en trabajos de producción representativos, y no elegirse únicamente según las tablas de clasificación.
La fuente de AIBase describe la optimización de toda la pila de servicios, que incluye:
También informa que el trabajo de inferencia ha mejorado la eficiencia de generación de tokens en más de un 15%.
Estos detalles subyacentes del servicio se presentan en el informe de AIBase. La página pública de lanzamiento actual de GPT-5.6 de OpenAI confirma el esfuerzo más amplio por mejorar el servicio y la eficiencia de la investigación, pero los datos subyacentes exactos deben considerarse como informes de origen, a menos que se reproduzcan en publicaciones técnicas de OpenAI o en pruebas de referencia que documenten el método completo.
Lo que puede confirmarse de forma independiente a partir de la documentación de OpenAI es que GPT-5.6 incorpora varios mecanismos destinados a reducir el trabajo innecesario del modelo.
Estos incluyen:
La dirección de ingeniería es coherente: reducir el trabajo redundante en torno a cada tarea exitosa.
GPT-5.6 introduce un caché de mensajes más predecible.
La documentación de OpenAI admite puntos de corte de caché explícitos, que permiten a los desarrolladores decidir qué prefijos de mensajes reutilizables deben almacenarse en caché.
Para los modelos GPT-5.6:
Esto cambia la forma en que los desarrolladores piensan sobre los agentes de larga duración.
Si los mensajes grandes del sistema, los directorios de herramientas, las secciones de políticas o el contexto del proyecto estable se envían repetidamente como entrada no almacenada en caché, el costo puede ser alto.
Cuando los prefijos reutilizables se mantienen estables, el caché puede reducir ese costo.
Al mismo tiempo, las escrituras innecesarias en caché pueden aumentar los costos. Por lo tanto, OpenAI recomienda realizar un seguimiento tanto del uso de tokens almacenados en caché como de los tokens de escritura en caché, en lugar de asumir que el caché siempre es más barato.
La segunda área principal de eficiencia es el marco del agente.
El ciclo de herramientas tradicional suele ser el siguiente:
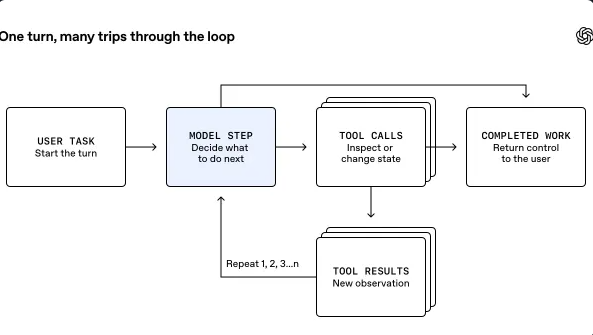
Aunque este método es flexible, puede volverse costoso.
Las salidas grandes de herramientas intermedias pueden entrar repetidamente en el contexto del modelo, incluso si solo se necesita una pequeña parte de los datos.
Las llamadas a herramientas programáticas de GPT-5.6 ofrecen otra opción.
La documentación de OpenAI muestra que GPT-5.6 puede escribir JavaScript en un entorno de ejecución gestionado para:
Para flujos de trabajo acotados, esto puede reducir:
OpenAI indica que este patrón es particularmente útil cuando el código puede manejar múltiples resultados predecibles de herramientas sin necesidad de reevaluar semánticamente después de cada llamada.
No es adecuado para todas las tareas de agente.
En los siguientes casos, la interacción directa modelo-herramienta sigue siendo la mejor opción:
El objetivo no es minimizar el número de llamadas a toda costa, sino evitar pasar información innecesaria a través del modelo.
El artículo de AIBase también señala que una gestión más estricta del historial de conversación es un método para mejorar la tasa de reutilización del caché.
La guía de desarrollo actual de GPT-5.6 de OpenAI proporciona el mecanismo oficial relacionado: inferencia persistente.
Los desarrolladores pueden configurar cómo mantener disponible el razonamiento de rondas anteriores.
Esto es importante para los flujos de trabajo de larga duración, ya que no todas las ideas anteriores son igualmente útiles para siempre.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Si la tarea se mantiene estable, el razonamiento anterior puede mejorar la continuidad.
Si el objetivo cambia, mantener todo el razonamiento anterior aumenta los costos e introduce suposiciones obsoletas.
Por lo tanto, OpenAI permite a las aplicaciones controlar el contexto de razonamiento y recomienda conservar correctamente los elementos de respuesta necesarios al gestionar el historial manualmente.
Esto proporciona a los desarrolladores otra palanca para equilibrar los siguientes elementos:
La guía de desarrollo de GPT-5.6 de OpenAI recomienda especialmente simplificar los mensajes.
En las muestras de ejecución de evaluación interna de agentes de codificación, OpenAI informa que simplificar los mensajes y las descripciones de las herramientas:
OpenAI indica claramente que estas cifras son solo de referencia y explica que los resultados varían según la carga de trabajo.
La recomendación no es eliminar restricciones útiles.
Su objetivo es eliminar contenido duplicado.
El proceso de migración práctico es el siguiente:
Esto es especialmente importante para los productos de agente, ya que el mismo mensaje del sistema y las mismas descripciones de herramientas pueden enviarse miles de veces al día.
La serie GPT-5.6 ofrece a los desarrolladores tres opciones principales de costo-calidad.
Elegir Sol cuando la tarea pueda beneficiarse sustancialmente de capacidades de vanguardia.
Casos de uso adecuados:
Cuando la tarea requiera una capacidad de razonamiento sólida pero no necesite Sol, Terra es la opción pragmática.
Es adecuada para:
Luna es la opción natural para los siguientes escenarios:
Una arquitectura común consiste en enrutar el trabajo rutinario a Luna o Terra, y solo escalar las tareas más difíciles a Sol.
Para los sistemas de agentes, una simple comparación por token puede ser engañosa.
Considera dos modelos.
El modelo A tiene un costo menor por token de salida, pero requiere:
El modelo B tiene un precio nominal más alto, pero necesita la mitad de pasos para completar la tarea.
El segundo modelo podría seguir siendo más barato calculando por tarea completada.
Por lo tanto, los equipos que evalúan GPT-5.6 deben rastrear:
Esto es lo que realmente significa "inteligencia por token".
Para los equipos que ya usan GPT-5.5 o modelos anteriores, una comparación controlada es más útil que una migración completa inmediata.
Incluye:
OpenAI sugiere comenzar con el mismo nivel de esfuerzo de razonamiento utilizado en el modelo anterior.
Luego prueba reduciendo un nivel.
GPT-5.6 puede mantener la calidad usando menos tokens de razonamiento, pero esto debe confirmarse en tu carga de trabajo.
No asumas que el modelo insignia es automáticamente la mejor opción de producción.
Mide si Terra o Luna pueden cumplir los mismos criterios de aceptación a un costo menor.
Rastrea las lecturas y escrituras de caché.
Cuando la tasa de reutilización es alta, el contexto estable puede volverse significativamente más económico, pero los prefijos de indicaciones que cambian con frecuencia pueden no beneficiarse tanto.
Aplícalo en etapas de procesamiento con límites bien definidos, como:
Compara los resultados con las llamadas directas a herramientas normales.
Una factura de tokens más baja solo tiene sentido si la tarea final sigue alcanzando los estándares de calidad.
El objetivo de optimización correcto no es la menor cantidad de tokens.
Es obtener resultados exitosos al costo confiable más bajo.
Durante años, la competencia entre modelos de frontera ha estado dominada por una pregunta: ¿qué modelo es más capaz?
Esa pregunta sigue siendo importante.
Pero a medida que la IA entra en producción a gran escala, otra pregunta es igualmente relevante:
¿Cuánto trabajo útil puede completar un sistema por unidad de cómputo y por dólar invertido?
Los sistemas de agentes amplifican esta presión.
Una sola solicitud de usuario puede desencadenar:
Sin una orquestación cuidadosa, la factura total crece rápidamente.
GPT-5.6 refleja un cambio más amplio, desde simplemente escalar la capacidad intelectual hacia hacer que el despliegue de inteligencia sea más económico.
Sol impulsa la capacidad intelectual en el extremo superior.
Terra reduce el costo del trabajo potente de uso general.
Luna lleva la familia de modelos a cargas de trabajo de alto rendimiento.
El almacenamiento en caché de indicaciones y la orquestación programática de herramientas se enfocan en la sobrecarga del sistema alrededor de los propios modelos.
El resultado es una familia de modelos diseñada no solo en torno a puntuaciones de referencia, sino también en torno a la economía de producción.
GPT-5.6 es la familia de modelos de OpenAI para razonamiento complejo, programación, trabajo profesional, flujos de trabajo de agentes y aplicaciones de IA de alto rendimiento. La serie incluye actualmente Sol, Terra y Luna.
Sol es el nivel insignia y más capaz. Terra equilibra inteligencia y costo, mientras que Luna está optimizada para cargas de trabajo de bajo costo y alto rendimiento.
OpenAI fija el precio de Sol en $5 por millón de tokens de entrada y $30 por millón de tokens de salida, Terra en $2.50/$15, y Luna en $1/$6. El precio de entrada en caché es más bajo, y las indicaciones muy largas pueden tener reglas de precios diferentes.
La página actual del modelo API de OpenAI enumera las ventanas de contexto de Sol, Terra y Luna en 1,050,000 tokens. Cada modelo admite hasta 128,000 tokens de salida.
OpenAI informa que Sol obtiene puntuaciones más altas en varias evaluaciones de agentes de programación, incluido el Índice de Agentes de Programación de Artificial Analysis, SWE-Bench Pro, DeepSWE y Terminal-Bench 2.1. El rendimiento real en producción sigue dependiendo del repositorio, marco de agente, indicaciones y herramientas.
Las llamadas a herramientas programáticas permiten que GPT-5.6 escriba código para coordinar herramientas elegibles y manejar resultados intermedios en un entorno de ejecución gestionado. Pueden reducir los viajes de ida y vuelta del modelo y el uso de tokens en flujos de trabajo con límites bien definidos.
Por ejemplo, operaciones como filtrado, uniones, ordenamiento y agregación.
Sí. GPT-5.6 admite almacenamiento en caché automático y puntos de interrupción de caché explícitos. OpenAI afirma que las lecturas de caché reciben un 90% de descuento en la entrada, mientras que las nuevas escrituras en caché cuestan 1.25 veces el precio de entrada no almacenada en caché.
Generalmente no. Si Terra o Luna pueden cumplir los mismos criterios de evaluación a un costo menor, usar un nivel de modelo más pequeño mejora la economía de la aplicación. Las tareas complejas solo deben enrutarse a Sol cuando una mayor capacidad genere beneficios medibles.
Directorio oficial de modelos y sus especificaciones principales.
GPT-5.6 es una familia de modelos compuesta por tres niveles, no un único modelo de uso general. Sol está orientado a las capacidades de primer nivel, Terra ofrece un equilibrio más rentable para tareas de producción habituales, mientras que Luna está optimizado para escenarios de alto rendimiento.
El tema principal es la eficiencia. OpenAI reduce la carga de trabajo del modelo necesaria para completar tareas complejas combinando modelos con mayor eficiencia de tokens, caché explícito de indicaciones, inferencia continua, consumo de inferencia configurable y llamadas a herramientas de programación.
Fuentes de AIBase también informan de más optimizaciones en la pila de inferencia, incluyendo decodificación especulativa y trabajo en núcleos de GPU, que mejoran la velocidad de generación de tokens en más de un 15%.
Eficiencia. A menos que se reproduzca en publicaciones técnicas oficiales completamente documentadas de OpenAI, estos datos de bajo nivel deben considerarse como informes de fuentes.
La comprensión óptima de GPT-5.6 no es simplemente el lanzamiento de un modelo más potente, sino un intento de mejorar la economía de la inteligencia en todo el flujo de trabajo de los agentes.
Empieza con una sola frase y obtén un sitio completo en minutos.



