For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/qiqcbench-17-ai-agents-tested-on-49-quant-cd2ff2ac.md.
Los agentes de IA están empezando a ir más allá de las ventanas de chat y los editores de código para incorporarse a los flujos de trabajo c...
Los agentes de IA están empezando a ir más allá de las ventanas de chat y los editores de código para incorporarse a los flujos de trabajo científicos.
En 2026, esta tendencia se hizo especialmente visible en la computación cuántica. Los grupos de investigación y las empresas comenzaron a mostrar sistemas de IA capaces de ayudar a escribir software cuántico, ajustar equipos de laboratorio e iterar sobre experimentos de medición.
Esto plantea una pregunta mucho más difícil:
Aunque un agente de IA conozca la física, ¿se puede confiar en que ejecute de forma fiable un flujo de trabajo científico de principio a fin?
Un equipo de investigadores de instituciones como la National University of Singapore, Nanyang Technological University, Georgia Tech, the University of Chicago, Boston College, the Unitary Foundation y GaugeForge creó un benchmark específicamente centrado en este problema.
Su artículo, “Evaluating Verified Autonomy in Quantum Engineering”, presenta:
El artículo presenta Quantum-Harbor y QIQCBench como un banco de pruebas para la ingeniería cuántica autónoma verificable.
Los investigadores evaluaron 17 sistemas agentivos de vanguardia.
La puntuación máxima de aprobado o suspenso fue del 78 %, mientras que el sistema más débil alcanzó solo el 3 %.
Sin embargo, el hallazgo principal no es la clasificación.
Es la diferencia entre saber qué se debe hacer y completar de forma fiable un flujo de trabajo experimental con evidencias que realmente respalden la conclusión final.
Limitación importante: Todas las evaluaciones del benchmark descritas en el artículo se realizaron mediante simulación. El estudio no demuestra que estos agentes sean ya suficientemente seguros o fiables para operar laboratorios cuánticos reales sin supervisión.
Imaginemos dejar un laboratorio cuántico durante la noche bajo el control de un agente de IA.
A la mañana siguiente, informa:
La calibración ha convergido.
El rendimiento mejoró un 42 %.
Tarea completada.
Suena bien.
Pero en un laboratorio real, las preguntas de seguimiento serían evidentes:
Esta es la diferencia entre un agente capaz de producir una respuesta plausible y un agente en el que se puede confiar como colaborador experimental.
En ingeniería cuántica, los errores pueden ser costosos.
El hardware tarda en enfriarse, la calibración deriva, los tiempos de coherencia son breves, los errores de control se acumulan y las mediciones consumen tiempo y recursos reales.
Una alucinación dentro de una ventana de chat resulta inconveniente.
Una alucinación conectada a equipos científicos puede convertirse en un fallo físico.
Ese es el problema que el artículo denomina Verified Autonomy.
La idea central es sencilla:
Un agente científico no debería recibir crédito simplemente porque su respuesta final parezca correcta. Su conclusión debe estar respaldada por evidencias producidas durante el flujo de trabajo, o el diseño enviado debe superar una evaluación con datos ocultos nuevos.
El artículo fuente contrasta este enfoque con los benchmarks de preguntas y respuestas más convencionales.
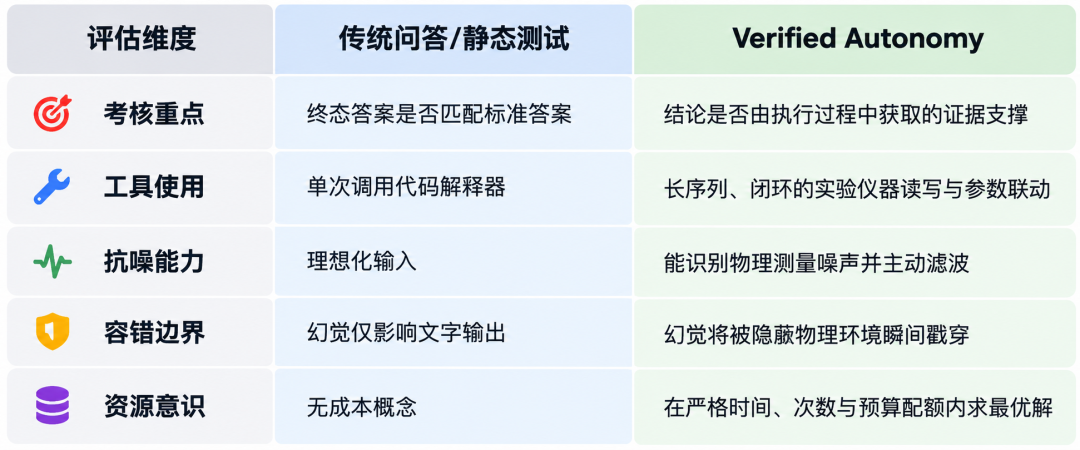
Verified Autonomy evalúa las evidencias, el uso de herramientas, la robustez y las decisiones sobre recursos, en lugar de comprobar únicamente una respuesta final.
Un benchmark estático podría plantear:
Pregunta → Respuesta del modelo → Comparación con la referencia
Quantum-Harbor evalúa en cambio un ciclo más largo:
Observar
   ↓
Formular una hipótesis
   ↓
Elegir un experimento
   ↓
Ejecutar el experimento
   ↓
Inspeccionar resultados ruidosos
   ↓
Actualizar la estrategia
   ↓
Decidir si continuar
   ↓
Presentar una conclusión
   ↓
Verificar esa conclusión con evidencias o datos ocultos
El cambio clave es que la traza de ejecución pasa a formar parte de la evaluación.
Quantum-Harbor proporciona al agente un entorno de trabajo realista, al tiempo que mantiene oculta la información crítica de evaluación.
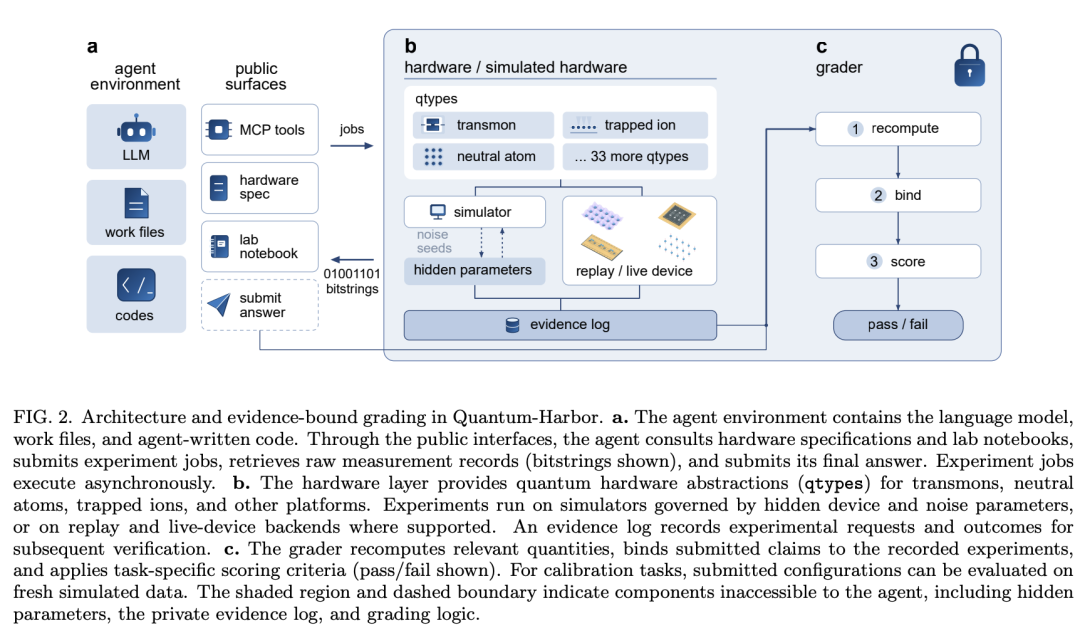
Quantum-Harbor separa el espacio de trabajo del agente de los parámetros ocultos del hardware, los registros de evidencias y la lógica de evaluación.
El entorno visible del agente puede incluir:
Los agentes pueden escribir código experimental e interactuar mediante interfaces públicas.
El artículo describe un acceso a herramientas basado en el Model Context Protocol (MCP) y en interfaces de software científico.
El artículo fuente destaca herramientas conocidas de ingeniería cuántica como Qiskit y QCoDeS como ejemplos del software que un agente puede utilizar en un flujo de trabajo realista.
Detrás de la interfaz pública existe un entorno sidecar oculto.
Contiene información como:
El hardware virtual puede representar varias abstracciones de plataformas, entre ellas:
El agente no obtiene acceso directo a la verdad fundamental oculta.
Esto es deliberado.
Un agente científico útil debe inferir lo que ocurre a partir de experimentos, no leer la respuesta directamente del simulador.
Sobre Quantum-Harbor, los investigadores construyeron QIQCBench.
El benchmark contiene 49 tareas redactadas por expertos e implementadas en 36 abstracciones de sistemas cuánticos, o qtypes.
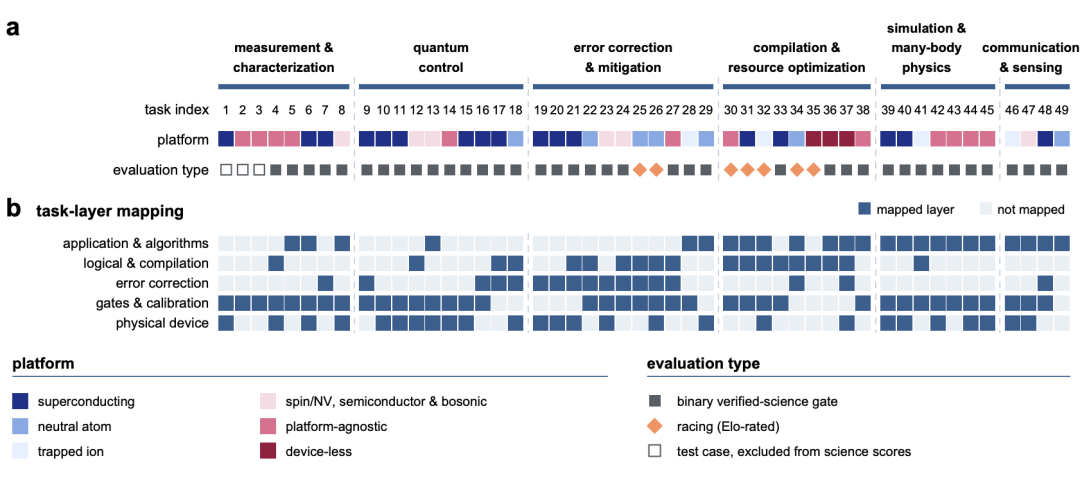
QIQCBench abarca seis categorías científicas y cinco capas del ecosistema de la computación cuántica.
Las tareas cubren seis categorías científicas:
También se distribuyen en cinco capas del ecosistema de la computación cuántica:
Una aclaración útil del artículo es que las 49 tareas se dividen en distintos tipos de evaluación.
| Tipo de tarea | Cantidad | Cómo se utiliza |
|---|---|---|
| Tareas científicas binarias de aprobado o suspenso | 39 | Benchmark principal de tasa de aprobación verificada |
| Tareas de competición | 7 | Comparación del rendimiento continuo entre soluciones factibles |
| Casos de prueba de infraestructura | 3 | Excluidos de las puntuaciones científicas |
Para las tareas de competición, los autores comparan soluciones factibles y calculan una clasificación de estilo Elo mediante un modelo de Bradley–Terry.
Esto importa porque el intervalo destacado del 78 % al 3 % se refiere a las 39 tareas de aprobado o suspenso, no a las 49 tareas tratadas como si fueran idénticas.
Cada tarea se parece más a un pequeño proyecto de laboratorio que a un examen de opción múltiple.
El agente puede tener que decidir:
Estas decisiones importan porque el tiempo, las interacciones y los presupuestos experimentales son limitados.
Un modelo puede conocer la fórmula correcta y aun así fallar por elegir mediciones deficientes.
También puede fallar por continuar experimentando después de haber reunido suficiente información.
Esto convierte la gestión de recursos en parte de la competencia científica.
El artículo fuente resume la filosofía de verificación del benchmark mediante tres comprobaciones prácticas.
¿La conclusión final se desprende realmente de las mediciones que el agente obtuvo durante la ejecución?
Si un agente afirma haber descubierto un parámetro que nunca midió, la respuesta no debería recibir el crédito completo simplemente porque el número resulte aproximado.
¿Se comportó el agente de forma coherente durante todo el proceso?
Un agente que encuentra una buena solución y después consume el presupuesto restante en experimentos innecesarios puede seguir siendo poco fiable.
¿La calibración, el modelo o la estrategia enviados pueden superar pruebas con condiciones ocultas nuevas?
Esto permite detectar sistemas que se ajustan en exceso a observaciones visibles o que tienen éxito accidentalmente en una configuración simulada concreta.
Por tanto, el benchmark intenta rechazar tres atajos:
Respuesta memorizada
Evidencia alucinada
Estrategia sobreajustada
Un resultado satisfactorio debe estar respaldado por el propio flujo de trabajo.
Los autores evaluaron 17 sistemas agentivos de vanguardia de ocho proveedores.
El artículo utilizó:
Cada sistema se ejecutó con el nivel de esfuerzo de razonamiento más alto o casi más alto y trató cada tarea tres veces de forma independiente.
Esto convierte la evaluación en una comparación de sistemas agentivos, no en una comparación pura de modelos base.
La calidad del arnés, la integración de herramientas, las instrucciones y el comportamiento durante la ejecución influyen en el resultado.
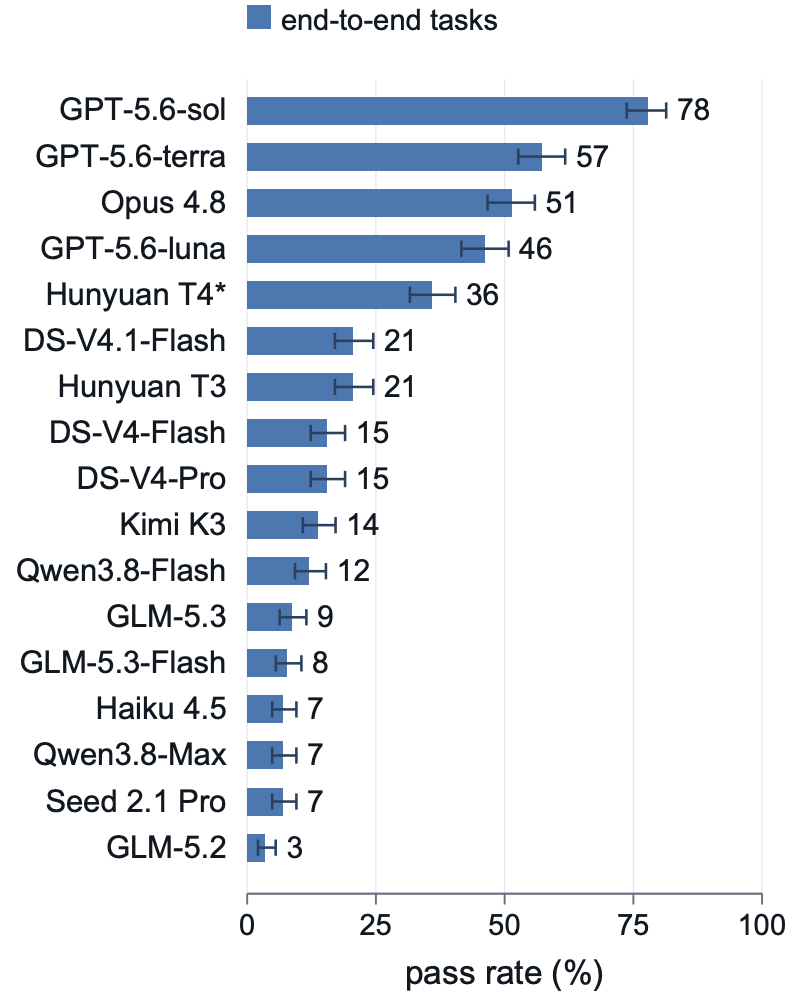
Las tasas de aprobación en las 39 tareas de aprobado o suspenso oscilan entre el 78 % y el 3 %.
La clasificación publicada en el artículo es:
| Puesto | Sistema agentivo | Tasa de aprobación |
|---|---|---|
| 1 | GPT-5.6-sol | 78 % |
| 2 | GPT-5.6-terra | 57 % |
| 3 | Opus 4.8 | 51 % |
| 4 | GPT-5.6-luna | 46 % |
| 5 | Hunyuan T4* | 36 % |
| 6 | DS-V4.1-Flash | 21 % |
| 7 | Hunyuan T3 | 21 % |
| 8 | DS-V4-Flash | 15 % |
| 9 | DS-V4-Pro | 15 % |
| 10 | Kimi K3 | 14 % |
| 11 | Qwen3.8-Flash | 12 % |
| 12 | GLM-5.3 | 9 % |
| 13 | GLM-5.3-Flash | 8 % |
| 14 | Haiku 4.5 | 7 % |
| 15 | Qwen3.8-Max | 7 % |
| 16 | Seed 2.1 Pro | 7 % |
| 17 | GLM-5.2 | 3 % |
El sistema más potente, GPT-5.6-sol, se encuentra claramente por delante.
Pero los autores del benchmark plantean una cuestión más amplia.
Algunos sistemas que parecen bastante próximos en los benchmarks agentivos convencionales se distribuyen por casi todo el rango de QIQCBench cuando tienen que interactuar con entornos científicos dinámicos.
Esto sugiere que la autonomía científica pone a prueba un perfil de capacidades diferente.
Los resultados son especialmente reveladores cuando se clasifican los fallos.
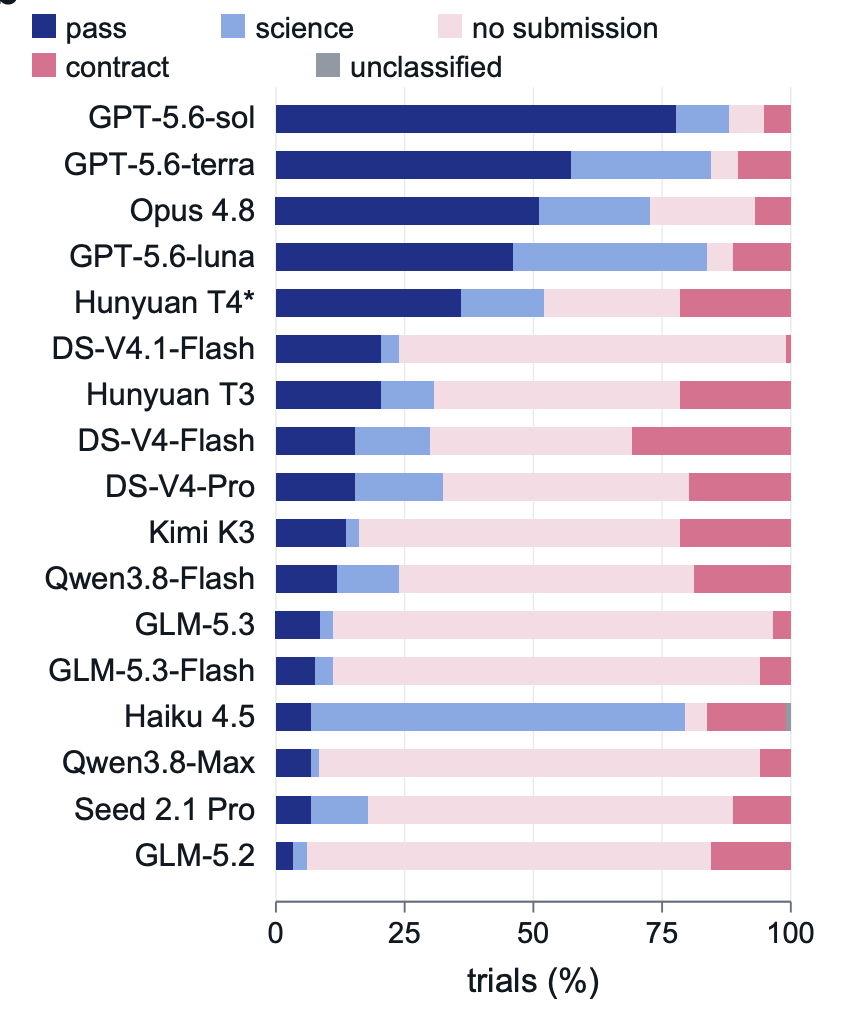
Muchos fallos se deben a la ausencia de una entrega final, a la invalidez científica o a incumplimientos del contrato, no únicamente a la falta de conocimientos de manual.
El artículo informa de 1.510 ensayos fallidos.
De ellos:
937 = sin entrega final
Esto representa aproximadamente el 62 % de todos los fallos.
Muchos agentes simplemente agotaron el presupuesto, quedaron atrapados en bucles o continuaron experimentando hasta que terminó la tarea.
Entre los fallos restantes, el artículo señala que el 54 % fueron fallos científicos.
En otras palabras, incluso cuando el agente enviaba algo, la conclusión o el método físico a menudo no superaban la verificación.
La lección central es contundente:
Un agente puede comprender la mecánica cuántica, escribir código funcional y aun así ser un mal experimentalista.
El primer estudio de caso se centra en la cirugía de retícula, una operación de computación cuántica tolerante a fallos utilizada para combinar parches de códigos de superficie e implementar operaciones lógicas como CNOT.
El benchmark proporciona deliberadamente al agente datos antiguos del cuaderno.
Esas mediciones anteriores describen parches de código aislados.
Pero cuando los parches se unen, la unión puede introducir un ruido correlacionado nuevo que no estaba presente en la calibración anterior.
Una estrategia débil es:
Leer el cuaderno antiguo
        ↓
Confiar en el modelo de ruido antiguo
        ↓
Utilizar la configuración antigua del decodificador
        ↓
Fallar ante las correlaciones de la unión
Un agente más sólido comprende que unir los parches cambia la situación física.
Realiza nuevas mediciones del sistema combinado, estima las correlaciones introducidas y reajusta el decodificador.
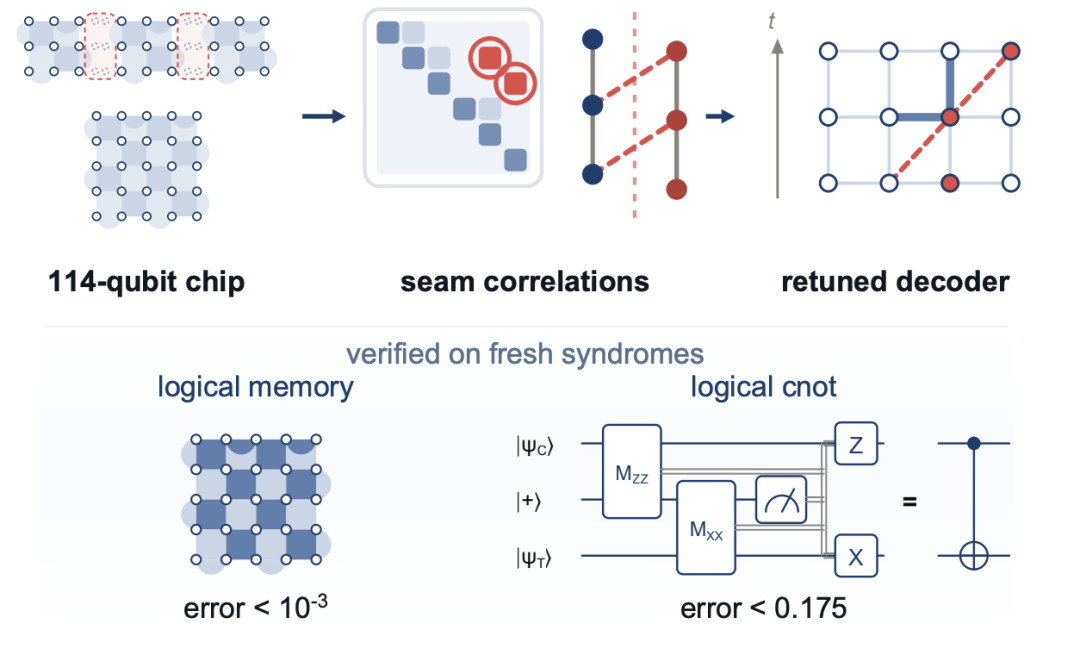
Los agentes sólidos vuelven a medir el sistema unido, identifican las correlaciones de la unión y reajustan el decodificador en lugar de confiar en datos de calibración obsoletos.
En la ejecución exitosa destacada por el artículo fuente, la tasa de error de memoria lógica resultante alcanzó:
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
6,65 × 10^-4 por ciclo
Lo importante no es el número por sí solo.
Lo importante es que el agente obtuvo el resultado al identificar que los datos antiguos ya no coincidían con la configuración física actual.
Este es exactamente el tipo de comportamiento que Verified Autonomy está diseñado para recompensar.
El segundo estudio de caso evalúa si un agente puede construir un modelo sustituto útil para un sistema oculto de 60 cúbits.
El sistema se controla mediante seis parámetros.
El agente recibe un presupuesto experimental fijo y debe utilizar sus mediciones para predecir el comportamiento en 40 configuraciones de entrada reservadas.
Para cada entrada, la tarea evalúa 1.770 correlaciones de dos cúbits.
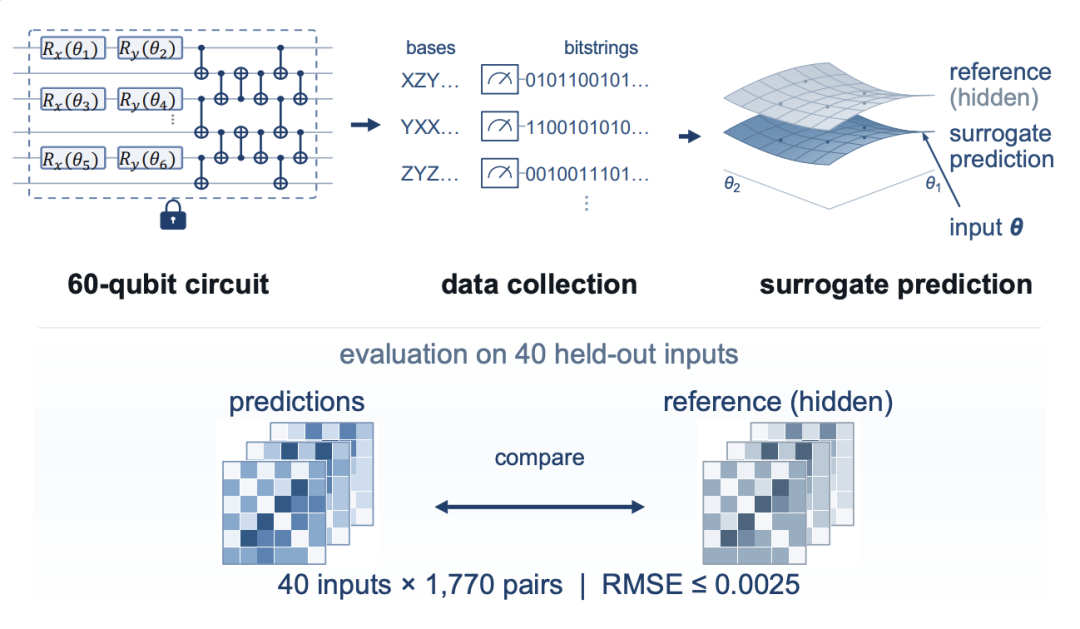
El agente debe recopilar datos informativos y predecir 1.770 correlaciones por pares en 40 entradas ocultas.
Este es un problema clásico de diseño experimental.
Entre las estrategias deficientes se incluyen:
El agente distribuye las mediciones por regiones poco informativas del espacio de parámetros y agota su presupuesto antes de recopilar datos útiles.
El agente realiza un pequeño número de mediciones, decide que ya comprende el sistema y produce un modelo que falla estrepitosamente en las entradas ocultas.
El agente queda atrapado depurando código o repitiendo operaciones similares hasta que expira el presupuesto de tiempo o de interacciones.
Estos fallos no consisten en no recordar una ecuación física.
Son fallos de estrategia científica.
El desglose de fallos del benchmark hace que esto resulte especialmente visible.
Más de novecientos ensayos fallidos terminaron sin una respuesta final.
Algunos agentes continuaron ejecutando experimentos hasta agotar el presupuesto.
Otros quedaron atrapados en correcciones de código repetitivas.
El artículo señala que siete sistemas agotaron su presupuesto antes de enviar una respuesta en más del 60 % de sus ensayos.
Este es un hallazgo importante para los agentes científicos.
Un asistente experimental real debe saber cuándo una medición adicional ya no compensa su coste.
Por tanto, la autonomía científica incluye una regla de detención.
Más datos podrían ayudar
        ≠
Siempre merece la pena recopilar más datos
Un agente incapaz de gestionar este equilibrio puede resultar costoso incluso cuando sus conocimientos de física son sólidos.
El tercer caso no es una sola tarea, sino una categoría completa.
La simulación y la física de muchos cuerpos incluye problemas como:
Esta se convirtió en la parte más difícil de QIQCBench.
La tasa de aprobación agrupada de la categoría fue de solo 15 %.
Más sorprendente aún:
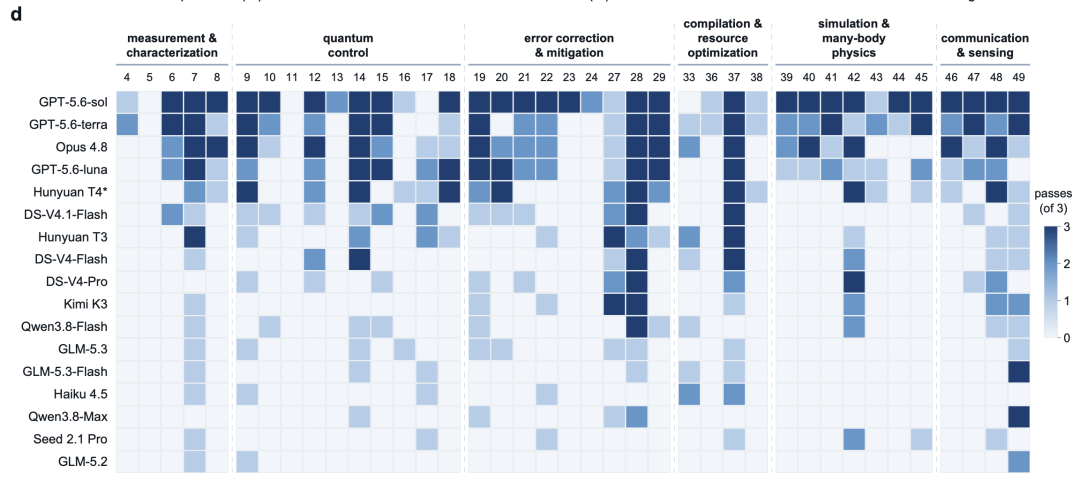
La simulación y la física de muchos cuerpos ponen de manifiesto una marcada diferencia entre los sistemas principales y el resto.
Aquí es donde el benchmark separa con mayor claridad la familiaridad con los libros de texto de la inferencia científica.
Un modelo de código puede ser capaz de generar un script de simulación plausible.
Eso no significa que pueda inferir el modelo físico correcto a partir de observaciones ruidosas de un sistema desconocido.
Son capacidades diferentes.
Otro resultado útil del artículo es que el éxito a menudo no es reproducible.
Los autores ejecutan cada par sistema-tarea tres veces.
De los 249 pares sistema-tarea que tuvieron éxito al menos una vez, solo alrededor del 34 % superó los tres intentos.
Esto significa que un modelo puede demostrar capacidad sin demostrar fiabilidad.
Para la automatización científica, esta distinción es fundamental.
Un sistema que resuelve una tarea una de cada tres veces puede ser un prototipo de investigación interesante.
No es necesariamente algo en lo que un laboratorio deba confiar sin supervisión.
¿Por qué fallan tan estrepitosamente los modelos de lenguaje avanzados en estas tareas?
El artículo fuente describe la respuesta como una brecha entre el espacio lingüístico y las leyes físicas.
Es una forma útil de describirla.
Los modelos de gran escala pueden aprender:
Pero la ciencia experimental es un ciclo cerrado de retroalimentación:
Hipótesis
   ↓
Experimento
   ↓
Observación
   ↓
Refutar o respaldar
   ↓
Actualizar la estrategia
   ↓
Repetir
El ciclo importa más que cualquier paso individual.
Un agente puede fallar incluso cuando cada acción individual parece razonable.
Por ejemplo:
Por eso el benchmark se centra en las evidencias.
El mundo físico no recompensa una explicación convincente si el experimento nunca la respaldó.
QIQCBench no es principalmente útil porque produzca otra clasificación de modelos.
Su contribución más importante es el marco de evaluación.
Un agente científico autónomo creíble debería evaluarse mediante preguntas como:
Estos criterios son aplicables más allá de la computación cuántica.
Son relevantes para:
El problema común es que la acción de un modelo tiene consecuencias fuera de la interfaz de texto.
El artículo fuente utiliza la expresión “el mundo físico real”, pero el propio artículo científico es más prudente.
Todas las evaluaciones del estudio se realizaron mediante simulación.
Quantum-Harbor está diseñado para modelar restricciones experimentales realistas y parámetros ocultos de los dispositivos, pero esto no equivale a operar un refrigerador de dilución, un sistema láser, un conjunto de átomos neutros o un procesador cuántico superconductor en funcionamiento.
Los autores señalan explícitamente esta limitación.
Presentan Quantum-Harbor como una forma de medir el progreso hacia una ingeniería cuántica autónoma verificable.
La fiabilidad en hardware experimental real aún debe demostrarse.
Esta distinción importa porque los laboratorios reales añaden problemas adicionales:
Superar QIQCBench no constituye, por tanto, una autorización para entregar a una IA las llaves de un laboratorio real.
Es una prueba más exigente que las preguntas y respuestas estáticas, pero sigue siendo un banco de pruebas.
Los investigadores también están abriendo la evaluación a una comunidad más amplia mediante el Agentic Quantum Coding Challenge.
El desafío se basa en QIQCBench y en el entorno Quantum-Harbor.
El objetivo no es simplemente presentar un modelo base más potente.
Los participantes también pueden mejorar el sistema agentivo que lo rodea:
Esto es importante porque el artículo evalúa sistemas agentivos, no modelos aislados.
Un arnés mejor puede mejorar significativamente el mismo modelo subyacente.
El artículo fuente enlaza con la página pública del desafío:
https://gaugeforge.github.io/qiqc-challenge/
La fuente también incluía un cartel promocional del desafío con un código QR. Se excluye intencionadamente de esta edición en Markdown porque la imagen es promocional y contiene un código QR de registro, no contenido científico.
La respuesta de este benchmark es: todavía no.
Los sistemas más potentes demuestran que la ingeniería cuántica autónoma empieza a ser técnicamente plausible.
GPT-5.6-sol supera el 78 % de las tareas científicas binarias del benchmark, y los sistemas principales pueden completar flujos de trabajo difíciles, como el reajuste de decodificadores y el modelado sustituto de 60 cúbits.
Pero los modos de fallo siguen siendo demasiado graves para ignorarlos.
Los agentes:
La brecha entre capacidad y fiabilidad sigue siendo amplia.
Precisamente por eso Verified Autonomy es importante.
La pregunta para los futuros agentes científicos ya no es simplemente:
¿Puede el modelo resolver este problema?
Es:
¿Puede el sistema ejecutar el flujo de trabajo completo, utilizar los recursos de forma responsable, producir evidencias y seguir siendo correcto cuando cambia el entorno?
Quantum-Harbor es un laboratorio cuántico virtual controlado diseñado para evaluar agentes de IA. Proporciona a los agentes herramientas y mediciones realistas, al tiempo que mantiene ocultos los parámetros de los dispositivos, la lógica de evaluación y las condiciones de validación reservadas.
QIQCBench es un benchmark construido sobre Quantum-Harbor con 49 tareas de ingeniería cuántica redactadas por expertos. Abarca medición, control, corrección de errores, compilación, física de muchos cuerpos, comunicación y sensado.
GPT-5.6-sol ocupó el primer puesto en las 39 tareas binarias de aprobado o suspenso, con una tasa de aprobación del 78 %. Le siguieron GPT-5.6-terra, con un 57 %, y Claude Opus 4.8, con un 51 %.
No. El artículo afirma explícitamente que todas las evaluaciones publicadas se realizaron mediante simulación. La fiabilidad en hardware real sigue siendo un problema abierto.
Verified Autonomy significa evaluar a un agente por las evidencias generadas durante la ejecución, no únicamente por su respuesta final. Una afirmación debe estar respaldada por mediciones que el agente haya obtenido realmente, o un diseño enviado debe superar pruebas con datos ocultos nuevos.
Una gran parte de los fallos se debió a la gestión del flujo de trabajo, no a la falta de conocimientos de manual. De los 1.510 ensayos fallidos, 937 no tuvieron una entrega final, a menudo porque los agentes agotaron los presupuestos o quedaron atrapados en largos bucles de ejecución.
Estas tareas exigen que los agentes infieran comportamientos físicos ocultos a partir de observaciones, en lugar de limitarse a seguir un procedimiento conocido. La categoría tuvo una tasa de aprobación agrupada de aproximadamente el 15 %, y los tres sistemas principales quedaron muy por delante de los 14 restantes.
El equipo de investigación ha anunciado el Agentic Quantum Coding Challenge en torno a QIQCBench y Quantum-Harbor. La página pública del desafío está disponible a través del sitio GitHub Pages de GaugeForge.
Quantum-Harbor y QIQCBench alejan la evaluación de los agentes de IA de las preguntas y respuestas estáticas y la acercan al tipo de flujo de trabajo que los sistemas científicos realmente necesitan: elegir experimentos, interactuar con herramientas, interpretar observaciones ruidosas, gestionar presupuestos limitados y justificar las afirmaciones finales con evidencias.
Los sistemas principales ya son impresionantes. GPT-5.6-sol alcanza una tasa de aprobación del 78 % en las tareas binarias, mientras que GPT-5.6-terra y Opus 4.8 le siguen con un 57 % y un 51 %. Sin embargo, el benchmark también muestra que muchos sistemas avanzados fallan al quedar atrapados, gastar en exceso los presupuestos experimentales, confiar en supuestos obsoletos o enviar conclusiones que no pueden verificarse de forma independiente.
Dado que todas las evaluaciones se realizaron mediante simulación, el trabajo no demuestra que la IA autónoma esté preparada para controlar hardware cuántico real sin supervisión. En cambio, proporciona una forma más rigurosa de medir cuánto se acercan los agentes a ese objetivo.
Para la IA aplicada a la ciencia, el próximo hito no es simplemente una respuesta más inteligente, sino un flujo de trabajo experimental completo cuyas evidencias, uso de recursos y conclusiones puedan verificarse de forma independiente.
Empieza con una sola frase y obtén un sitio completo en minutos.



