For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/recursive-self-improvement-what-ai-resear-557e0db8.md.
Los sistemas de IA están asumiendo una parte cada vez mayor del trabajo que implica construir IA: escribir software, depurar infraestructura...
Los sistemas de IA están asumiendo una parte cada vez mayor del trabajo que implica construir IA: escribir software, depurar infraestructura, ejecutar experimentos y sugerir qué probar después. Esto convierte a la auto-mejora recursiva, normalmente abreviada como RSI, en una cuestión de investigación cada vez más práctica.
La distinción relevante es si la IA acelera un proceso dirigido por humanos o si puede diseñar y desarrollar de forma independiente un sucesor más potente. El informe proporcionado de BAAI describe una industria que avanza hacia lo segundo. La investigación pública ofrece evidencias concretas de lo primero, junto con una incertidumbre considerable sobre hasta dónde llegará ese progreso.
En el debate de investigación de Anthropic, la RSI completa significa que un sistema llega a ser capaz de diseñar y desarrollar de forma autónoma a su sucesor. Un agente de programación que mejora un script de entrenamiento puede contribuir a ese proceso sin completar todo el ciclo.
Existen varias capacidades distintas implicadas:
El éxito en un nivel no demuestra el éxito en todos los niveles posteriores. Anthropic afirma explícitamente que, según su análisis, la RSI completa aún no se ha alcanzado y no es inevitable.
Anthropic informa que, en mayo de 2026, Claude había creado más del 80 % del código integrado en su base de código. Esta es una medida de atribución para el código integrado, no una afirmación de que la IA haya tomado más del 80 % de todas las decisiones de ingeniería.
La empresa también informa que la producción habitual de código por ingeniero en el segundo trimestre de 2026 fue aproximadamente ocho veces superior a su nivel de 2024, medida en líneas de código integradas por día. Su propia advertencia es esencial: las líneas de código miden la cantidad de manera imperfecta y no deben interpretarse como un aumento de ocho veces en la productividad útil.
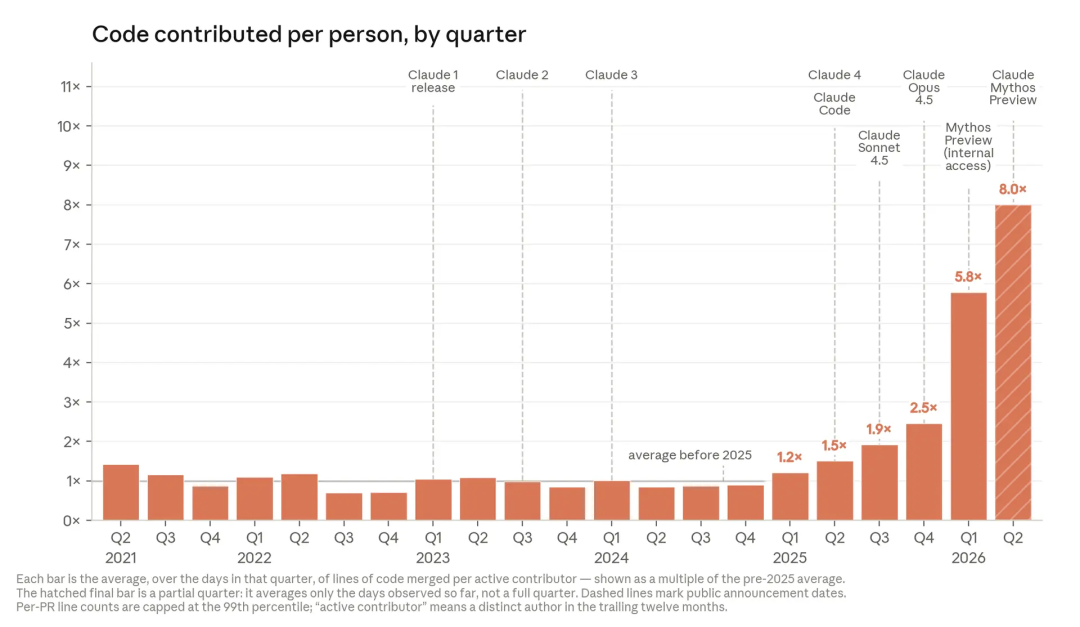
Gráfico de Anthropic reproducido en el artículo de Xinzhiyuan en BAAI Hub.
El cambio práctico es que un ingeniero puede dirigir y revisar más trabajo sin escribir cada implementación. Aun así, los objetivos, la calidad del código, la infraestructura compartida y la capacidad de revisión siguen siendo limitaciones. Esto no demuestra que la revisión humana haya dejado de ser necesaria.
Escribir una implementación es solo una parte de la investigación. Un agente también necesita ejecutar experimentos, inspeccionar los resultados y decidir si un cambio realmente ayudó.
Anthropic describe una prueba de optimización repetida en la que un modelo recibe código de entrenamiento e intenta hacerlo más rápido mientras preserva las comprobaciones de corrección. Los resultados mejoraron notablemente entre generaciones de modelos. La empresa advierte que la aceleración absoluta depende de cuánto margen de optimización exista en el código inicial; no es una medición de una aceleración equivalente en el entrenamiento de modelos de frontera.
Su proyecto de investigación automatizada de débil a fuerte proporciona otro ejemplo. Los agentes podían proponer y ejecutar experimentos dentro de un problema y un marco de puntuación seleccionados por humanos. Esto es evidencia de automatización de la investigación dentro de límites especificados, no una demostración de que el sistema eligiera de manera independiente la agenda de investigación más valiosa.
SWE-bench evalúa cambios de software frente a tareas de repositorios y pruebas. Los horizontes temporales de finalización de tareas de METR examinan la duración de las tareas que los modelos pueden completar con niveles de fiabilidad especificados.
Estas mediciones responden a preguntas diferentes. Un sistema puede mejorar al corregir problemas de repositorios o al completar tareas más largas sin ser capaz de planificar por sí solo un programa exitoso de desarrollo de modelos.
Los resultados de horizonte temporal también son probabilísticos. La duración de una tarea en un benchmark no significa que el agente vaya a trabajar de forma fiable durante esa misma cantidad de tiempo real en cualquier proyecto. Las referencias humanas, los umbrales de éxito, el acceso a herramientas y la distribución de tareas son factores importantes.
El artículo fuente cita conversaciones en redes sociales sobre agentes internos, ciclos de lanzamiento más cortos, modelos no publicados y grandes resultados científicos. Estas afirmaciones pueden señalar temas que merecen investigación, pero no demuestran de forma independiente un ciclo autónomo de auto-mejora.
Los intervalos de lanzamiento más cortos pueden tener varias explicaciones. Que un modelo resuelva matemáticas difíciles demuestra una capacidad en esos problemas; no demuestra por sí mismo que el modelo haya mejorado su propio proceso de entrenamiento. Del mismo modo, una afirmación anónima sobre el modelo interno de un laboratorio no sustituye a un informe técnico con evidencia reproducible.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
La conclusión defendible es más acotada: las divulgaciones públicas muestran que la IA realiza una proporción creciente de la ingeniería y de cierta investigación experimental. Que este progreso se convierta en RSI completa sigue siendo una cuestión abierta.
Anthropic analiza tanto los posibles beneficios como los riesgos de un desarrollo cada vez más automatizado. Los agentes de investigación más capaces podrían acelerar el trabajo científico, al tiempo que harían más exigentes la verificación, la monitorización y la alineación.
El mismo proceso también puede crear cuellos de botella operativos habituales. Si los agentes generan código más rápido de lo que las personas pueden revisarlo, una generación más rápida no se traduce directamente en una implementación fiable más rápida. La disponibilidad de cómputo, la calidad de los experimentos y las decisiones sobre qué construir siguen siendo relevantes incluso cuando la implementación se abarata.
Por eso, una evaluación de la RSI debe seguir la evidencia en cada etapa: qué hizo el agente, quién seleccionó su objetivo, qué recursos utilizó y cómo se comprobó el resultado.
RSI significa auto-mejora recursiva. En este contexto, se refiere a que un sistema de IA llega a ser capaz de diseñar y desarrollar de forma autónoma un sucesor más potente, en lugar de limitarse a ayudar a un humano a mejorar software.
La generación de código muestra que una parte del proceso de desarrollo puede automatizarse. La RSI completa requeriría una combinación mucho más amplia de dirección de investigación, implementación, entrenamiento y evaluación, por lo que una alta proporción de código creado por IA no es evidencia suficiente.
Se refiere al código atribuido a Claude e integrado en la base de código de Anthropic en mayo de 2026. No debe interpretarse como la proporción de todo el trabajo de la empresa realizado de forma autónoma ni como la proporción de decisiones estratégicas tomadas por IA.
Pueden indicar un cambio en el volumen de producción, pero no miden directamente la utilidad, la mantenibilidad ni el valor de negocio. Anthropic advierte que su aumento de ocho veces en la producción de código probablemente sobreestima la ganancia real de productividad.
Describen el rendimiento en una colección concreta de tareas con niveles de éxito establecidos, utilizando las duraciones humanas de las tareas como referencia. No garantizan que un agente pueda completar cualquier asignación real de duración equivalente.
Sí; un agente puede diseñar y ejecutar experimentos dentro de un problema y un marco de puntuación proporcionados por humanos. Esto puede ser una automatización valiosa de la investigación, mientras deja las decisiones de nivel superior en manos de las personas.
El debate principal de Anthropic afirma explícitamente que no es inevitable. El criterio de investigación, el cómputo, la infraestructura, la evaluación y otros cuellos de botella podrían limitar o cambiar la trayectoria, y las previsiones deben mantenerse separadas de los resultados demostrados.
La evidencia pública respalda un aumento sustancial de la programación asistida por IA y de la automatización limitada de la investigación. Estos avances hacen que la posibilidad de la auto-mejora recursiva merezca ser analizada, pero no demuestran que ya exista un ciclo completamente autónomo de desarrollo de sucesores.
La pregunta clave es qué partes del desarrollo de IA puede realizar y verificar un sistema de manera independiente, no cuán espectacular parezca su calendario de lanzamientos o el titular de un benchmark.
Empieza con una sola frase y obtén un sitio completo en minutos.



