For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/robobrain-orca-multimodal-world-model.md.
RoboBrain Orca explora un cambio desde la predicción de resultados aislados hasta la modelización de transiciones de estado mundial. En luga...
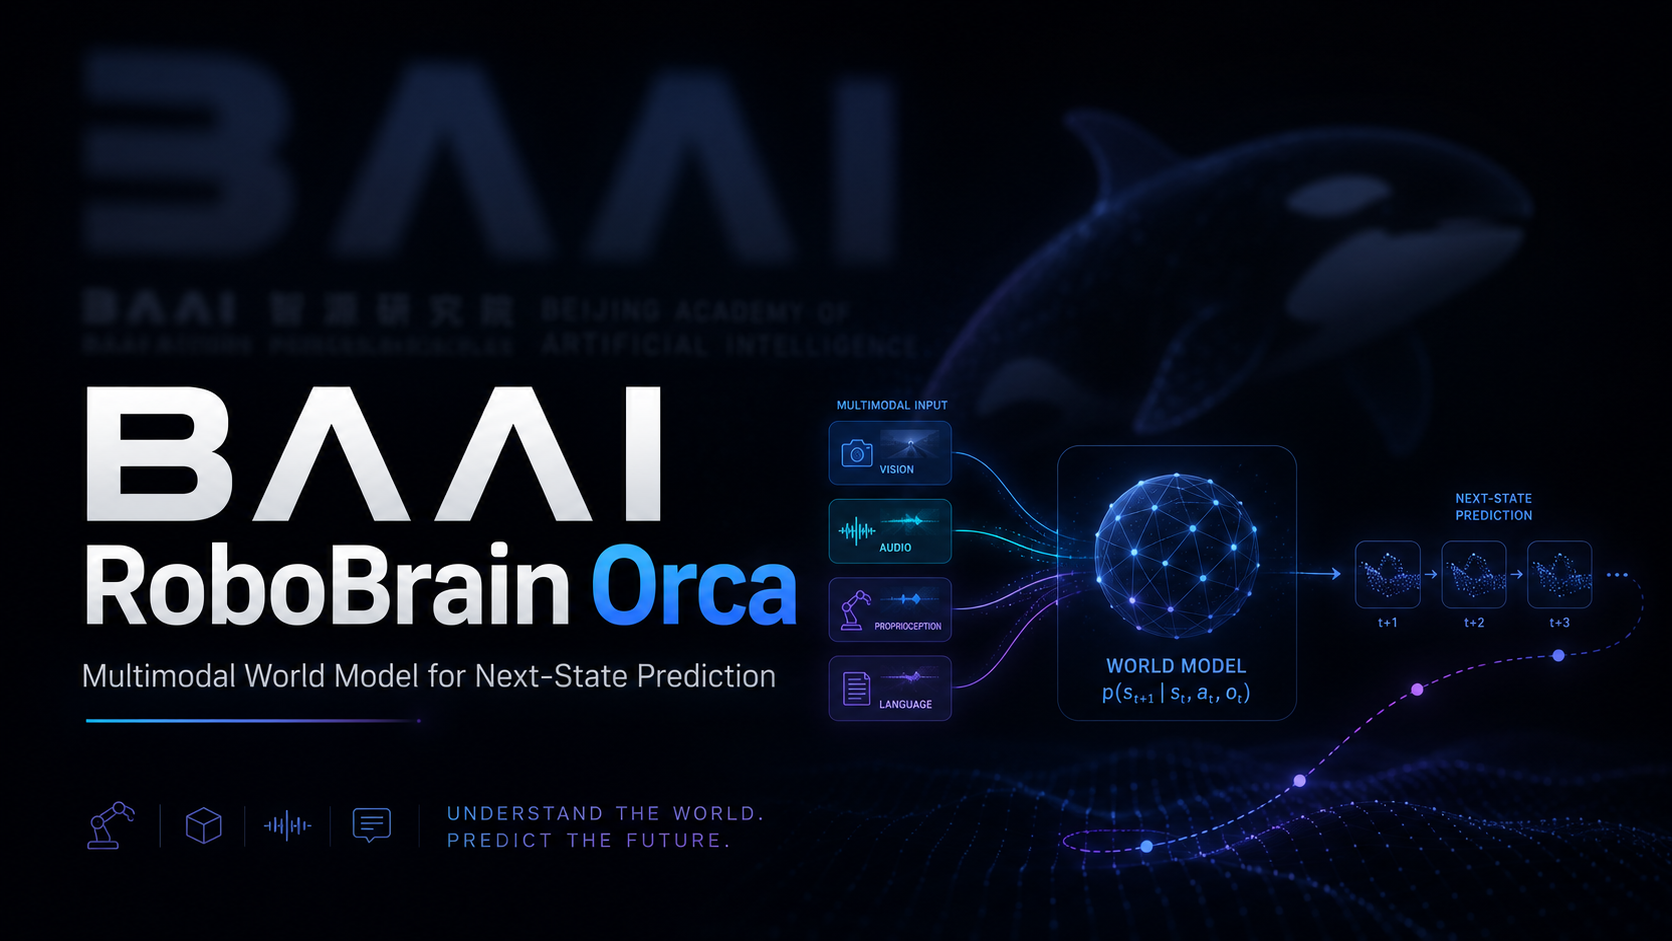
Los sistemas modernos de IA ya pueden hacer muchas cosas impresionantes. Un modelo de lenguaje puede responder preguntas y escribir código. Un modelo de imagen o video puede generar contenido visual realista. Un modelo robótico puede aprender a agarrar, colocar o mover objetos.
Pero estas habilidades a menudo provienen de objetivos de predicción separados. Un modelo de lenguaje predice el siguiente token. Un modelo de video predice el siguiente fotograma. Una política robótica predice la siguiente acción. Cada objetivo es útil, pero aún deja una pregunta más profunda: ¿entiende el modelo cómo cambia el mundo mismo?
El proyecto RoboBrain Orca de BAAI, presentado en el informe técnico "Orca: The World is in Your Mind", explora este problema desde la perspectiva de la representación mundial. Orca no se posiciona simplemente como un chatbot más potente, un generador de imágenes más bonito o una política de imitación directa para robots. Su idea central es más fundamental: aprender primero una representación latente compartida de los estados del mundo, luego leer esa representación para generar comprensión del lenguaje, predicción de imágenes y generación de acciones.
El artículo original parte de una observación simple pero importante: la IA puede generar resultados, pero la generación de resultados no es lo mismo que la comprensión del mundo.
Por ejemplo:
Estas preguntas apuntan a un objetivo más amplio. Un modelo mundial útil no solo debería predecir una salida externa. Debería construir una representación interna del estado del mundo y la transición de estado.
La página del proyecto de Orca y el informe técnico describen esto como un cambio de Predicción del Siguiente X a Predicción del Siguiente Estado. En lugar de predecir por separado el siguiente token, el siguiente fotograma o la siguiente acción, Orca intenta aprender cómo evoluciona un estado del mundo bajo dinámicas naturales, condiciones de eventos e intenciones de tarea.
Página de inicio del proyecto: https://orca-wm.github.io
Informe técnico: https://arxiv.org/abs/2606.30534
Después del lanzamiento, Orca atrajo la atención de las comunidades de investigación interesadas en modelos mundiales, representación multimodal e inteligencia encarnada. La discusión se centró menos en si Orca puede generar resultados visualmente atractivos y más en su intento de conectar texto, imágenes, video y acción como diferentes proyecciones del mismo mundo subyacente.
El artículo también apareció en Hugging Face Papers, donde recibió una notable atención de la comunidad. Esto es importante porque los modelos del mundo se evalúan cada vez más no solo por la calidad de su salida, sino también por si sus representaciones aprendidas pueden transferirse entre tareas.
En los últimos años, muchos avances en IA pueden describirse como formas de "predecir el siguiente X".
Los modelos de lenguaje predicen el siguiente token, lo que les otorga capacidades de escritura, razonamiento, diálogo y codificación. Los modelos de video predicen o sintetizan fotogramas futuros, lo que les ayuda a crear un movimiento más coherente. Los modelos encarnados a menudo predicen la siguiente acción, permitiendo a los robots realizar tareas de manipulación.
Orca argumenta que esto no es suficiente para los agentes que deben operar en el mundo real. El lenguaje, las imágenes y las acciones son solo interfaces diferentes hacia el mundo. El objetivo más profundo es el propio estado del mundo.
En el marco de Orca, la Predicción del Siguiente Estado significa aprender una representación interna del estado que pueda respaldar transiciones física y semánticamente consistentes. Ese estado no es idéntico a una oración, una imagen o una trayectoria de acción. Está más cerca de una representación latente comprimida del mundo.
Una vez que se aprende dicha representación, diferentes módulos de lectura pueden usarla de diversas maneras:
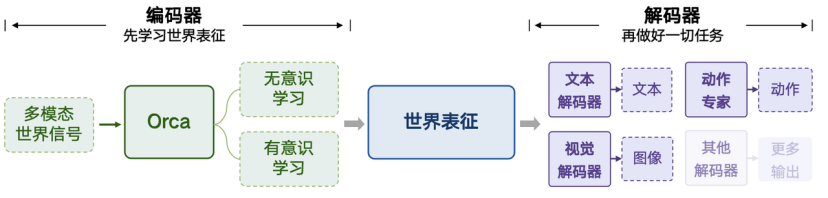
Es por esto que el proyecto utiliza la frase "El Mundo Está en Tu Mente". El mundo no se trata como tokens inconexos, fotogramas y etiquetas de acción. Se modela como un espacio latente que puede leerse a través de múltiples modalidades.
Si se compara un robot con un niño, muchos enfoques actuales son como enviar al niño directamente a un banco de trabajo y pedirle que repita una tarea específica hasta que se vuelva bueno en ella.
Orca sigue un orden diferente. Antes de enseñarle a un robot exactamente cómo actuar, intenta proporcionar al modelo una educación más general sobre los cambios en el mundo.
Esto incluye regularidades básicas como:
La motivación es directa. Si un modelo primero aprende cómo cambian los estados del mundo, entonces una cantidad menor de
de datos de acción puede ser suficiente para conectar esa representación con el control del robot. Esto podría reducir el costo de entrenamiento y mejorar la generalización.
Orca utiliza dos modos de aprendizaje complementarios: aprendizaje inconsciente y aprendizaje consciente.
El aprendizaje inconsciente captura transiciones naturales densas a partir de observaciones continuas. El modelo observa cómo evolucionan las escenas, los objetos, la oclusión, el contacto y el movimiento sin necesidad de etiquetas de acción o instrucciones explícitas de tareas.
El aprendizaje consciente añade estructura semántica. Utiliza descripciones de eventos, lenguaje y supervisión estilo VQA para que el modelo pueda conectar los cambios visuales con conceptos humanos, instrucciones y significado causal.
Juntos, estos modos de aprendizaje están respaldados por tres tipos principales de señales.
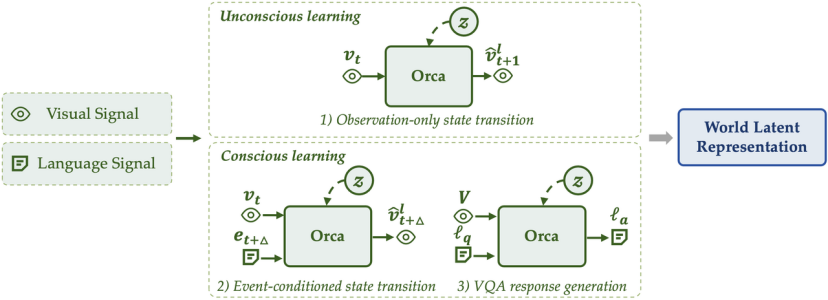
La primera señal es el video continuo del mundo real. Esto proporciona al modelo una experiencia densa de cambios de estado naturales, como el movimiento de objetos, la evolución de escenas, los efectos de contacto y la oclusión.
Este tipo de aprendizaje no requiere que el modelo conozca de antemano el objetivo de la tarea. Se acerca más a la observación pasiva: el modelo aprende cómo cambia el mundo observando cómo cambia.
La segunda señal es la organización a nivel de eventos. Los procesos del mundo real no son solo fotogramas aislados. Las personas los describen naturalmente como eventos: lavar verduras antes de cortarlas, abrir un grifo antes de que el agua cambie el estado de los alimentos, o mover una mano antes de que un objeto cambie de posición.
La supervisión de eventos ayuda a Orca a aprender transiciones de estado significativas bajo condiciones semánticas específicas.
La tercera señal es la comprensión basada en el lenguaje. El lenguaje no es el objetivo final de Orca, pero es una interfaz importante entre los estados del mundo y la intención humana.
La supervisión de VQA ayuda a alinear los estados visuales, la estructura de eventos y el lenguaje natural. En otras palabras, el modelo no solo debe notar que algo cambió, sino también describir y razonar por qué ese cambio es importante.
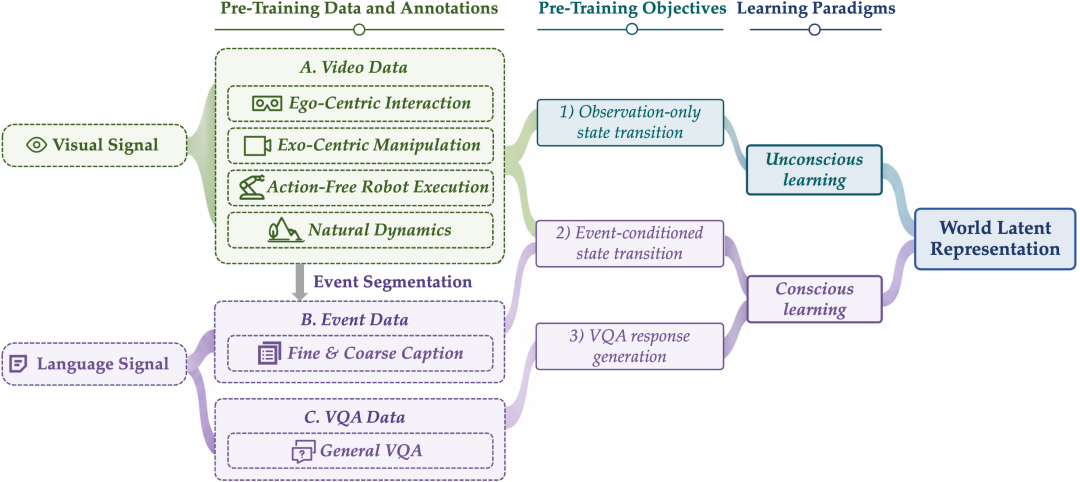
Para respaldar el aprendizaje de estados del mundo, Orca utiliza un inventario de datos de aprendizaje del mundo a gran escala. El artículo original y la página oficial del proyecto describen los siguientes recursos.
| Tipo de recurso | Escala | Rol en el aprendizaje |
|---|---|---|
| Video continuo | Aproximadamente 125 mil horas | Observación densa de transiciones de estado naturales |
| Anotaciones de eventos | Aproximadamente 160 millones de eventos | Supervisión semántica para la |
transiciones de estado significativas |
| Ejemplos de VQA | Alrededor de 11.5 millones de ejemplos | Alineación de lenguaje y comprensión de estados condicionados por preguntas |
Estas fuentes de datos abarcan interacciones egocéntricas, manipulación exocéntrica, videos de ejecución robótica, escenas dinámicas naturales, transiciones a nivel de eventos y respuestas generales a preguntas visuales.
El punto importante es que Orca no está entrenado solo en trayectorias de robots ni solo en respuestas a preguntas visuales. Intenta aprender un espacio latente mundial más amplio a partir de múltiples tipos de señales del mundo real.
Una representación del mundo solo es útil si se puede probar y mejorar. Por lo tanto, los experimentos de Orca plantean dos preguntas centrales.
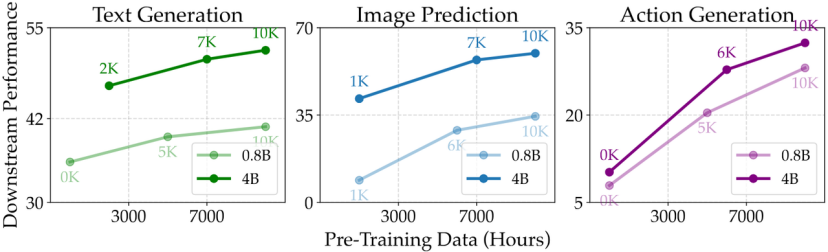
Los resultados de escalado sugieren que, a medida que aumentan los datos de preentrenamiento, la pérdida continúa disminuyendo tanto para el modelo de 0.8B como para el de 4B. El modelo de 4B también alcanza un nivel de pérdida más bajo que el de 0.8B.
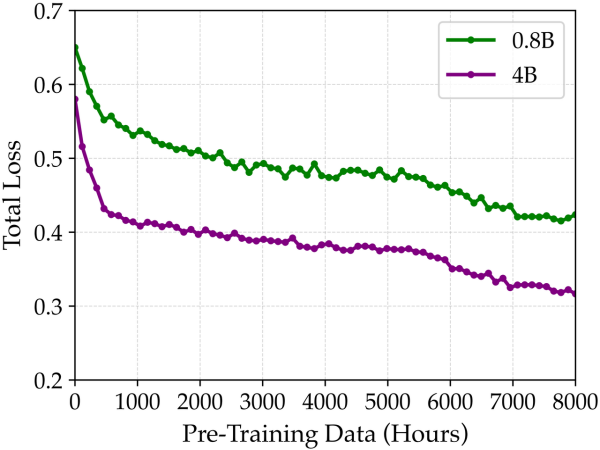
Esto respalda la idea de que la predicción del siguiente estado no es solo un truco a pequeña escala. Parece ser un objetivo de aprendizaje mundial escalable, al menos dentro del rango probado.
La prueba clave no es si Orca puede inventar un concepto que suene bien. La prueba es si el latente aprendido puede respaldar tareas reales posteriores.
Orca congela la columna vertebral preentrenada y adjunta módulos de lectura livianos para tres direcciones:
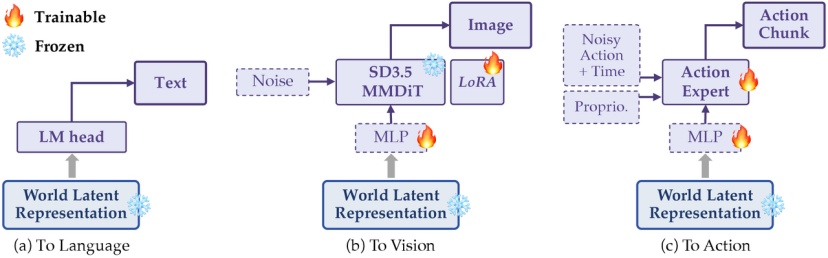
Este diseño es importante porque la columna vertebral congelada impide que los módulos posteriores simplemente vuelvan a aprender todo desde cero. Si diferentes lecturas pueden extraer habilidades de lenguaje, imagen y acción del mismo latente congelado, entonces la representación latente en sí misma probablemente contenga información útil sobre el estado del mundo.
Los resultados posteriores también mejoran a medida que escala el preentrenamiento.
(/cms-assets/image/2026/07/28b12759-9160-48b4-92f6-6c6194bf0621-09-eb93bffa-9db9-456a-bfa9-cd10764544ba.png)
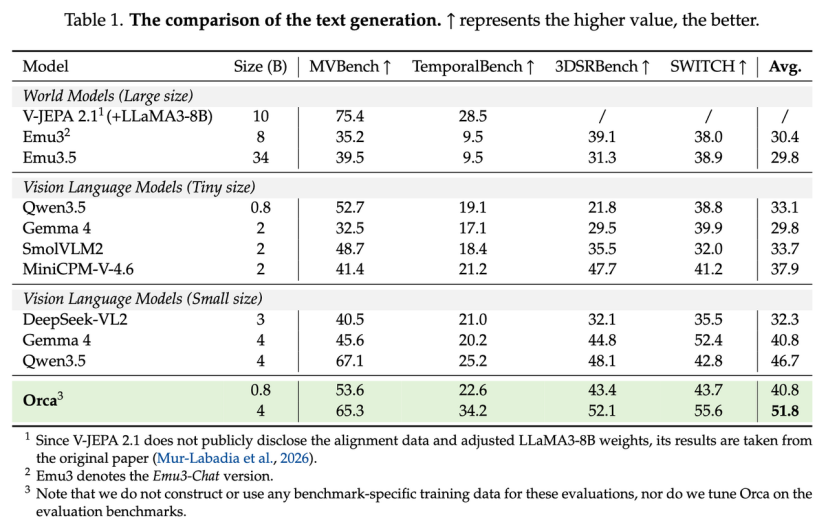
En tareas de generación de texto y VQA, Orca se compara con varios modelos visuales de lenguaje y modelos del mundo, incluyendo V-JEPA, Emu3, Qwen3.5, Gemma, MiniCPM-V y DeepSeek-VL2.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Los resultados reportados muestran que el modelo Orca 4B tiene un rendimiento sólido entre modelos de tamaño similar, especialmente en preguntas que involucran razonamiento temporal, transición de estados y movimiento dinámico.
A continuación se muestra un desglose simplificado de capacidades del artículo.
| Dimensión de capacidad | Qwen3.5-4B | Orca-4B | Ventaja de Orca |
|---|---|---|---|
| Transición de estados | 51.86 | 64.13 | +12.27% |
| Razonamiento de sentido común | 57.76 | 62.95 | +5.19% |
| Relaciones espaciales | 54.68 | 55.25 | +0.57% |
| Movimiento dinámico | 57.03 | 65.55 | +8.52% |
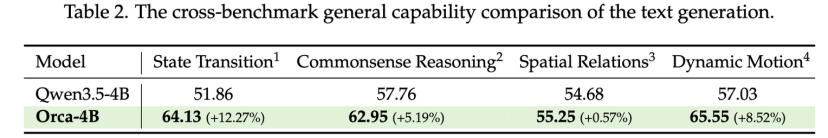
Este patrón es importante. La ventaja de Orca no se limita al reconocimiento de objetos en una escena estática. Las mayores ganancias aparecen en categorías más cercanas a la dinámica del mundo: cómo cambia un estado, cómo se desarrollan los eventos y cómo el movimiento afecta la escena.
Para un modelo del mundo, esto es más significativo que la comprensión de imágenes ordinaria por sí sola. El mundo real no es una colección de imágenes fijas. Es un sistema cambiante.
La lectura de imágenes de Orca no se presenta como una función estándar de generación de imágenes. Se utiliza como una forma de probar si el modelo puede predecir un estado visual plausible después de una interacción.
Esto difiere de la generación de imágenes ordinaria. Un generador de imágenes típico puede crear algo visualmente atractivo, pero aún así romper las restricciones reales de la escena. Podría agregar objetos que no estaban allí, eliminar la encarnación del robot, ignorar la instrucción o seguir un estereotipo en lugar del estado actual.
Por ejemplo, si un prompt menciona un globo rojo, un generador normal puede dibujar un globo rojo completamente inflado independientemente del estado real del globo. Un predictor de estado mundial, en cambio, debería razonar a partir de la escena actual y la condición de interacción.
En el benchmark de interacción del mundo real PRICE, Orca se evalúa frente a líneas base de generación de imágenes como FLUX y OmniGen2. El objetivo no es solo la calidad visual, sino si el estado futuro predicho respeta la disposición de la escena, las relaciones entre objetos, la encarnación del robot y las restricciones físicas.
A la izquierda está la instrucción "Cerrar la puerta del microondas", y a la derecha "Dejar la esponja y retirar la mano". La predicción de Orca coincide con la escena real, como cerrar la puerta del microondas o colocar la esponja; mientras que Flux.2 y OmniGen2 pueden generar predicciones poco razonables, como que la esponja sea retirada o colocada en una posición incorrecta. Esta imagen está estrechamente relacionada con el contexto y muestra visualmente la ventaja de Orca en la predicción de escenas reales, destacando que sus resultados respetan la disposición de la escena y las relaciones entre objetos, en consonancia con la descripción del contexto sobre la capacidad de predicción de imágenes de Orca.](https://we0-cms.oss-cn-beijing.aliyuncs.com/cms-assets/image/2026/07/f96fdbbc-cb9d-43ae-aaf5-c3e8b56393ce-12-8e944a34-7e1f-45d5-a9a3-937f15165375.png)
En este contexto, la predicción de imágenes se convierte en una sonda visible de la comprensión del mundo. La pregunta no es "¿Puede el modelo dibujar una imagen bonita?" La pregunta es "¿Sabe el modelo en qué debería convertirse esta escena después de la interacción descrita?"
Uno de los experimentos más interesantes de Orca es la lectura de acciones para robots reales.
Durante el preentrenamiento, Orca no utiliza trayectorias robóticas etiquetadas con acciones. No memoriza primero cómo debe moverse un brazo específico. En su lugar, aprende cambios de estado del mundo a partir de videos, eventos y lenguaje.
Para las tareas de acción posteriores, los investigadores congelan la columna vertebral de Orca y adjuntan un Experto en Acciones de estilo DiT entrenado desde cero. Cada tarea utiliza una pequeña cantidad de datos de trayectoria dentro del dominio, y luego el modelo se evalúa en entornos de manipulación de doble brazo fuera de la distribución.
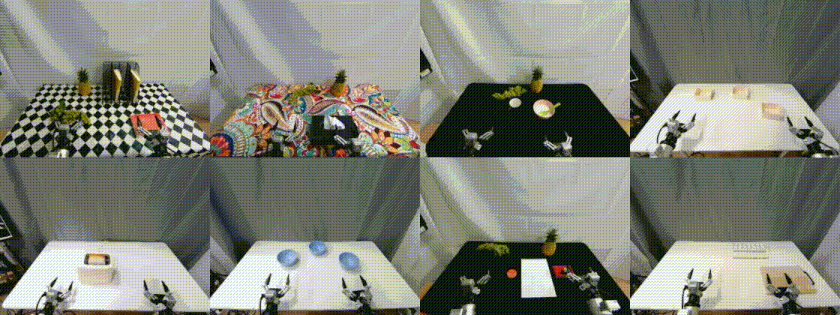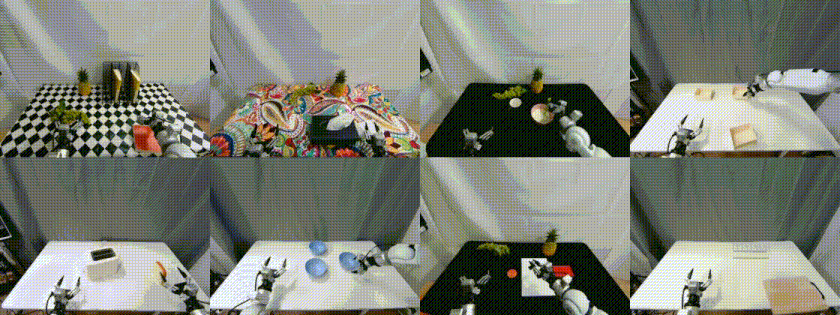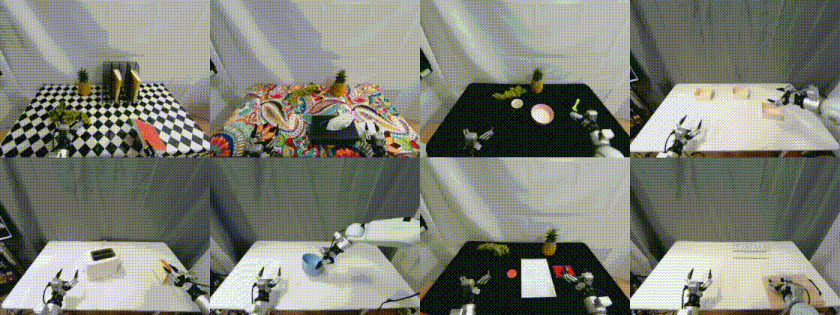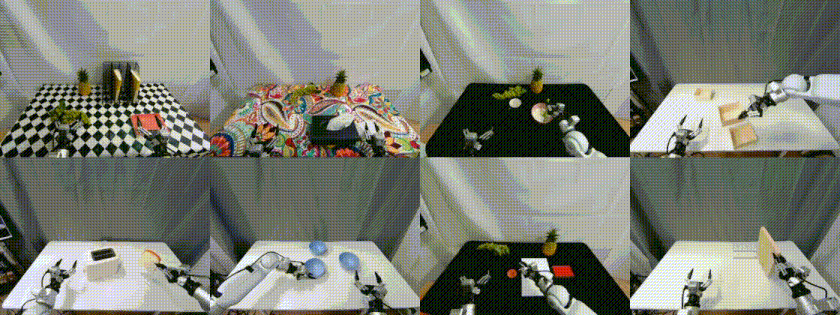
La comparación reportada de generación de acciones muestra que Orca mejora el avance general de la tarea y el comportamiento de recuperación en comparación con varias líneas base.
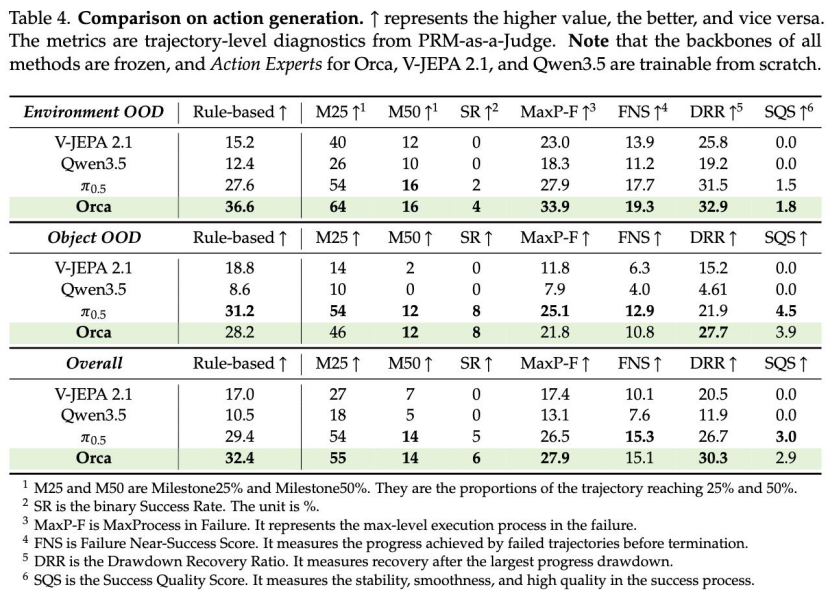
A continuación se muestra una comparación general simplificada.
| Modelo | Basado en reglas ↑ | M25 ↑ | M50 ↑ | SR ↑ | MaxP-F ↑ | FNS ↑ | DRR ↑ | SQS ↑ |
|---|---|---|---|---|---|---|---|---|
| V-JEPA 2.1 | 17.0 | 27 | 7 | 0 | 17.4 | 10.1 | 20.5 | 0.0 |
| Qwen3.5 | 10.5 | 18 | 5 | 0 | 13.1 | 7.6 | 11.9 | 0.0 |
| π₀.₅ | 29.4 | 54 | 14 | 5 | 26.5 | 15.3 | 26.7 | 3.0 |
| Orca | 32.4 | 55 | 14 | 6 | 27.9 | 15.1 | 30.3 | 2.9 |
Los ejemplos de recuperación son especialmente relevantes. En robótica real, el primer intento a menudo falla. Un sistema que solo mapea observaciones a acciones memorizadas puede quedarse atascado después de una perturbación. Un sistema con una representación más sólida del estado del mundo tiene más posibilidades de notar que la tarea no está terminada, que el objeto todavía existe y que el estado actual aún tiene un camino hacia el objetivo.
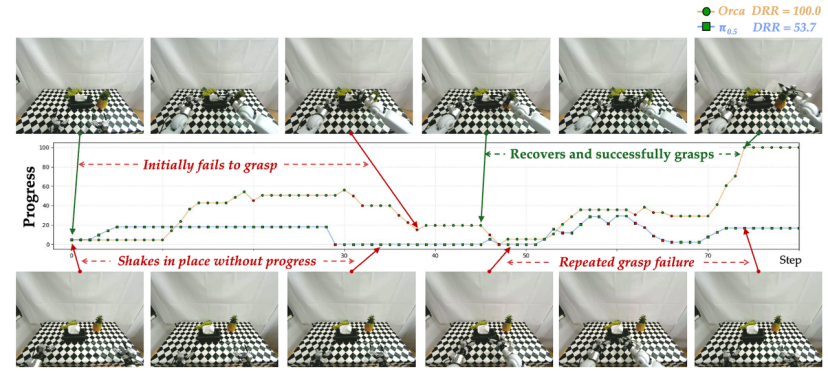
Este es el valor práctico de aprender el estado del mundo.
antes de la acción. Orca no argumenta que los datos de acción sean innecesarios. En cambio, cambia el orden de aprendizaje: primero aprende dinámicas mundiales escalables, luego conecta esa representación a la acción del robot con una cantidad menor de datos específicos de la tarea.
El artículo también analiza experimentos de ablación. Los investigadores eliminan diferentes objetivos de entrenamiento y observan cómo cambian las lecturas de texto, imagen y acción.
El resultado es que los tres objetivos desempeñan roles diferentes.
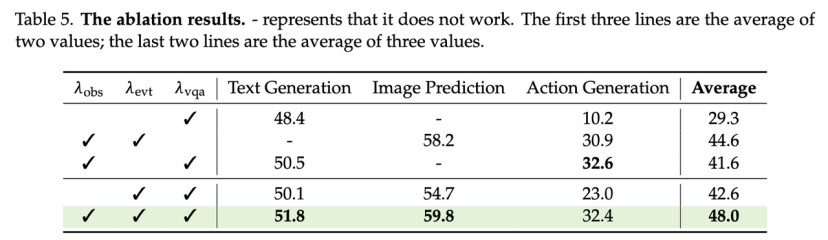
La lección principal es que una representación del mundo no se produce únicamente mediante una señal de supervisión. Está moldeada por múltiples restricciones: cambio natural, eventos semánticos, razonamiento del lenguaje y transición de estado.
El artículo también menciona mejoras a nivel de sistema de entrenamiento basadas en el marco FlagScale de BAAI. El equipo informa mejoras en torno a FSDP2, la pérdida de entropía cruzada fragmentada y la precarga hacia adelante/atrás.
En un clúster H100, se informa que estos cambios aumentan el rendimiento de entrenamiento desde la línea base de StarVLA de 0.66 muestras/segundo/GPU a 2.91 muestras/segundo/GPU, una aceleración de 4.4x.
Esta parte es importante porque el entrenamiento del modelo del mundo depende en gran medida de la escala. Si el sistema de entrenamiento no puede manejar eficientemente grandes tuberías de supervisión de video, eventos y multimodal, la idea de modelado se vuelve difícil de probar en la práctica.
Orca sigue siendo una versión temprana. El informe técnico y los materiales del proyecto describen varias limitaciones.
Orca actual se basa principalmente en señales visuales y del lenguaje. Aún no cubre completamente el tacto, la fuerza, el sonido, la propiocepción y otras modalidades físicas que serían importantes para un modelado del mundo más rico. El enfoque actual también depende en parte de codificadores visuales existentes y espacios de representación multimodal.
La escala del modelo y la escala de datos son tempranas en comparación con la ambición a largo plazo de modelos fundacionales del mundo generales. La predicción de imágenes, la generalización de acciones y los métodos de evaluación para el modelado del mundo también necesitan más trabajo.
Aún así, el valor de Orca no está en afirmar que el modelado del mundo está resuelto. Su valor es que ofrece una ruta concreta:
útil.
Si esta dirección continúa mejorando, podría tener relevancia más allá de la robótica. Muchos campos involucran estados, intervenciones y transiciones: sistemas físicos, biología, modelado ambiental, experimentos científicos y toma de decisiones autónomas.
La pregunta más amplia es si los futuros sistemas de IA podrán primero construir un modelo interno, estable y transferible del mundo antes de generar respuestas, imágenes o acciones.
Esa es la idea central detrás de Orca: El mundo está en tu mente.
BAAI RoboBrain Orca es un proyecto temprano de modelo fundacional del mundo centrado en la predicción del siguiente estado. Aprende una representación latente del mundo a partir de señales multimodales y utiliza módulos de lectura ligeros para la predicción de lenguaje, imágenes y generación de acciones.
Predicción del Siguiente Estado significa predecir cómo cambia el estado subyacente del mundo, no solo predecir el siguiente token, fotograma o acción. El objetivo es modelar las transiciones de estado de manera que pueda apoyar el razonamiento, la predicción visual y el control físico.
Orca no se limita a ninguna de esas categorías. Primero aprende un latente compartido del mundo, luego utiliza diferentes lecturas para lenguaje, visión y acción. Por eso se describe como un modelo mundial multimodal en lugar de un modelo de un solo propósito.
Orca utiliza recursos de aprendizaje mundial a gran escala, incluyendo aproximadamente 125,000 horas de video, 160 millones de anotaciones de eventos y 11.5 millones de ejemplos de VQA. Estas señales ayudan al modelo a aprender dinámicas naturales, transiciones condicionadas por eventos y comprensión alineada con el lenguaje.
Congelar la columna vertebral hace que la evaluación sea más limpia. Si los módulos de lectura ligeros pueden funcionar bien mientras la columna vertebral permanece congelada, sugiere que la información útil ya está presente en el latente del mundo aprendido, en lugar de reaprenderse desde cero en el downstream.
En los experimentos de acción reportados, el latente del mundo congelado de Orca se conecta a un experto en acciones entrenable para tareas robóticas. No es simplemente un controlador robótico plug-and-play directo, pero los resultados sugieren que el preentrenamiento del estado mundial puede ayudar a la generalización downstream en robótica.
Los materiales disponibles presentan a Orca como una dirección de investigación temprana, no como un sistema de producción terminado. El proyecto aún necesita modalidades físicas más amplias, métodos de evaluación más sólidos, entrenamiento a mayor escala y puntos de control o código de inferencia liberados para una reproducción más amplia.
Los mejores puntos de partida son la página oficial del proyecto Orca, el informe técnico en arXiv, el repositorio de GitHub y la página del artículo en Hugging Face. Estas fuentes proporcionan las referencias más directas para el diseño del modelo, los datos, la evaluación y la citación.
figuras, y futuros lanzamientos de código o puntos de control.
RoboBrain Orca explora un cambio de predecir salidas aisladas a modelar transiciones de estados del mundo. En lugar de tratar el lenguaje, las imágenes y las acciones como objetivos separados, intenta aprender una representación latente compartida del mundo que pueda soportar múltiples interfaces de lectura.
El artículo explica la configuración de aprendizaje de Orca, incluyendo video continuo, anotaciones de eventos y datos de VQA. También recorre las tres lecturas principales: razonamiento textual, predicción de imágenes de estados futuros y generación de acciones robóticas.
La idea más importante no es que Orca haya completado el modelado del mundo. Es que Orca ofrece una ruta comprobable para construir y evaluar un modelo latente del mundo a través del lenguaje, la visión y la acción.
En resumen: Orca es un intento temprano de hacer que la IA comprenda el cambio de estado antes de generar palabras, imágenes o acciones.
Empieza con una sola frase y obtén un sitio completo en minutos.



