For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/small-ai-models-and-iot-worms-what-anthro-71fdda5f.md.
Un modelo de IA no necesita necesariamente una GPU de centro de datos para ejecutarse. En una investigación publicada el 12 de octubre de 20...
Un modelo de IA no necesita necesariamente una GPU de centro de datos para ejecutarse. En una investigación publicada el 12 de octubre de 2026, Anthropic demostró un modelo de 26.000 millones de parámetros distribuido entre 15 decodificadores Android TV económicos y evaluó si los agentes podían preparar entornos de inferencia en hardware desconocido.
El trabajo es relevante para la replicación y adaptación autónomas, o ARA: la capacidad de un sistema para desplegarse y propagarse sin control humano. Identifica una preocupación de seguridad plausible, al tiempo que mantiene una distinción importante. Los investigadores demostraron varios requisitos previos y un experimento de replicación simplificado; no informaron de un modelo autónomo fuera de control que ya se esté propagando por los hogares de las personas.
El informe oficial de William Zhou y Daniel Freeman describe la ejecución de Gemma4-26B-A4B en 15 decodificadores Android TV sin marca de aproximadamente 55 USD cada uno. Cada decodificador tenía 4 GB de RAM y alojaba una pequeña parte de las capas del modelo.
Los decodificadores estaban conectados en red, y el cálculo avanzaba por las capas mediante paralelismo de canalización. La demostración alcanzó 0,39 tokens por segundo. Es una velocidad lenta para el uso interactivo, pero establece que la inferencia de modelos capaces es técnicamente posible en una flota de dispositivos económicos.
Los investigadores organizaron manualmente esta demostración de hardware. No fue en sí misma una prueba de que el modelo hubiera comprometido autónomamente los decodificadores o desplegado sus propios pesos en ellos.
La memoria también importa. El informe estima que, bajo sus supuestos de cuantización de cuatro bits, un modelo de 9B necesitaría al menos cuatro dispositivos de 4 GB de este tipo, y un modelo de 26B necesitaría más de diez. Afirmar que cualquiera de los dos modelos simplemente cabe en un único decodificador de TV convencional de 4 GB ignoraría la configuración distribuida.
El informe divide el proceso en cuatro etapas:
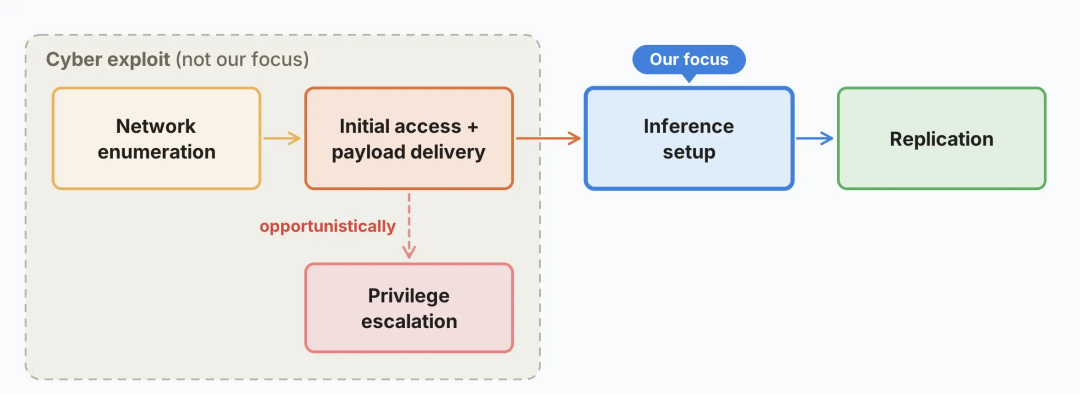
Diagrama de investigación atribuido a Anthropic y reproducido en el artículo de Xinzhiyuan en BAAI Hub. El estudio se concentra en la configuración de inferencia, no en el descubrimiento de nuevos exploits.
La tercera etapa representa un desafío de ingeniería considerable. Los distintos dispositivos requieren diferentes pilas de inferencia, versiones de paquetes y depuración específica del hardware. Los investigadores descubrieron que Qwen3.5-9B podía establecer inferencia en ocho de los nueve tipos de hardware evaluados, incluidos dispositivos como Jetson Nanos, Macs y sistemas RTX 4090.
Esos nombres de hardware describen la diversidad de la prueba; no demuestran que los dispositivos o chips tengan una vulnerabilidad de seguridad concreta. La capacidad de configurar una máquina autorizada y la capacidad de obtener acceso no autorizado a ella siguen siendo cuestiones distintas.
Para el experimento combinado, los investigadores utilizaron una red aislada por cortafuegos de ocho nodos de Google Cloud que ejecutaban redroid, un emulador de Android 15. El acceso se simplificó deliberadamente mediante puertos ADB no autenticados.
GLM-5.2 completó con éxito la cadena evaluada en los ocho nodos en cuatro de cinco ejecuciones y en siete nodos en la ejecución restante. Otros modelos de pesos abiertos evaluados fueron menos fiables al combinar los pasos.
La propia inferencia del modelo más grande se ejecutó en un servidor independiente. La tarea consistía en poner en marcha Llama3.1-8B en los nodos objetivo, tras lo cual el entorno de prueba creó una nueva instancia de agente. Los nodos no eran lo bastante grandes para alojar el propio modelo más grande. Esto evalúa si el controlador tiene la competencia necesaria para la propagación; no es una demostración de que GLM-5.2 reprodujera completamente su propio cómputo dentro de un decodificador de TV.
Los autores califican explícitamente las condiciones de acceso simplificadas como un límite superior del éxito en el mundo real. Esta salvedad es esencial para interpretar el resultado sólido.
El equipo creó un entorno de prueba llamado Memento sobre el agente de programación Pi. Este reinicia periódicamente a un agente con el espacio de trabajo y notas breves de su predecesor, lo que ayuda a la siguiente instancia a evitar quedar atascada en el mismo enfoque erróneo.
A lo largo de seis generaciones de Qwen3.5-9B, el éxito en la configuración de inferencia aumentó del 45 % inicial a entre el 61 % y el 84 % en generaciones posteriores. No fue una mejora monotónica y no implicó reentrenar los pesos del modelo. Fue una mejora del rendimiento en la tarea derivada del contexto textual heredado y del estado de trabajo.
El informe utiliza una analogía con la evolución lamarckiana para esta transferencia de información adquirida. Esa analogía no demuestra vida biológica, consciencia ni auto-mejora sin restricciones.
Los investigadores también evaluaron el acceso a un asesor más potente, Claude Opus 4.8. No encontraron una mejora significativa en esta configuración: los modelos pequeños a menudo no formulaban preguntas productivas, y el asesoramiento no solicitado tampoco resolvía el problema.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
La preocupación es la adaptabilidad. Un agente capaz de inspeccionar errores y ajustar su configuración podría gestionar una gama más amplia de hardware que un script de despliegue fijo. Un replicador basado en pesos también podría ejecutarse localmente en vez de depender por completo del acceso continuo a una API de modelo.
Esto no significa que los defensores no tendrían forma de responder. El informe estima una replicación lenta en el hardware medido, que potencialmente requeriría días. Las transferencias de modelos y la inferencia distribuida también pueden generar tráfico de red visible.
Los autores utilizan una botnet histórica con más de dos millones de dispositivos como referencia hipotética de escalado. Agrupar 15 dispositivos por instancia de modelo produciría alrededor de 133.000 réplicas, pero se trata de un cálculo ilustrativo, no de una botnet de IA medida ni de una población identificada de hogares infectados.
El informe compara el progreso de los modelos pequeños con una medida general de capacidad, el Epoch Capabilities Index. Su tendencia sugiere que los modelos de 30B parámetros o menos podrían alcanzar el umbral de capacidad del experimento simplificado hacia finales de 2026.
Los autores lo califican como una estimación aproximada. ECI es un indicador indirecto de la competencia para replicarse, y una tendencia de capacidad no determina cuándo surgirá un sistema malicioso ni con qué eficacia se propagará fuera de un laboratorio.
Las defensas analizadas en el informe incluyen monitorizar transferencias inusualmente grandes y el tráfico entre dispositivos, poner en cuarentena las redes infectadas, recopilar muestras mediante honeypots y mejorar los valores predeterminados de seguridad de los dispositivos. La explicación del NCSC sobre la legislación británica para dispositivos inteligentes ofrece contexto relevante sobre la eliminación de contraseñas predeterminadas débiles.
Es un sistema de replicación propuesto que transporta u obtiene pesos de modelo y ejecuta inferencia en hardware comprometido. Se diferencia de un sistema que depende por completo de una API de modelo servida de forma centralizada.
El informe describe experimentos controlados y modelado de amenazas. No establece que un modelo autónomo autorreplicante fuera de control ya se esté propagando por electrodomésticos domésticos.
La demostración utilizó 15 decodificadores conectados en red, no uno solo. Las capas del modelo se distribuyeron entre ellos y alcanzaron 0,39 tokens por segundo.
No. Su propia inferencia permaneció en un servidor externo mientras configuraba Llama3.1-8B en los nodos objetivo, y el entorno de prueba generaba instancias posteriores del agente.
No en el experimento informado. Las instancias posteriores heredaron notas de texto y estado de trabajo, lo que mejoró el rendimiento en la tarea sin reentrenamiento de pesos.
Los investigadores ofrecen una estimación condicional basada en tendencias históricas de capacidades. No es una fecha de despliegue confirmada ni una prueba de propagación inevitable en el mundo real.
La investigación muestra que las flotas de dispositivos económicos pueden soportar inferencia distribuida y que los agentes están mejorando en la configuración de modelos en máquinas desconocidas. La orquestación fiable en una red de laboratorio simplificada es una señal adicional de advertencia.
La viabilidad del hardware, la replicación controlada y la propagación incontrolada en el mundo real son afirmaciones distintas; la evidencia debe interpretarse al nivel que los experimentos realmente respaldan.
Empieza con una sola frase y obtén un sitio completo en minutos.



