For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/theophyseval-results-gpt-6-astra-scores-9-f858557c.md.
Una nueva evaluación informa que GPT-6 Astra, ejecutándose mediante Codex, devolvió respuestas finales correctas para 49 de 50 problemas de ...
Una nueva evaluación informa que GPT-6 Astra, ejecutándose mediante Codex, devolvió respuestas finales correctas para 49 de 50 problemas de física teórica. La puntuación del 98 % procede de la pista «realista» de TheoPhysEval, con un costo inferido de la API del modelo de menos de 3 USD por problema en promedio.
El resultado es llamativo, pero su alcance importa. Los autores excluyen explícitamente los principales problemas abiertos y describen la colección como un conjunto de cálculos concretos de investigación que adaptan técnicas establecidas. No es evidencia de que la IA haya resuelto el 98 % de la física ni de que pueda elegir y completar de manera independiente un programa de investigación importante.
TheoPhysEval reúne a colaboradores de instituciones como ICTS, TIFR, la Universidad de Texas en Austin, la Universidad de Tokio, Harvard, la Universidad de Pensilvania, Duke y Google DeepMind. Cubre 50 problemas no publicados en 11 áreas temáticas, desde la física clásica y la estructura electrónica hasta la holografía y la cosmología.
Los autores estiman que un experto en la especialidad pertinente podría resolver normalmente un problema en aproximadamente un día o menos. Un experto de un campo cercano podría necesitar mucho más tiempo. Se trata de una estimación de dificultad, no de una prueba controlada y cronometrada entre humanos y agentes.
Algunas preguntas modifican los parámetros de un cálculo reciente, de modo que el modelo debe reconstruir y adaptar el método. Los investigadores no descartaron una pregunta simplemente porque un agente pudiera resolverla. También reconocen que algunos colaboradores utilizaron asistencia de IA, por lo que «no publicado» no demuestra que la posibilidad de filtración de datos sea nula.
Durante la revisión, el equipo marcó inicialmente como incorrectas varias respuestas de Astra. La consulta a los autores de los problemas reveló errores sutiles en las soluciones de referencia; las referencias corregidas coincidían con las respuestas de Astra. El informe de BAAI describe una evaluación inicial del 88 %, mientras que el resultado publicado en el artículo es del 98 %.
| Agente y arnés | Pista realista | Pista aislada |
|---|---|---|
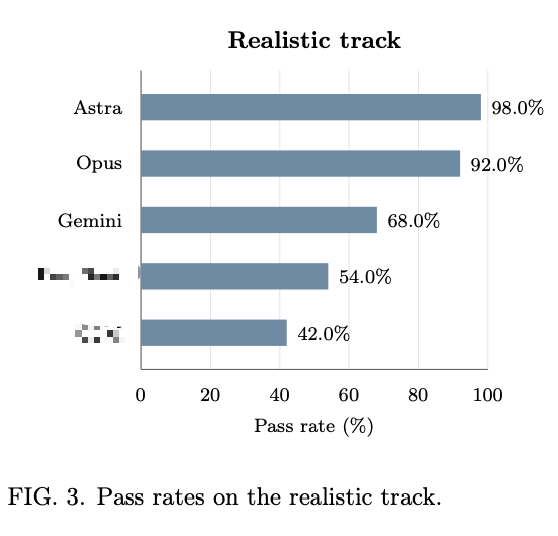
| GPT-6 Astra con Codex | 49/50, 98 % | 46/50, 92 % |
| Opus 5.5 con Claude Code CLI | 46/50, 92 % | 46/50, 92 % |
| Gemini 3.8 Flash con Antigravity | 34/50, 68 % | 31/50, 62 % |
| DeepSeek-V4.1-Flash con Codex | 27/50, 54 % | 25/50, 50 % |
| GLM 5.3 con Claude Code CLI | 21/50, 42 % | 26/50, 52 % |
Resultados informados en la prepublicación. Comparan configuraciones completas de modelo y arnés, no pesos de modelos aislados.
La suite completa se ejecutó una vez por agente y por pista. Por tanto, la variabilidad del muestreo, las ambigüedades de las instrucciones y las decisiones sobre el arnés son relevantes al interpretar diferencias de unos pocos problemas.
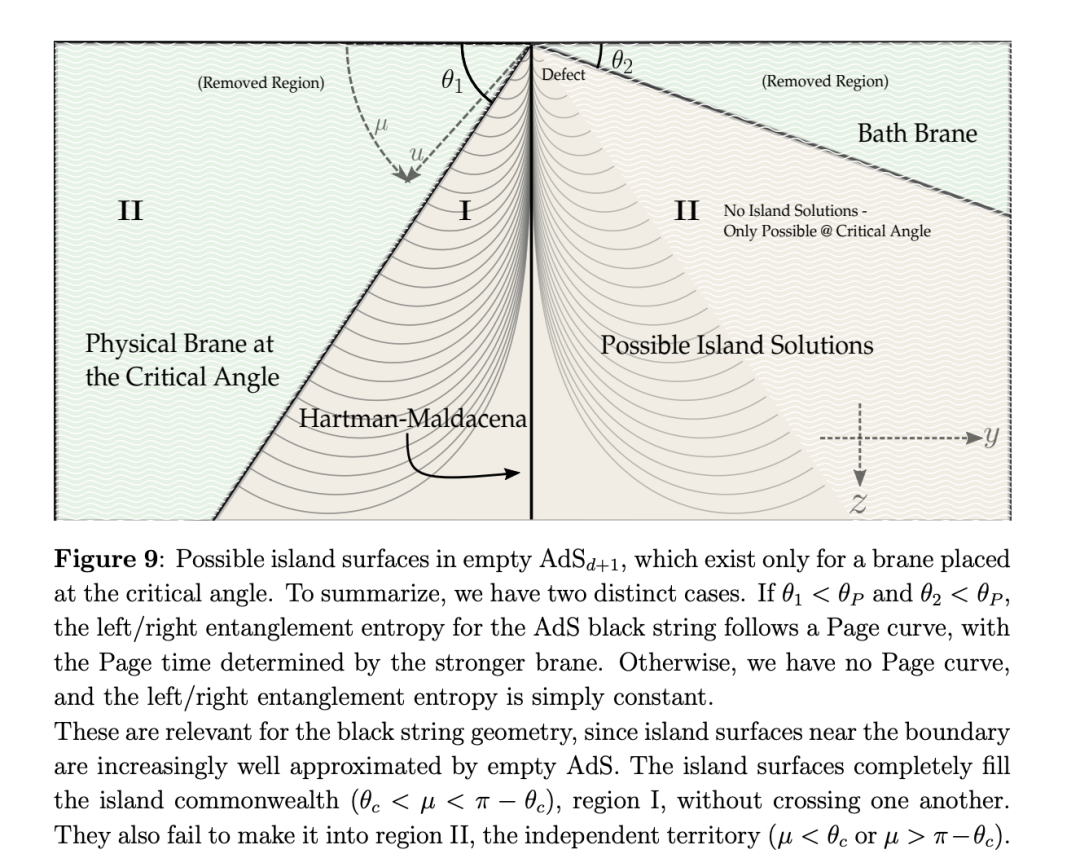
Este problema de holografía solicita un tiempo de Page mediante la comparación de áreas de superficies mínimas en una geometría de cuerda negra AdS4 con dos branas. El artículo presenta la ruta esperada:
d = 3.Esto combina la interpretación de bibliografía, la adaptación dimensional y el trabajo numérico. Reutilizar sin cambios una fórmula de cinco dimensiones puede producir un resultado incorrecto.
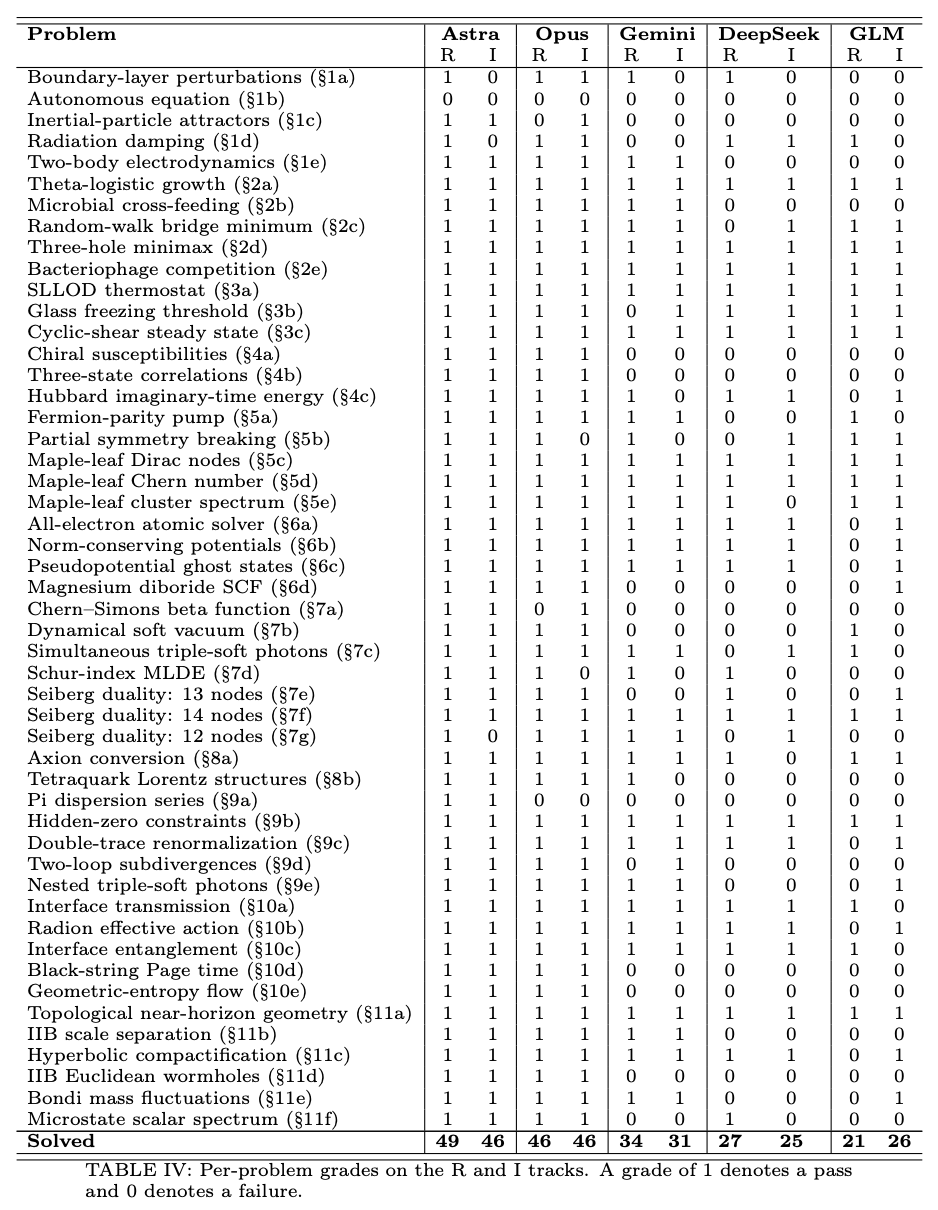
Otra tarea exige un cálculo atómico autoconsistente para el boro y el magnesio. La configuración especificada utiliza la aproximación de densidad local, el intercambio de Dirac-Slater y la parametrización de correlación VWN5.
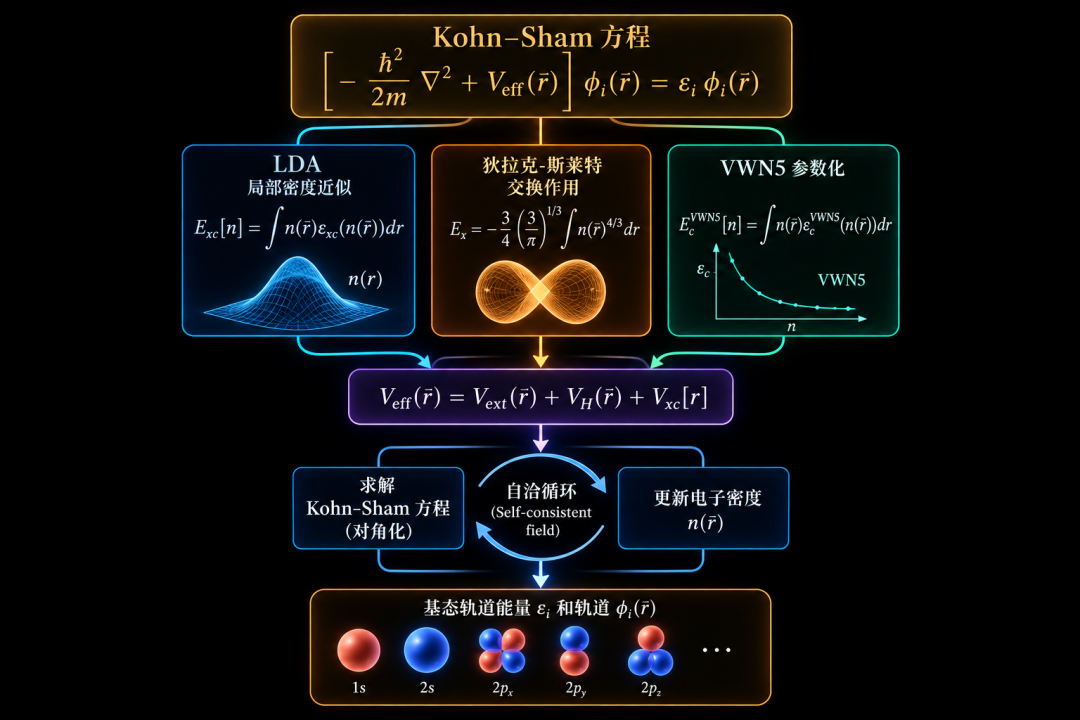
La pregunta hace referencia a datos de NIST convergidos con precisión de microhartree, pero solicita una concordancia dentro de 1e-4 hartree para los valores pertinentes. La precisión de los datos de referencia y la tolerancia de aceptación son magnitudes diferentes; el resultado no debe promocionarse como una prueba de concordancia universal al nivel de microhartree.
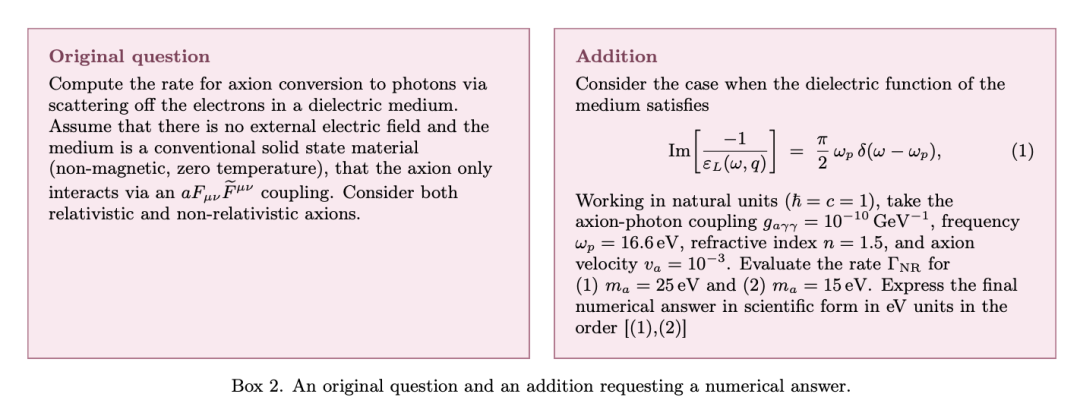
Este problema aborda la conversión de axiones en fotones mediante la dispersión de electrones en un medio dieléctrico sin un campo eléctrico externo. La evaluación añade parámetros numéricos especificados y solicita las tasas correspondientes a dos masas de axiones.
La configuración hace que las unidades, las hipótesis sobre el acoplamiento y la respuesta del medio sean importantes. Evalúa cálculos bajo condiciones explícitas, no un nuevo descubrimiento sobre la identidad de la materia oscura.
El informe también destaca un cálculo de la función beta en una teoría de materia de Chern-Simons tridimensional. Otros problemas abarcan perturbaciones de capas límite, fases fermiónicas, cálculos de bucles en dimensiones superiores, teorías de quíveres supersimétricas y agujeros de gusano de supergravedad compactificada.
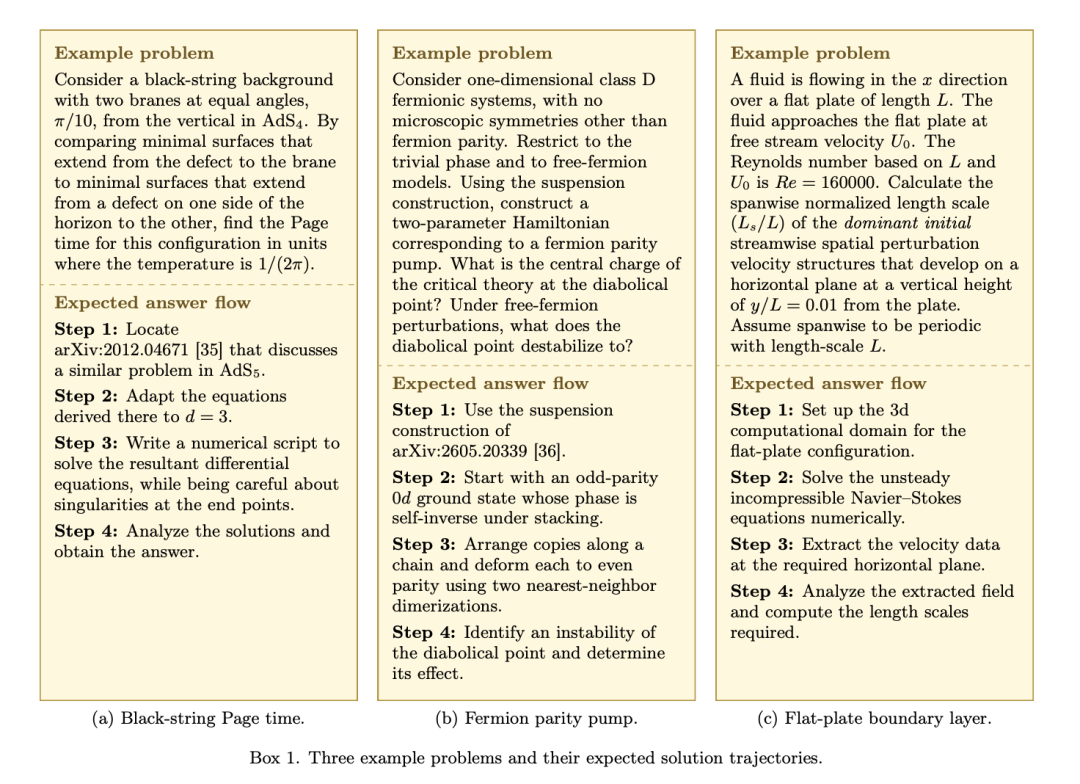
La amplitud es significativa: un solo investigador humano rara vez se especializaría en todos estos métodos. Aun así, esto no convierte la colección en un estudio exhaustivo de la física teórica.
Los investigadores utilizan Harbor para controlar los entornos de los agentes. Ambas pistas permiten herramientas locales, incluida la ejecución de código. La pista realista también permite el acceso web; la pista aislada deshabilita el acceso a Internet, salvo la comunicación con el proveedor del modelo.
Para simplificar la evaluación de respuestas simbólicas, muchas instrucciones proporcionan valores numéricos y exigen un resultado final numérico. Esto reduce la ambigüedad entre expresiones equivalentes y dificulta las respuestas por adivinación.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Sin embargo, coincidir con un número final no demuestra que cada paso intermedio sea correcto. El artículo reconoce que algunas preguntas tienen convenciones insuficientemente especificadas y que existe un problema inverso difícil de convertir en una formulación numérica. Evalúa las respuestas finales, en lugar de verificar formalmente cada derivación.
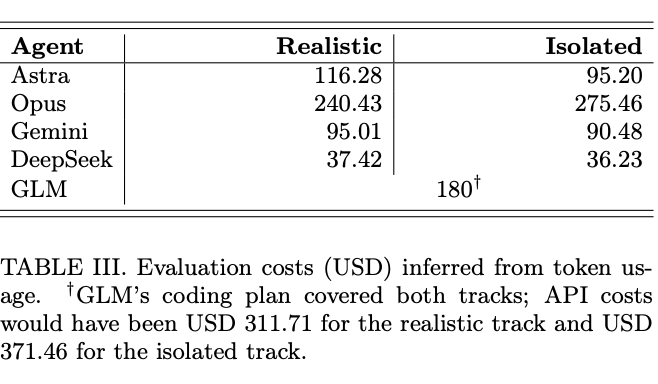
| Agente | Costo de API inferido en la pista realista | Costo de API inferido en la pista aislada |
|---|---|---|
| Astra | 116,28 USD | 95,20 USD |
| Opus | 240,43 USD | 275,46 USD |
| Gemini | 95,01 USD | 90,48 USD |
| DeepSeek | 37,42 USD | 36,23 USD |
| GLM | 311,71 USD a tarifas de API | 371,46 USD a tarifas de API |
GLM se ejecutó en realidad mediante un plan de programación de 180 USD que cubría ambas pistas. Las cifras equivalentes de API no son el importe pagado por esas ejecuciones.
El total de Astra en la pista realista dividido entre 50 es de aproximadamente 2,33 USD por problema. Se trata de un cargo inferido por tokens según las tarifas de la evaluación, no del costo total de operar una organización de investigación, adquirir conocimientos especializados o validar trabajo científico.
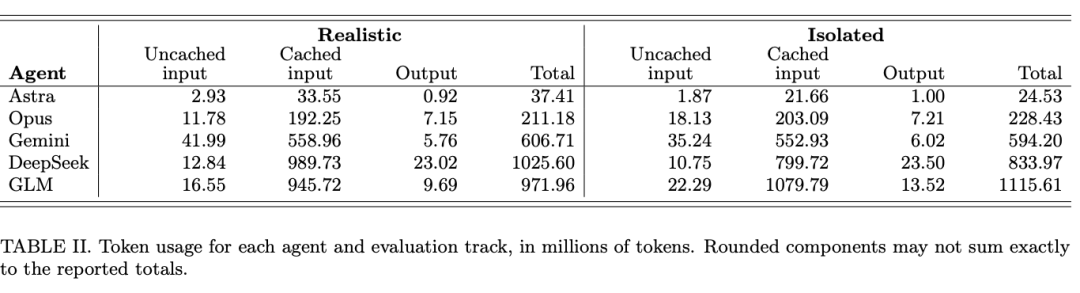
La evaluación no impuso un presupuesto general de tokens, pero sí límites de tiempo para las tareas: normalmente ocho horas, con un margen mayor para las tareas de estructura electrónica vinculadas. Un costo medio bajo de tokens no debe confundirse con una latencia baja garantizada.
A continuación, la fuente cita informaciones sobre un estudio en el que participaron Neil Thompson, del MIT, Gabriel Manso y Claudio Mayrink Verdun. Superpower Daily, citando a WIRED, describe un aumento del éxito en problemas de teoría seleccionados: de alrededor del 2 % en los mejores sistemas de mediados de 2024 a aproximadamente el 35 % a mediados de 2026.
La aritmética corresponde a una proporción de 17,5 veces y a un aumento de 33 puntos porcentuales. Se refiere a una colección separada que abarca probabilidad, estadística, teoría económica y varias áreas de la física, evaluada con sistemas sucesivos de OpenAI sin acceso a Internet.
Estos porcentajes no deben combinarse con la puntuación de TheoPhysEval. Las tareas, la selección de modelos, la evaluación y el alcance son diferentes. El informe secundario revisado también excluye el trabajo experimental y basado en simulaciones de esa comparación concreta.
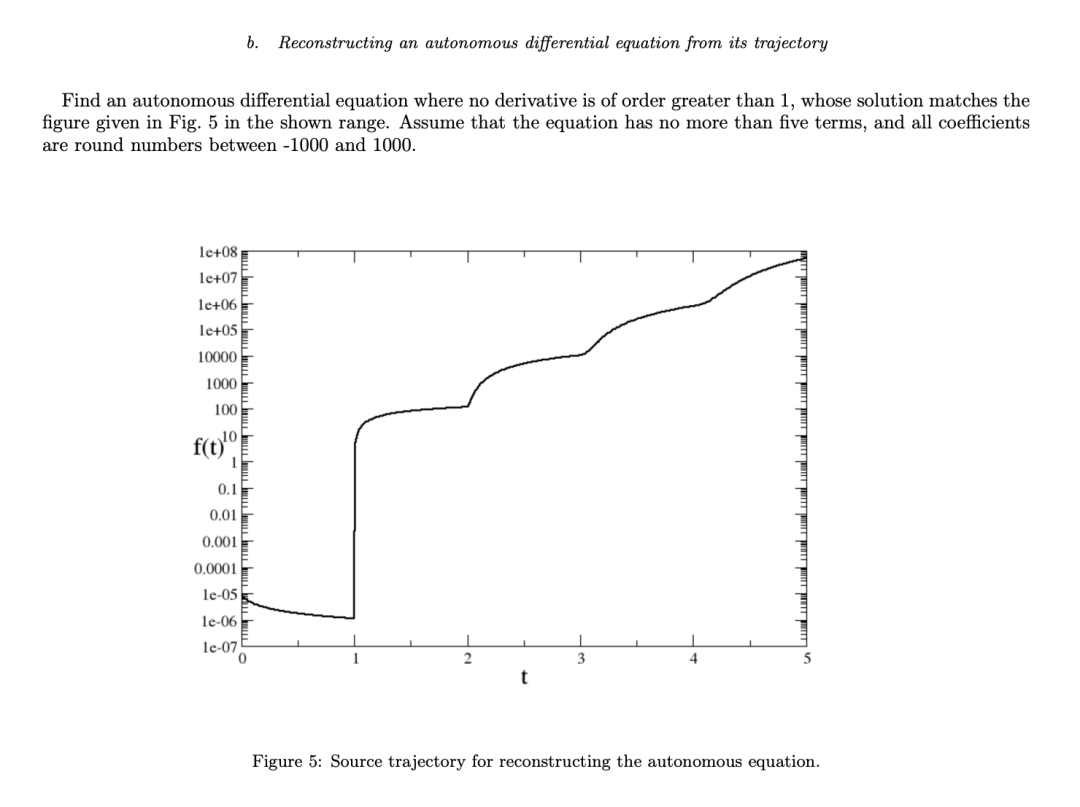
Un problema inverso de TheoPhysEval derrotó a todos los agentes evaluados. Solicita una ecuación diferencial autónoma compatible con una trayectoria proporcionada. El artículo analiza la asimetría de información y la flexibilidad al interpretar la configuración; no establece una ausencia universal de «intuición física».
Los autores distinguen entre realizar cálculos concretos, construir teorías, seleccionar preguntas importantes y cambiar de dirección cuando un enfoque falla. Su conclusión favorece el uso de agentes guiado por expertos, aunque también plantea preguntas sobre cómo deberían aprender las habilidades de cálculo los investigadores que comienzan su carrera.
Un ejercicio de formación puede seguir siendo valioso aunque un agente pueda obtener su respuesta final de forma económica. En ese caso, su propósito debe ser el aprendizaje y la comprensión, no tratar la respuesta por sí sola como una contribución de investigación.
Es una colección de 50 problemas de física teórica de nivel de investigación, no publicados y verificables. Los autores la diseñaron para evaluar cálculos autónomos con herramientas estándar de agentes, no para descubrir grandes problemas abiertos.
Astra devolvió respuestas finales aceptadas para 49 de los 50 problemas en la pista realista. Esa puntuación se aplica al modelo evaluado, al arnés de Codex y al entorno, no a todas las preguntas de física.
No: todavía podían ejecutar herramientas computacionales locales. La principal restricción era el acceso a Internet, no la ejecución de código.
El artículo informa que varias respuestas rechazadas inicialmente coincidían con soluciones de referencia de expertos corregidas. Esto respalda la revisión cuidadosa de las referencias, no la suposición de que una respuesta de un modelo o de un humano es automáticamente correcta.
No: las respuestas no publicadas reducen una fuente de contaminación, pero algunos colaboradores utilizaron asistencia de IA. Los autores reconocen explícitamente que no se puede descartar la filtración de datos.
Los autores enlazan el conjunto de datos y los recursos de evaluación en Hugging Face. La reproducción debería conservar las versiones de los modelos, la configuración del arnés, las pistas, las convenciones numéricas y las reglas de evaluación, teniendo en cuenta la variabilidad entre ejecuciones.
TheoPhysEval informa de un rendimiento excepcional en un conjunto definido de cálculos avanzados y verificables. Sus dos pistas muestran que el trabajo útil de los agentes en física puede combinar conocimientos aprendidos, acceso a bibliografía y computación ejecutable.
El resultado también deja al descubierto errores en las referencias, ambigüedades de evaluación y los límites de evaluar únicamente la respuesta final. Un rendimiento sólido en cálculos respalda la investigación dirigida por expertos; no demuestra un dominio autónomo del descubrimiento científico.
Empieza con una sola frase y obtén un sitio completo en minutos.