For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/typesafe-jev-vs-openai-decisions-api-fast-7c48d620.md.
Una nueva empresa de IA ha recaudado **870 millones de dólares** pocas semanas después de lanzar un modelo que no intenta escribir ensayos, ...
Una nueva empresa de IA ha recaudado 870 millones de dólares pocas semanas después de lanzar un modelo que no intenta escribir ensayos, código ni respuestas conversacionales amistosas.
La empresa es TypeSafe AI.
Su modelo se llama Jev.
TypeSafe anunció la ronda Serie A el 9 de octubre de 2026, con una valoración de 7.500 millones de dólares. Andreessen Horowitz lideró la ronda, en la que también participaron Sequoia Capital, el inversor existente DCVC y otros inversores.
El equipo fundador de la empresa también atrajo atención.
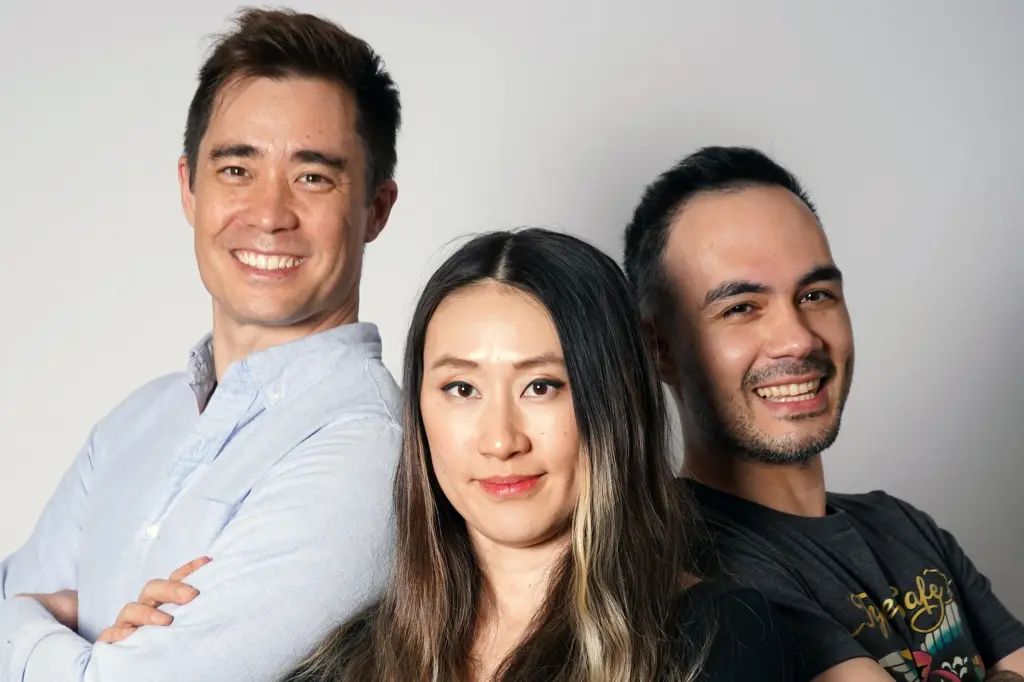
TypeSafe fue fundada por Erik Gafni, Sasha Sheng y Diogo Almeida. Almeida trabajó anteriormente en OpenAI y contribuyó al desarrollo de investigaciones relacionadas con los sistemas de seguimiento de instrucciones de la era de ChatGPT. Sheng trabajó anteriormente en Meta/FAIR, mientras que Gafni cuenta con experiencia en ingeniería y empresas emergentes.
Jev se lanzó públicamente el 15 de septiembre.
Solo dos semanas después, OpenAI anunció una vista previa limitada de una dirección de producto sorprendentemente similar: una API rápida para devolver probabilidades, opciones y puntuaciones en lugar de texto largo generado. OpenAI trasladó ese producto, la Decisions API, a una beta pública el 6 de octubre.
Más tarde, Nikunj Handa, responsable de producto de API en OpenAI, reconoció abiertamente que Jev había inspirado la categoría de producto.
Esto hace que Jev sea interesante por dos motivos.
En primer lugar, propone una forma diferente de utilizar la IA dentro del software.
En segundo lugar, obligó a un laboratorio de vanguardia a responder con una rapidez inusual.
Jev no intenta ser la IA con la que conversas.
Intenta ser la IA a la que tu software llama miles o millones de veces sin que tú llegues a ver la respuesta.
Abre una bandeja de entrada de correo electrónico y encontrarás cientos de pequeños juicios pendientes.
¿Es importante este mensaje?
¿Contiene una factura que está a punto de vencer?
¿Requiere una respuesta urgente?
¿Ha cambiado la hora de la reunión?
¿Debe archivarse, escalarse o ignorarse?
Un modelo de lenguaje de propósito general ya puede responder preguntas como estas.
El problema es que un LLM convencional suele estar diseñado para generar lenguaje.
Para un solo correo electrónico, esa sobrecarga quizá no importe.
A escala, sí importa.
Si una aplicación toma el mismo tipo de decisión miles o millones de veces al día, pequeñas diferencias en latencia y coste se convierten en grandes gastos operativos.
Jev está diseñado específicamente para esos juicios repetidos.
TypeSafe describe Jev como un modelo System One.
La referencia alude al estilo de cognición rápido e intuitivo del «Sistema 1», popularizado por Daniel Kahneman.
En lugar de pedir a Jev que genere un párrafo, una aplicación le proporciona un estado y un conjunto de preguntas predefinidas.
Jev devuelve valores tipados como:
La aplicación puede utilizar directamente el resultado.
Un patrón simplificado sería el siguiente:
Correo electrónico entrante
      ↓
Jev evalúa varias preguntas
      ↓
urgent_reply = 0.91
billing_related = 0.74
meeting_change = 0.03
      ↓
La aplicación aplica sus propias reglas
      ↓
Alerta / archivar / derivar / revisar
La diferencia importante está en la interfaz.
Con un modelo de lenguaje general, los desarrolladores suelen pedir JSON u otro formato estructurado y después validar la respuesta generada.
Con Jev, las salidas de decisiones tipadas son el núcleo del diseño del producto.
La API de TypeSafe expone un único endpoint systemone y permite a los desarrolladores enviar varias preguntas sobre el mismo estado compartido.
TypeSafe pone énfasis en la toma de decisiones en paralelo.
Si una aplicación quiere evaluar la misma entrada según varios criterios independientes, puede enviar esas preguntas juntas en lugar de convertir cada una en un turno conversacional separado.
Esto resulta útil para el software que necesita responder preguntas como:
Después, la aplicación combina esas salidas mediante código convencional.
Esta es una de las razones por las que Jev se parece menos a un chatbot y más a una instrucción condicional inteligente.
Actualmente, TypeSafe muestra Jev con los siguientes precios:
| Uso | Precio de Jev |
|---|---|
| Entrada | 0,042 $ / 1 millón de tokens |
| Salida | Gratis |
TypeSafe afirma que la salida es demasiado barata como para medirla, porque Jev no genera secuencias largas de texto de forma autorregresiva.
El precio importa porque Jev se dirige a decisiones que pueden producirse con una frecuencia extremadamente alta.
Una decisión demasiado cara para automatizarla una vez por acción del usuario puede resultar viable cuando el coste se reduce en un orden de magnitud.
Esto crea una pregunta de implementación diferente.
En lugar de preguntar:
¿Es esto lo bastante importante como para llamar a un modelo de IA?
Los equipos de software pueden empezar a preguntar:
¿Por qué no dejar que la IA evalúe también este pequeño paso?
Ese es el argumento económico que sustenta el producto.
El precio destacado por token es solo una parte del coste de producción.
Los equipos todavía necesitan medir:
Una decisión barata que se equivoca con demasiada frecuencia también puede resultar cara.
Este punto será importante más adelante, en la evaluación independiente de Jev.
Vercel añadió Jev a AI Gateway casi inmediatamente después de su lanzamiento.
La respuesta del primer día fue inusualmente sólida.
Según Vercel, en 24 horas Jev había sido utilizado por casi el 13 % de los equipos de AI Gateway de pago.
Esto representaba más del doble del alcance del primer día de cualquier lanzamiento de modelo anterior en la plataforma.
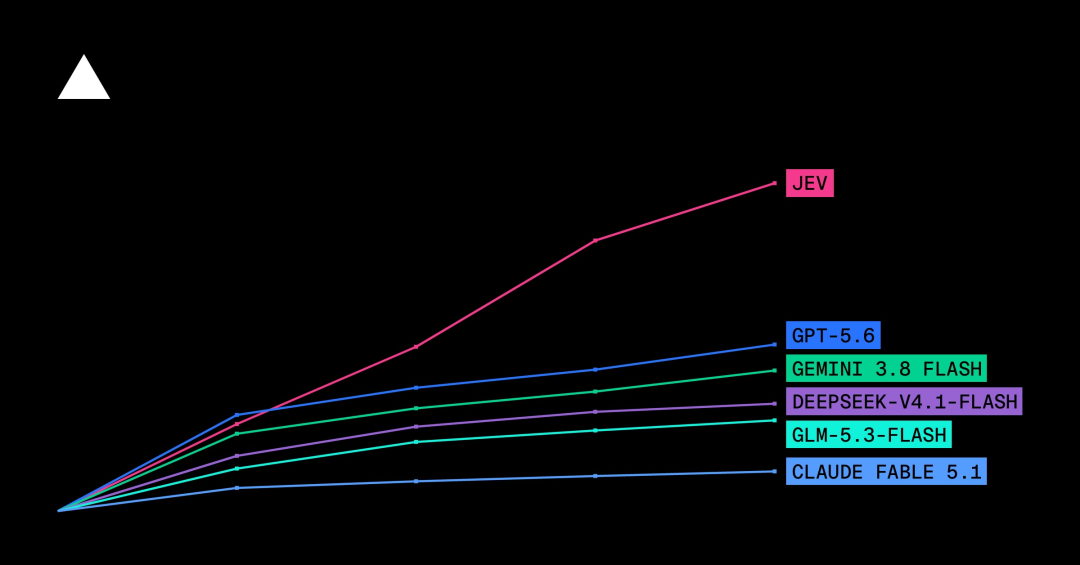
Más tarde, Vercel calificó a Jev como el modelo adoptado con mayor rapidez en la historia de AI Gateway.
Ese pico del primer día no demuestra una retención a largo plazo.
Sí demuestra que los desarrolladores reconocieron de inmediato una clase de tareas en las que un modelo de decisiones especializado podía resultar útil.
Vercel enumera ejemplos como:
No son tareas glamorosas.
Son exactamente el tipo de tareas que el software de producción ejecuta constantemente.
La idea detrás de Jev no apareció de la noche a la mañana.
Diogo Almeida ha explicado que, mientras trabajaba en OpenAI, empezó a interesarse cada vez más por una pregunta básica:
Si la IA transforma la economía, ¿quién realizará la mayoría de las llamadas a modelos en el futuro?
¿Personas abriendo manualmente ventanas de chat?
¿O el software llamando automáticamente a la inteligencia en segundo plano?
Su respuesta fue la segunda opción.
Esto cambia aquello que una interfaz de IA debería optimizar.
Los modelos orientados a las personas se benefician de la conversación natural, la prosa flexible, la explicación y la creatividad.
Los modelos orientados al software se benefician de:
Almeida ha descrito Jev como una respuesta a la brecha entre los modelos que resultan impresionantes en una conversación y los modelos que son fáciles de utilizar como primitivas de software fiables.
TypeSafe afirma que pasó aproximadamente dos años desarrollando el sistema antes de su lanzamiento público.
El lanzamiento de Jev no pasó desapercibido dentro de OpenAI.
En una entrevista de Latent Space grabada alrededor de OpenAI DevDay, Nikunj Handa, responsable de producto de API, reconoció directamente que Jev había inspirado el impulso de la Decisions API.
Explicó que usuarios y equipos internos estaban solicitando un sistema de clasificación mucho más rápido.
También confirmó que el proyecto no había estado en la hoja de ruta apenas unas semanas antes.
OpenAI no entrenó un modelo fundacional completamente nuevo solo para la primera versión.
En su lugar, utilizó GPT-6 Luna y construyó en torno a él una interfaz de decisiones y una ruta de inferencia específicas.
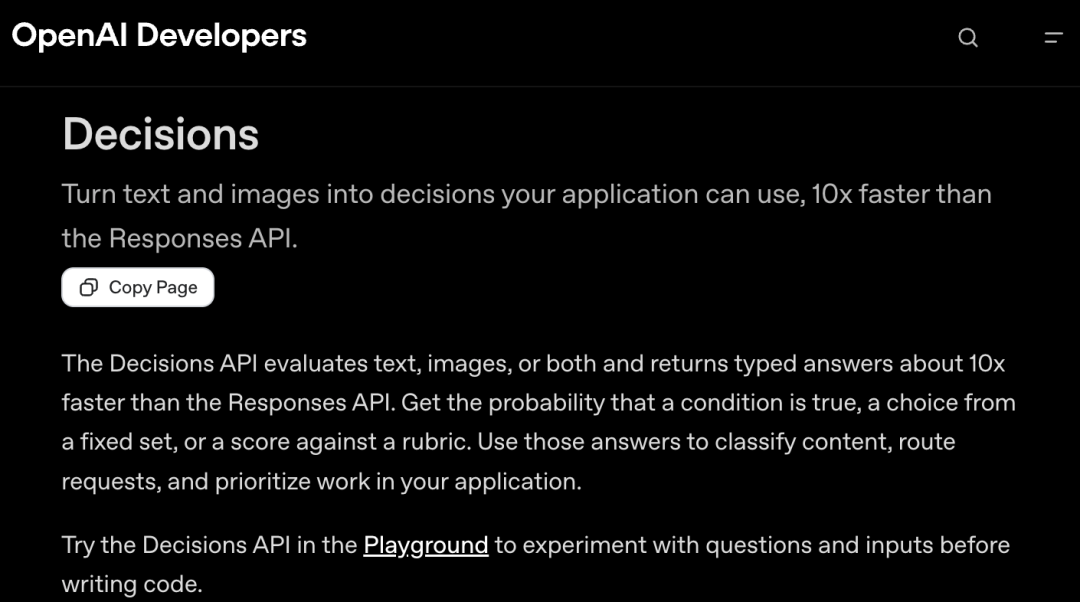
El resultado está ahora disponible en beta pública mediante:
POST /v1/decisions
La Decisions API acepta evidencia compartida junto con una o más preguntas y devuelve respuestas tipadas.
Actualmente, OpenAI admite tres tipos de preguntas:
| Tipo de pregunta | Resultado |
|---|---|
predicate | Probabilidad de que una condición sea verdadera |
choice | Una opción seleccionada junto con probabilidades/confianza |
score | Una puntuación distribuida entre niveles ordenados |
Esto coincide en gran medida con los casos de uso a los que se dirige Jev.
Esta es la mayor diferencia arquitectónica entre los productos públicos actuales.
TypeSafe afirma que Jev utiliza una arquitectura de modelo especializada y un método de entrenamiento que denomina Reinforcement Learning for Calibrated Decisions (RLCD).
La primera versión de OpenAI Decisions API utiliza, en cambio, los pesos existentes de GPT-6 Luna, junto con una interfaz especializada para servir decisiones.
Conceptualmente:
TypeSafe:
Modelo de decisiones especializado
→ salida probabilística tipada

OpenAI:
GPT-6 Luna
→ ruta especializada de Decisions API
→ salida probabilística tipada
Esto significa que ambos productos pueden parecer similares para los desarrolladores, aunque adopten enfoques diferentes internamente.
Una diferencia práctica es la modalidad de entrada.
La actual OpenAI Decisions API acepta texto, imágenes o ambos.
El lanzamiento público de Jev por parte de TypeSafe se centró en entradas de texto/estado.
La documentación de OpenAI incluye un ejemplo en el que la API inspecciona una fotografía de producto y estima si existe algún daño visible, como una grieta, un desgarro o una abolladura.
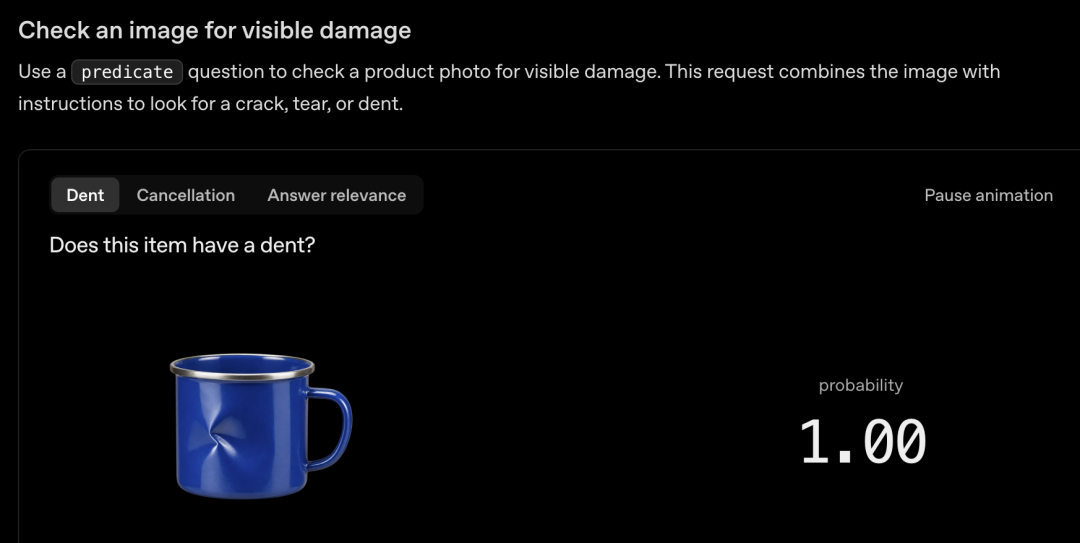
Una aplicación de comercio electrónico podría utilizar este patrón para derivar automáticamente las imágenes a revisión.
Por ejemplo:
Fotografía del producto
→ Decisions API comprueba si existe daño visible
→ probabilidad = alta
→ derivar a inspección manual
Este es un buen ejemplo de por qué las API de decisiones pueden integrarse en el software convencional sin producir una respuesta visible para el usuario.
Es posible que el usuario nunca sepa qué modelo evaluó la fotografía.
Solo experimenta el flujo de trabajo resultante.
Los precios públicos actuales son sencillos.
| Producto | Precio de entrada | Precio de salida |
|---|---|---|
| TypeSafe Jev | 0,042 $ / 1 millón de tokens | Gratis |
| OpenAI Decisions API con GPT-6 Luna | 0,10 $ / 1 millón de tokens | Gratis |
En cuanto al precio base por token de entrada, Jev es más barato.
La documentación de OpenAI Decisions indica que la API devuelve respuestas tipadas aproximadamente 10 veces más rápido que la Responses API.
Esa afirmación de 10 veces es específicamente una comparación con la propia ruta Responses API de OpenAI.
No constituye una ventaja de velocidad publicada de 10 veces frente a Jev en una comparación directa.
La distinción es importante.
Del mismo modo, TypeSafe publica multiplicadores de velocidad y coste mucho mayores en sus propias evaluaciones de flujos de trabajo, pero reconoce explícitamente que esas pruebas siguen su propia metodología y pueden situarse en el extremo superior de las mejoras observables en el mundo real.
Para seleccionar una solución en producción, los equipos deberían comparar el rendimiento con su carga de trabajo real.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Lo que hace inusual esta historia de producto es la franqueza con la que OpenAI reconoció la inspiración.
En la entrevista de Latent Space, Handa afirmó que Jev inspiró la categoría y que los usuarios y equipos internos de OpenAI empezaron rápidamente a solicitar una capacidad de clasificación rápida similar.
Describió a un pequeño grupo interno que construyó rápidamente un prototipo y después optimizó la latencia.
Esto no significa que Jev y Decisions API sean idénticos.
Sí demuestra que TypeSafe encontró una carencia real de producto.
La competencia pasó de:
¿Quién tiene el modelo general más capaz?
a otra pregunta:
¿Cuál es la primitiva de modelo más barata y rápida
para una decisión repetida específica dentro del software?
Ese es un mercado diferente al de las comparativas tradicionales de chatbots.
El bajo precio de Jev recibió un análisis independiente útil poco después de su lanzamiento.
El 29 de septiembre, investigadores de la Universidad de Bonn y del Instituto Lamarr presentaron un preprint en el que evaluaban Jev 1.13.0.
El estudio cubrió:
El coste total de la API de Jev fue inferior a 10 dólares.
Es una cifra llamativa.
Pero la parte más importante del estudio es lo que afirma sobre la fiabilidad.
Los investigadores descubrieron que las probabilidades de elección de Jev podían ser útiles para la predicción selectiva.
En términos sencillos:
Si el sistema responde únicamente a los casos en los que tiene mayor confianza, la precisión puede ser más alta.
Cuando la aplicación acepta más casos de baja confianza, la precisión disminuye.
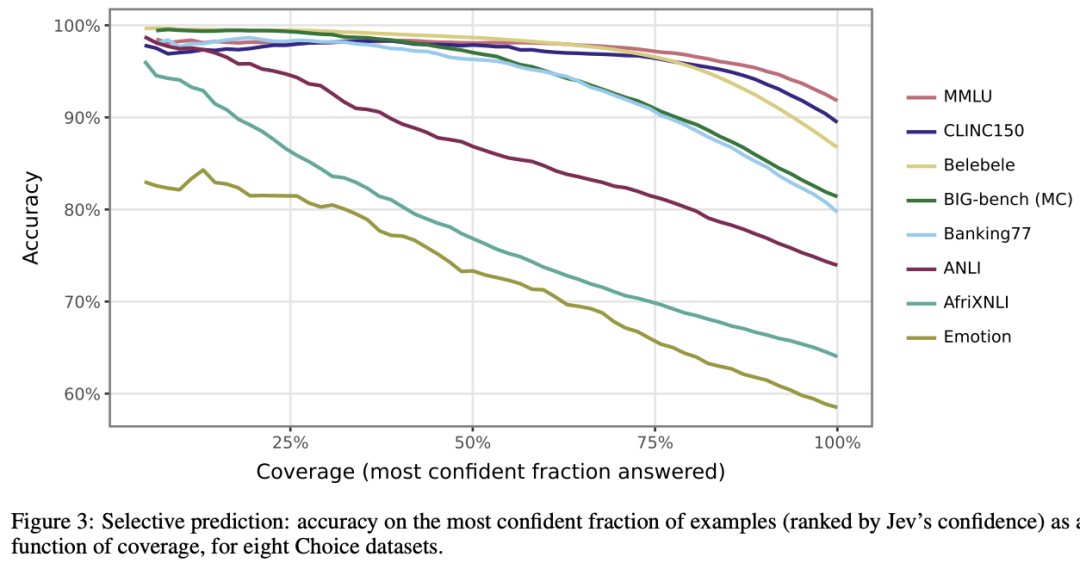
Precisamente por eso las probabilidades resultan útiles en la automatización.
Un flujo de trabajo de producción puede definir comportamientos diferentes para distintos niveles de confianza.
Por ejemplo:
confidence >= 0.95
→ automatizar

0.70 <= confidence < 0.95
→ solicitar una verificación secundaria

confidence < 0.70
→ revisión humana
Los umbrales exactos deberían proceder de los datos de evaluación, no de la intuición.
El estudio encontró una salvedad importante para las decisiones binarias.
Las probabilidades de Jev podían ordenar bien los ejemplos y, aun así, estar mal calibradas alrededor de un umbral fijo de 0,5.
Esto significa que esta regla:
if probability >= 0.5:
    act
no es automáticamente óptima para todas las tareas.
En una evaluación de UNFAIR-ToS, los investigadores informaron de que ajustar los umbrales con datos de entrenamiento mejoró el micro-F1 de 0,50 a 0,75.
La lección general es sencilla:
Una probabilidad es útil, pero la aplicación todavía debe decidir qué probabilidad es suficientemente alta como para actuar.
Esto no es exclusivo de Jev.
Es un requisito básico para implementar clasificadores probabilísticos de forma responsable.
Volvamos al ejemplo del correo electrónico.
Supongamos que un modelo marca incorrectamente como importante un correo promocional. El coste es una pequeña molestia.
Ahora supongamos que no detecta un correo que requiere respuesta antes de que termine el día. El coste puede ser mucho mayor.
Por tanto, el umbral correcto depende de la asimetría entre falsos positivos y falsos negativos.
Un sistema práctico puede utilizar reglas diferentes para decisiones diferentes:
| Decisión | Valor predeterminado más seguro |
|---|---|
| Detección de correos promocionales | Automatizar de forma agresiva |
| Detección de plazos de facturación | Utilizar un umbral inferior para las alertas |
| Clasificación jurídica o de cumplimiento | Escalar la incertidumbre |
| Acción sobre una cuenta de alto riesgo | Exigir confirmación humana |
| Etiquetado de contenido de bajo valor | Automatizar la mayoría de los casos |
Un modelo de decisiones sólido no elimina las políticas de producto.
Hace que las políticas de producto sean más fáciles de expresar en el software.
TypeSafe destaca que la salida de Jev es segura en cuanto al tipo.
Esta es una propiedad de ingeniería real.
Si el desarrollador define un conjunto permitido de salidas, el modelo no necesita inventar una cadena arbitraria fuera de ese esquema.
Pero existen dos tipos diferentes de corrección:
La salida coincide con el tipo permitido.
La respuesta seleccionada es realmente correcta.
Un modelo de decisiones puede garantizar la primera con mucha más solidez que la segunda.
La evaluación independiente hace evidente esta diferencia: Jev todavía puede elegir la respuesta incorrecta aunque su respuesta sea perfectamente válida como valor tipado.
Por eso, la interpretación más segura para producción es:
Jev elimina una gran clase de fallos de formato y análisis, pero no elimina los errores del modelo.
La fuente original señala correctamente que no todos los juicios deberían delegarse a Jev.
El propio material de TypeSafe reconoce que los modelos System One especializados tienen un papel más limitado que los modelos de lenguaje generales.
Una división útil del trabajo sería la siguiente:
Ejemplos:
Ejemplos:
Ejemplos:
Ejemplos:
El modelo barato no debería crear un nuevo gasto al producir decisiones que las personas tengan que corregir constantemente.
El nombre Jev hace referencia al economista William Stanley Jevons.
Jevons está asociado con la idea que ahora se denomina paradoja de Jevons.
La versión simplificada es:
El recurso se vuelve más eficiente
→ disminuye el coste por uso
→ aumenta la demanda
→ puede crecer el consumo total del recurso
TypeSafe aplica esa lógica a la inteligencia artificial.
Si cada llamada a la IA se vuelve mucho más barata, el software quizá no se limite a gastar menos en las mismas cargas de trabajo.
Los desarrolladores pueden crear cargas de trabajo completamente nuevas que antes eran demasiado caras como para justificarlas.
Esto ya se observa en ejemplos como:
El resultado puede ser un coste por decisión menor, pero muchas más decisiones en total.
Esta es la apuesta basada en la paradoja de Jevons que subyace a Jev.
La parte más importante de esta tendencia puede ser invisible para los usuarios.
Hoy, las personas suelen interactuar con la IA de forma explícita:
Abrir un chatbot
→ pegar el contexto
→ escribir un prompt
→ leer la respuesta
→ copiar el resultado en otra herramienta
Los modelos de decisiones nativos para máquinas sugieren otro patrón:
El usuario utiliza un software normal
→ la IA evalúa pequeñas decisiones en segundo plano
→ el software deriva, puntúa, comprueba o filtra automáticamente
→ la persona solo ve los casos importantes
Una bandeja de entrada puede mostrar únicamente los correos urgentes.
Una herramienta de escritura puede señalar solo las frases que necesitan revisión.
Un agente puede elegir automáticamente la siguiente herramienta.
Un sistema de soporte puede derivar los tickets antes de que los vea una persona.
Un marketplace puede clasificar a los candidatos inmediatamente después del registro.
En ese momento, quizá al usuario no le importe si el sistema subyacente utilizó Jev, GPT-6 Luna u otro modelo de decisiones.
Al usuario le importa que el software parezca más rápido y requiera menos pasos manuales.
La financiación de TypeSafe tiene más sentido desde esa perspectiva.
La empresa no está apostando por que las personas quieran otra pestaña de chatbot.
Está apostando por que el propio software realizará un número enorme de llamadas a modelos.
TypeSafe afirma que un tercio de las empresas de Fortune 500 ya utiliza Jev, aunque se trata de una cifra de adopción comunicada por la empresa y esta no ha identificado públicamente a todos esos clientes.
La ronda Serie A de 870 millones de dólares proporciona a TypeSafe un capital considerable para ampliar esa estrategia.
En su anuncio de financiación, la empresa afirma que pretende desarrollar:
La rápida respuesta de OpenAI con Decisions API sugiere que los grandes laboratorios ven la misma oportunidad.
La próxima pregunta competitiva no es simplemente qué sistema es más barato.
Es cuál produce decisiones suficientemente fiables como para que los desarrolladores se sientan cómodos dejando que el software actúe sobre ellas automáticamente.
Jev es el primer «modelo System One» de TypeSafe AI, diseñado para tomar decisiones rápidas y legibles por máquinas en lugar de generar texto libre. Acepta un estado compartido junto con preguntas tipadas y devuelve opciones, puntuaciones o probabilidades que el software puede utilizar directamente.
Actualmente, TypeSafe muestra Jev a 0,042 dólares por millón de tokens de entrada, con salida gratuita. El coste real de una aplicación depende del volumen de solicitudes, el tamaño de las entradas, los reintentos, la sobrecarga de evaluación y el número de casos que se escalan a modelos más grandes o a personas.
TypeSafe describe Jev como un modelo System One basado en transformadores, en lugar de un modelo de lenguaje grande convencional para la generación de texto. Su comportamiento distintivo como producto es que no genera prosa arbitraria, sino que devuelve decisiones probabilísticas tipadas.
Sí. Las salidas seguras en cuanto al tipo evitan determinados errores de formato y de esquema, pero la decisión seleccionada todavía puede ser semánticamente incorrecta. Una evaluación independiente muestra resultados sólidos en muchos conjuntos de datos, pero también identifica errores dependientes de la tarea y problemas de calibración de umbrales.
OpenAI Decisions API es un endpoint en beta pública impulsado por GPT-6 Luna que convierte texto o imágenes en predicados, opciones o puntuaciones tipadas. OpenAI anuncia que es aproximadamente 10 veces más rápida que utilizar la misma categoría de trabajo mediante Responses API.
El precio actual de Decisions API es de 0,10 dólares por millón de tokens de entrada, sin cargo por tokens de salida. El precio base publicado de Jev es inferior: 0,042 dólares por millón de tokens, también con salida gratuita.
Una probabilidad no indica por sí sola qué acción debe tomar una aplicación. Los equipos deberían elegir los umbrales utilizando datos de evaluación etiquetados y el coste real de los falsos positivos, los falsos negativos y la revisión humana, en lugar de asumir que 0,5 es siempre el corte adecuado.
Los modelos de decisiones son más adecuados para la clasificación, el enrutamiento, la puntuación, la verificación y la ramificación de gran volumen cuando las salidas posibles pueden definirse de antemano. Utiliza modelos de propósito general cuando la tarea requiera razonamiento abierto, explicación, generación de contenido o planificación compleja.
TypeSafe Jev adopta un enfoque deliberadamente limitado para la IA: en lugar de producir lenguaje para las personas, produce decisiones tipadas para el software. Este diseño hace que la clasificación, el enrutamiento, la puntuación y la verificación de gran volumen sean mucho más baratos y fáciles de integrar en el código.
La adopción inicial del modelo fue suficientemente sólida como para que OpenAI entrara rápidamente en la misma categoría de producto con Decisions API, impulsada por GPT-6 Luna. Jev sigue siendo más barato según el precio base publicado de entrada, mientras que OpenAI añade compatibilidad con imágenes y la escala de una plataforma de modelos de propósito general ya existente.
El principal desafío de ingeniería es la fiabilidad, no el formato. Las salidas tipadas eliminan una clase de fallos, pero la precisión de las decisiones todavía depende del conjunto de datos, el umbral, el coste de los errores y la política de escalado. El estudio independiente de Jev lo deja especialmente claro.
El cambio más amplio es que la IA puede dejar de ser algo con lo que los usuarios conversan de forma explícita y convertirse en una capa de decisiones de bajo coste que se ejecuta discretamente dentro del software cotidiano.
Empieza con una sola frase y obtén un sitio completo en minutos.



