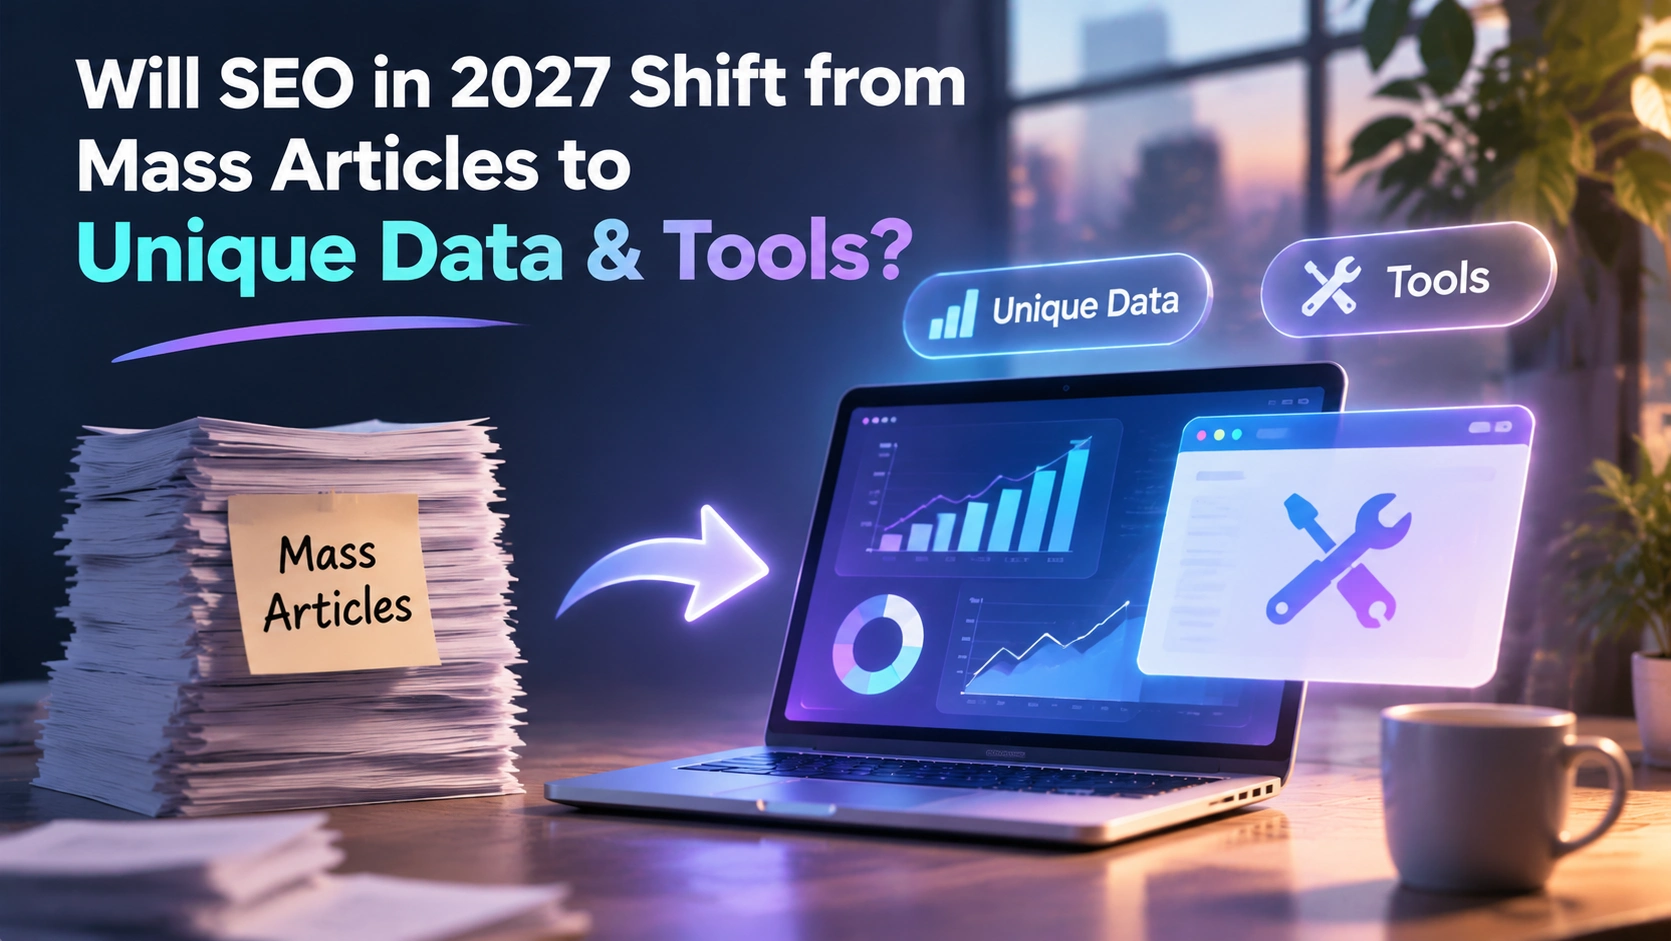
Résumer le changement de 2027 en une phrase : la rentabilité marginale du trafic des pages produites en volume continuera de baisser ; la valeur relative des pages capables de fournir une information indépendante et d’aider l’utilisateur à accomplir sa tâche augmentera.
Il s’agit d’une prévision sectorielle, pas d’une règle déjà publiée par les moteurs de recherche. Trois types de documents publics étayent ce jugement : la définition par la politique relative au spam des « contenus générés à grande échelle sans valeur ajoutée pour l’utilisateur », l’accent mis par les consignes sur le contenu généré par IA sur « le contenu est-il utile ? », et le constat observable que les réponses de recherche générative incluent généralement des liens de citation.
La forme réelle de ce basculement n’est pas « arrêter de mettre à jour le blog », mais une réorganisation du mix de contenus. Les articles explicatifs passeront du statut de source principale de trafic à celui de socle : ils restent nécessaires, mais pourront difficilement porter à eux seuls la croissance d’un site de contenu. Les données exclusives, les outils interactifs, les pages de bases de données interrogeables et les cas réels deviendront le champ de bataille principal de la différenciation.
Ce qui arrive à la structure de l’offre lorsque l’IA ramène le coût de production à presque zéro
Ce que l’IA change d’abord, c’est la structure des coûts. Lorsqu’un article générique bien structuré et fluide peut être produit à un coût proche de zéro, l’offre de pages pour une même intention de recherche explose rapidement, tandis que l’attention totale des utilisateurs reste inchangée.
Le résultat n’est pas « le contenu IA est pénalisé », mais « les pages sans incrément d’information indépendant perdent leur avantage comparatif ». Trois catégories de pages sont réellement diluées :
- les variantes de modèle où seuls le nom de ville, le secteur ou l’année changent ;
- les « pseudo-études » qui réordonnent des rapports publics et n’ajoutent qu’un paragraphe d’interprétation ;
- les articles longs qui ne donnent pas de réponse dès le premier écran et obligent l’utilisateur à tout lire pour juger de leur pertinence.
Ces trois catégories pouvaient encore capter des miettes grâce à la longue traîne à l’époque des dix liens bleus. Mais aujourd’hui, où les réponses sont directement extraites et où les pages doivent être citées comme preuves, leur situation se dégrade nettement.
La politique a déjà tracé une ligne rouge : « volume + absence de valeur ajoutée »
Sur le plan politique, deux faits doivent être distingués.
Premièrement, la politique de Google sur le spam dans la recherche Web classe parmi les abus de contenu à grande échelle (scaled content abuse) les « pages générées à grande échelle dans le but de manipuler le classement dans les résultats de recherche et sans apporter de valeur ajoutée aux utilisateurs », et précise que la détermination de ces comportements est indépendante du fait que le contenu soit créé automatiquement ou manuellement. Les mots clés sont « volume » et « absence de valeur ajoutée » simultanément, et non « utilisation de l’IA ».
Deuxièmement, les consignes de Google sur le contenu généré par IA autorisent les sites à recourir à l’automatisation pour aider à produire du contenu, à condition que celui-ci soit utile aux utilisateurs, crédible et que des humains en assument la qualité. Les consignes du même site pour un contenu utile, fiable et centré sur l’utilisateur placent également le cœur du jugement sur des informations vérifiables telles que « qui l’a écrit, comment cela a été fait, pourquoi mérite-t-il la confiance ».
Pris ensemble, le point de risque de la publication massive d’articles ne réside pas dans l’outil, mais dans la substituabilité : un lot de pages couvre des dizaines de mots clés proches, l’utilisateur ne peut prendre aucune décision après en avoir lu une seule, et les moteurs de recherche comme les utilisateurs manquent de raisons de les traiter différemment.
Trois signaux de prévision, et une limite à ne pas franchir

Premièrement, le discours politique est déjà clair. Les pages automatisées à grande échelle et à faible valeur appartiennent à la zone d’infraction ; cette limite ne dépend pas de conjectures sectorielles.
Deuxièmement, le centre de gravité des documents officiels est l’« utilité ». Le guide de démarrage SEO de Google explique comment aider les moteurs de recherche à comprendre le contenu, et aider les utilisateurs à trouver le contenu et à juger s’il vaut la peine d’être consulté ; le glossaire de la documentation Web MDN inscrit le SEO comme terme Web fondamental. Ni l’un ni l’autre ne pose de condition technique du type « données originales obligatoires », mais tous deux placent le bénéfice pour l’utilisateur au centre.
Troisièmement, le parcours de consommation de contenu change. Les utilisateurs obtiennent de plus en plus d’abord un résumé avec citations auprès d’un assistant IA, puis décident quelle page ouvrir. Les pages susceptibles d’être citées comme preuves ont généralement une définition précise, un échantillon précis et une fenêtre temporelle précise.
La limite doit aussi être claire : les données exclusives, la recherche originale et les outils interactifs ne sont actuellement pas des facteurs de classement publiés par Google. Les présenter comme des « bonus de classement officiellement confirmés » est faux. Formulation plus prudente : dans un environnement où les pages se banalisent, ces formats ont plus de chances d’obtenir de vrais signaux d’utilisateurs et des citations externes, et donc de prendre l’avantage dans la concurrence.
Tableau comparatif des capacités de cinq formats de contenu
| Format de contenu | Valeur centrale | Principale intention de recherche couverte | Coût de réutilisation et de maintenance | Recommandation d’indexation |
|---|---|---|---|---|
| Article généré par IA standard | Expliquer les concepts de base, couvrir les questions de longue traîne | Questions d’initiation « qu’est-ce que », « comment faire » | Faible, mais très facilement remplacé par des contenus similaires | Fusionner les pages similaires, ne conserver que quelques articles réellement différenciés |
| Article de recherche original | Fournir des données indépendantes et des conclusions citables | « combien », « quelle tendance », « comparaison sectorielle » | Élevé, nécessite une description de méthode et une mise à jour régulière | Indexer en priorité, avec page de méthode et description des données |
| Outil interactif | Aider l’utilisateur à accomplir immédiatement une tâche ou obtenir un résultat de calcul | « calculer », « détecter », « générer », « évaluer » | Moyen à élevé, nécessite une maintenance continue de la logique et des résultats | Indexer en priorité, garantir que les pages de résultats sont explorables |
| Page de type base de données | Fournir des informations structurées interrogeables et filtrables | « liste », « prix », « modèle », « région » | Moyen, dépend de la fréquence de mise à jour de la source | Indexer seulement si les conditions d’unicité sont remplies, sinon réduire |
| Cas réel | Fournir une expérience réelle, un processus et les limites des résultats | « efficacité », « comment mettre en œuvre », « vaut-il la peine » | Moyen, dépend de l’accumulation de projets réels | Indexer, en soulignant le sujet, la période et les conditions limites |
La colonne la plus souvent négligée dans le tableau est celle du « coût de réutilisation et de maintenance ». Les articles massifs coûtent peu, mais leur valeur de réutilisation est tout aussi faible ; la recherche et les outils demandent un investissement initial élevé, mais un jeu de données peut soutenir plusieurs articles d’analyse, des versions multilingues et des citations sur le long terme.
Qu’est-ce qui constitue des « données exclusives que les autres ne peuvent pas produire à court terme » ?
« Exclusif » ne signifie pas « que nous avons compté nous-mêmes », mais que les autres ont du mal à reproduire en peu de temps. Les données susceptibles de créer une différence proviennent généralement de quatre sources :
- Capital métier propre : comportements agrégés anonymisés dans le produit, cycles de conversion, causes d’échec fréquentes, répartition de l’usage des fonctionnalités.
- Processus clients et projets : cycles de mise en ligne, comparaisons avant/après refonte, évolution de la structure entre acquisition payante et trafic naturel.
- Panneaux sectoriels collectés en continu : offres d’emploi, pages de tarification, documents publics, snapshots réguliers de textes réglementaires.
- Questionnaires ou entretiens maison : études primaires avec taille d’échantillon, méthode de recrutement et taux de réponse explicites.
Pour que les données puissent être citées, quatre éléments doivent être réunis simultanément : définition de la mesure (comment sont calculés le numérateur et le dénominateur), périmètre de l’échantillon (qui est inclus, qui est exclu), fenêtre temporelle (période de collecte et fréquence de mise à jour), description de la méthode (comment les données sont nettoyées, comment les valeurs aberrantes sont traitées). S’il manque un seul élément, le lecteur et l’assistant IA ne peuvent pas juger si le chiffre est crédible, et la valeur différenciante est réduite d’autant.
Les contre-exemples méritent aussi d’être rappelés : réordonner des chiffres issus de rapports publics et y ajouter sa propre interprétation ne constitue pas des données exclusives. Ce type de contenu peut générer des clics à court terme, mais ne crée pas de barrière à la citation.
Pourquoi les calculateurs, outils de test et pages interactives résistent mieux à la substitution
Un résumé peut reformuler une explication, mais il ne peut pas réaliser un calcul à la place de l’utilisateur. Lorsqu’un utilisateur recherche « combien coûte ce type de projet » ou « mon site remplit-il telle condition », ce qu’il veut vraiment, c’est un résultat, pas une description. Les pages d’outils ont donc naturellement deux caractéristiques : l’action de l’utilisateur se déroule sur la page, et la page elle-même devient une partie de la réponse.
Pour traduire cet avantage en performance dans les recherches, trois choses doivent être traitées.
Creez un site vitrine et genere des leads en quelques minutes
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
- Faire en sorte que la page puisse d’abord être explorée. Le texte explicatif principal, la signification des champs de saisie et l’explication des résultats doivent autant que possible être produits en rendu côté serveur ou en pré-rendu, afin d’éviter que tout le contenu ne soit généré qu’après un clic. L’explorabilité est la condition préalable d’une page interactive.
- Ajouter des données structurées à la page d’outil. Prenons l’exemple d’un outil d’évaluation gratuit : on peut utiliser le type
SoftwareApplicationpour indiquer le nom, la catégorie et le prix :
{
  "@context": "https://schema.org",
  "@type": "SoftwareApplication",
  "name": "Outil d’auto-évaluation de l’indexabilité du contenu du site",
  "applicationCategory": "BusinessApplication",
  "operatingSystem": "Web",
  "offers": { "@type": "Offer", "price": "0", "priceCurrency": "CNY" }
}
- Rendre les résultats partageables et citables. Ce n’est que si les paramètres peuvent être reproduits via un lien et si les résultats disposent d’une explication de calcul claire qu’ils seront utilisés comme référence par des pages externes et des réponses IA.
Comment organiser les cas d’entreprise et la recherche originale
Le problème des cas n’est généralement pas leur nombre, mais leur structure. Un cas digne de confiance doit au minimum clarifier cinq choses : le contexte et les contraintes du projet, les actions concrètes mises en œuvre (ne pas se contenter d’écrire « optimisation de la stratégie de contenu »), les changements observables, la durée d’observation, et les situations dans lesquelles il ne s’applique pas. Si l’on ne présente l’« effet » que comme une conclusion, le lecteur aura au contraire du mal à juger si cela le concerne.
La recherche originale gagne à être publiée selon une structure en trois couches : la première est une page de synthèse des conclusions, qui explique en un ou deux paragraphes les découvertes les plus importantes et la taille de l’échantillon ; la deuxième est une page de méthode, qui précise la source des données, les règles de nettoyage, le traitement des valeurs manquantes et les limites ; la troisième est une annexe de jeu de données ou de graphiques, pour faciliter la citation de chiffres précis. Les contenus de recherche doivent aussi conserver un journal des mises à jour, avec la version des données et les raisons des révisions ; sinon, six mois plus tard, des chiffres contradictoires feront rapidement perdre la crédibilité.
Quatre actions pour faire en sorte que les pages d’outils et les tutoriels se soutiennent mutuellement
L’outil résout le « faire », l’article résout le « pourquoi » et le « comment » ; les deux servent mutuellement de point d’entrée de trafic et de caution de confiance.
- Utiliser les articles pour précéder le besoin. Dans un tutoriel, expliquer dans quels cas l’outil est nécessaire, quels paramètres saisir, comment interpréter les résultats, et placer le lien vers l’outil dans un contexte d’action du type « commencer le calcul » ou « lancer la détection », plutôt que de l’insérer au hasard dans un paragraphe.
- Utiliser l’outil comme preuve de l’article. Si les conclusions d’un article peuvent être vérifiées par un petit outil reproductible, le temps passé et le retour des lecteurs seront plus naturels, et la probabilité que des pages externes citent la même page augmentera.
- Unifier les termes et la structure. Le même indicateur doit utiliser exactement le même nom et la même définition sur la page d’outil, la page de tutoriel et la page de cas, afin d’éviter que l’utilisateur ne voie des définitions différentes selon les pages.
- Établir une synchronisation des mises à jour. Lorsque la logique de l’outil est modifiée, réviser en même temps les exemples chiffrés des tutoriels et des cas associés, en indiquant un numéro de version ou une date de mise à jour, pour réduire les contradictions entre pages.
Comment juger si une page programmatique mérite d’être indexée
La génération programmatique n’est pas illégale en soi ; ce qui est illégal, c’est « grand volume + absence de valeur ajoutée ». Avant la mise en ligne, passer en revue chaque point de la liste ci-dessous ; si un point est clairement négatif, envisager la fusion ou le passage en non-indexé :
- Information unique : cette page possède-t-elle des données, un stock, des paramètres ou des conclusions propres à cette combinaison ? Si seuls les groupes de mots du titre changent, la réponse est directement non.
- Capacité à répondre : l’utilisateur arrive avec une question précise ; le premier écran peut-il donner la réponse ou une prochaine étape claire ?
- Authenticité : les chiffres, noms et dates de la page existent-ils réellement, et peuvent-ils être rattachés à une source de données ?
- Échelle des combinaisons : ces pages sont-elles l’enveloppe d’un même modèle, ou chaque combinaison a-t-elle une différence substantielle ? Les combinaisons sans différence doivent être fortement réduites.
- Maintenabilité : après une mise à jour des données, les pages se synchronisent-elles automatiquement, ou faut-il les corriger une par une manuellement ?
- Valeur d’entrée : la page dispose-t-elle de liens internes et d’une position de navigation claire, ou ne peut-elle être découverte que par hasard via le plan du site ?
- Budget d’exploration : les pages à faible valeur accaparent-elles les ressources d’exploration des pages importantes ?
L’action qui suit le contrôle est plus importante que le contrôle lui-même : fusionner les pages qui ne remplissent pas les conditions en une page de synthèse plus complète, utiliser noindex pour les pures variantes de paramètres tout en préservant leur accessibilité, et réserver les ressources d’exploration économisées aux pages d’outils et de recherche.
Comment les entreprises peuvent hiérarchiser les priorités dès maintenant
Si l’on veut ajuster le mix de contenus à partir de ce mois, on peut avancer en trois étapes, sans réécrire tout le site d’un coup :
- Inventorier l’existant : classer les pages actuelles selon le tableau ci-dessus, signaler celles qui n’existent que sous forme de variantes de modèle ; cette étape permet généralement d’éliminer le plus grand volume de production à faible valeur.
- Choisir un angle d’outil ou de données livrable : partir du maillon métier que l’on connaît le mieux, par exemple l’estimation de devis, la comparaison de configurations, l’auto-contrôle de conformité ; commencer par calculer correctement un problème, puis étendre.
- Construire l’environnement d’accueil : les pages d’outils, de méthode et de cas ont besoin d’une base de site stable, d’un CMS maintenable et d’une configuration SEO/GEO de base. Un espace de travail IA comme We0, qui va de la création de site à l’acquisition de clients, peut générer la structure des pages en langage naturel, puis réunir pages d’outils et pages de contenu dans un même site via un canevas visuel, la collaboration multi-Agent, un back-office CMS et le déploiement de domaine, afin de réduire la rupture fréquente où « l’outil est terminé mais personne ne le maintient ».
FAQ
La publication massive d’articles sera-t-elle encore efficace en 2027 ?
Elle reste efficace, mais son champ d’application se réduira. Les articles qui couvrent de vraies formulations de longue traîne, sont exacts et sont maintenus en continu restent utiles ; les variantes de modèle où seuls le nom de ville ou l’année changent perdront de plus en plus de valeur, car elles sont interchangeables aux yeux des utilisateurs comme des moteurs de recherche.
Les données exclusives sont-elles un facteur de classement publié par Google ?
Non. Les documents officiels publics actuels ne contiennent pas de condition technique du type « bonus pour données originales ». Une interprétation plus raisonnable est la suivante : les données exclusives rendent une page plus difficile à remplacer par un contenu similaire et plus facile à citer par des pages externes et des réponses IA, mais elles ne doivent pas être présentées comme un mécanisme de classement officiellement confirmé.
Que doivent faire les petites et moyennes équipes qui ne disposent pas de données propres ?
Commencer par les données les plus accessibles : les cycles de mise en ligne de ses propres projets, la répartition des questions fréquentes des clients, les enregistrements de comparaison avant/après refonte peuvent tous être organisés en petites études structurées. La taille n’a pas besoin d’être grande, mais la définition, l’échantillon et la fenêtre temporelle doivent être clairement indiqués. Il en va de même pour les outils : un petit outil qui calcule correctement des règles sectorielles génériques produit souvent des résultats plus rapidement que la course aux mégadonnées.
Les pages d’outils interactives risquent-elles de ne pas être explorées parce qu’elles dépendent de JavaScript ?
Le risque existe, mais il peut être évité. Produire sous une forme explorable le texte explicatif principal de l’outil, la signification des paramètres et l’explication des résultats, et ajouter des données structurées adaptées à l’outil, permet aux moteurs de recherche de comprendre le sujet de la page. Le vrai problème est de verrouiller le contenu derrière l’interaction, avec une page initiale presque vide.
Faut-il séparer les pages d’outils et les articles tutoriaux ?
C’est recommandé. La page d’outil assume « l’accomplissement de la tâche » : son contenu doit être court, direct et immédiatement utilisable ; la page de tutoriel assume « le jugement et l’explication » et peut être plus complète. Les deux se lient mutuellement et partagent le même ensemble de définitions terminologiques ; c’est plus facile à comprendre et à citer que de comprimer deux intentions dans une page interminable.
Outils associés
- We0 : espace de travail IA de création de site et d’acquisition de clients pour les sites de présentation, prenant en charge la description des besoins en langage naturel, la génération de pages par collaboration multi-Agent, l’ajustement sur canevas visuel, le déploiement de domaine, le back-office CMS et l’optimisation SEO/GEO ; adapté comme base de site pour les pages d’outils, les pages de cas et les pages d’atterrissage de recherche.
Liens associés
- Politique de Google sur le spam dans la recherche Web : définition officielle des comportements infractionnels tels que l’abus de contenu à grande échelle.
- Consignes de Google sur le contenu généré par IA : exigences et critères officiels lors de la production de contenu assistée par IA.
- Google : créer un contenu utile, fiable et centré sur l’utilisateur : dimensions d’auto-évaluation pour déterminer si un contenu mérite la confiance.
- Guide de démarrage SEO de Google : connaissances de base et points essentiels d’exploration et d’indexation pour l’optimisation pour les moteurs de recherche.
- MDN Web Docs : SEO : définition terminologique et explication de base du SEO.
Résumé
Le changement SEO de 2027 se manifestera plus probablement par une migration de la structure des contenus que par une remise à zéro des volumes. L’avantage de coût des articles massifs existe toujours, mais leur avantage différenciant disparaît ; dans un environnement où l’offre explose, où les résultats de recherche donnent directement la réponse et où les réponses IA s’accompagnent de citations, les pages capables de fournir des données indépendantes, d’aider l’utilisateur à accomplir une tâche et d’expliciter une expérience réelle sont plus facilement dignes de confiance et citées. La limite à respecter sur le plan politique est claire : les pages générées à grande échelle et dépourvues de valeur ajoutée relèvent de la zone d’infraction, tandis que les données originales et les outils interactifs ne sont pas des facteurs de classement officiellement confirmés. La voie praticable consiste à commencer par des données réelles à petite échelle, à faire communiquer les pages d’outils et les tutoriels, à encadrer le périmètre d’indexation des pages programmatiques avec une liste de contrôle, et à concentrer les ressources d’exploration sur un petit nombre de pages réellement dotées d’une valeur unique.