curl -sL https://www.example.com/ | grep -o '[^'
curl -sL https://www.example.com/ | head -c 1200
Si la réponse ne contient que `
` et une série de balises script, sans nom d’entreprise, nom de produit ni paragraphe lisible, alors le robot d’exploration reçoit cette coquille vide lors de sa première visite. La documentation Google sur le SEO JavaScript explique la relation entre exploration et rendu : le contenu des scripts n’est pas totalement invisible, mais le rendu nécessite une file d’exploration et des ressources supplémentaires ; plus le contenu et les liens dépendent de scripts, plus l’incertitude d’une lecture correcte augmente (voir [Bases du SEO JavaScript de Google](https://developers.google.com/search/docs/crawling-indexing/javascript/javascript-seo-basics)).
**Correction** : faire entrer le contenu clé dans le HTML initial — rendu côté serveur, génération statique, ou au minimum sortir le titre, le corps du texte et les liens internes sous forme de vraies balises. Le critère est simple : désactivez JavaScript dans le navigateur, la page doit rester lisible.
## Vérification 2 : Title et Meta Description sont-ils correctement renseignés ?

Les métadonnées sont ce qui manque le plus souvent dans les pages générées par IA, car elles sont totalement invisibles à l’écran. Trois erreurs fréquentes :
- **Un même Title sur tout le site** : les variables de template n’ont pas été remplacées, toutes les pages affichent « Accueil | Une entreprise technologique » ;
- **Une Description vide** : Google doit extraire lui-même le contenu, et le résumé obtenu est souvent sans intérêt ;
- **Un Title trop long** : un titre en chinois de plus d’environ 30 caractères est tronqué sur mobile et l’argument est coupé.
```html
Création d’un site d’entreprise : processus complet, du besoin à la mise en ligne | Nom de la marque
Méthode d’auto-contrôle : prélevez 5 pages clés (accueil, page produit, page tarifs, page études de cas, page blog), vérifiez que les Title sont tous différents et contiennent le mot-clé thématique de la page ; que la Description est une phrase complète, et non un empilement de mots-clés.
Vérification 3 : sitemap.xml et robots.txt sont-ils réellement utilisables ?
Ces deux fichiers sont les points d’entrée des robots dans le site, et aussi les deux fichiers les plus souvent négligés dans la création de sites par IA — parce qu’ils n’existent pas dans l’interface.
# https://www.example.com/robots.txt
User-agent: *
Disallow: /admin
Disallow: /preview
Disallow: /api
Allow: /

Sitemap: https://www.example.com/sitemap.xml
    https://www.example.com/pricing
    2026-03-01
Vérifiez trois choses : le domaine dans le sitemap doit être le domaine définitif, pas un domaine de prévisualisation ; les chemins bloqués par Disallow ne doivent pas apparaître dans le sitemap ; la ligne Sitemap: doit être une adresse absolue.
Il faut aussi comprendre les limites de robots.txt. Dans son guide d’indexation, Google rappelle que robots.txt contrôle l’exploration, mais ne constitue pas un moyen fiable d’empêcher l’indexation : une URL bloquée par robots.txt peut tout de même apparaître dans les résultats de recherche à cause de liens externes ; pour qu’une page n’entre pas dans l’index, il faut utiliser noindex (balise meta robots ou en-tête de réponse X-Robots-Tag). Google a également ajouté, dans une mise à jour de sa documentation d’octobre 2026, une section « n’indexer que le contenu destiné à la recherche », et recommande de définir par défaut comme non indexées les pages générées uniquement pour le partage, la collaboration ou la sortie d’outils, puis de surveiller les anomalies d’indexation via les rapports « Indexation des pages » et « Performances de recherche » de Search Console (voir Analyse de la mise à jour du guide d’indexation de Google).
Vérification 4 : le canonical pointe-t-il bien vers cette page ?
rel=canonical indique aux moteurs de recherche « parmi ce groupe d’URL similaires, laquelle est la version principale ». Trois erreurs fréquentes avec l’IA :
- Toutes les pages pointent vers l’accueil, ce qui revient à dire à Google que chaque page est une copie de l’accueil ;
- Le canonical pointe vers un domaine de prévisualisation ou de test, et la page définitive est considérée comme une copie ;
- Les adresses avec paramètres et les adresses propres se désignent mutuellement, ce qui fait s’affronter les signaux.
-
La bonne pratique : le canonical utilise une adresse absolue, https, et correspond exactement à l’URL finale que vous souhaitez voir indexée (avec ou sans barre oblique finale, la règle doit être identique sur tout le site) ; pour un site multilingue, chaque version linguistique pointe vers elle-même et utilise hreflang pour établir les correspondances, au lieu de se canonicaliser mutuellement vers la version anglaise.
Vérification 5 : les données structurées contiennent-elles des informations erronées ?

L’IA est très douée pour « compléter » les données structurées, et tout aussi douée pour inventer au passage : des notes inexistantes, des fourchettes de prix absentes, une année de création fictive. Tout cela enfreint l’exigence de base des données structurées — les données doivent correspondre au contenu visible sur la page.
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "name": "Nom de la marque",
  "url": "https://www.example.com/",
  "logo": "https://www.example.com/logo.png"
}
Le principe est plutôt moins que trop : n’écrivez que les champs visibles sur la page ; supprimez systématiquement les dates de création, notes et états de stock incertains ; avant publication, faites passer le tout dans un outil de test des données structurées pour vérifier l’absence d’erreurs d’analyse.
Vérification 6 : formulaires, fenêtres modales et interactions bloquent-ils les robots ?
Le formulaire lui-même n’empêche pas l’indexation ; le problème vient de ce qu’ils remplacent souvent le contenu principal : une page entière ne contient qu’un formulaire de collecte de prospects, le contenu est verrouillé derrière une connexion, une fenêtre modale plein écran s’affiche au premier écran pour demander l’accord aux cookies. Pour les robots, ces pages manquent de texte permettant de correspondre à l’intention de recherche.
De plus, les outils de création de sites par IA génèrent souvent un grand nombre de pages « jetables » — pages de confirmation après envoi de formulaire, pages de résultat de devis, liens de partage. Si ces pages sont indexées, elles diluent la qualité du site. Selon la recommandation de Google, il est plus prudent de les définir par défaut en noindex (Analyse du guide d’indexation) ; les véritables pages d’atterrissage destinées à la recherche doivent en revanche conserver un corps HTML complet et visible, sans dépendre d’un clic pour se déplier.
Creez un site vitrine et genere des leads en quelques minutes
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Vérification 7 : la prochaine modification de page par IA va-t-elle rétablir les réglages SEO ?
C’est le risque le plus sous-estimé de la création de sites par IA : les pages sont générées en continu, et les Title, canonical et règles robots corrigés manuellement aujourd’hui peuvent être écrasés demain par une régénération du type « modifie la palette de couleurs et optimise le texte au passage ».
La bonne approche est une contrainte de processus, pas la mémoire :
- centraliser les réglages liés au SEO dans le template ou la configuration globale, pour réduire la saisie manuelle page par page ;
- après chaque régénération, repasser la checklist, au minimum sur l’accueil, la page produit et la page tarifs ;
- surveiller la croissance anormale du nombre d’URL : les modifications de template ou la mise en ligne de nouvelles fonctionnalités produisent souvent des URL en masse ; Google recommande de surveiller en parallèle l’évolution du volume de contenu créé côté plateforme et du volume indexé (même source) ;
- fixer un « diff des réglages » avant mise en ligne : comparer Title, canonical, robots et sitemap avec la version publiée précédente.
Vérification 8 : pourquoi cela vaut-il la peine d’y consacrer des efforts ?
Le SEO technique n’est pas un sujet de niche. Selon les statistiques de Mordor Intelligence, le marché des services de SEO technique représentait 1,573 milliard de dollars en 2025, et devrait passer de 1,689 milliard de dollars en 2026 à 2,837 milliards de dollars en 2031, avec un taux de croissance annuel composé d’environ 10,93 % entre 2026 et 2031 ; la catégorie du SEO technique représentait 32,41 % en 2025, précisément parce que le rendu, la structure du site, les redirections, les données structurées et les performances des pages déterminent directement si le contenu peut être découvert et récupéré à grande échelle ; le rapport indique aussi que Google continue d’intégrer les Core Web Vitals dans l’évaluation de la recherche (données dans le rapport de marché Technical SEO Services). Autrement dit, la mise en ligne de la page n’est que le début : être exploré, compris et cité est le vrai ticket d’entrée à l’ère de la recherche et de la recherche par IA.
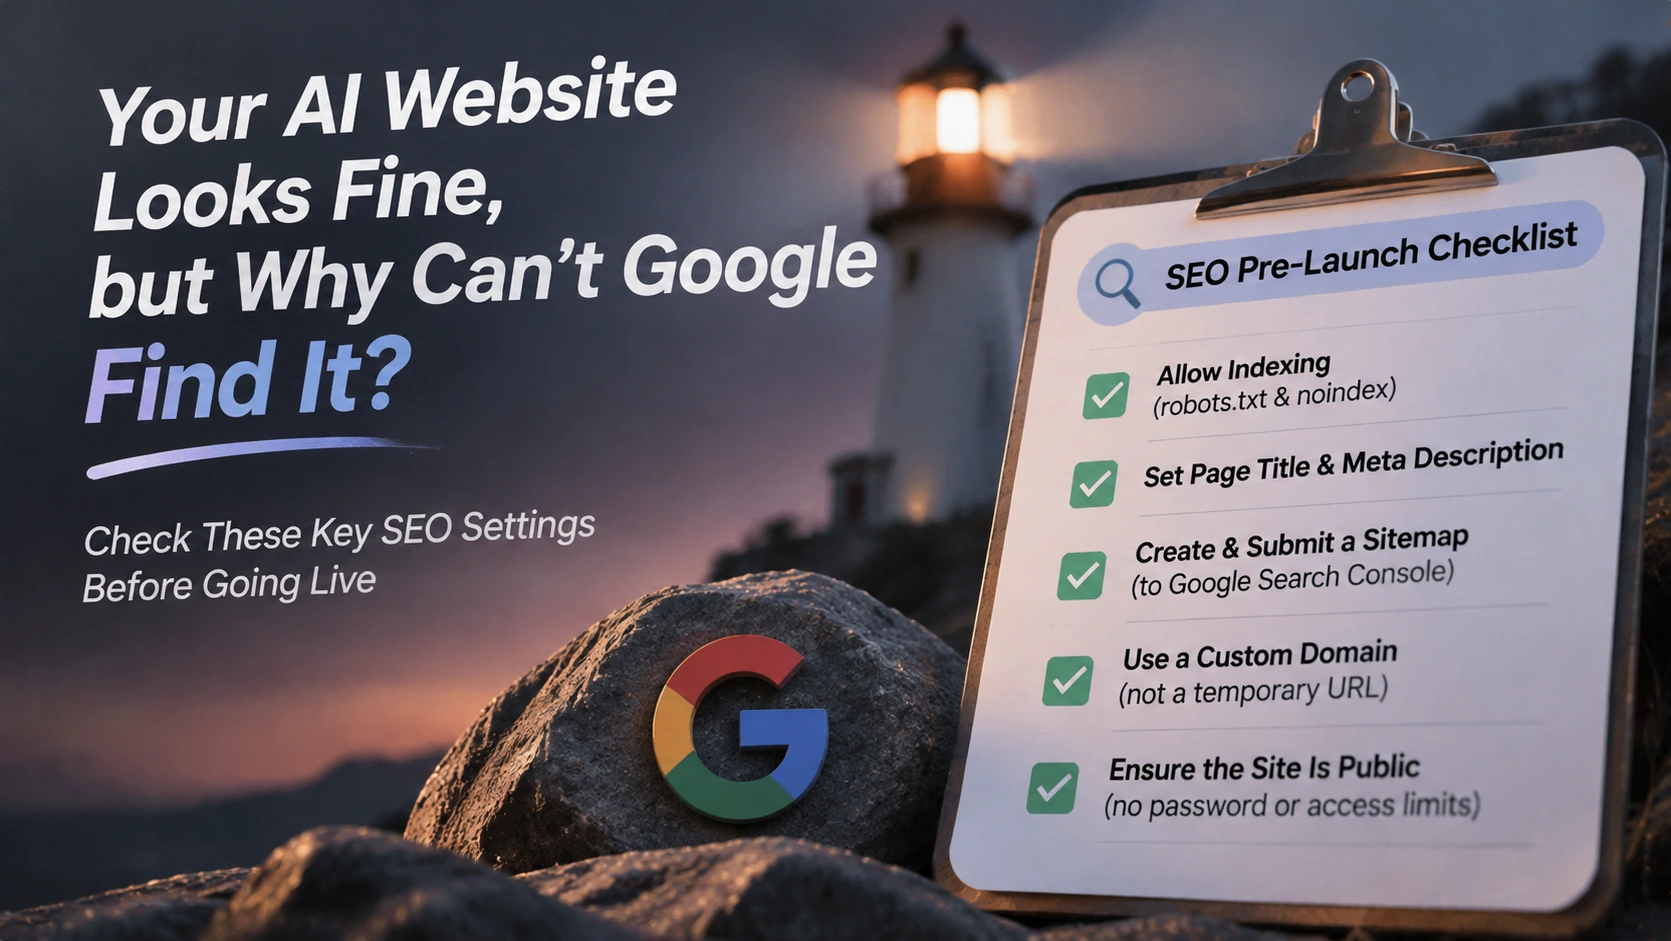
Checklist SEO en 10 points avant la mise en ligne d’un site créé par IA
| # | Point de contrôle | Critère de réussite |
|---|---|---|
| 1 | HTML initial | Après désactivation de JS, le titre et le corps restent visibles |
| 2 | Statut HTTP | Les pages clés renvoient 200, les anciennes adresses redirigent en 301 vers les nouvelles |
| 3 | Title | Unique par page, contient le mot-clé thématique, longueur maîtrisée |
| 4 | Meta Description | Indépendante par page, phrase complète |
| 5 | robots.txt | Ne bloque que les chemins d’administration et de prévisualisation, Sitemap en adresse absolue |
| 6 | sitemap.xml | Contient uniquement le domaine définitif et les pages indexables |
| 7 | canonical | Pointe vers sa propre URL définitive, règle de barre oblique uniforme sur tout le site |
| 8 | noindex | Site de prévisualisation, pages de résultat et pages de partage non indexés par défaut |
| 9 | Données structurées | Uniquement les champs visibles sur la page, aucune erreur d’analyse |
| 10 | Interactions et formulaires | Le contenu principal n’est pas accaparé par une modale, un mur de connexion ou un formulaire |
La valeur de ce tableau ne réside pas dans des « techniques avancées », mais dans sa répétabilité : le passer avant chaque publication permet, en dix minutes, d’écarter la plupart des cas « le site est prêt mais introuvable ».
Ce que les entreprises doivent faire maintenant
Si vous créez votre site avec des outils d’IA, vous pouvez changer l’ordre : générer d’abord la structure et le contenu, puis compléter les métadonnées et les règles d’indexation, et enfin effectuer une vérification unifiée avant publication. Des plateformes de création de sites par IA comme We0 intègrent déjà la génération de pages, le back-office CMS, le déploiement du domaine et la configuration SEO/GEO dans une même chaîne (voir site officiel de We0), et la rapidité de génération ne change pas une condition préalable : les moteurs de recherche ne reconnaissent que ce qui est réellement présent dans le HTML, donc les tests réels après mise en ligne restent indispensables.
Trois actions concrètes : d’abord utiliser curl pour inspecter le HTML initial, puis vérifier l’état d’exploration et d’indexation dans la console de recherche, et enfin intégrer les 10 points ci-dessus comme étape fixe avant publication, en les documentant dans le processus de mise en ligne de l’équipe.
FAQ
Q : Les sites générés par IA sont-ils naturellement non conformes aux exigences SEO ?
Non. La génération par IA n’est qu’un mode de production ; le problème est que le processus de génération se concentre par défaut sur « la page semble-t-elle correcte ? », sans vérifier « ce que le moteur de recherche lit réellement ». Tant que le HTML initial contient le corps du texte et que les métadonnées et règles d’indexation sont correctes, il n’y a pas de différence essentielle de performance en recherche entre un site créé par IA et un site créé manuellement.
Q : Une page introuvable dans Google a-t-elle été pénalisée ?
Dans la plupart des cas, on n’en est pas encore à la « pénalité », mais la page n’a pas encore été explorée ou indexée. Vérifiez d’abord le statut d’indexation, puis si elle est bloquée par robots.txt ou noindex, et seulement ensuite la qualité du contenu et le niveau de concurrence.
Q : La simple soumission d’un sitemap garantit-elle l’indexation ?
Non. Le sitemap est un indice de découverte, pas une promesse d’indexation ; il permet aux robots de savoir plus vite quelles pages vous avez, mais l’indexation d’une page dépend de l’accès à l’exploration, de la qualité du contenu et des règles d’indexation.
Q : Google ne peut-il jamais lire une page rendue en JavaScript ?
Pas nécessairement, mais l’incertitude est plus élevée. Le rendu nécessite des ressources supplémentaires, et plus une page dépend de scripts, plus la probabilité que le texte et les liens du premier écran soient correctement lus est faible. Placer le contenu essentiel dans le HTML initial est l’assurance la moins coûteuse.
Q : Combien de temps faut-il pour voir des résultats ?
Il n’existe pas de calendrier uniforme pour l’indexation et le classement ; cela dépend de la fréquence d’exploration, de la taille du site et de la concurrence. Ce qui est certain, c’est qu’une erreur de réglage reste active jusqu’à ce que vous la découvriez et la corrigiez.
Outils associés
- Google Search Console : consulter le rapport d’indexation des pages et les performances de recherche
- Documentation Google sur le SEO JavaScript : confirmer les règles réelles de rendu et d’exploration
curl/ outils de développement du navigateur : vérifier le HTML initial et la lisibilité après désactivation de JS- Outil de test des données structurées : valider la capacité d’analyse du JSON-LD
Liens associés
- Bases du SEO JavaScript de Google
- Analyse de la mise à jour du guide d’indexation de Google : pages partageables et contenu généré
- Rapport sur la taille et les tendances du marché Technical SEO Services
- Site officiel de We0
Résumé
La création de sites par IA accélère la mise en ligne, mais ne change pas le fonctionnement des moteurs de recherche : ils lisent le HTML, les en-têtes de réponse et la structure des liens, pas la maquette que vous voyez à l’écran. Avant la mise en ligne, vérifiez les sept points que sont le HTML initial, Title et Description, robots.txt et sitemap, canonical, noindex, données structurées, formulaires et interactions, puis transformez-les en processus : vous ferez passer « le site est prêt mais il n’y a pas de trafic » du statut de normalité à celui de problème diagnosticable.