For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/anthropic-s-2021-roadmap-coding-agents-to-438c8006.md.
Une courte feuille de route de recherche d’Anthropic datant de juillet 2021 décrit un assistant capable de converser avec des personnes tout...
Une courte feuille de route de recherche d’Anthropic datant de juillet 2021 décrit un assistant capable de converser avec des personnes tout en créant, modifiant et expliquant des logiciels. Relue aujourd’hui, elle fait ressortir des questions qui façonnent encore les agents de codage : comment explorer un dépôt, utiliser des outils, apprendre des retours et agir de manière sûre dans un environnement réel.
Le scan accessible publiquement est intéressant pour ces rapprochements, et non parce qu’il prouverait qu’une version finalisée de Claude Code existait cinq ans plus tôt. Il consigne des objectifs de recherche et des désaccords. Il s’agit d’un type de preuve différent d’un produit commercialisé, d’une expérience achevée ou d’une déclaration sur l’architecture des modèles actuels.
L’objectif à long terme du document est une AGI sûre et bénéfique. Sa preuve de concept proposée est un assistant généraliste capable de travailler avec un utilisateur sur des logiciels en langage naturel.
Les tâches décrites vont au-delà de la complétion des quelques caractères suivants de code. Elles comprennent la réponse à des questions, l’écriture de fonctions, la localisation de bugs, la conception d’API et la discussion du style et des bonnes pratiques. L’état final ambitieux est l’étendue de compétences d’un collègue en ingénierie logicielle.
La formulation reconnaît aussi que l’équipe ne s’attendait pas à atteindre immédiatement cet objectif. Elle présente une direction de recherche ; c’est pourquoi le document ne devrait pas être décrit rétrospectivement comme un plan de lancement de Claude Code en 2021, dont toutes les fonctionnalités actuelles auraient déjà été arrêtées.
La documentation actuelle de Claude Code permet de comparer cette ambition générale à un produit réel. La continuité thématique est claire ; le document seul n’établit pas un historique d’implémentation ininterrompu pour chaque fonctionnalité.
Les commentaires révèlent une tension pratique entre la création immédiate de quelque chose d’utile et la démonstration d’une capacité plus générale.
Tom Brown suggère que la navigation dans les dépôts constitue un point de départ précieux. Nelson Elhage donne un exemple concret : trouver des définitions de types dans un projet. Il s’agit de besoins ordinaires pour les développeurs, notamment lorsqu’ils découvrent une base de code inconnue.
Andy Jones oppose cette approche à une démonstration mettant l’accent sur le débogage avec printf et l’utilisation d’un éditeur. La recherche dans un dépôt peut être une excellente première fonctionnalité pour l’assistant d’un programmeur, tandis que ces autres actions pourraient fournir une démonstration plus convaincante de la capacité d’un modèle à utiliser des outils.
La réponse de Dario Amodei privilégie à court terme la démonstration d’utilisation d’outils et, à long terme, le programmeur très performant. Cet échange est utile parce qu’il montre que le séquencement constituait un choix explicite. Une première étape de recherche peut être précieuse même si elle n’est pas encore le produit complet le plus utile.
La section sur le préentraînement appelle à développer de solides modèles de langage et de code, des jeux de données orientés code et des évaluations reliant les capacités au réglage fin ultérieur. Elle évoque également la science de l’entraînement de modèles arbitrairement grands, y compris de 1 T de paramètres et plus.
Il s’agit d’un objectif de recherche exprimé. Ce n’est ni la révélation qu’un modèle Claude actuel possède un trillion de paramètres, ni une preuve que l’équipe avait déjà entraîné un tel modèle en 2021.
La même section envisage des contextes très vastes ou un moyen équivalent d’incorporer une mémoire et une expérience substantielles. Cela laisse ouvertes plusieurs méthodes possibles, plutôt que de prescrire une conception précise de fenêtre de contexte actuelle.
| Élément de la feuille de route | Ce qu’il étaye | Ce qu’il n’établit pas |
|---|---|---|
| Un assistant logiciel généraliste | La collaboration autour des logiciels était un objectif de recherche précoce. | Une version finalisée de Claude Code en 2021. |
| Des modèles de 1 T de paramètres et plus | Une très grande échelle faisait partie du programme de recherche. | Le nombre de paramètres d’une version actuelle de Claude. |
| De grands contextes ou une mémoire équivalente | L’équipe envisageait une expérience étendue et de la mémoire. | Une architecture fixe ou la limite exacte de jetons d’aujourd’hui. |
| L’utilisation d’outils via la recherche, le débogage et l’édition | Le programme incluait l’action dans des environnements logiciels. | Un fonctionnement autonome fiable et sans restriction. |
La section consacrée aux retours humains et à l’alignement inclut l’étude de la correspondance entre les jugements des modèles et les jugements humains concernant le comportement et la qualité des échantillons. Elle mentionne explicitement l’auto-évaluation et relie cette question aux biais, à l’équité et aux conséquences sociales.
Il s’agit d’une première formulation significative consistant à considérer les évaluations propres à un modèle comme un objet de recherche. Cela ne démontre pas que ces jugements sont automatiquement fiables, ni qu’un modèle peut certifier sa propre sortie de manière sûre.
Le document évoque également le calcul au moment de l’inférence dans une discussion sur l’entraînement de GAN ou de discriminateurs et sur les lois de mise à l’échelle. Cela montre que l’équipe réfléchissait à l’utilisation du calcul au-delà du préentraînement. Il ne faut pas l’assimiler sans nuance à toutes les techniques ultérieures de modèles de raisonnement, ni le considérer comme la preuve qu’un système moderne de mise à l’échelle à l’inférence était déjà spécifié.
Cette distinction renforce la comparaison historique. Le document révèle des questions de recherche connexes sans obliger le lecteur à prétendre qu’un vocabulaire similaire implique des méthodes identiques sur cinq ans.
L’un des commentaires les plus directement pertinents demande comment déployer des outils non isolés dans un bac à sable de manière sûre. Amodei précise la préoccupation particulière : les outils qui exécutent du code au moment du déploiement.
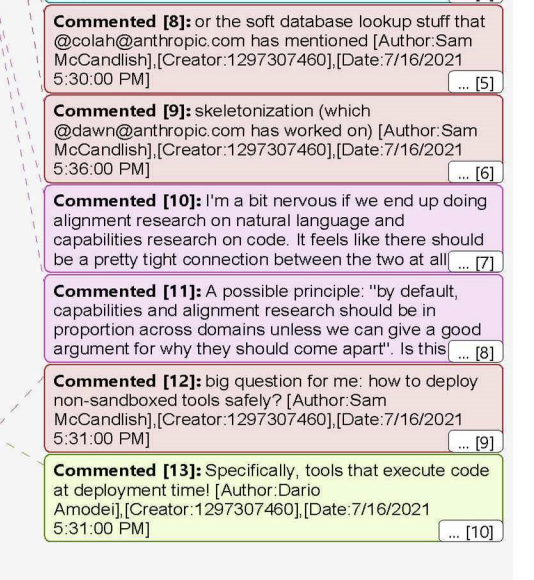
Source : le scan de la feuille de route de juillet 2021, extrait par QbitAI sur BAAI Hub. Les commentaires correspondants sont visibles dans le PDF lié, y compris dans ses pages de commentaires développés.
Cette préoccupation reste compréhensible dans un contexte d’agent. Un système capable d’exécuter des commandes ou de modifier des fichiers peut transformer son environnement ; son comportement sûr ne peut donc pas être évalué uniquement à partir de la politesse ou de la plausibilité de sa réponse finale.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
La documentation actuelle sur le bac à sable de Claude Code décrit des restrictions de système de fichiers et de réseau pour l’outil Bash isolé, ainsi que les limites de la protection qu’il fournit. Il s’agit d’une référence d’implémentation actuelle, et non d’une preuve que chacun de ces mécanismes était déjà défini dans la feuille de route.
Le commentaire historique identifie clairement le problème : l’accès à un outil utile crée également une frontière qui doit être conçue, testée et maintenue.
Amanda Askell soulève une préoccupation différente dans les commentaires. Si les capacités progressent principalement dans le code tandis que les expériences d’alignement restent concentrées sur le langage naturel, les tests d’alignement risquent de devenir moins utiles pour les capacités réellement développées.
Elle propose de maintenir une proportion entre la recherche sur les capacités et celle sur l’alignement dans les différents domaines, sauf raison valable de les séparer. Le point est opérationnel : évaluer une interaction facile à étudier peut laisser un angle mort si le système déployé agit de plus en plus dans un autre type d’environnement.
La section de la feuille de route consacrée à l’impact sociétal inclut également l’évaluation des modèles, l’aide à l’évaluation des systèmes par des tiers et l’élargissement du nombre de chercheurs externes capables d’expérimenter avec eux. Il s’agit d’objectifs de recherche, plutôt que d’une garantie que les programmes d’accès ou évaluations ultérieurs satisfont chacun des principes proposés.
Pris ensemble, ces éléments rendent la discussion sur la sécurité plus précise qu’une simple déclaration de mission. Ils relient les retours durant l’entraînement, le domaine d’évaluation, les outils exécutables et l’évaluation externe.
Le document étaye une conclusion historique limitée mais utile : plusieurs thèmes associés aux agents de codage modernes étaient déjà reliés dans la planification initiale de recherche d’Anthropic. L’assistance logicielle, l’utilisation d’outils, les retours, l’échelle, la mémoire et la sécurité apparaissent dans le même programme.
Il ne prouve pas que la feuille de route a causé chaque succès ultérieur, que le produit final était inévitable, ni que d’autres laboratoires ne disposaient pas d’idées similaires. Ces affirmations exigeraient des preuves historiques et des comparaisons supplémentaires, au-delà de ce seul document.
Pour un développeur, les questions les plus utiles restent concrètes. Quelles parties d’une tâche le modèle peut-il accomplir ? Quels outils peut-il utiliser ? Comment les erreurs sont-elles détectées ? Et qu’est-ce qui empêche une action incorrecte d’affecter un environnement plus large ? La feuille de route est précieuse notamment parce que ces questions restent reconnaissables.
Il s’agit du scan accessible publiquement intitulé Concise Research Roadmap, attribué à Jared Kaplan et marqué comme mis à jour pour la dernière fois en juillet 2021. La copie de six pages comprend le texte de recherche et des commentaires développés, mais son origine liée à une divulgation judiciaire n’a pas été authentifiée indépendamment ici.
Non. Elle décrit une orientation de recherche vers un assistant logiciel généraliste. Un objectif ressemblant à un produit ultérieur diffère d’une preuve que ce produit avait déjà été construit ou commercialisé.
Non. Sa référence aux modèles de 1 T de paramètres et plus constitue un objectif de recherche. Elle n’établit ni l’architecture ni le nombre de paramètres d’un modèle Claude actuel.
La feuille de route propose d’étudier la relation entre les jugements humains et ceux des modèles concernant le comportement et la qualité des sorties. Elle relie aussi ce sujet aux biais, à l’équité et aux conséquences sociales, plutôt que de supposer que les jugements du modèle suffisent à eux seuls.
L’expression apparaît dans le contexte de l’alignement, des discriminateurs et de la recherche sur la mise à l’échelle. Elle montre un intérêt pour le calcul au moment de l’évaluation, mais ne spécifie pas toutes les méthodes employées par les modèles de raisonnement ultérieurs.
Les outils exécutant du code peuvent apporter des modifications à un environnement réel ; évaluer uniquement la réponse finale ne couvre donc pas toute la surface de risque. Le cloisonnement en bac à sable, les contrôles d’autorisation et des tests adaptés au domaine traitent différents aspects de ce problème et nécessitent toujours une mise en œuvre attentive.
La feuille de route de juillet 2021 relie l’ambition d’un collègue logiciel à des recherches sur les outils, les grands modèles, la mémoire et les retours. Ses commentaires identifient également des problèmes de sécurité liés aux outils exécutables et aux tests d’alignement qui prennent du retard sur le développement des capacités.
Elle documente un programme de recherche précoce aux thèmes modernes reconnaissables, et non un produit finalisé en 2021 ni une spécification des modèles Claude actuels.
Partez d’une phrase et obtenez un site complet en quelques minutes.
