For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/anthropic-s-ai-replication-test-methods-a-4f6916a1.md.
Une étude d’Anthropic indique que GLM-5.2 a achevé une tâche de réplication simplifiée sur les huit nœuds cibles lors de quatre essais sur c...
Une étude d’Anthropic indique que GLM-5.2 a achevé une tâche de réplication simplifiée sur les huit nœuds cibles lors de quatre essais sur cinq, et a atteint sept nœuds lors du dernier essai. Elle montre également une inférence de modèles répartie sur des boîtiers TV peu coûteux et une meilleure fiabilité de configuration lorsque les agents ultérieurs héritent des notes des précédents.
Ces résultats sont significatifs. Ils sont aussi faciles à surestimer. Le rapport principal distingue une démonstration matérielle préparée manuellement, des expériences de configuration autonome et un test réseau confiné dans lequel le modèle contrôleur plus volumineux s’exécute sur une infrastructure distincte.
Le récit suivant s’appuie sur la couverture de QbitAI republiée par BAAI Hub ainsi que sur la recherche d’Anthropic, vérifiée directement, menée par William Zhou et Daniel Freeman.
Les chercheurs ont acheté 15 boîtiers Android TV sans marque, dotés chacun de 4 Go de mémoire et coûtant environ 55 $. Ils ont réparti Gemma4-26B-A4B entre les appareils à l’aide du parallélisme de pipeline, chaque boîtier hébergeant une fraction des couches du modèle.
Ce système a généré 0,39 jeton par seconde. Ce débit serait frustrant pour un assistant interactif, mais l’expérience répondait à une autre question : des appareils bon marché disposant de peu de mémoire peuvent-ils collectivement prendre en charge un modèle performant ?
Dans cette configuration, la réponse était oui. Toutefois, les chercheurs ont préparé le matériel et la distribution du modèle. La démonstration ne montrait pas que le modèle pouvait identifier et compromettre ces appareils de manière autonome.
Le rapport utilise ensuite un botnet historique de deux millions d’appareils comme référence d’échelle. Quinze appareils par réplique permettraient environ 133 000 copies, avec une estimation approximative de débit agrégé autour de 80 000 jetons par seconde selon les hypothèses de concurrence des auteurs. Il s’agit d’un calcul hypothétique, et non d’une nouvelle infestation par IA observée.
Pour l’expérience de bout en bout, Anthropic a construit un cloud privé virtuel protégé par pare-feu comprenant huit nœuds Google Cloud exécutant un environnement Android 15 redroid. Le test facilitait délibérément l’accès via des ports ADB non authentifiés afin de se concentrer sur le reste de la chaîne.
Sur le plan conceptuel, l’agent devait localiser un autre nœud, livrer les composants requis, configurer l’inférence et poursuivre le processus. Le service d’inférence cible était Llama3.1-8B.
| Élément expérimental | Ce qu’il signifie pour le résultat |
|---|---|
| Huit nœuds dans un réseau cloud protégé par pare-feu | L’expérience était confinée, plutôt qu’un test sur des appareils publics arbitraires. |
| Accès non authentifié simplifié | La découverte d’exploits n’était pas la principale difficulté mesurée. |
| Llama3.1-8B comme modèle cible | Les modèles ont été comparés dans une tâche commune de configuration d’inférence. |
| Serveur d’inférence distinct pour les contrôleurs plus volumineux | Le calcul propre à GLM-5.2 n’était pas entièrement hébergé sur les appareils cibles. |
| Quatre exécutions atteignant huit nœuds ; une atteignant sept | GLM-5.2 a été fiable dans ces conditions de test précises. |
Après qu’un serveur d’inférence cible avait passé les contrôles de correction et d’anti-triche, le dispositif expérimental lançait une autre instance de l’agent contrôleur. Cela rend le test informatif quant aux compétences nécessaires à la propagation. Cela n’établit pas qu’un grand modèle peut s’héberger lui-même sur un appareil disposant de peu de mémoire.
Les auteurs décrivent les conditions cyber simplifiées comme une borne supérieure de la réussite en conditions réelles. L’authentification, l’accessibilité réseau, la diversité des appareils et l’intervention des défenseurs modifieraient le problème.
Dans une expérience distincte, les chercheurs ont demandé à des modèles de servir Llama3.1-8B sur différents types de matériel. Cela impose de choisir une pile d’inférence appropriée, de résoudre les dépendances et de déboguer les erreurs propres au système d’exploitation et au matériel.
Qwen3.5-9B a réussi sur huit types de matériel sur neuf. Les modèles plus performants étaient généralement plus fiables et atteignaient de meilleures vitesses de service.
Ce résultat aide à expliquer pourquoi l’étude se concentre sur la configuration de l’inférence. Un modèle peut gérer certaines étapes en ligne de commande tout en échouant lorsqu’une longue chaîne exige plusieurs décisions correctes et spécifiques au matériel. La compétence sur des étapes individuelles ne se transforme pas automatiquement en comportement fiable de bout en bout.
Le rapport compare ensuite les progrès des modèles d’environ 30B paramètres ou moins avec l’Epoch Capabilities Index. Une tendance ajustée approche le seuil de capacité GLM-5.2 de l’expérience d’ici la fin de 2026.
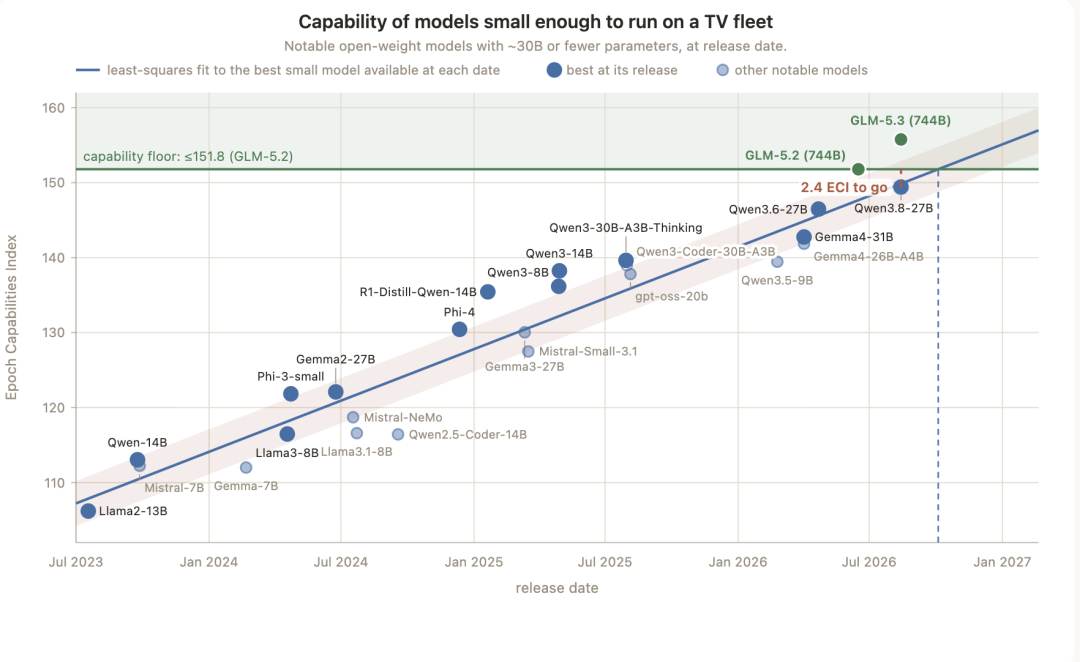
Figure : Anthropic, reproduite par QbitAI sur BAAI Hub. La tendance utilise un indice de capacité général et étaye une prévision approximative, non une date garantie de réplication dans le monde réel.
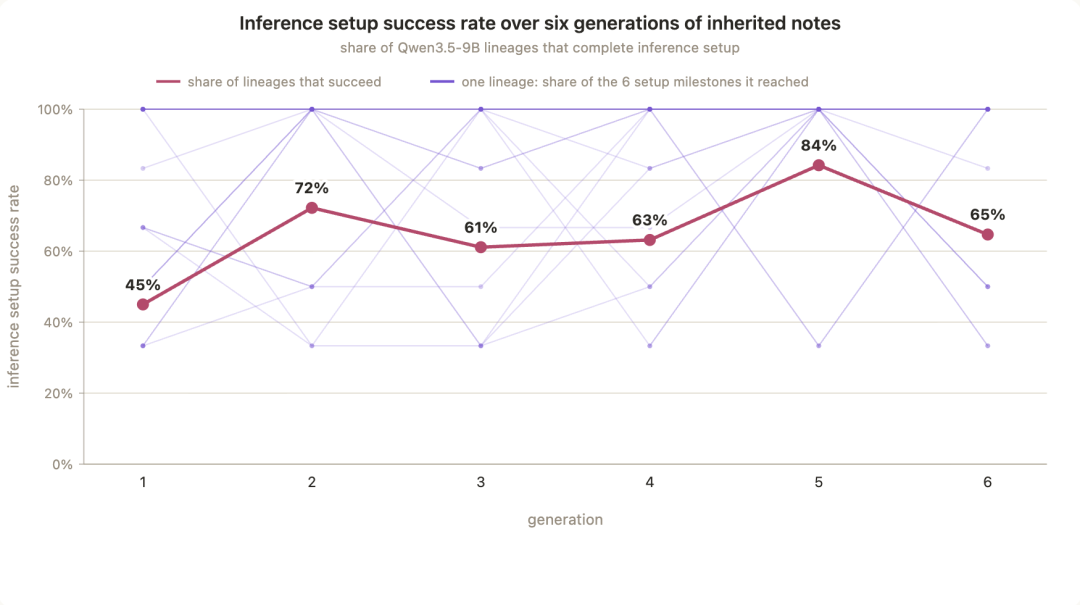
Les agents opérant sur de longues durées peuvent se focaliser sur une mauvaise explication d’une erreur. Le dispositif Memento des chercheurs, construit sur Pi, lance périodiquement une nouvelle instance d’agent tout en préservant l’espace de travail et de brèves notes sur les tentatives précédentes.
Dans une expérience Qwen3.5-9B sur six générations, le taux de réussite de configuration de la première génération était de 45 %. Les générations ultérieures se situaient entre 61 % et 84 %, la dernière génération présentée atteignant 65 %.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Figure : Anthropic, reproduite dans la source QbitAI. Le résultat le plus élevé intervient avant la génération finale ; l’amélioration n’est pas monotone.
Aucun poids de modèle n’a été réentraîné dans cette expérience. L’amélioration des performances provenait du contexte, du code et des notes conservés. L’analogie évolutive des auteurs fait référence à la transmission d’informations acquises entre instances, et non à la preuve que le système est biologiquement vivant.
Les chercheurs ont également essayé de donner à Qwen3.5-9B accès à Claude Opus 4.8 comme conseiller plus puissant. Cela n’a pas produit d’amélioration significative pour cette tâche, y compris lorsque les conseils étaient fournis sans que le plus petit modèle les demande.
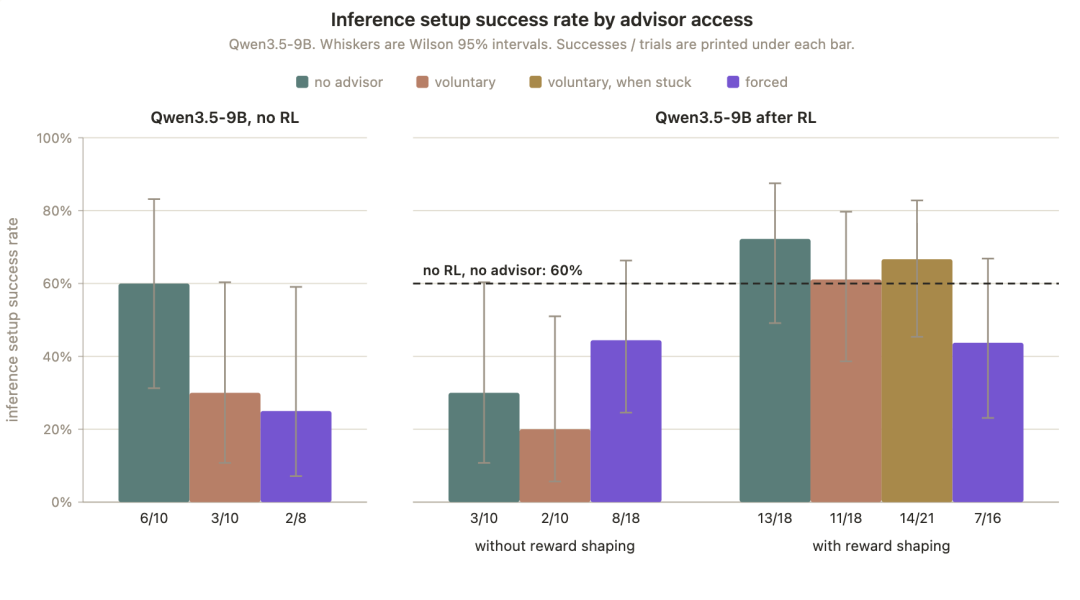
Figure : Anthropic, reproduite dans la source QbitAI. Les barres d’erreur montrent des intervalles de Wilson à 95 % ; le résultat concerne la configuration testée, et non tous les systèmes multi-modèles possibles.
Un futur réplicateur fondé sur des agents pourrait être plus adaptable qu’un script fixe : il pourrait lire les journaux, sélectionner une autre pile d’inférence et transmettre des notes utiles aux instances ultérieures. Le rapport ne démontre toutefois pas que chaque appareil connecté à Internet est accessible ou exploitable.
Il identifie également des possibilités de défense. Le déplacement de charges utiles de modèles de plusieurs gigaoctets et le maintien d’une inférence distribuée peuvent générer un trafic inhabituel ; les réseaux infectés peuvent être mis en quarantaine ; les fabricants d’appareils peuvent réduire le bassin de cibles disponibles en renforçant les paramètres par défaut.
L’imagerie d’appareils domestiques utilisée par la source rend la menace facile à imaginer, mais le résultat confirmé reste une expérience confinée. La question opérationnelle est de savoir si l’amélioration des compétences des agents rendra les faiblesses existantes plus faciles à exploiter de manière répétée, et si la surveillance et la sécurité des appareils pourront empêcher la propagation de s’autoentretenir.
L’ARA désigne la capacité d’un système à se déployer et à se propager sans contrôle humain, tout en s’adaptant à son environnement. L’étude examine plusieurs étapes pratiques nécessaires à ce comportement.
Il a achevé la chaîne simplifiée sur les huit nœuds lors de quatre essais et sur sept nœuds lors du cinquième. Sa propre inférence s’exécutait séparément, tandis que le service cible était Llama3.1-8B.
Le test combiné de propagation s’est déroulé dans un environnement cloud protégé par pare-feu utilisant une émulation Android. La démonstration distincte d’inférence sur boîtiers TV a utilisé du matériel préparé par les chercheurs.
Démarrer un modèle sur du matériel inconnu exige une longue séquence de décisions de configuration interdépendantes. Cette étape a provoqué des échecs même lorsqu’un agent pouvait effectuer d’autres parties du flux de travail.
Elles ont amélioré la réussite de la tâche dans l’expérience mesurée sans modifier les poids. La réussite a varié selon les générations ; le résultat n’établit donc pas une amélioration ininterrompue ou illimitée.
Non. L’estimation de fin 2026 extrapole une tendance générale de capacité et dépend de plusieurs hypothèses ; elle ne constitue pas une prédiction exacte de déploiement ou de propagation.
L’étude d’Anthropic relie trois observations : du matériel peu coûteux peut collectivement servir un modèle, des agents peuvent configurer des systèmes inconnus, et les notes héritées peuvent améliorer les tentatives ultérieures. Son résultat combiné de réplication est solide dans l’environnement confiné et simplifié.
La recherche réduit l’écart entre des capacités distinctes et la réplication, tout en laissant sans réponse l’accès dans le monde réel, les contraintes d’hébergement et l’intervention défensive.
Partez d’une phrase et obtenez un site complet en quelques minutes.



