For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/anysearch-for-ai-agents-structured-search.md.
La recherche est devenue l'une des capacités externes les plus importantes dont disposent les agents IA. Les modèles puissants excellent dan...

La recherche est devenue l'une des capacités externes les plus importantes à la disposition des agents IA. Les modèles puissants sont capables d'effectuer des raisonnements solides, mais ils ne peuvent pas récupérer des faits jamais consultés, distinguer les informations actuelles des rapports obsolètes sur la base de preuves, ni déduire de manière fiable des enregistrements d'entreprise manquants.
AnySearch aborde ce problème comme une infrastructure orientée agent, et non comme une page de recherche destinée à l'utilisateur. Au lieu de simplement renvoyer des liens, des titres et de courts extraits, il achemine les requêtes vers des sources web ou verticales pertinentes, élimine les doublons et le contenu de faible valeur, extrait les informations utiles et livre une réponse structurée pouvant entrer directement dans le contexte de raisonnement du modèle.
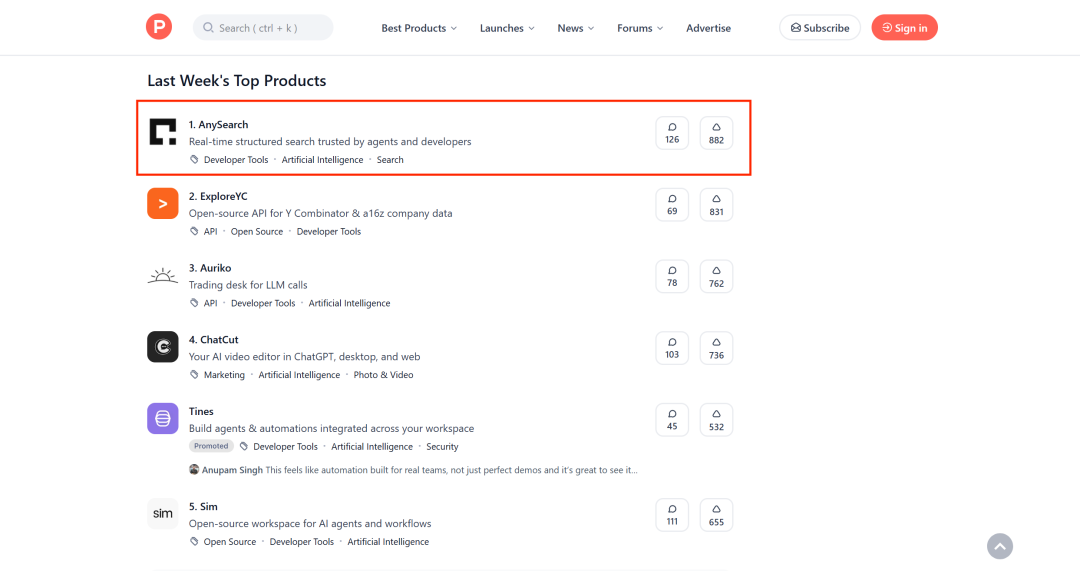
Ce produit a été classé premier sur Product Hunt le 6 juillet 2026 et pour la semaine correspondante. Sa présentation de lancement met l'accent sur la fourniture d'informations en temps réel, filtrées, dédupliquées et structurées via une API, un serveur MCP ou des compétences d'agent installables.
Cet article explique en quoi ce workflow de recherche orienté agent diffère des API de recherche traditionnelles, détaille les exemples présentés dans le rapport original et fournit des conseils pratiques d'installation et d'évaluation.
Note sur les benchmarks : Les données de précision et de latence ci-dessous proviennent des résultats de comparaison d'AnySearch reproduits à partir de l'article source. Les documents publics examinés pour cette version ne contiennent pas le code d'évaluation complet, les sorties brutes, les invites d'évaluation ou les analyses statistiques. Veuillez considérer ces données comme des résultats rapportés par le fournisseur, et non comme des benchmarks reproduits de manière indépendante.
Les humains peuvent parcourir une page de résultats, ignorer les publicités, identifier les articles en double et juger quels liens méritent l'attention.
Les agents, quant à eux, reçoivent souvent chaque résultat comme une entrée, ce qui entraîne des coûts multiples :
Le problème ne réside pas seulement dans la précision de la récupération, mais aussi dans la forme et la densité des informations renvoyées.
Par conséquent, un système de recherche pratique pour agent doit répondre à trois questions avant de transmettre les informations au modèle :
AnySearch est conçu autour de ces étapes.
AnySearch a été classé premier du jour et de la semaine sur Product Hunt le 6 juillet 2026. Product Hunt le décrit comme
Une recherche structurée en temps réel approuvée par les agents et les développeurs, qui récupère des informations filtrées et dédupliquées à partir de sources interrogées en parallèle.
L'article source présente également un système d'évaluation de 300 questions construit à partir de trois ensembles de référence :
Il indique qu'AnySearch, Brave Search et Parallel ont tous utilisé le même modèle de langage, de sorte que la couche de recherche (et non le choix du modèle) est la variable principale.
| Système de recherche | Précision globale | FreshQA | WebWalkerQA |
|---|---|---|---|
| AnySearch | 76.4 % | 80.0 % | 65.2 % |
| Brave Search | 64.0 % | 74.0 % | 46.8 % |
| Parallel | 72.2 % | 78.0 % | 61.0 % |
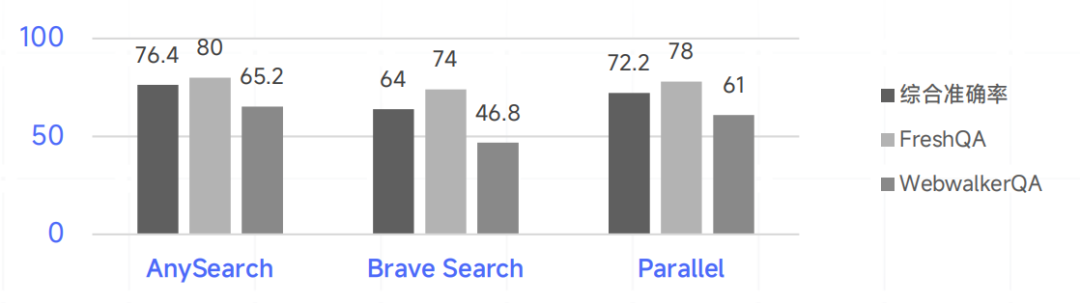
FreshQA évalue les questions qui dépendent d'informations actuelles ou changeantes. WebWalkerQA se concentre sur la navigation sur plusieurs pages et la localisation de preuves. Leur combinaison est très pertinente pour les agents qui ne se contentent pas d'une simple liste de liens superficiels.
FRAMES a été inclus dans l'évaluation globale de l'article source, mais le graphique présenté par l'article, ventilé par benchmark, n'affiche que FreshQA et WebWalkerQA en plus du score global.
Le graphique de latence montre qu'AnySearch a des valeurs plus faibles à la fois pour la comparaison moyenne et pour le sous-ensemble WebWalkerQA.
| Système de recherche | Valeur de latence moyenne | Valeur de latence WebWalkerQA |
|---|---|---|
| AnySearch | 48.0 | 76.5 |
| Brave Search | 68.9 | 133.0 |
| Parallel | 77.4 | 145.6 |
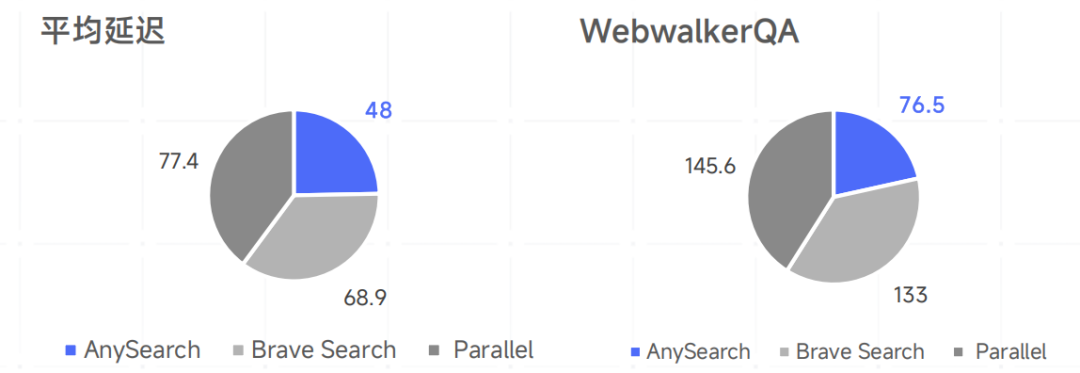
L'image source n'indique pas clairement d'unité, le tableau conserve donc intentionnellement les valeurs rapportées sans les convertir en secondes ou millisecondes.
AnySearch prend actuellement en charge trois principaux modes d'intégration :
Le projet GitHub officiel fournit une compétence et un serveur MCP sous licence Apache-2.0. Les deux prennent en charge la recherche web générale, la recherche verticale, la recherche par lots parallèle et l'extraction d'URL de page entière.
Cette image est liée au contenu présentant AnySearch dans le document. Elle fournit une représentation visuelle des fonctions et caractéristiques d'AnySearch, aidant les lecteurs à mieux comprendre les types de recherche pris en charge, entre autres informations.](https://we0-cms.oss-cn-beijing.aliyuncs.com/cms-assets/image/2026/07/80912d0a-73aa-4f80-bbab-eb6f0779cd63-e96fb0d4-000e-4288-ae1b-bf3c078c578f.png)
Le dépôt officiel recommande de télécharger une version figée (pinned release), plutôt que de récupérer directement des modifications non publiées depuis la branche principale.
Branche.
# Télécharger une version spécifique de la compétence AnySearch Skill.
# Consultez la page des versions ; remplacez v2.1.0 par une version stable plus récente le cas échéant.
curl -L -o anysearch-skill.zip \
  https://github.com/anysearch-ai/anysearch-skill/archive/refs/tags/v2.1.0.zip

# Décompresser la version.
unzip anysearch-skill.zip
Déplacez le répertoire décompressé vers l'emplacement approprié utilisé par votre agent :
# Claude Code
mv anysearch-skill-2.1.0 ~/.claude/skills/anysearch

# OpenCode
mv anysearch-skill-2.1.0 ~/.config/opencode/skills/anysearch

# Projet Cursor ou Windsurf
mv anysearch-skill-2.1.0 /.skills/anysearch

# Emplacement d'agent partagé
mv anysearch-skill-2.1.0 ~/.agents/skills/anysearch
Le répertoire exact dépend de la plateforme de l'agent et de ses règles actuelles de découverte des compétences.
La documentation officielle de la compétence et du MCP indique que l'accès anonyme a des limites de débit réduites. La clé API est facultative, mais recommandée pour une utilisation plus stable ou plus élevée.
Ne soumettez pas la clé API dans un dépôt public. Stockez-la dans une variable d'environnement, un gestionnaire de clés ou un fichier de configuration local ignoré.
Le premier test de l'article source demande à l'agent de trouver une implémentation réelle et professionnelle d'un limiteur de débit API en Go, et non un tutoriel d'introduction.
L'invite est la suivante :
Je construis un projet et j'ai besoin d'implémenter un limiteur de débit API en Go. Je n'ai pas besoin de tutoriel. Trouve-moi du code de niveau production provenant de véritables projets open source.
Sans workflow de recherche dédié, l'agent aurait, selon les rapports, renvoyé des liens courants et des extraits de code isolés. Ce résultat, bien qu'il puisse expliquer les concepts, est d'une utilité limitée lorsqu'un développeur a besoin du contexte complet de l'implémentation.
Une exécution assistée par AnySearch a renvoyé des résultats plus structurés et orientés code, avec des chaînes d'appel plus claires et du matériel provenant de bases de code réelles.
Cette distinction est cruciale, car le code de production ne se limite pas à un algorithme. Un résultat de recherche utile doit aider l'agent à examiner :
Une recherche de code qui extrait une belle fonction mais ignore ses hypothèses contextuelles pourrait induire en erreur l'agent d'implémentation.
Quel que soit le fournisseur de recherche, des requêtes plus explicites peuvent améliorer les résultats :
Trouver des projets Go open source maintenus qui implémentent un limiteur de débit API dans du code de production.

Exigences :
- Retourner le dépôt et les chemins de fichiers exacts.
- Privilégier le code utilisé dans un véritable serveur ou passerelle.
- Inclure le contexte d'initialisation et de flux de requêtes.
- Indiquer l'algorithme, le stockage backend, les tests et la licence.
- Exclure les bases de code tutoriel et les extraits de code copiés.
- Mentionner la date des commits récents pertinents.
Le système de recherche doit fournir des preuves. L'agent de codage doit toujours vérifier le dépôt, la licence, les tests, les hypothèses de sécurité et l'état de maintenance actuel avant d'adapter le code.
Deuxième test
Le même besoin de recherche d'entreprise a comparé AnySearch et Exa.
Les deux rapports ont bien performé sur les informations publiques de base de l'entreprise. Les différences résident principalement dans la partie risques.
Selon les rapports, AnySearch a trouvé des enregistrements de conformité publiés localement et des annonces de plateforme, absents du rapport généré par Exa. La source attribue cette différence à l'accès aux sources de données verticales chinoises, et non au modèle de langage lui-même.

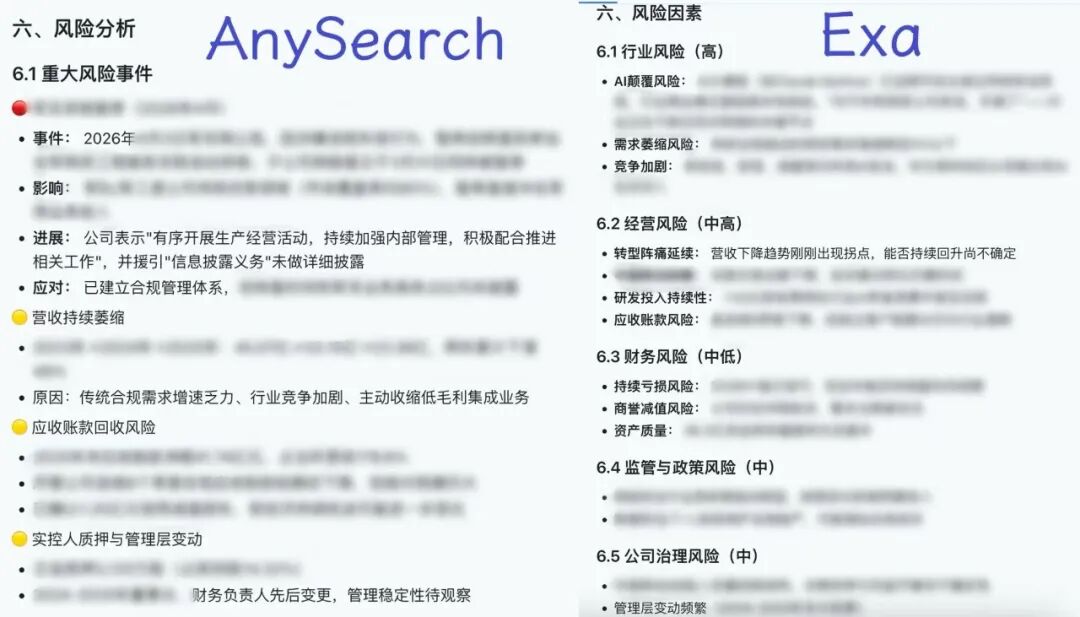
Cet exemple met en lumière une limitation courante de la recherche d'entreprise : un index web mondial peut bien couvrir le site officiel de l'organisation, les reportages internationaux et les bases de données en anglais, mais peut manquer les registres locaux de régulation, de justice, de plaintes ou de plateformes.
Un agent de due diligence devrait explicitement rechercher dans plusieurs catégories :
Remarque importante : La due diligence assistée par la recherche ne remplace pas un examen juridique, financier ou de conformité professionnel. Les enregistrements peuvent être incomplets, les noms peuvent prêter à confusion et les résumés automatiques peuvent mal interpréter les preuves.
Le troisième test a demandé à AnySearch de générer un rapport sur le marché mondial de l'énergie, couvrant :
Les résultats présentés par la source comprenaient des détails régionaux sur les stocks, une comparaison des prix européens de l'électricité et des données d'émission. Le rapport citait des informations récentes, notamment les données publiées par l'Agence américaine d'information sur l'énergie le 9 juillet et les prix day-ahead européens du 12 juillet.

Ce graphique est lié au troisième test du document, présentant les données des prix spot de l’électricité pour plusieurs pays européens, faisant partie du rapport sur le marché mondial de l’énergie généré par AnySearch.](https://we0-cms.oss-cn-beijing.aliyuncs.com/cms-assets/image/2026/07/3f5432f8-0641-4e6e-b8aa-62b6a50e7d18-f18fcac7-52c7-4efa-a066-9c9722c9cea9.jpeg)
Ceci est un exemple typique de requête multidomaine, qui exige que le système reconnaisse une demande contenant plusieurs chemins de données indépendants, et non une simple recherche web unique.
Une implémentation fiable doit :
Les données actuelles doivent toujours inclure un horodatage. Si le rapport ne précise pas le moment de la publication des mesures sous-jacentes et leur période de couverture, le terme « dernier » n’a aucun sens.
Le principe central de conception est qu’AnySearch reconstruit le pipeline de recherche autour du comportement des agents.
Le processus, tel que montré par le code source, comporte cinq phases :
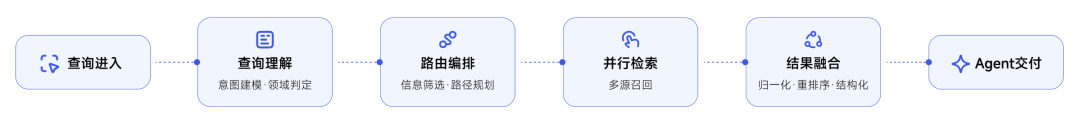
Le système identifie d’abord le type de preuves dont la requête a besoin.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Une requête sur une entreprise peut nécessiter des registres, des brevets, des bases de données juridiques et des plateformes de plaintes. Des questions liées au code doivent être acheminées vers des dépôts de code et de la documentation. Une requête sur le marché de l’énergie peut nécessiter des stocks officiels et des données sur les marchés de l’électricité.
Cela diffère considérablement du traitement de toutes les requêtes par le biais d’un index générique unique.
AnySearch indique qu’en plus de la recherche générique, il prend en charge plus de 20 catégories verticales, couvrant les domaines suivants :
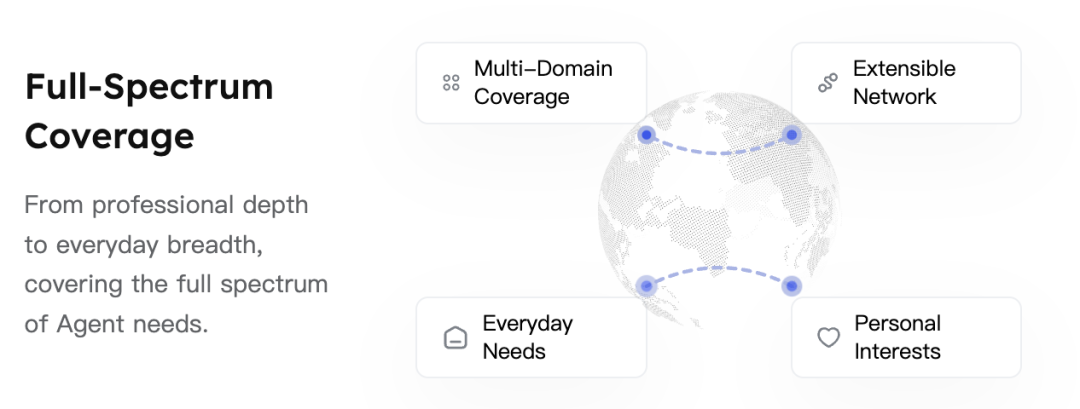
L’interface MCP publique comprend une méthode de catalogue de domaines. L’agent doit demander les domaines valides et les schémas de paramètres, plutôt que de créer lui-même des filtres non pris en charge.
Une question couvrant plusieurs domaines peut lancer plusieurs recherches indépendantes. Le serveur MCP prend en charge l’exécution par lots de 1 à 5 objets de recherche, et l’échec d’une branche ne bloque pas l’exécution des autres branches.
La recherche parallèle peut réduire le temps d’attente total, à condition que la couche d’agrégation empêche les résultats de faible qualité apparaissant rapidement de prendre le pas sur les résultats plus lents mais faisant autorité.
Preuves.
Le texte original propose trois idées de classement :
L’objectif attendu est de filtrer davantage le contenu avant qu’il n’entre dans le modèle de langage.
Cela diffère des pipelines qui renvoient un ensemble de résultats volumineux et laissent le modèle dédupliquer lui-même. Le préfiltrage peut économiser des tokens, mais introduit une autre responsabilité : le système de classement ne doit pas supprimer silencieusement des enregistrements minoritaires ou contradictoires essentiels.
Après le classement, AnySearch extrait le contenu principal, supprime le bruit de la page et convertit les résultats en format Markdown.
Le serveur MCP officiel propose également une opération d’extraction d’URL qui renvoie le contenu de la page en Markdown, avec une limite de troncature claire de 50 000 caractères.
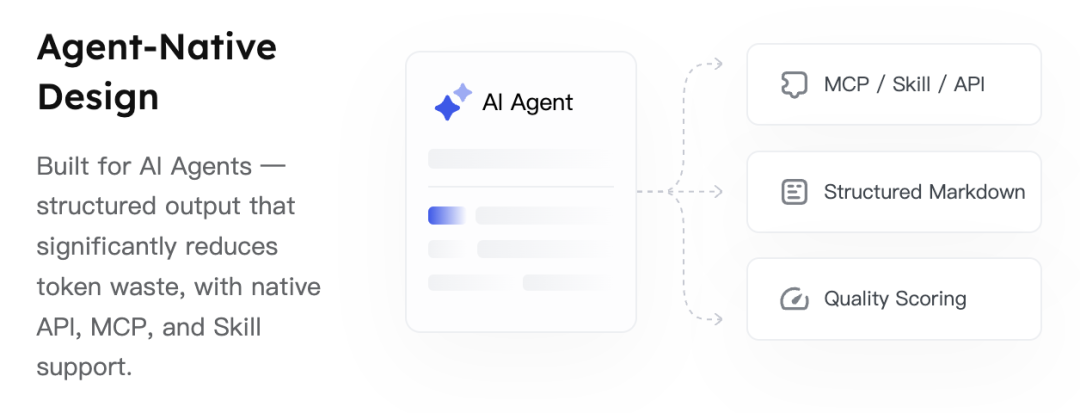
La sortie structurée peut réduire la charge de travail du modèle, surtout lorsque les résultats incluent :
Pourquoi la déduplication réduit le gaspillage de tokens
Supposons qu’un agent reçoive dix résultats concernant le même événement. Si sept d’entre eux sont des reformulations d’un même rapport original, le contexte contient des affirmations redondantes, et non sept confirmations indépendantes.
Cela entraîne trois problèmes :
La déduplication basée sur la source vise à conserver des preuves uniques, et non simplement à garder les pages les mieux classées.
Une réponse de recherche pratique pour un agent doit rendre les sources visibles. Les développeurs doivent savoir si cinq résultats représentent cinq sources originales, cinq republications d’une même source, ou un mélange de preuves principales et secondaires.
Le texte original décrit une consommation réduite de tokens comme un avantage d’AnySearch, mais n’annonce pas de pourcentage général de réduction des tokens.
C’est logique, car l’économie dépend de :
Une évaluation équitable doit mesurer l’ensemble de la tâche, pas seulement la réponse à la première recherche.
Les indicateurs utiles incluent :
| Indicateur | Ce qu’il mesure |
|---|---|
| Tokens d’entrée de recherche | Contexte consommé par les matériaux récupérés |
| Tokens totaux de l’agent | Recherche, raisonnement, actions suivantes, |
| Génération finale | |
| Nombre d’appels de recherche par cycle | Une faible récupération entraîne-t-elle des recherches répétées |
| Nombre de sources distinctes | Diversité des preuves après déduplication |
| Précision des citations | Les sources citées soutiennent-elles les affirmations concernées |
| Complétude de la réponse | La réponse couvre-t-elle les dimensions requises |
| Latence de bout en bout | Temps nécessaire pour que la tâche soit disponible |
| Taux de succès de la tâche | L’agent atteint-il l’objectif attendu |
Une réponse courte qui omet des preuves clés n’est pas une stratégie d’optimisation. La réduction du nombre de tokens n’a de valeur que si la qualité et la traçabilité de la réponse sont maintenues.
Les composants de recherche utilisés dans les environnements de production réels doivent gérer des problèmes de défaillance rarement rencontrés dans les démonstrations produit.
La ressource source met en avant les caractéristiques suivantes :
La documentation publique MCP prend également en charge les fonctionnalités suivantes :
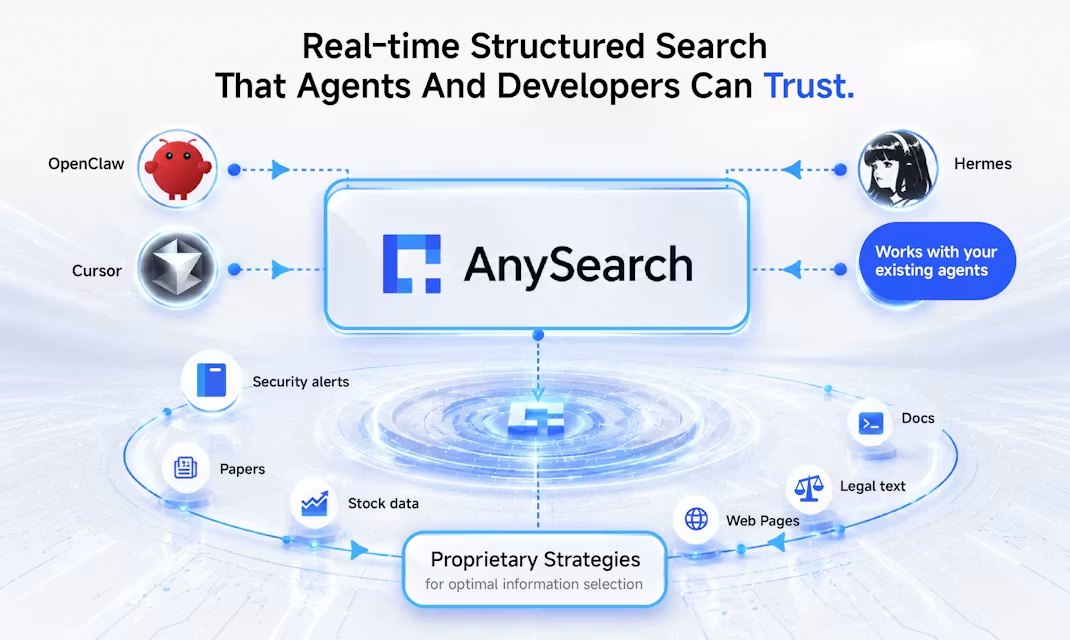
Les équipes de production doivent encore ajouter leurs propres contrôles :
La sortie de recherche est une entrée externe non fiable. Même le texte Markdown nettoyé peut contenir des instructions malveillantes, des déclarations fausses ou des contenus compromis.
La recherche traditionnelle aide les utilisateurs à localiser des pages. La recherche pour agents a un objectif différent : fournir des preuves exploitables par machine pour le raisonnement et l’exécution.
Cela modifie les priorités de conception.
| Recherche pour humains | Recherche pour agents |
|---|---|
| Optimisée pour un survol rapide | Optimisée pour l’ingestion machine |
| Liens et résumés | Preuves structurées |
| Déduplication par l’utilisateur | Le système doit réduire les contenus répétés |
| L’utilisateur vérifie les dates d’expiration | Les dates doivent être clairement indiquées |
| L’utilisateur décide à qui faire confiance | Signaux de source et de qualité nécessaires |
| La navigation peut être exploratoire | Les recherches répétées consomment du temps et des tokens |
| La disposition visuelle est importante | L’architecture stable et le Markdown sont importants |
Le modèle détermine la capacité de l’agent à raisonner à partir des preuves. La couche de recherche détermine quelles preuves sont initialement disponibles.
À mesure que les capacités des modèles augmentent, l’importance de la qualité de la récupération ne fait que croître. Les modèles puissants peuvent générer des réponses très convaincantes même à partir d’un contexte faible. Cela fait de la sélection des sources, de l’actualité et de la traçabilité une partie du système de sécurité et de fiabilité des agents.
Les développeurs ne devraient pas choisir un fournisseur de recherche uniquement sur la base d’un benchmark public ou d’une démonstration impressionnante.
Ils devraient plutôt construire un ensemble d’évaluation basé sur des scénarios réels.
Les tâches que votre agent exécute.
Couvrir des cas simples et difficiles :
Utiliser le même modèle, les mêmes invites, la même stratégie d’outils et le même schéma de sortie pour chaque fournisseur.
Stocker les sources renvoyées avant que le modèle ne les résume. Sinon, vous ne pouvez pas déterminer si l’erreur provient du processus de récupération ou de raisonnement.
Mesurer la latence, le nombre total de tokens, le nombre d’appels de recherche répétés, la couverture, le support des citations, l’actualité et le taux d’échec.
Les tâches financières, juridiques, de sécurité, médicales et de conformité nécessitent une validation par des experts. Les API de recherche peuvent améliorer la collecte de preuves, mais ne peuvent assumer la responsabilité professionnelle.
Désactivez une source, ralentissez une route, retournez un contenu au format erroné, injectez des résultats en double. La fiabilité en production dépend des performances du système lorsque la récupération est imparfaite.
AnySearch est un service d'infrastructure de recherche en temps réel conçu pour les agents IA et les développeurs. Il propose une recherche web, une recherche par domaine vertical, une recherche par lots et une extraction de texte intégral avec sortie structurée.
Il dispose d'un site web permettant aux utilisateurs d'essayer la recherche, mais son positionnement principal est celui d'une infrastructure pour agents. Les modes d'intégration principaux incluent l'API, le MCP et une Skill installable.
La documentation officielle de la Skill et du MCP indique que l'accès anonyme est soumis à des limites de débit et des quotas plus faibles. La clé API est facultative, mais recommandée pour une utilisation plus régulière.
La documentation publique mentionne la finance, la recherche académique, la sécurité, les informations juridiques, le code, ainsi que d'autres catégories. Les agents doivent consulter le répertoire des domaines pris en charge avant d'utiliser un paramètre de domaine spécifique.
Il tente de router les requêtes avant la récupération, de réduire les sources en double, de privilégier les résultats à haute densité d'information, de supprimer le bruit des pages et de retourner un format Markdown structuré. Les économies réelles de tokens dépendent du contenu de la requête et du flux de travail plus large de l'agent.
Ce score a été rapporté par AnySearch et reproduit dans l'article original. Aucun ensemble d'évaluation publique complet n'a été trouvé lors de la vérification, ce résultat doit donc être considéré comme une donnée comparative rapportée par le fournisseur.
Non. Il peut aider à collecter des informations sur les entreprises, juridiques, financières et les risques publics, mais les professionnels doivent vérifier l'identité, l'autorité de la source, l'exhaustivité, la juridiction et l'interprétation.
Les bases de code de la Skill AnySearch et du serveur MCP sont publiées sous licence Apache-2.0. Le backend de l'API hébergée est un service distinct, non couvert par la licence de ces bases de code.
AnySearch considère la recherche comme une couche d'entrée pour les agents, et non comme une liste de pages à parcourir pour les humains. Il achemine les requêtes à travers des sources générales et verticales, recherche sur plusieurs chemins, trie et déduplique les preuves, supprime le bruit des pages et retourne un contenu structuré via une API, un MCP ou une intégration Skill.
Les exemples dans le code source montrent pourquoi cette conception est cruciale pour la découverte de code en production, la due diligence locale d'entreprise et les données multi-marchés actuelles. Dans chaque cas, l'agent a besoin de preuves complètes, opportunes et traçables – et pas seulement de liens pertinents.
Son classement Product Hunt et les résultats de benchmark rapportés par le fournisseur font d'AnySearch un outil à tester, mais les équipes devraient reproduire les comparaisons avec leurs propres requêtes, modèles, comptabilité de tokens et critères de qualité avant de remplacer leur pile de recherche en production.
Dans les flux de travail des agents, le modèle décide comment traiter les preuves ; la couche de recherche détermine si les bonnes preuves parviennent au modèle.
Partez d’une phrase et obtenez un site complet en quelques minutes.



