For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/azure-maia-300-microsoft-s-2027-multi-gig-1e316d9a.md.
Microsoft fait entrer son programme d’infrastructure IA personnalisée dans une phase de déploiement beaucoup plus vaste.
Microsoft fait entrer son programme d’infrastructure IA personnalisée dans une phase de déploiement beaucoup plus vaste.
Le 12 octobre 2026, l’entreprise a déclaré prévoir de faire évoluer la famille Azure Maia vers des déploiements multi-gigawatts à partir de 2027, Maia devenant le principal système d’inférence pour les produits et services Microsoft.
L’annonce relie deux générations de matériel IA conçu par Microsoft.
Maia 200 est déjà en production et exécute des charges de travail Microsoft. Maia 300, le système suivant, doit commencer son déploiement en production en 2027 et est conçu spécifiquement pour le raisonnement à contexte long, les conversations sensibles à la latence et les charges de travail d’agents soutenues en plusieurs étapes.
L’argument central de Microsoft est que l’efficacité de l’inférence ne peut plus être améliorée en considérant uniquement la puce.
L’entreprise conçoit conjointement :
comme un seul système.
C’est cette approche à l’échelle du système que Microsoft entend déployer à l’échelle multi-gigawatt.
Avant d’aborder Maia 300, l’annonce de Microsoft commence par la génération actuelle.
Maia 200 n’est plus seulement une plateforme de développement.
Microsoft indique qu’elle exécute désormais des charges de travail de production, notamment Microsoft Copilot, tout en soutenant l’équipe Microsoft AI dans le développement de modèles de nouvelle génération.
L’entreprise indique que GitHub Copilot et Microsoft Foundry devraient suivre d’ici la fin de 2026.
Pour ces charges de travail, Maia 200 peut exécuter :
C’est important, car Microsoft ne présente pas Maia comme du silicium destiné à une seule famille de modèles propriétaires.
L’architecture est conçue pour prendre en charge un portefeuille de modèles hétérogène au sein d’Azure et des propres services de Microsoft.
Microsoft exploite des produits IA à une échelle considérable.
Cela donne à ses équipes d’infrastructure une visibilité directe sur la manière dont les modèles déployés utilisent le temps de calcul, la bande passante mémoire, la capacité réseau et l’énergie.
Au lieu de concevoir d’abord un accélérateur généraliste puis de décider plus tard comment les applications doivent l’utiliser, Microsoft affirme que ses équipes matériel et logiciel travaillent ensemble plusieurs années à l’avance.
L’objectif est d’anticiper les futurs besoins des modèles et de les traduire en choix matériels tels que :
Cette boucle de rétroaction façonne déjà la génération suivante.
Microsoft indique que Maia 200 est déployé aux :
Pour les capacités IA intégrées à des produits comprenant Microsoft Teams, Copilot et Cowork, Microsoft rapporte que Maia 200 peut fournir jusqu’à 1,7× plus de tokens par watt que ce qu’elle décrit comme une infrastructure GPU de premier plan.
Il s’agit d’une comparaison rapportée par Microsoft, et non d’un benchmark indépendant publié sur des systèmes tiers standardisés.
La formulation a son importance.
Elle témoigne de l’expérience de production interne de Microsoft, mais ne doit pas être interprétée comme un avantage universel de 1,7× pour chaque modèle, prompt, taille de lot, objectif de latence ou déploiement GPU.
Microsoft indique que l’expérience de production acquise avec Maia 200 a directement orienté la conception de Maia 300.
Le nouveau système est destiné à prendre en charge un éventail plus large de charges de travail, notamment :
La contrainte commune à ces charges de travail est l’inférence.
Elles exigent que les modèles restent réactifs tout en traitant des contextes plus longs, en conservant davantage d’état et en exécutant plus d’étapes.
Microsoft décrit Maia 300 comme la troisième génération de son programme Azure Maia.
Sa conception est orientée inférence.
Cela signifie que Microsoft optimise le système autour des charges de travail qui, selon elle, domineront les systèmes IA déployés, plutôt qu’autour du seul débit d’entraînement.
Ces charges de travail comprennent :
La mesure cible n’est de plus en plus pas seulement le nombre brut de FLOPS.
Il s’agit du nombre de tokens utiles qu’un centre de données peut fournir dans des contraintes fixes de :
Microsoft indique que Maia 300 devrait fournir 40 % de tokens par mégawatt de plus que les systèmes basés sur des GPU de premier plan.
Ce chiffre est une prévision de Microsoft concernant l’efficacité de déploiement au niveau système, et non un benchmark public indépendant doté d’une méthodologie complète de test inter-fournisseurs.
Dans un rack complet de 96 accélérateurs, Microsoft indique également que Maia 300 peut fournir jusqu’à 7× le débit de tokens à l’échelle du rack de Maia 200.
Ces deux chiffres mesurent des comparaisons différentes :
| Affirmation | Comparaison |
|---|---|
| 40 % de tokens par mégawatt en plus | Maia 300 par rapport aux systèmes basés sur des GPU de premier plan |
| Jusqu’à 7× le débit de tokens à l’échelle du rack | Rack Maia 300 complet à 96 accélérateurs par rapport à Maia 200 |
Ils ne doivent pas être considérés comme interchangeables.
L’une des idées principales derrière Maia 300 est que le déplacement des données est devenu un goulot d’étranglement majeur.
Les systèmes d’inférence modernes déplacent à plusieurs reprises :
entre les unités de calcul, la mémoire et les liaisons réseau.
Chaque déplacement coûte de la latence et de l’énergie.
La réponse de Microsoft est une évolution de l’architecture Software Defined Locally Accessed Dataflow, ou SDLA, introduite avec Maia 200.
Le logiciel contrôle l’emplacement des données et le moment de leur déplacement entre :
Maia 300 étend cette idée à une conception multi-chiplets.
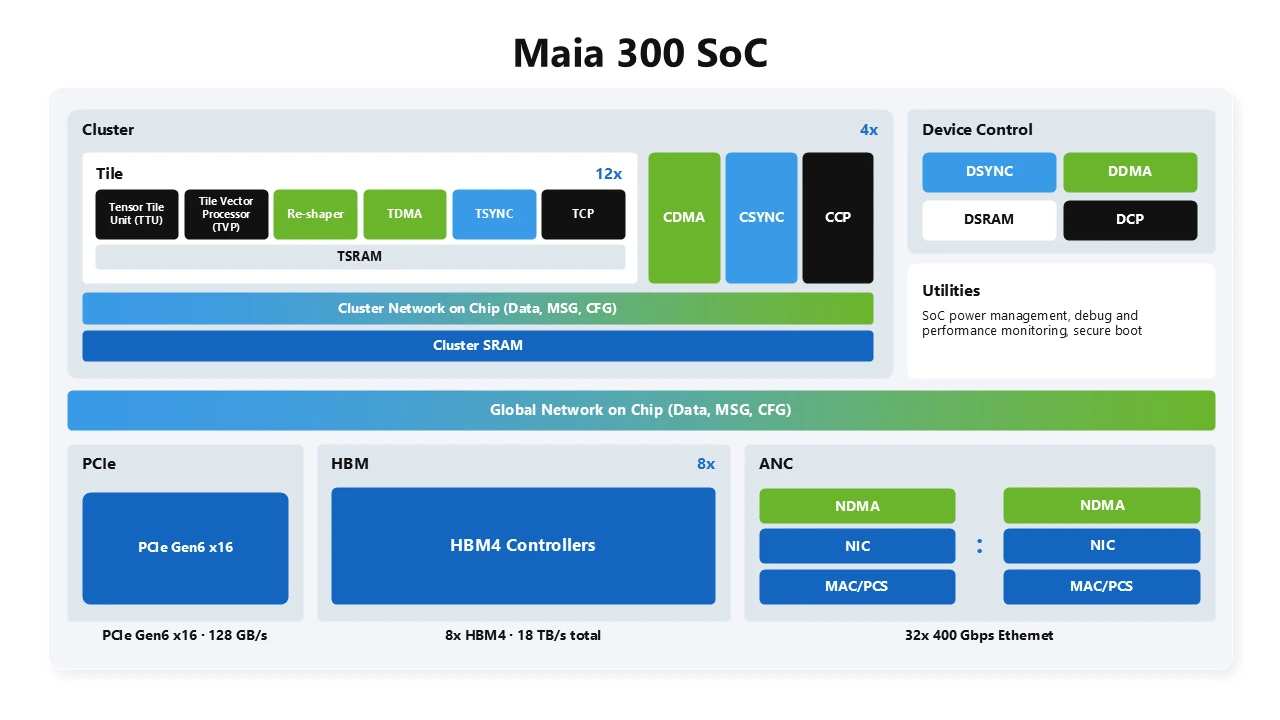
Maia 300 passe d’une organisation mémoire plus uniforme à une architecture mémoire non uniforme, consciente de la localité, entre les chiplets.
L’objectif est simple :
Garder les données plus près du calcul qui les utilise
→ déplacer moins d’octets
→ réduire la latence et l’énergie
→ améliorer l’utilisation
L’architecture confère au logiciel une responsabilité plus directe dans le contrôle de la localité.
C’est particulièrement important pour l’inférence à contexte long et dominée par le décodage, où le déplacement de l’état du modèle et du cache KV peut dominer la charge de travail.
La mémoire représente l’une des plus grandes améliorations de Maia 300.
Chaque accélérateur utilise huit piles HBM4 offrant :
Microsoft indique que cela apporte approximativement :
Le système utilise également de la SRAM sur puce comme espace de travail géré par logiciel.
Cela peut réduire la pression sur la HBM en gardant les données fréquemment réutilisées plus près du calcul.
Pour l’inférence, c’est important, car de nombreuses charges de travail sont limitées par la vitesse à laquelle l’état peut être livré aux moteurs de calcul plutôt que par leur capacité arithmétique maximale.
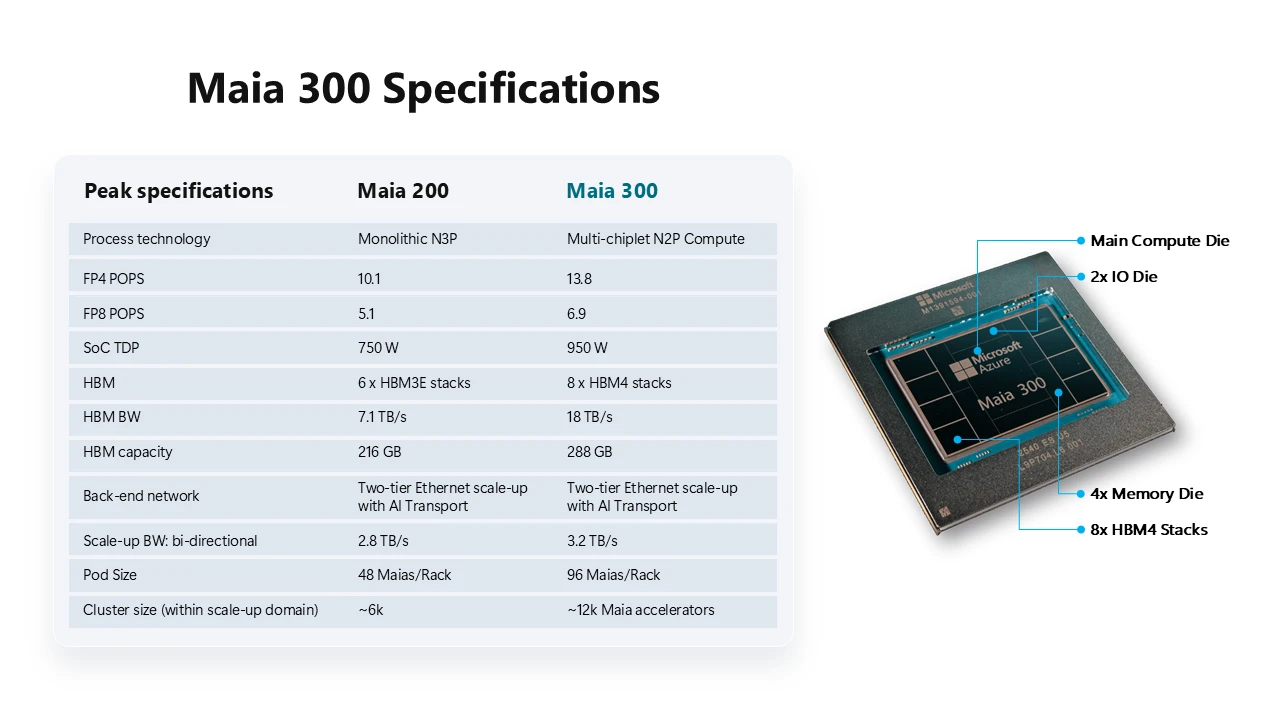
Maia 300 n’est pas une seule puce monolithique au même sens que Maia 200.
Microsoft sépare les principales fonctions entre plusieurs chiplets.
L’architecture comprend des fonctions distinctes pour :
Les chiplets de calcul sont fabriqués avec le procédé N2P de TSMC.
Le raisonnement est autant économique que technique.
La technologie de procédé la plus avancée peut être concentrée là où elle offre le meilleur bénéfice en performances par watt, tandis que d’autres fonctions peuvent utiliser des conceptions optimisées pour la bande passante, la connectivité ou le coût.
L’article de Microsoft sur l’architecture technique indique que ce changement contribue à :
par rapport à Maia 200.
Maia 300 étend également la prise en charge de l’inférence à précision réduite.
Microsoft met en avant une prise en charge améliorée de MXFP4 et des formats de stockage inférieurs à 3 bits dans ses documents d’architecture technique.
Une précision plus basse peut réduire :
Le bénéfice ne consiste pas simplement à utiliser des nombres plus petits.
Si le modèle peut conserver la qualité requise à une précision plus basse, l’infrastructure peut prendre en charge :
Microsoft indique également que le moteur vectoriel ajoute des optimisations au niveau des instructions pour les noyaux d’inférence tels que softmax et la conversion de données à faible précision.
À grande échelle, les accélérateurs ne sont utiles que s’ils peuvent communiquer efficacement.
Maia 300 étend son modèle de flux de données au réseau lui-même.
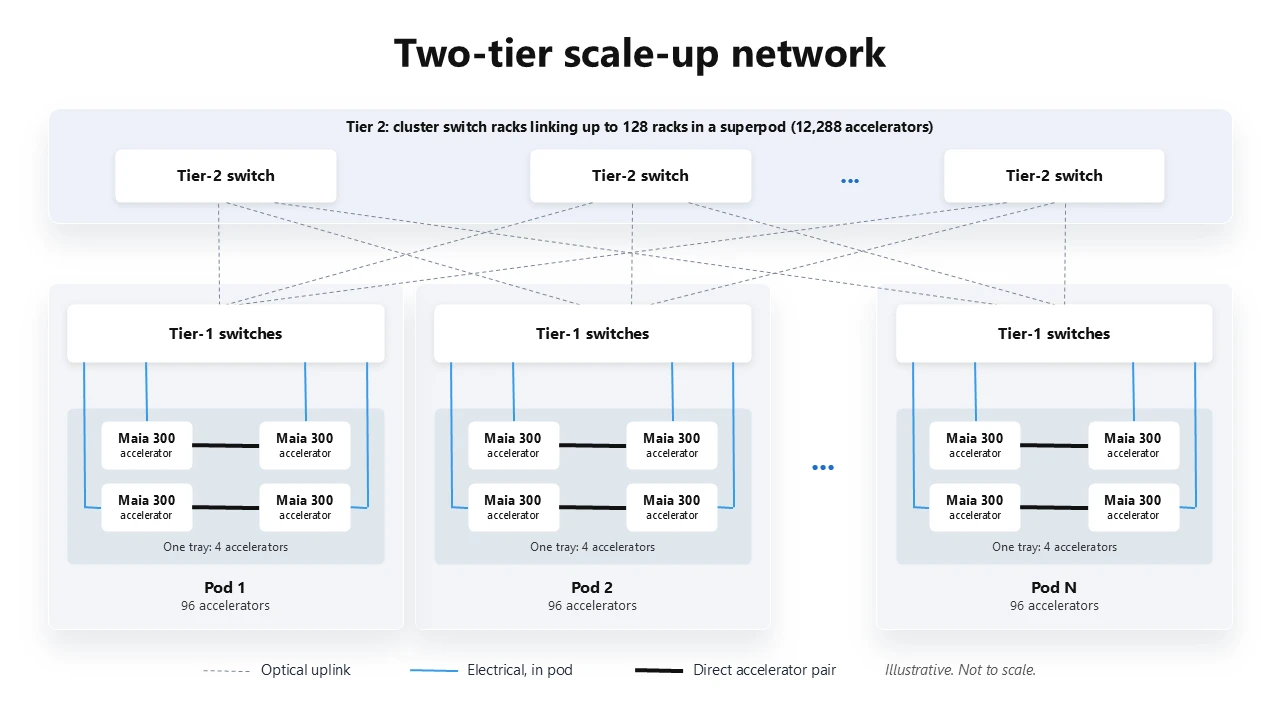
Microsoft utilise un transport IA personnalisé sur une infrastructure basée sur Ethernet et une topologie scale-up à deux niveaux.
Un seul rack Maia 300 contient :
96 accélérateurs
Plusieurs racks peuvent ensuite être connectés dans un superpod.
L’architecture technique de Microsoft décrit un superpod maximal de :
128 racks
12 288 accélérateurs Maia 300
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
À l’intérieur d’un rack, des liaisons directes connectent des paires d’accélérateurs, tandis que des chemins électriques commutés relient le pod complet de 96 accélérateurs.
Microsoft indique que le maintien du scale-up dans le rack en électrique contribue à réduire la consommation et les coûts.
Un second niveau de réseau utilise une connectivité optique pour couvrir plusieurs racks.
Cela permet à jusqu’à 128 racks de participer au même domaine scale-up.
L’objectif déclaré de Microsoft est d’éviter d’exposer une sémantique de communication distincte pour chaque frontière physique.
Le même modèle général de communication couvre :
Cela donne davantage de flexibilité aux ordonnanceurs et aux logiciels dans le placement des charges de travail parallèles par tenseurs, par pipeline et par experts.
Le rack de Maia 300 est une partie majeure de la conception du système.
Chaque rack contient :
La comparaison d’architecture de Microsoft arrondit la capacité HBM totale à 27,7 To dans son graphique de rack.
La différence provient simplement de l’arrondi de 96 × 288 Go.
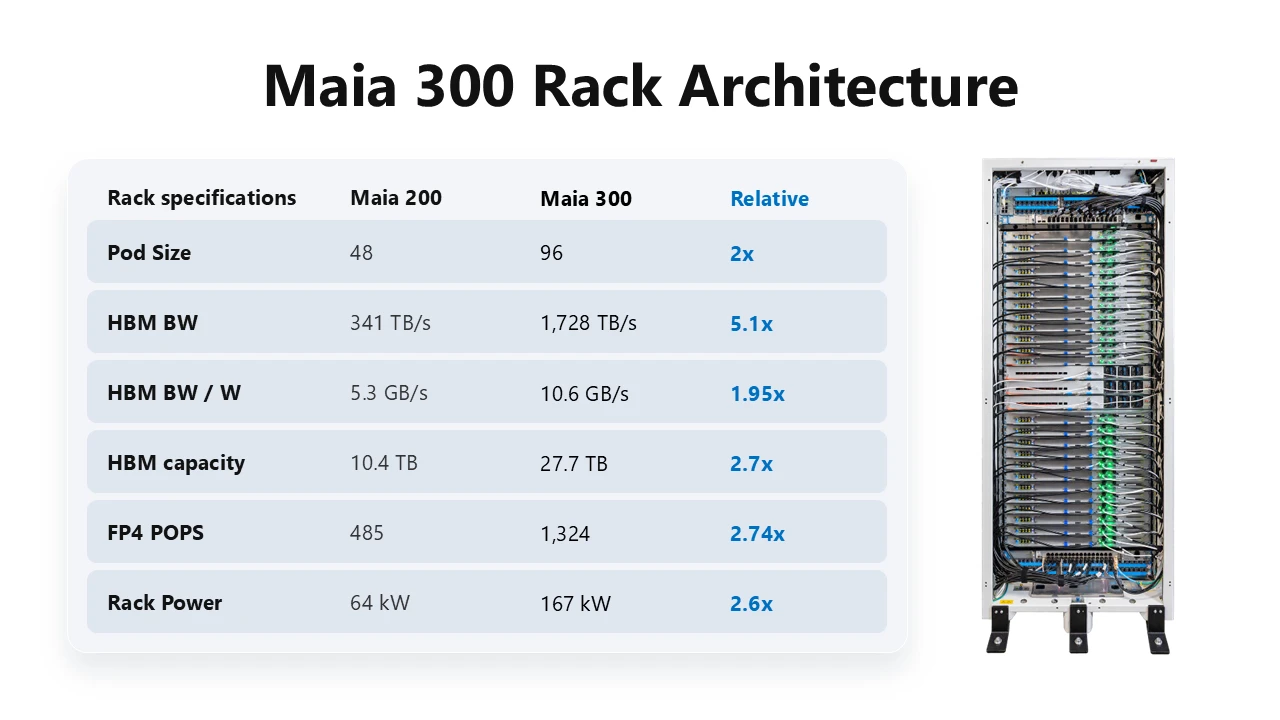
La densité d’accélérateurs est le double de celle de Maia 200.
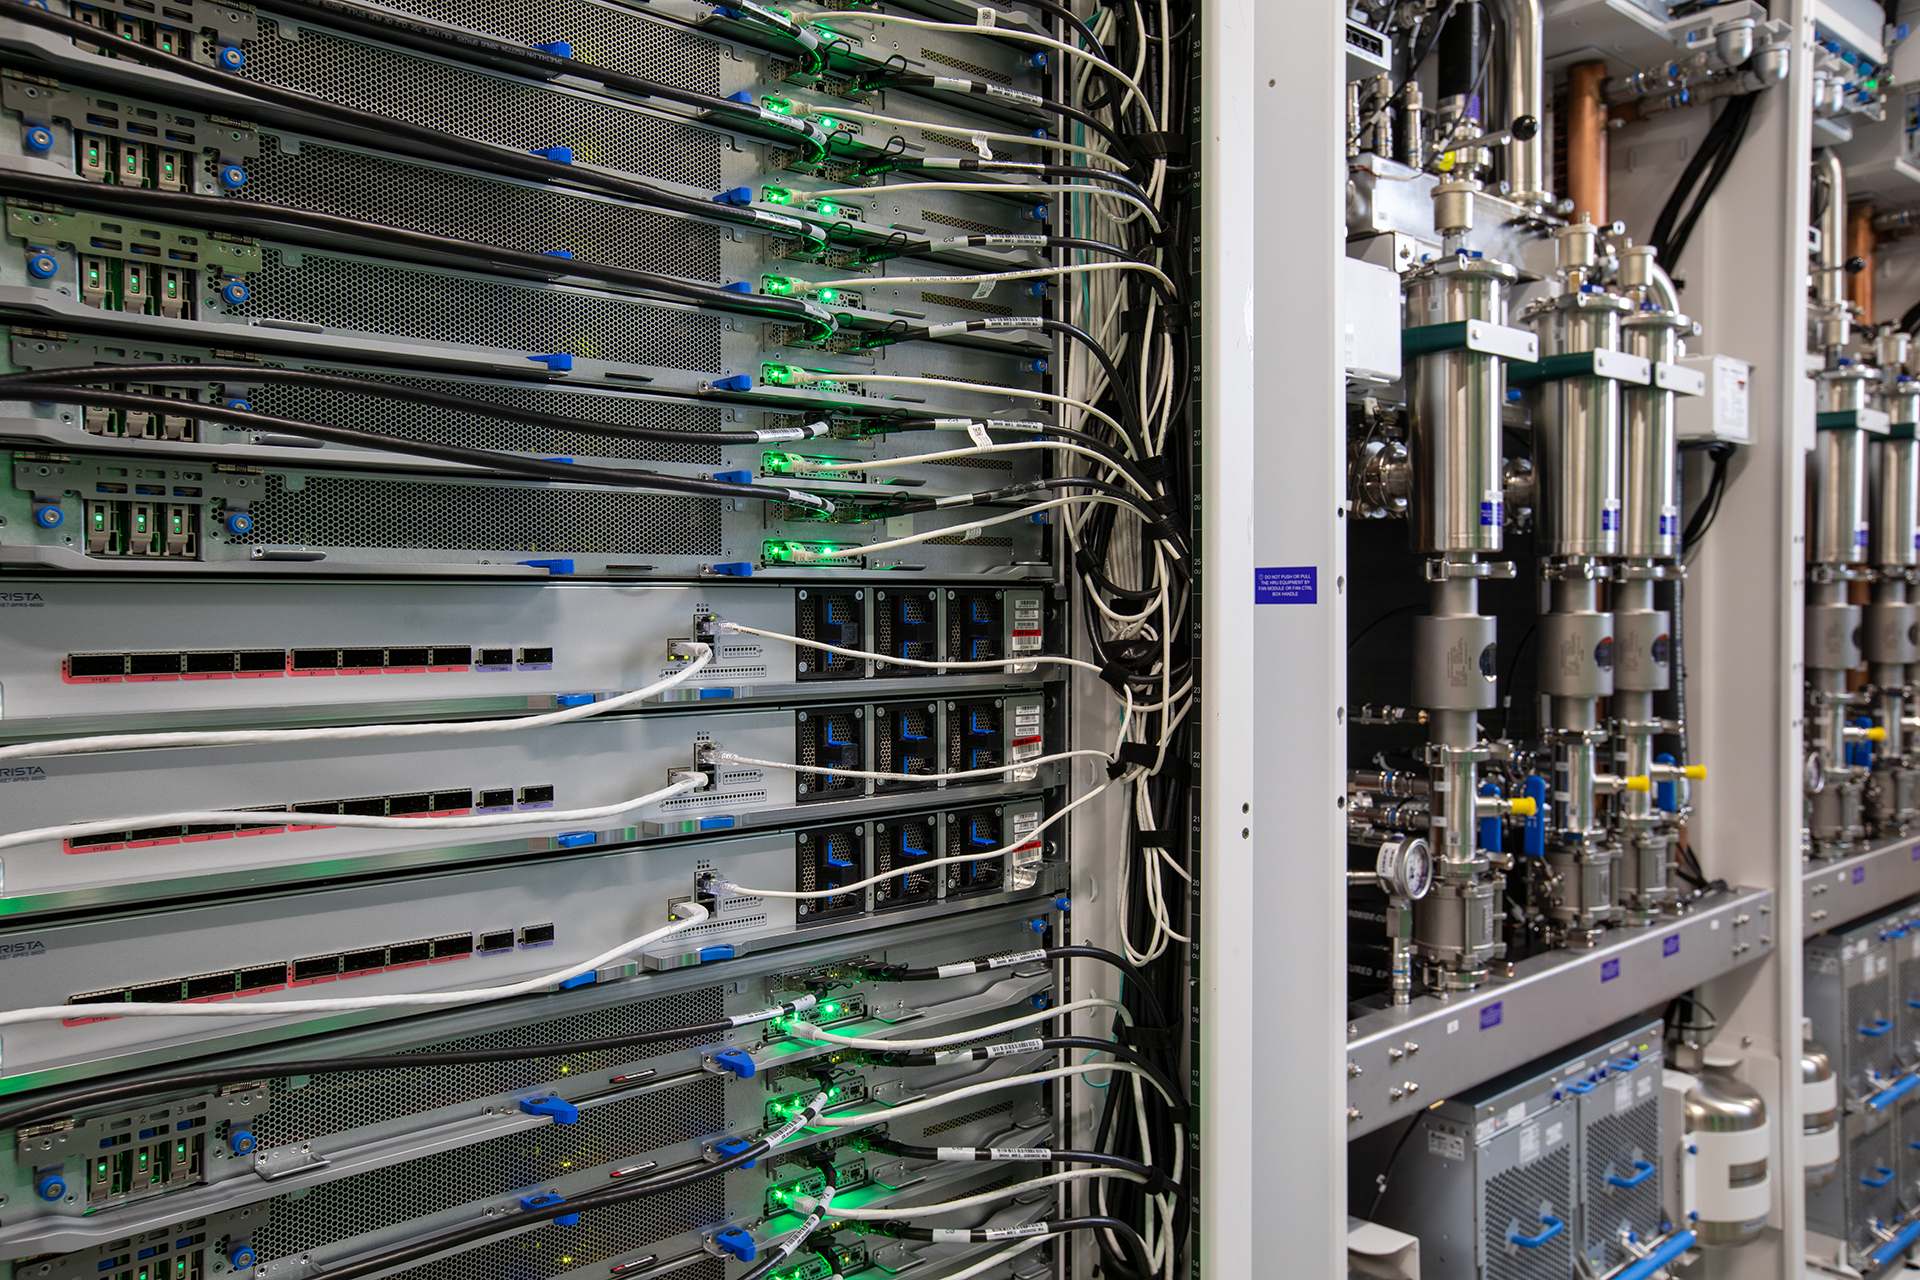
Microsoft intègre le calcul hôte, la mémoire, le stockage, le refroidissement et les accélérateurs dans chaque tiroir, plutôt que d’exiger des tiroirs hôtes séparés.
Cela libère de l’espace dans le rack et permet de gérer l’alimentation et la chaleur comme un seul système.
Un rack IA de 167 kW crée un défi important de gestion thermique.
Microsoft indique que le refroidissement liquide évacue plus de 80 % de la charge thermique du rack de composants tels que :
Le refroidissement par air reste utilisé pour des composants comprenant la mémoire, le stockage et d’autres systèmes de support.
Le rack peut se connecter directement à l’eau de l’installation là où cette infrastructure existe.
Il peut également utiliser une unité d’échange thermique dans les installations qui sont autrement refroidies par air.
Cette flexibilité est importante pour l’échelle de déploiement.
Microsoft ne peut pas étendre Maia uniquement dans des centres de données construits autour d’une seule configuration de refroidissement précise.
Le tableau suivant consolide les spécifications publiées par Microsoft pour Maia 300 et sa comparaison avec Maia 200.
| Spécification | Maia 200 | Maia 300 |
|---|---|---|
| Procédé / approche de packaging | N3P monolithique | Multi-chiplets, calcul N2P |
| Pic FP4 | 10,1 POPS | 13,8 POPS |
| Pic FP8 | 5,1 POPS | 6,9 POPS |
| TDP SoC | 750 W | 950 W |
| HBM | 6 × HBM3E | 8 × HBM4 |
| Capacité HBM par accélérateur | 216 Go | 288 Go |
| Bande passante HBM par accélérateur | 7,1 To/s | 18 To/s |
| Bande passante scale-up bidirectionnelle | 2,8 To/s | 3,2 To/s |
| Accélérateurs par rack | 48 | 96 |
| Capacité HBM approximative par rack | 10,4 To | 27,7 To |
| Puissance du rack | 64 kW | 167 kW |
| Domaine scale-up maximal publié | ~6 000 accélérateurs | ~12 000 accélérateurs |
Il s’agit de spécifications de pointe et de système publiées par Microsoft.
Elles ne constituent pas des garanties au niveau des applications.
Le débit réel dépend du modèle, de la précision, de la taille de lot, de l’objectif de latence, de la stratégie de parallélisme, de la pile logicielle et du mélange de charges de travail.
Le chiffre phare est le plan de Microsoft d’étendre Azure Maia à des déploiements multi-gigawatts à partir de 2027.
Il s’agit d’une déclaration sur l’échelle de l’infrastructure.
Microsoft n’a pas communiqué de chiffre exact en gigawatts, de calendrier de déploiement site par site ni de nombre d’accélérateurs lié à cette déclaration.
Elle ne doit pas non plus être interprétée comme signifiant qu’un seul centre de données Maia 300 consommera nécessairement plusieurs gigawatts.
Un programme à l’échelle du gigawatt peut couvrir :
L’annonce de l’entreprise se concentre intentionnellement sur la stratégie système plutôt que sur un plan de construction installation par installation.
L’infrastructure IA est de plus en plus limitée par la quantité de calcul utile pouvant être intégrée dans la puissance disponible.
Un centre de données ne peut pas ajouter des accélérateurs indéfiniment s’il ne peut pas aussi fournir :
C’est pourquoi Microsoft met l’accent sur les tokens par mégawatt.
Cette mesure relie la production du service de modèles à la ressource rare qui détermine de plus en plus l’expansion des centres de données.
Une puce plus rapide mais consommant proportionnellement plus d’énergie peut ne pas résoudre le véritable problème de déploiement.
L’objectif est de générer davantage de sortie IA utile dans la même enveloppe d’infrastructure.
L’annonce de Microsoft va au-delà de l’idée selon laquelle Maia 300 serait une autre option d’accélérateur.
L’entreprise affirme que la famille Maia deviendra son principal système d’inférence pour les produits et services Microsoft à mesure que le déploiement se développera.
Cela rend Maia stratégiquement important dans l’ensemble de la pile Microsoft.
L’entreprise nomme ou mentionne notamment les charges de travail suivantes :
Cela ne signifie pas que Microsoft abandonne les GPU ou d’autres accélérateurs.
Microsoft décrit explicitement son infrastructure plus large comme hétérogène et diversifiée en modèles.
Le programme Maia offre à Microsoft une autre option d’infrastructure qu’elle peut optimiser étroitement autour des schémas d’utilisation de ses propres services.
La dernière section de l’annonce de Microsoft inscrit Maia dans ce que l’entreprise appelle la Frontier Transformation.
L’idée est que l’infrastructure IA ne doit pas être optimisée sous forme de couches isolées.
Microsoft veut relier :
Silicium
→ systèmes
→ centres de données
→ service de modèles
→ agents
→ applications
Parce que Microsoft exploite toutes ces couches, l’entreprise peut utiliser les retours de production des applications pour influencer le matériel futur.
L’inverse est également vrai.
Les nouvelles capacités matérielles peuvent façonner ce que les futurs modèles et agents pourront accomplir de manière économiquement viable à grande échelle.
C’est l’objectif stratégique de Maia.
L’entreprise ne cherche pas à prouver qu’une seule puce remplacera chaque accélérateur.
Elle construit une plateforme d’inférence conçue verticalement de manière conjointe, qui peut coexister avec d’autres matériels dans Azure.
Les spécifications publiées de Maia 300 sont importantes, mais la majeure partie du système clé reste en préproduction.
Le déploiement en production commence en 2027.
Plusieurs questions compteront une fois que le système atteindra des charges de travail réelles.
Microsoft prévoit 40 % de tokens par mégawatt de plus que les systèmes basés sur des GPU de premier plan.
La question utile sera de savoir comment ce résultat se maintient selon les modèles et les objectifs de latence.
Le silicium personnalisé ne réussit que lorsque le compilateur, les noyaux, l’observabilité, les outils de déploiement et la prise en charge des modèles sont suffisamment mûrs pour les équipes de production.
Microsoft veut que Maia prenne en charge les familles de modèles OpenAI, MAI et open source.
L’efficacité en production entre architectures hétérogènes sera un test important.
Le domaine scale-up de 12 288 accélérateurs est significatif sur le plan architectural.
L’utilisation réelle, la récupération après incident, l’ordonnancement et les communications inter-racks détermineront quelle part de cette échelle théorique se traduit en capacité utile.
La performance par watt n’est qu’une partie du coût total.
Les opérateurs de centres de données se préoccupent également :
L’avantage de Microsoft, si la stratégie fonctionne, proviendra de l’optimisation de l’ensemble du système plutôt que d’un seul chiffre de benchmark.
Azure Maia 300 est le système d’inférence IA personnalisé de troisième génération de Microsoft. Il combine un accélérateur multi-chiplets, de la mémoire HBM4, un flux de données défini par logiciel, un réseau scale-up personnalisé basé sur Ethernet et une architecture de rack à 96 accélérateurs conçue pour l’inférence IA à l’échelle du cloud.
Microsoft indique que le déploiement en production commencera en 2027. L’entreprise prévoit également de commencer à faire évoluer la famille Maia vers des déploiements multi-gigawatts en 2027.
Cela signifie que Microsoft prévoit une infrastructure Maia à une échelle de puissance agrégée mesurée en plusieurs gigawatts. Microsoft n’a pas publié de total exact, de nombre d’accélérateurs, ni déclaré qu’un seul centre de données consommerait plusieurs gigawatts ; ces détails ne doivent donc pas être déduits du seul titre.
Chaque accélérateur Maia 300 possède huit piles HBM4 offrant 288 Go de capacité et 18 To/s de bande passante HBM de pointe. Un rack de 96 accélérateurs contient environ 27,6 à 27,7 To de HBM agrégée.
Microsoft spécifie une enveloppe de puissance de 167 kW pour un rack Maia 300 complet à 96 accélérateurs. Le SoC de l’accélérateur lui-même a un TDP de 950 W.
Microsoft prévoit que Maia 300 fournisse 40 % de tokens par mégawatt de plus que les systèmes basés sur des GPU de premier plan, mais n’a pas publié de méthodologie complète de benchmark indépendant inter-fournisseurs pour cette affirmation. Le résultat doit donc être considéré comme une prévision de performance système de Microsoft plutôt que comme une conclusion universelle de benchmark.
Microsoft indique que Maia deviendra son principal système d’inférence pour les produits et services Microsoft, mais décrit également Azure comme une plateforme ouverte et hétérogène offrant un choix de modèles et de silicium. Maia fait partie de ce mix d’infrastructure plus large, plutôt que de prouver qu’Azure utilisera uniquement du silicium Microsoft.
Microsoft indique que Maia 200 exécute déjà Microsoft Copilot et soutient le développement par l’équipe MAI de modèles de nouvelle génération. GitHub Copilot et Microsoft Foundry devraient suivre d’ici la fin de 2026.
Microsoft fait évoluer Azure Maia d’un programme d’accélérateurs personnalisés vers une plateforme d’inférence à grande échelle. Maia 200 exécute déjà des charges de travail de production, tandis que Maia 300 doit commencer son déploiement en 2027 et est conçu autour de l’inférence agentique, à contexte long et dominée par le décodage.
Les principaux changements sont au niveau du système : 288 Go de HBM4 par accélérateur, 18 To/s de bande passante mémoire, une conception N2P multi-chiplets, 96 accélérateurs par rack de 167 kW, une structure scale-up atteignant 12 288 accélérateurs et un refroidissement liquide évacuant plus de 80 % de la chaleur du rack.
L’objectif de Microsoft est de faire évoluer la famille Maia vers des déploiements multi-gigawatts et d’en faire le principal système d’inférence derrière ses propres produits et services, tout en maintenant Azure hétérogène.
L’histoire de Maia 300 porte moins sur le remplacement d’une puce par une autre que sur la conception par Microsoft de tout le parcours, du silicium au centre de données puis à l’agent, autour de l’économie de l’inférence IA.
Partez d’une phrase et obtenez un site complet en quelques minutes.



