L'assistant Wenxin de Baidu a décroché la première place dans un autre benchmark de type agent. Lors de l'évaluation produit XClaw de SuperC...
L'Assistant Wenxin de Baidu s'est classé premier dans un autre benchmark de type agent.
Dans l'évaluation produit XClaw de SuperCLUE d'août 2026, l'Assistant Wenxin a obtenu un score global de 97,62, le score le plus élevé de l'instantané publié.
Ses scores par catégorie étaient les suivants :
| Capacité | Score |
|---|---|
| Programmation | 90,28 |
| Création de contenu | 99,44 |
| Traitement des données | 98,86 |
| Analyse de recherche | 96,44 |
| Mémoire | 100,00 |
Ce résultat est arrivé moins de trois semaines après une autre performance remarquable.
Dans un instantané de juillet de PinchBench v2, l'agent de tâches de Baidu — soumis sous le nom Orion Mission Mode — a enregistré un score maximal de 94,6 % et un score moyen de 94,4 %, le plaçant en tête de cet instantané de classement.
Les deux benchmarks sont différents. SuperCLUE XClaw se concentre sur les produits agents chinois et les livrables pratiques à travers cinq dimensions de capacité. PinchBench v2, créé par Kilo, est construit autour de tâches informatiques et d'automatisation du monde réel.
Ensemble, ils pointent vers la même évolution :
L'évaluation des agents passe de « Le modèle peut-il répondre correctement ? » à « Le système peut-il terminer la tâche et fournir quelque chose d'utilisable ? »
Un modèle de langage peut connaître la réponse et échouer en tant qu'agent parce qu'il oublie les exigences, choisit le mauvais outil, gère mal les fichiers, s'arrête au milieu d'un flux de travail ou retourne le mauvais artefact.
Cela rend les derniers résultats de Wenxin plus liés à l'exécution des tâches qu'à l'intelligence brute du modèle de langage.
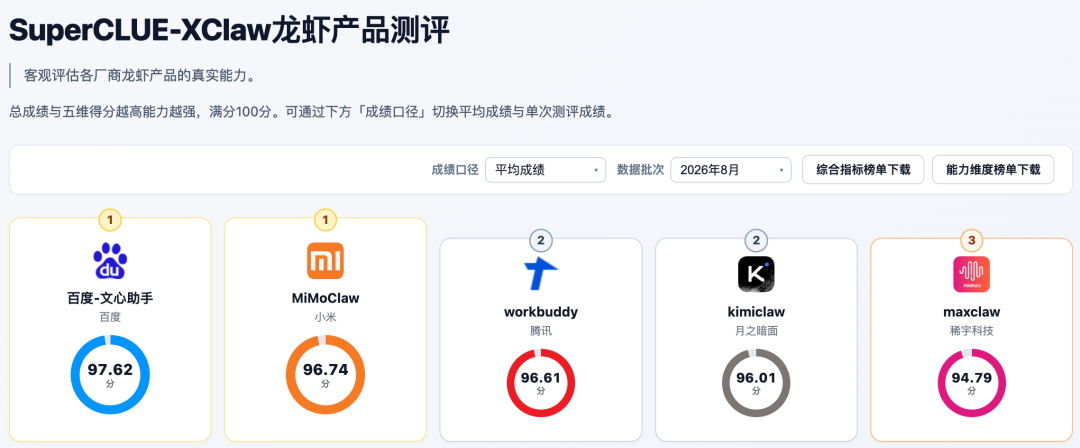
SuperCLUE décrit XClaw comme une évaluation orientée produit pour les assistants IA de type « Claw ».
Plutôt que de s'appuyer principalement sur des questions à choix multiples, le benchmark met l'accent sur les livrables complétés.
L'instantané d'août 2026 classe les principaux produits comme suit :
| Rang | Produit | Score |
|---|---|---|
| 1 | Assistant Wenxin de Baidu | 97,62 |
| 2 | MiMoClaw | 96,74 |
| 3 | WorkBuddy | 96,61 |
| 4 | KimiClaw | 96,01 |
| 5 | MaxClaw | 94,79 |
Le benchmark évalue cinq dimensions :
La logique de base est simple : l'agent reçoit une tâche et doit produire un artefact ou un résultat final qui peut réellement être évalué.
Cela fait du suivi des instructions, de la gestion des fichiers, de l'utilisation des outils et de l'exécution sur de longues périodes des éléments du score.
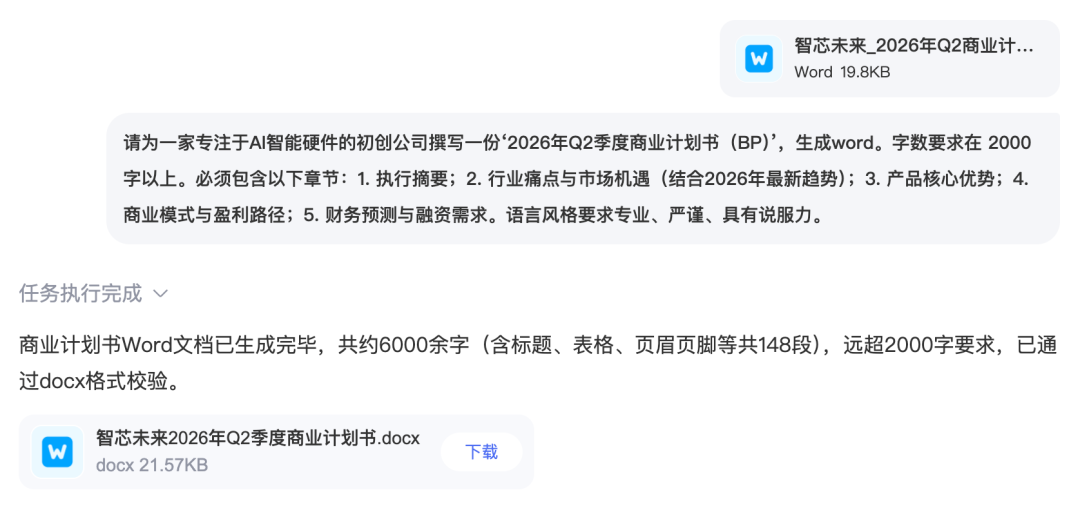
Cela montre la différence entre le travail de chat et le travail d'agent.
Un modèle de chat pourrait rédiger le plan dans la conversation.
Un flux de travail d'agent peut faire ceci :
Lire le fichier source
→ extraire les informations structurées
→ rédiger le contenu
→ formater le document Word
→ valider la sortie
→ renvoyer un fichier
L'artefact, et non la réponse en prose, devient le produit final.
Wenxin a obtenu 99,44 pour la création de contenu.
Dans un benchmark d'agents, la création de contenu n'est pas simplement de l'écriture créative.
Le système peut avoir besoin de satisfaire plusieurs contraintes à la fois :
Un brouillon peut être grammaticalement correct et échouer quand même parce qu'il
ignore le format demandé.
C’est pourquoi les benchmarks de produits évaluent de plus en plus l’achèvement plutôt que la seule qualité linguistique.
La catégorie XClaw la plus faible de Wenxin était le codage, avec 90,28.
C’est encore un score solide, mais l’écart par rapport à la création de contenu et au traitement des données est révélateur.
Les agents de codage doivent gérer une boucle opérationnelle plus large :
Comprendre la demande
→ choisir la pile technique
→ écrire les fichiers
→ exécuter ou prévisualiser
→ inspecter les erreurs
→ corriger
→ vérifier l’interaction
→ empaqueter le résultat
L’éditeur source a testé le produit avec une demande en une phrase pour un simulateur de système solaire 3D.
Le flux de travail rapporté utilisait Three.js et a renvoyé une application HTML monofichier de 31 Ko.
L’article montre également une page pédagogique de simulation météorologique générée via un flux de travail interactif similaire.
Ce sont des démonstrations illustratives, et non des éléments officiels du benchmark XClaw.
Wenxin a obtenu 96,44 en analyse de recherche.
Une tâche de recherche sérieuse peut impliquer :
L’article source décrit deux cas de test.
L’éditeur a demandé à Wenxin de faire des recherches sur la conjecture de Kakeya en trois dimensions dans le contexte de la médaille Fields Hong Wang.
Le comportement rapporté de l’agent était :
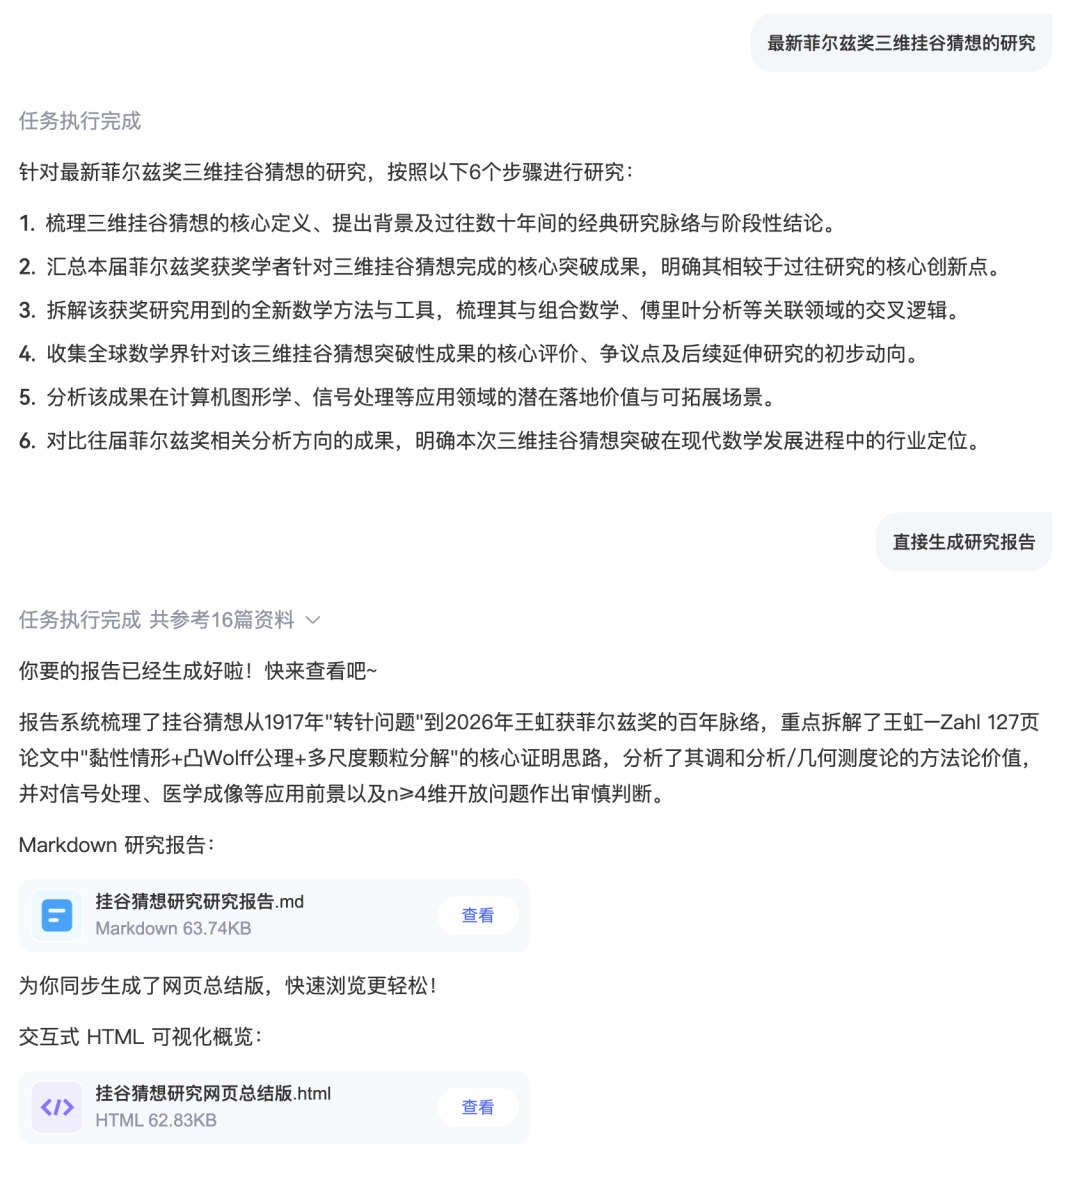
Le nombre de sources n’est pas en soi une mesure de qualité.
Ce qui compte, c’est de savoir si l’agent final utilise des sources faisant autorité, attribue correctement les affirmations, résout les conflits, évite les données obsolètes et sépare les faits de l’interprétation.
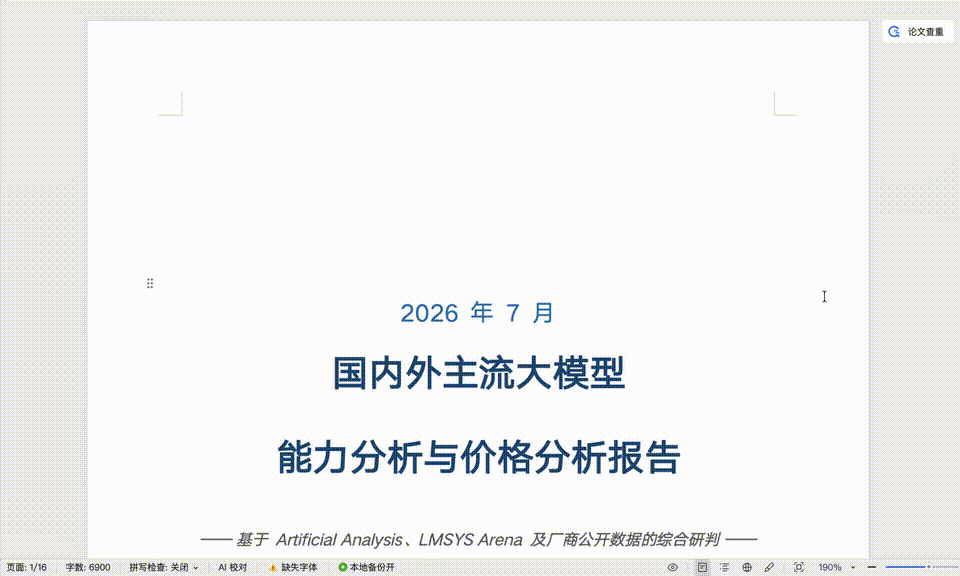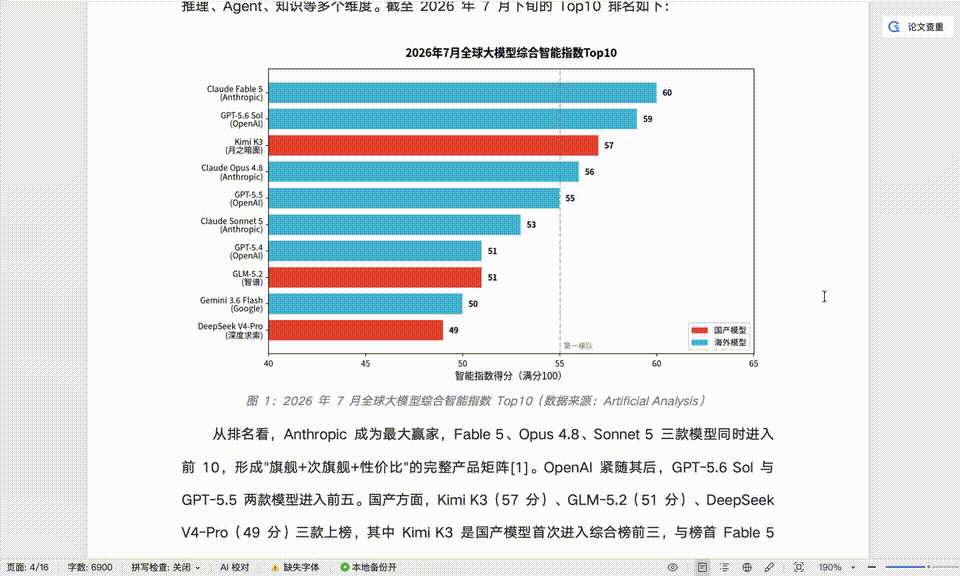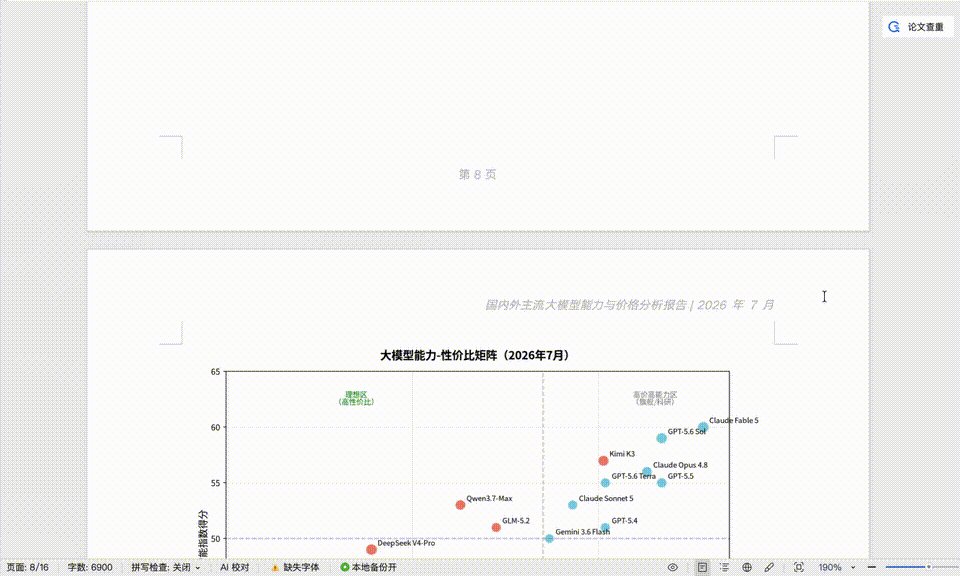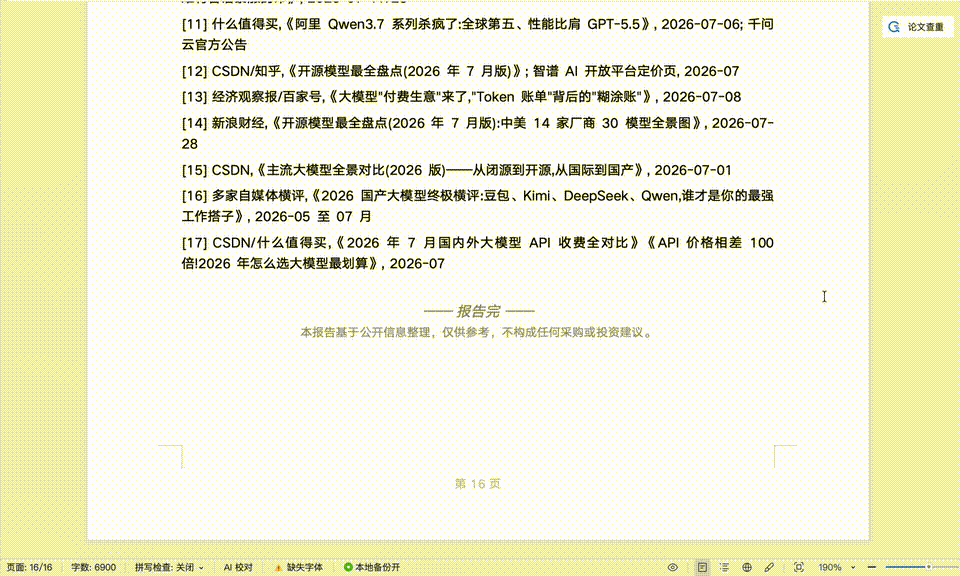
L’éditeur a également demandé à Wenxin d’analyser les capacités et les prix des principaux modèles nationaux et internationaux du mois précédent.
L’article indique que l’agent a :
La boucle de recherche utile est la suivante :
Rechercher
→ identifier l'incertitude
→ rechercher à nouveau
→ comparer les sources
→ résoudre ou signaler les désaccords
→ écrire
Cette étape de vérification supplémentaire est souvent celle où la qualité de la recherche s'améliore.
Le résultat SuperCLUE a suivi une première place en juillet sur PinchBench v2.
PinchBench a été créé par Kilo pour évaluer les agents sur des flux de travail réels plutôt que sur des benchmarks traditionnels de type question-réponse.
La version 2.0 de PinchBench de Kilo a élargi le benchmark à 148 tâches et a ajouté des règles de notation et de classement plus strictes.
Dans l'instantané du classement de juillet reproduit par l'article source, le système de Baidu apparaissait comme suit :
Orion-Mission-Mode
avec :
Meilleur score :    94,6 %
Score moyen :       94,4 %
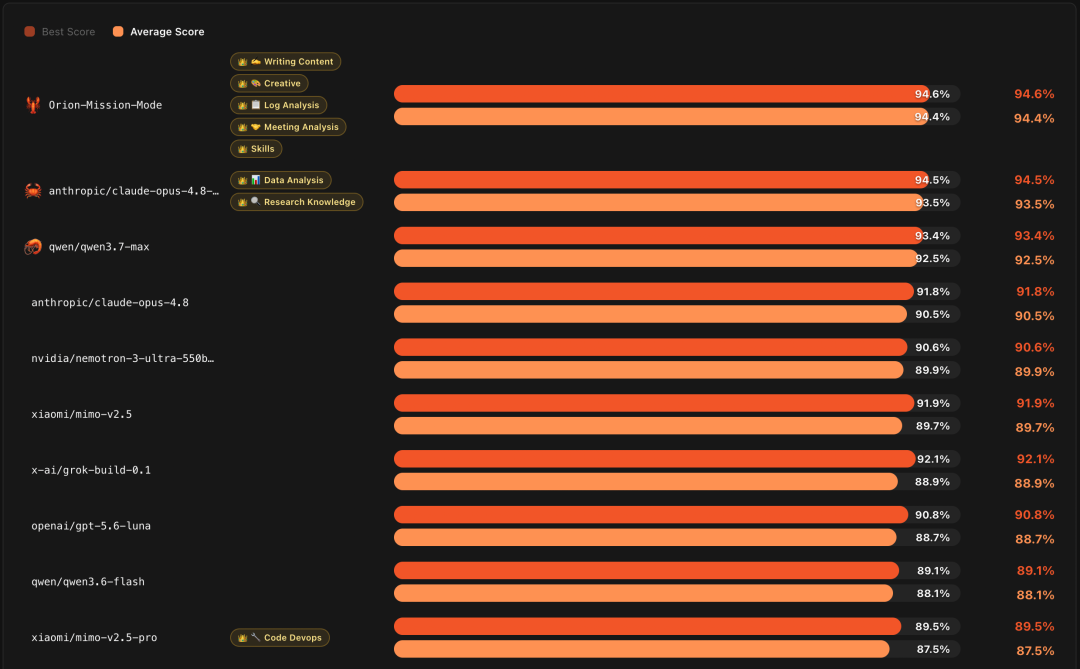
La capture d'écran place Orion Mission Mode devant les systèmes basés sur des modèles d'Anthropic, Alibaba, NVIDIA, Xiaomi, xAI, OpenAI, et d'autres dans cet instantané particulier.
Le mot important est instantané.
Les classements des agents évoluent rapidement.
Les modèles, les harnais, les invites, les politiques d'outils et les soumissions de benchmark peuvent tous être mis à jour.
Un résultat de première place en juillet doit donc être cité avec sa date plutôt que d'être traité comme un classement mondial permanent.
Kilo décrit PinchBench 2.0 comme un benchmark de flux de travail réels pour les agents.
Il contient des tâches qui exigent qu'un système utilise des outils et effectue des opérations plutôt que de simplement sélectionner une réponse.
Le benchmark couvre des catégories telles que :
L'article source indique que 59 entrées de modèles ou d'agents étaient représentées dans l'instantané du classement.
Ce nombre peut changer à mesure que des soumissions sont ajoutées ou mises à jour.
Le benchmark lui-même est plus stable que la population du classement.
La version officielle de PinchBench 2.0 décrit :
148 tâches
La source et plusieurs rapports de juillet décrivent l'évaluation de Wenxin sur 147 tâches terminées tout en décrivant PinchBench comme un benchmark de 148 tâches.
L'interprétation la plus sûre est :
PinchBench v2 contient 148 tâches ; l'évaluation rapportée d'Orion Mission Mode peut avoir produit des résultats notés sur 147 d'entre elles dans cet instantané.
Cette distinction est importante car les rapports de benchmark mélangent souvent la taille du benchmark avec le nombre de résultats réussis.
exécutions terminées.
La source souligne que le mode mission Orion a enregistré :
94,6 % de meilleur score
94,4 % de score moyen
L'écart de 0,2 point est faible.
Cela suggère une faible variation entre les exécutions rapportées.
Cependant, il ne faut pas l'interpréter comme une garantie de stabilité universelle.
La variance des benchmarks peut dépendre de :
La leçon pratique est simplement que l'exécution PinchBench rapportée ne reposait pas sur un seul résultat chanceux isolé.
Sa moyenne est restée proche de son meilleur score.
L'un des points les plus importants de l'article source est que le benchmark évalue un système produit ou agent, et non un modèle linguistique nu.
L'agent de tâche peut combiner :
Cela peut s'exprimer ainsi :
Résultat de l'agent
=
capacité du modèle
+
outils
+
mémoire
+
planification
+
recherche
+
environnement d'exécution
+
vérification
C'est pourquoi il faut être prudent lorsqu'on dit :
« Le modèle X a battu le modèle Y. »
Le classement peut en réalité comparer deux piles d'agents différentes utilisant des outils et une orchestration distincts.
Une description plus précise serait :
« Le système d'agent X a obtenu un score supérieur au système d'agent Y dans cette configuration de benchmark. »
Cette formulation devient de plus en plus importante à mesure que les produits IA se transforment en systèmes logiciels complexes.
L'article source présente 2026 comme l'année où la norme pour un produit IA utile est en train de changer.
L'interaction ancienne ressemblait à ceci :
L'utilisateur demande
→ le modèle répond
→ l'utilisateur effectue le travail
Le modèle émergent de l'agent ressemble à ceci :
L'utilisateur donne un objectif
→ l'agent planifie
→ l'agent rassemble le contexte
→ l'agent appelle les outils
→ l'agent crée des fichiers
→ l'agent vérifie les résultats
→ l'agent livre l'artefact
Cela change ce que les utilisateurs remarquent.
Un modèle peut être extrêmement compétent mais frustrant s'il ne peut pas :
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
La nouvelle condition de succès se rapproche de :
La tâche a-t-elle réellement été terminée ?
plutôt que :
La réponse était-elle impressionnante ?
L'article du BAAI montre l'option « Tâche » directement dans l'interface de Wenxin.
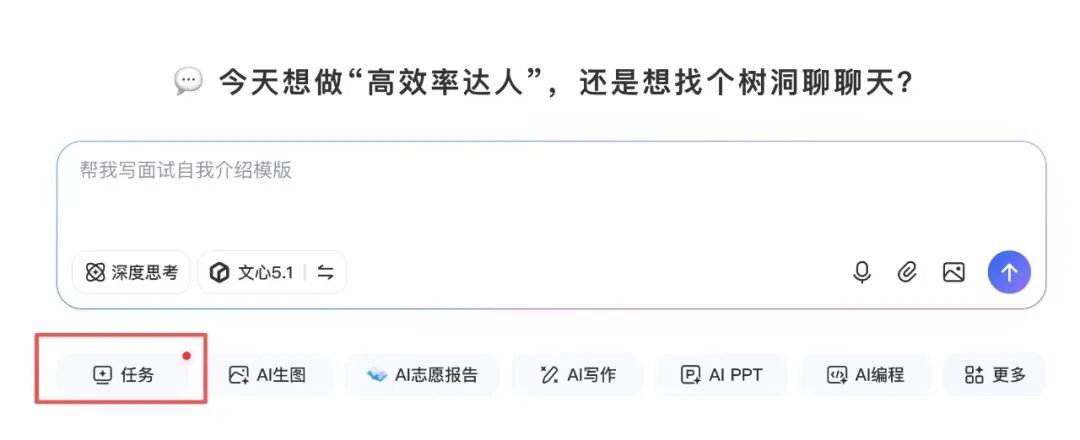
Le site officiel de Wenxin de Baidu décrit le produit comme un assistant IA multimodal pour :
Utilisation multi-appareils.
L'application Baidu répertorie également Wenxin Assistant comme une fonctionnalité d'IA intégrée pour la recherche approfondie, l'écriture, la génération d'images, la génération vidéo et l'assistance conversationnelle.
Cela confirme que l'IA orientée tâches est passée dans les surfaces grand public de Baidu plutôt que de rester une expérience réservée aux développeurs.
L'article source souligne à plusieurs reprises un point commercial :
Wenxin Assistant est gratuit et sans paywall.
Les pages officielles de Wenxin de Baidu proposent actuellement un accès gratuit ou une expérience gratuite.
C'est facile à vérifier.
L'affirmation plus forte — gratuit en permanence et sans limite pour toutes les fonctionnalités d'agents — est plus difficile à vérifier à partir d'une page de politique officielle stable.
Les produits d'IA peuvent introduire :
Pour une publication, la formulation la plus prudente est :
Wenxin Assistant est actuellement disponible pour les utilisateurs individuels avec des options d'accès gratuit, et l'expérience de tâche présentée dans l'article source ne nécessitait pas d'abonnement payant.
Ne construisez pas une comparaison de coûts à long terme autour d'une « gratuité illimitée pour toujours » à moins que Baidu ne publie une politique spécifique la garantissant.
La dernière section de l'article source soutient que l'historique de recherche de Baidu lui confère un avantage structurel dans la conception d'agents.
Il existe une réelle analogie.
Un moteur de recherche gère quelque chose comme :
Requête utilisateur
→ compréhension de l'intention
→ décomposition de la requête
→ récupération
→ classement
→ agrégation des résultats
→ réponse
Un agent gère :
Objectif utilisateur
→ compréhension de l'intention
→ décomposition de la tâche
→ sélection des outils
→ exécution
→ agrégation des résultats
→ livraison
Les deux pipelines ne sont pas identiques.
Un agent dispose d'un espace d'action beaucoup plus vaste et porte un risque d'exécution plus élevé.
Mais plusieurs capacités techniques se transfèrent naturellement :
Cela est particulièrement pertinent pour les agents de recherche.
Un système qui dispose déjà d'une infrastructure de recherche solide peut construire des flux de travail plus profonds par-dessus.
Considérez une requête de recherche traditionnelle :
Trouvez le vol le moins cher de Pékin à Shanghai.
Un système de recherche peut devoir déduire :
Un agent auquel on demande :
Trouvez le vol le moins cher entre Pékin et Shanghai et préparez un itinéraire.
peut devoir ajouter :
La première moitié du problème ressemble à de la recherche.
La seconde moitié est une orchestration d'actions.
L'expérience en recherche fournit des composants utiles, mais la qualité de l'agent dépend toujours de la couche d'exécution.
La source relie également le score de mémoire de Wenxin à l'expérience de Baidu dans la compréhension des sessions de recherche. Il y a
un certain chevauchement conceptuel.
Les deux systèmes doivent déduire quelles informations des interactions précédentes restent pertinentes.
Une session de recherche peut contenir :
Requête 1 : voitures électriques
Requête 2 : autonomie supérieure à 600 km
Requête 3 : moins de 250 000 RMB
Le système doit comprendre que la troisième requête concerne toujours les voitures électriques.
Un système de mémoire d’agent a une tâche plus difficile.
Il peut avoir besoin de se souvenir :
L’expertise des sessions de recherche est utile, mais une mémoire d’agent persistante nécessite des mécanismes supplémentaires de stockage, de récupération, de confidentialité et de pertinence.
Parmi les cinq catégories de XClaw, l’analyse de recherche est le domaine le plus évident où l’expérience de recherche de Baidu peut être directement transférée.
Un agent de recherche a besoin :
La documentation officielle de l’assistant IA Qianfan de Baidu décrit également une solution d’agent d’entreprise intégrant la recherche Baidu, Baidu Baike, la recherche d’images, la gestion des conversations, la gestion de la mémoire et des capacités documentaires.
Cela ne prouve pas que le produit grand public Wenxin utilise exactement la même implémentation.
Cela montre que Baidu construit une pile d’agent commune autour de la recherche, de la mémoire, des outils et de la récupération multimodale à travers son portefeuille de produits.
Des scores de référence élevés sont des preuves utiles.
Ils ne constituent pas l’évaluation complète.
Les classements changent.
De nouveaux modèles et de nouvelles soumissions d’agents peuvent dépasser le leader actuel.
XClaw agrège des tâches et des catégories sélectionnées.
Le flux de travail réel d’un utilisateur peut être très différent.
Le score appartient à l’assistant complet ou à la pile d’agent.
Un agent capable d’effectuer des tâches efficacement peut encore faire des appels d’outils dangereux ou exposer des informations sensibles dans un environnement différent.
Les agents de recherche peuvent citer des sources faibles ou mal interpréter des données changeantes.
Les prix des produits et les quotas sont des politiques commerciales, pas des propriétés de référence.
Un test personnel utile devrait ressembler à votre travail réel.
Ne posez pas seulement des questions triviales.
Confiez une tâche complète à l’agent.
Fournissez cinq contraintes au début d’une longue conversation.
Après plusieurs échanges sans rapport, demandez un artefact final et vérifiez si les cinq sont préservés.
Téléchargez :
Demandez à l’agent de les combiner en un seul rapport.
Vérifiez indépendamment chaque valeur numérique.
Choisissez un sujet avec des informations changeantes.
Exigez :
Création
Demandez un artefact Word, PowerPoint, feuille de calcul ou HTML.
Évaluation :
Demandez une petite application interactive.
Vérifiez :
Confiez une tâche nécessitant plusieurs outils.
Observez si le système :
Lorsque vous comparez Wenxin à d'autres agents, utilisez un tableau plus large qu'un « score de référence ».
| Dimension | Ce qu'il faut mesurer |
|---|---|
| Réussite de la tâche | Le travail demandé a-t-il été terminé ? |
| Mémoire | Les contraintes antérieures ont-elles été conservées ? |
| Précision | Les chiffres et les affirmations sont-ils corrects ? |
| Qualité de la recherche | Les sources sont-elles autoritaires et actuelles ? |
| Fiabilité des outils | Les appels d'outils réussissent-ils de manière cohérente ? |
| Qualité des artefacts | Les fichiers sont-ils utilisables sans réparation manuelle ? |
| Récupération | L'agent peut-il corriger les étapes échouées ? |
| Latence | Combien de temps prend une tâche complète ? |
| Coût | Combien coûte un résultat accepté ? |
| Confidentialité | Comment sont traités les fichiers téléchargés et la mémoire ? |
| Disponibilité | Les fonctionnalités clés sont-elles gratuites, limitées par quota ou payantes ? |
Cela donne une image plus réaliste qu'un simple rang dans un classement.
Le point le plus fort de l'article source est plus large que Baidu.
La concurrence entre agents est en train de redéfinir la notion de qualité en IA.
Pour la première génération de chatbots, les utilisateurs se concentraient sur la qualité des réponses.
Pour les agents de tâches actuels, les questions clés deviennent :
C'est pourquoi des benchmarks tels que XClaw et PinchBench attirent l'attention.
Ils rapprochent l'évaluation du travail de production.
Il reste encore une longue distance entre un benchmark et un déploiement en entreprise.
Mais la direction est utile :
Benchmark de connaissances
→ benchmark de raisonnement
→ benchmark d'utilisation d'outils
→ benchmark de tâches de bout en bout
→ résultat de production réel
La dernière étape est finalement celle qui compte.
L'instantané SuperCLUE XClaw d'août 2026 donne à l'assistant Wenxin un score global de 97,62, le plaçant en première position parmi les produits présentés. Ses scores par catégorie étaient de 90,28 pour le codage, 99,44 pour la création de contenu, 98,86 pour le traitement des données, 96,44 pour l'analyse de recherche et 100 pour la mémoire.
Cela signifie que Wenxin a obtenu la note maximale sur les tâches de mémoire incluses dans cette évaluation XClaw. Cela ne signifie pas que l'assistant ne peut jamais oublier le contexte dans toutes les conversations réelles possibles.
PinchBench v2 est un benchmark d'agents créé par Kilo qui évalue les systèmes sur des tâches informatiques et des flux de travail du monde réel. La version 2.0 contient 148 tâches et est conçue pour mesurer
exécution de bout en bout plutôt qu’un simple question-réponse.
Dans un instantané du classement de juillet 2026, l’agent de tâches de Baidu est apparu sous le nom Orion Mission Mode avec un meilleur score de 94,6 % et un score moyen de 94,4 %. Les classements évoluent avec le temps, il convient donc d’inclure la date de l’instantané lors de la citation du résultat.
Les pages officielles de Baidu pour Wenxin proposent actuellement des options d’accès gratuit ou d’expérience gratuite, et l’article source indique que les fonctionnalités de tâches présentées étaient disponibles sans abonnement payant. Aucune garantie officielle stable d’un usage illimité permanent pour toutes les fonctionnalités n’a été trouvée, il est donc recommandé de vérifier les quotas actuels directement dans le produit.
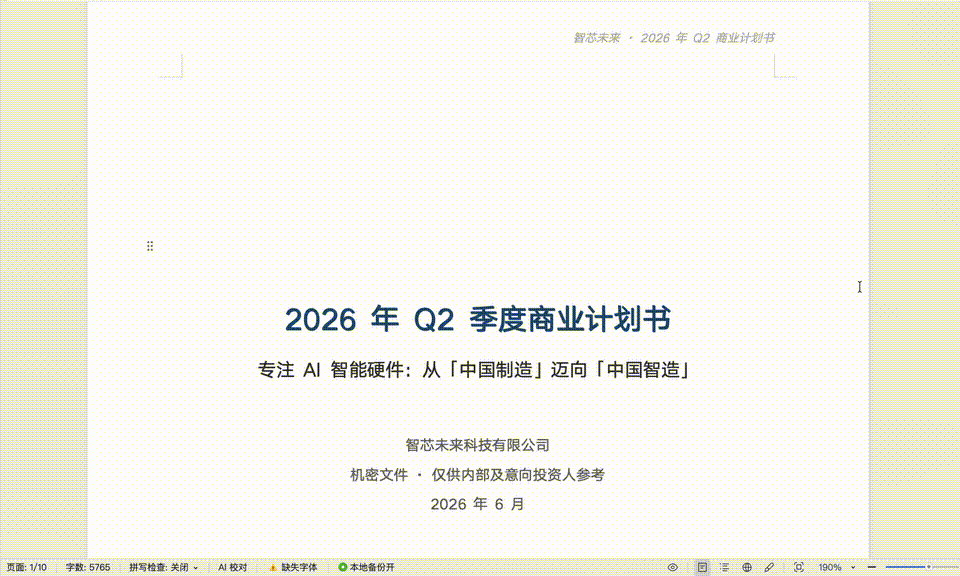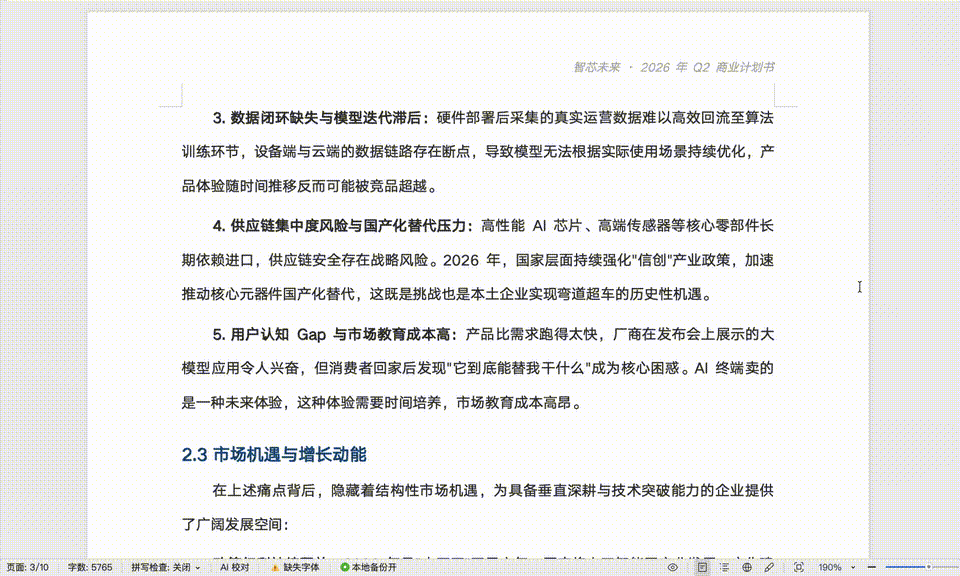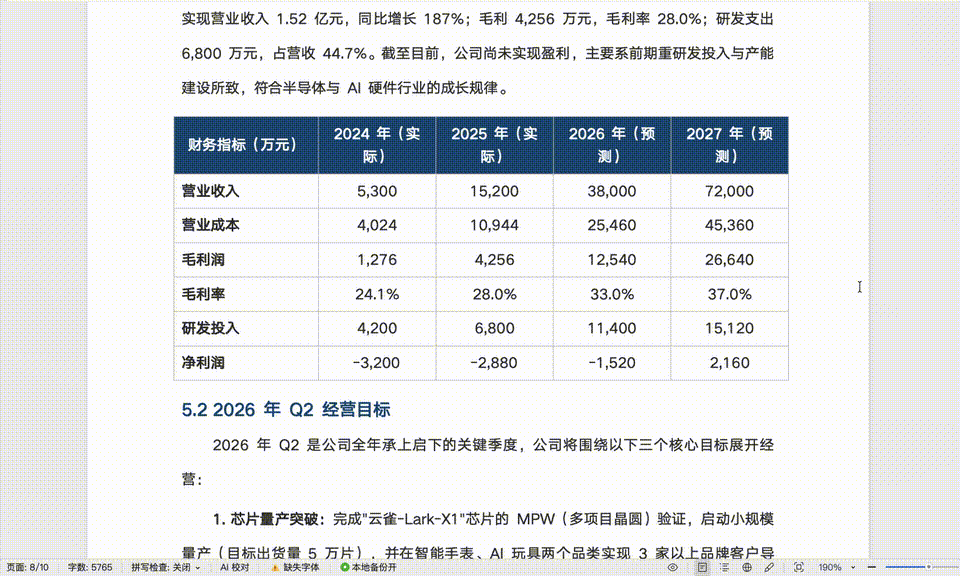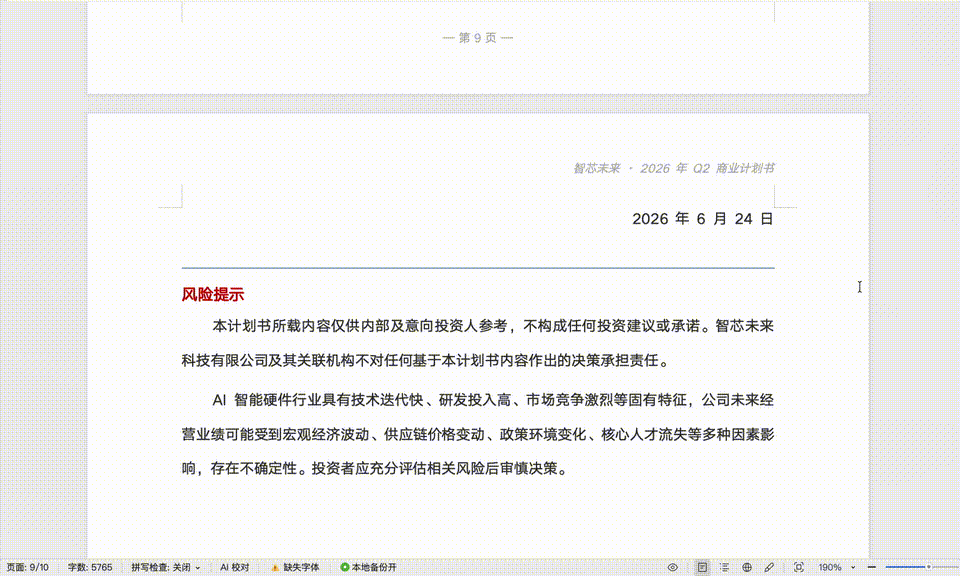
L’article source montre des sessions de test dans lesquelles Wenxin a généré un plan d’affaires Word formaté et des pages HTML interactives. Ces exemples illustrent le flux de travail de l’agent, mais ils ne garantissent pas que chaque invite ou environnement produira le même résultat.
La recherche et les agents partagent des capacités telles que la compréhension de l’intention, la décomposition de la requête, la récupération, le classement, l’agrégation des sources et le contexte de session. Les agents ajoutent une couche d’exécution plus large, incluant les appels d’outils, la création de fichiers, la mémoire, la planification et l’action.
Pas au sens strict. Ils évaluent des produits ou des systèmes d’agents qui peuvent combiner des modèles avec des outils, la mémoire, la recherche, des invites, l’orchestration et des environnements d’exécution. Leurs scores doivent donc être attribués à la configuration complète de l’agent.
Évaluation](https://superclueai.com/xclawpage?category=openclaw&name=SuperCLUE-XClaw%E9%BE%99%E8%99%BE%E4%BA%A7%E5%93%81%E6%B5%8B%E8%AF%84&folder=XClaw&date_if_exists=2026%E5%B9%B48%E6%9C%88) : La page de référence du benchmark citée dans l’article original.
L’assistant Baidu Wenxin s’est classé premier dans l’instantané XClaw de SuperCLUE d’août 2026 avec 97,62 points, dont un score parfait de 100 en mémoire et des scores dépassant 96 dans le traitement des données, la création de contenu et l’analyse de recherche.
Ce résultat fait suite à l’instantané du classement PinchBench v2 de juillet, où le mode Mission Orion de Baidu a enregistré un meilleur score de 94,6 % et un score moyen de 94,4 %. Les benchmarks utilisent des tâches différentes, mais les deux mettent l’accent sur l’achèvement réel des tâches plutôt que sur la simple réponse à des questions.
La conclusion la plus forte n’est pas qu’un assistant a définitivement « gagné » la course des agents. Les classements des agents évoluent rapidement, et les systèmes mesurés incluent des modèles, des outils, la recherche, la mémoire, des invites et l’orchestration.
Ce que montrent ces deux résultats, c’est que l’évaluation de l’IA évolue vers un standard plus pratique : non pas si le modèle semble intelligent, mais si l’agent peut accomplir le travail et rendre un résultat utilisable.
Partez d’une phrase et obtenez un site complet en quelques minutes.



