Nom : Déploiement - Environnement de production Description : Valider et déployer l'application en environnement de production. --- 1. Lire ...
checklist.md.scripts/verify-release.sh.Le mécanisme important est la divulgation progressive.
Claude voit une brève description qui l'aide à décider si une compétence est pertinente. Le corps complet de la compétence et les fichiers de support ne sont chargés que lorsque le processus est nécessaire.
Mukta compare cela à une bibliothèque.
Une personne n'a pas besoin de mémoriser chaque livre avant de commencer une conversation. Elle a seulement besoin de savoir quel livre pourrait contenir des informations pertinentes, et de le sortir au moment approprié.
Les compétences aident à résoudre le problème du « fichier de contexte en constante expansion » :
CLAUDE.md.La documentation officielle des compétences d'Anthropic recommande de créer une compétence lorsque les équipes collent à plusieurs reprises les mêmes instructions, listes de contrôle ou processus en plusieurs étapes dans les conversations, ou lorsqu'une section de CLAUDE.md est devenue un processus plutôt qu'un fait concis.
Les compétences sont réutilisables, mais quelqu'un doit encore décider :
Les agents peuvent aider à rédiger et maintenir les compétences, mais le système repose encore en partie sur la gestion humaine.
Cela mène à une quatrième approche.
Mukta décrit la mémoire basée sur le système de fichiers comme le modèle qu'Anthropic privilégie actuellement dans de nombreux systèmes de mémoire d'agents.
La justification est très pragmatique.
Les agents savent déjà bien :
grepPlutôt que d'inventer une interface mémoire hautement spécialisée, les équipes peuvent organiser la mémoire sous forme de fichiers et fournir aux agents des outils de système de fichiers ordinaires.
Une disposition possible est la suivante :
memory/
├── organization/
│   ├── principles.md
│   ├── terminology.md
│   └── security-policy.md
├── teams/
│   ├── engineering/
│   │   ├── architecture.md
│   │   └── release-process.md
│   └── support/
│       ├── escalation-rules.md
│       └── response-style.md
├── projects/
│   └── billing-redesign/
│       ├── decisions.md
│       ├── known-issues.md
│       └── current-status.md
└── agents/
    └── agent-104/
        └── scratchpad.md
Cette disposition prend en charge différents niveaux de mémoire :
Elle illustre également la divulgation progressive.
L'agent peut rechercher dans les répertoires et ne charger que les fichiers pertinents pour la tâche en cours.
L'interface de type système de fichiers n'exige pas que chaque mémoire d'entreprise existe sous forme de fichiers non gérés sur un ordinateur portable.
L'implémentation sous-jacente peut toujours utiliser :
Le point clé est que l'agent reçoit une abstraction simple et navigable.
Lors de la session de questions-réponses, un membre du public a demandé si cela revenait à réinventer la base de données.
Mukta a reconnu que cette architecture revenait à des principes familiers du génie logiciel. Une fois que les équipes comprennent quels comportements doivent être déterministes, elles peuvent les déplacer dans un cadre de contrôle, plutôt que de laisser le modèle improviser à chaque fois.
Un dossier rempli de fichiers Markdown peut fonctionner pour un utilisateur unique.
Mais lorsque des milliers d'agents peuvent tous mettre à jour une mémoire organisationnelle partagée, cela devient dangereux.
Mukta a souligné quatre principes de production :
Chaque mise à jour de mémoire doit avoir un historique.
Les métadonnées utiles incluent :
Les entrées de mémoire sans provenance sont difficiles à fiabiliser.
Supposons qu'un agent ajoute :
- Les déploiements de production du vendredi ne nécessitent pas d'approbation.
Sans source, relecteur ni historique de révision, un autre agent pourrait traiter cette déclaration comme faisant autorité.
Le contrôle de version prend en charge :
Un système de mémoire versionné doit pouvoir répondre facilement :
Quelle interaction a conduit à l'apparition de cette règle ?
Deux agents peuvent avoir lu la même mémoire à 10:00.
L'agent A écrit une mise à jour à 10:02.
L'agent B, ignorant ce changement, écrit sa propre version à 10:03 et supprime accidentellement la mise à jour de l'agent A.
Mukta décrit un modèle de concurrence basé sur le hachage :
L'agent lit la mémoire et enregistre le hachage A
        ↓
L'agent rédige une mise à jour
        ↓
L'agent relit la mémoire et enregistre le hachage B
        ↓
Si le hachage A == le hachage B :
    Soumettre la mise à jour
Sinon :
    Recharger, re-baser et réessayer
C'est le contrôle de concurrence optimiste.
Le modèle peut décider quel changement proposer, mais le cadre de contrôle doit empêcher de manière déterministe qu'une écriture obsolète remplace une version plus récente.
Tous les agents ne devraient pas être autorisés à modifier chaque mémoire.
Un modèle de permissions raisonnable pourrait être :
| Portée de la mémoire | Accès typique |
|---|---|
| Principes organisationnels | Lecture seule pour la plupart des agents ; écriture uniquement via un processus de validation |
| Politique de sécurité | Lecture seule pour les agents concernés ; écriture limitée par contrôle humain |
| Processus d'équipe | Lecture seule pour l'équipe ; écriture par les mainteneurs désignés |
| Décisions de projet | Lecture seule pour les agents du projet ; modifications proposées soumises à approbation |
| Zone de brouillon des agents | Lecture/écriture par un seul agent |
| Préférences utilisateur | Accès par les agents du périmètre utilisateur |
| Contexte client sensible | Accès strict basé sur les rôles |
Un agent ne devrait pas pouvoir transformer une observation incertaine en règle organisationnelle.
Les limites de permissions doivent également s'appliquer au Dreaming. Les tâches d'intégration ne peuvent recevoir que les enregistrements de conversation et les mémoires pour lesquels leur identité est autorisée.
La mémoire peut devenir l'un des atouts d'IA les plus précieux d'une organisation.
Elle contient :
Mukta estime que les équipes devraient éviter de concevoir cet actif pour qu'il ne fonctionne qu'à l'intérieur d'un seul produit.
Un système de mémoire portable doit disposer :
La portabilité permet au même contexte soigneusement organisé de prendre en charge :
Même les outils de mémoire bien conçus présentent deux limites structurelles.
L'agent doit à la fois accomplir la tâche et organiser la mémoire.
L'écriture en mémoire consomme des ressources qui pourraient autrement servir à l'objectif actuel.
L'agent peut :
Contrainte n° 2 : un agent ne voit qu’une seule session
Un agent peut remarquer qu’une commande a échoué une fois.
Il ne peut pas voir que la même commande a échoué dans 300 autres sessions.
Un agent de support peut voir qu’un client est confus au sujet d’une politique.
Il ne peut pas voir que la même confusion se répète à l’échelle de toute la région.
Un mécanisme d’apprentissage à l’échelle du système nécessite un processus doté d’une visibilité plus large.
Ce processus est ce qu’Anthropic appelle le « Rêve » (Dreaming).
Le Rêve est un processus asynchrone qui examine l’historique des agents une fois le travail normal terminé.
Dans les notes de version actuelles de l’API d’Anthropic, la fonctionnalité « Rêve » des agents hébergés Claude est décrite comme un aperçu de recherche.
Un « Rêve » lit :
Il crée ensuite un stockage de mémoire de sortie réorganisé, dans lequel il peut :
Il ne s’agit pas d’un réentraînement du modèle.
Les poids du modèle sous-jacent ne changent pas.
L’amélioration provient de la modification du contexte persistant, afin que les futures sessions puissent récupérer ces contenus.
Mukta utilise une école pour expliquer la différence entre la mémoire ordinaire et le « Rêve ».
Imaginez :
Un enseignant peut aider un élève à corriger une erreur.
Le directeur pédagogique, lui, peut remarquer que tous les élèves de géographie commettent la même erreur sur un même point, parce que ce contenu est tout simplement absent du programme.
La correction au niveau du système ne consiste pas à corriger chaque copie individuellement.
Elle consiste à mettre à jour le programme.
Dans le vocabulaire des agents :
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Cela permet au système d’apprendre à partir de schémas qu’un agent individuel ne peut pas percevoir.
Le pipeline simplifié du traitement par Rêve se présente comme suit :
Organigramme TD
    A[Stockage de mémoire existant] --> D[Orchestrateur du Rêve]
    B[Enregistrements de sessions] --> D
    C[Appels d’outils et métadonnées] --> D
    D --> E1[Agent d’évaluation 1]
    D --> E2[Agent d’évaluation 2]
    D --> E3[Agent d’évaluation 3]
    E1 --> F[Aggrégateur de schémas]
    E2 --> F
    E3 --> F
    F --> G[Modifications de mémoire proposées]
    G --> H{Approbation humaine}
    H -->|Acceptée| I[Stockage de mémoire mis à jour]
    H -->|Rejetée| J[Conserver la mémoire existante]
Le processus d’évaluation peut examiner bien plus que les messages de l’utilisateur et de l’assistant.
Les éléments de preuve utiles incluent :
L’agent du Rêve recherche ensuite des schémas tels que :
Mukta mentionne que la conception d’Anthropic peut inclure des exemples d’enregistrements de sessions pertinents ainsi que des statistiques montrant la fréquence des schémas observés.
Ces éléments de preuve aident les humains à juger si les modifications de mémoire proposées sont raisonnables.
Le processus de Rêve dispose d’un accès étendu et peut influencer le comportement futur de l’ensemble du cluster d’agents.
Cela rend les mises à jour automatiques et non vérifiées risquées.
Un flux de travail plus sûr est le suivant :
Par exemple :
## Mise à jour de mémoire proposée

**Cible :** `teams/engineering/test-process.md`

**Problème observé :**
Les agents ont utilisé la commande de test unitaire pour exécuter des tests d’intégration dans 18 des 63 sessions concernées.

**Preuves :**
Sessions `s-102`, `s-111`, `s-118`, `s-124`, …

**Ajout proposé :**
- Utiliser `npm run test:integration` pour tous les tests nécessitant des conteneurs de base de données.
- Ne pas utiliser `npm test` pour les fichiers sous `tests/integration/`.

**Niveau de confiance :** Élevé

**Décision humaine :** En attente
Cela préserve la supervision humaine tout en permettant au cluster d’agents d’effectuer l’essentiel du travail d’analyse.
Le Rêve nécessite des appels de modèle supplémentaires.
À première vue, cela semble être une dépense inutile.
Mukta soutient qu’un stockage de mémoire plus propre réduit les coûts totaux, car les futurs agents sont plus susceptibles de réussir du premier coup.
Du premier coup.
Une comparaison économique utile est la suivante :
Coût du rêve
contrasté avec
Coût des échecs répétés, des tentatives, des retouches et des contextes trop longs
Les économies potentielles peuvent provenir :
Anthropic n’a pas encore publié de référence générique indiquant combien chaque organisation peut économiser. La valeur dépend :
Le « Rêve » génère le plus de valeur lorsque de nombreux agents exécutent des tâches connexes et rencontrent de manière répétée les mêmes schémas.
Une équipe n’a pas besoin d’attendre une intégration complète de plateforme pour tester ce concept.
Une version manuelle peut être exécutée une fois par semaine.
Ne collecter que les enregistrements de conversations que l’examinateur est autorisé à consulter.
Organiser par :
Inclure :
CLAUDE.mdLe prompt peut être rédigé ainsi :
Examinez ces enregistrements de sessions autorisés et les fichiers de mémoire actuels.

Identifiez les échecs récurrents, les corrections répétées par les utilisateurs, les instructions obsolètes,
les processus manquants et les entrées en double.

Pour chaque modification proposée :
1. Indiquez le fichier cible.
2. Fournissez les identifiants de session à l’appui.
3.

Décrivez la fréquence à laquelle ce motif apparaît.
4. Rédigez la modification minimale efficace.
5. Ne modifiez pas directement les fichiers.
Rejetez les modifications suivantes :
Utilisez le contrôle de version et incluez les preuves de provenance dans le journal de commit ou d'audit.
Suivez si les mêmes échecs diminuent dans les sessions ultérieures.
Sans mesure, le « rêve » devient un exercice de génération de documentation, et non un système d'apprentissage.
La mémoire répond à cette question :
Qu'est-ce que l'agent devrait retenir de ses travaux précédents ?
L'ingénierie des graphes structurés répond à une question différente :
Quelles parties de la tâche actuelle dépendent réellement les unes des autres ?
L'article source de BAAI relie le thème de la mémoire à un guide d'ingénierie des graphes qui circule dans la communauté du développement de l'IA.
L'argument central de ce guide est que de nombreux « workflows » sont déjà, par nature, des graphes — simplement mal conçus.
Les workflows écrits sous forme de listes ont tendance à être artificiellement transformés en processus séquentiels :
Recherche
    ↓
Synthèse
    ↓
Comparaison
    ↓
Vérification des faits
    ↓
Rédaction
Certaines de ces étapes dépendent effectivement des sorties précédentes.
D'autres attendent sans nécessité.
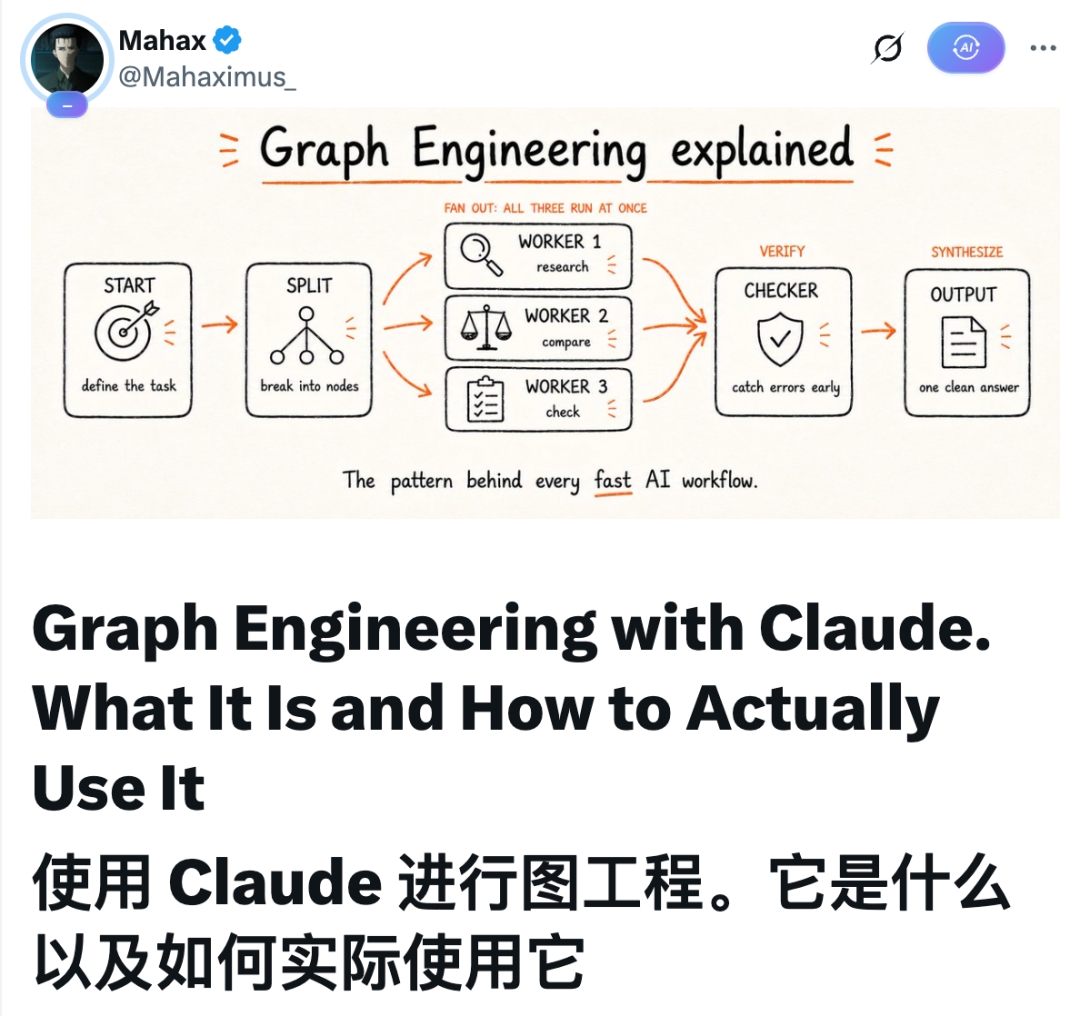
Dans un graphe de workflow :
Par exemple :
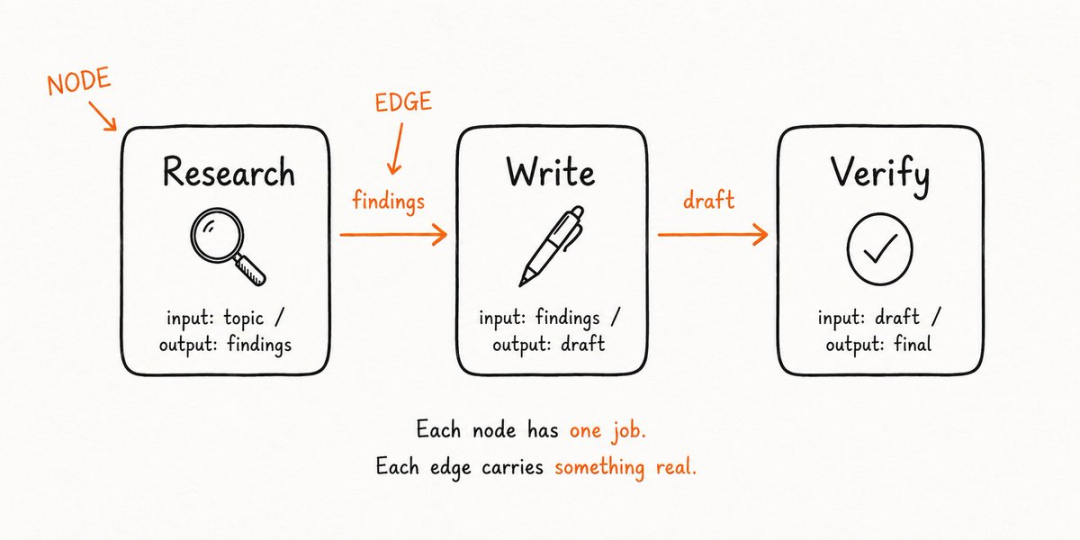
Le nœud de recherche produit des résultats de recherche.
Le nœud de rédaction consomme ces résultats et produit un brouillon.
Le nœud de vérification consomme le brouillon et produit un résultat révisé.
Ces flèches sont justifiées, car chaque nœud en aval a besoin de la sortie du nœud en amont.
Le guide communautaire propose un test simple pour chaque flèche :
La tâche suivante a-t-elle réellement besoin de la sortie de la tâche précédente ?
Si la réponse est non, cette dépendance est une fausse dépendance.
Considérez le workflow suivant :
Rechercher le concurrent A
    ↓
Rechercher le concurrent B
    ↓
Rechercher le concurrent C
    ↓
Rédiger le rapport comparatif
La recherche sur le concurrent B n'exige généralement pas la sortie de la recherche sur le concurrent A.
La recherche sur le concurrent C n'exige généralement pas la sortie de la recherche sur le concurrent B.
Ces tâches peuvent être exécutées en parallèle :
flowchart TD
    A[Définir les critères de comparaison] --> B1[Rechercher le concurrent A]
    A --> B2[Rechercher le concurrent B]
    A --> B3[Rechercher le concurrent C]
    B1 --> C[Rédiger le rapport comparatif]
    B2 --> C
    B3 --> C
Supprimer les fausses arêtes réduit les temps d'attente.
Si les trois recherches prennent respectivement 10, 12 et 15 minutes :
Le graphe ne rend pas chaque agent individuel plus rapide.
Il modifie l'ordonnancement.
Une fois les fausses arêtes supprimées, une forme courante apparaît :
On parle souvent de losange.
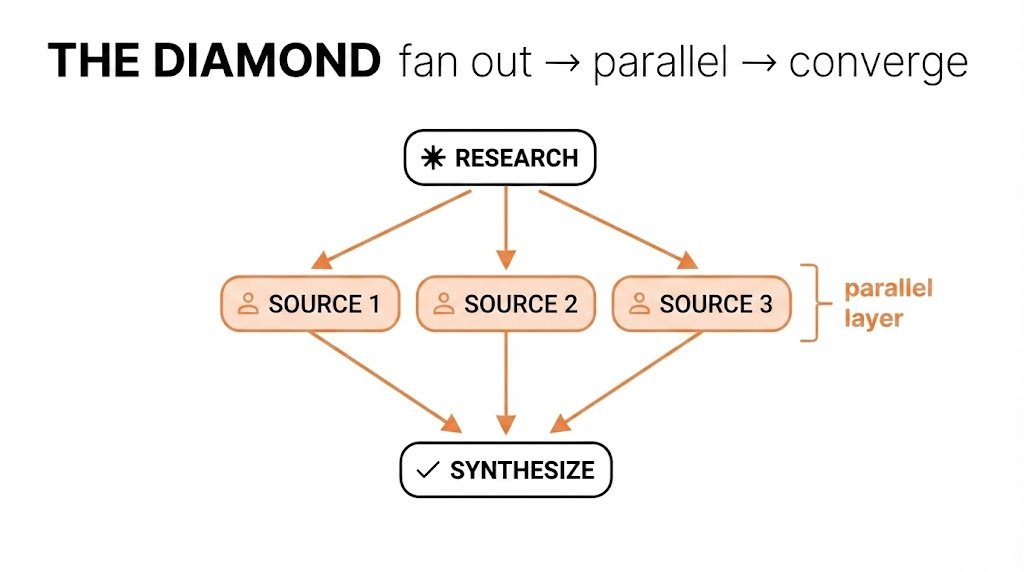
Un exemple de recherche pourrait ressembler à ceci :
flowchart TD
    A[Question de recherche] --> B1[Données de marché]
    A --> B2[Preuves clients]
    A --> B3[Analyse concurrentielle]
    B1 --> C[Vérificateur]
    B2 --> C
    B3 --> C
    C --> D[Synthèse finale]
Le temps total est principalement déterminé par la branche la plus lente, et non par la somme de toutes les branches.
Le parallélisme introduit un nouveau
risque.
Un thread de travail peut produire une sortie faible, obsolète ou non étayée.
Si le système fusionne tout sans vérification, une mauvaise branche peut contaminer la réponse finale.
C'est pourquoi le guide du graphe place un vérificateur avant la synthèse.
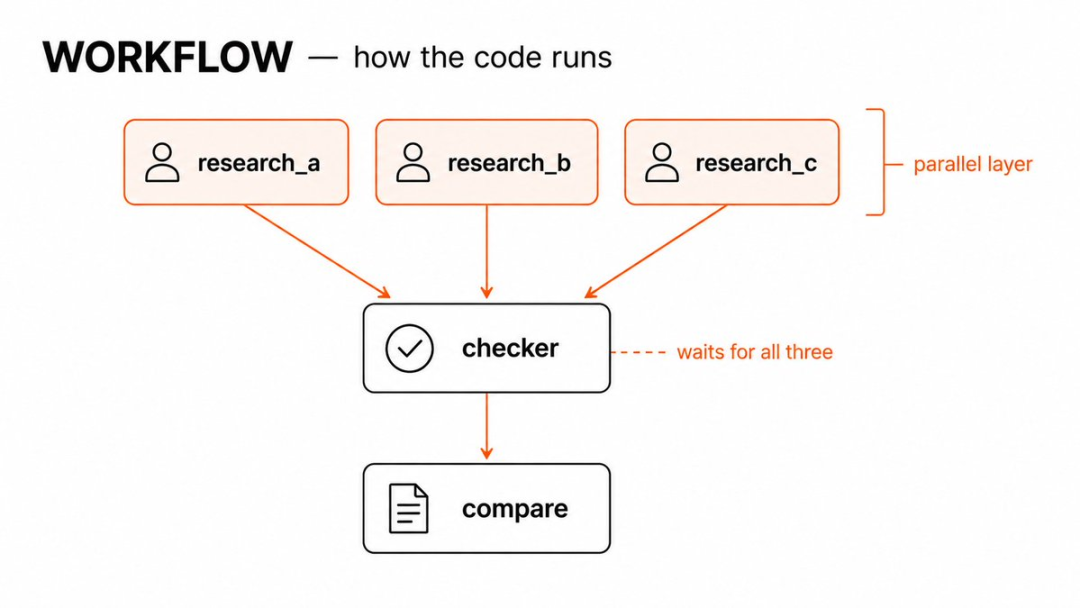
Un vérificateur peut demander :
La sortie respecte-t-elle le format demandé ?
Un vérificateur utile devrait avoir des critères d'acceptation clairs.
Par exemple :
Partez d’une phrase et obtenez un site complet en quelques minutes.



