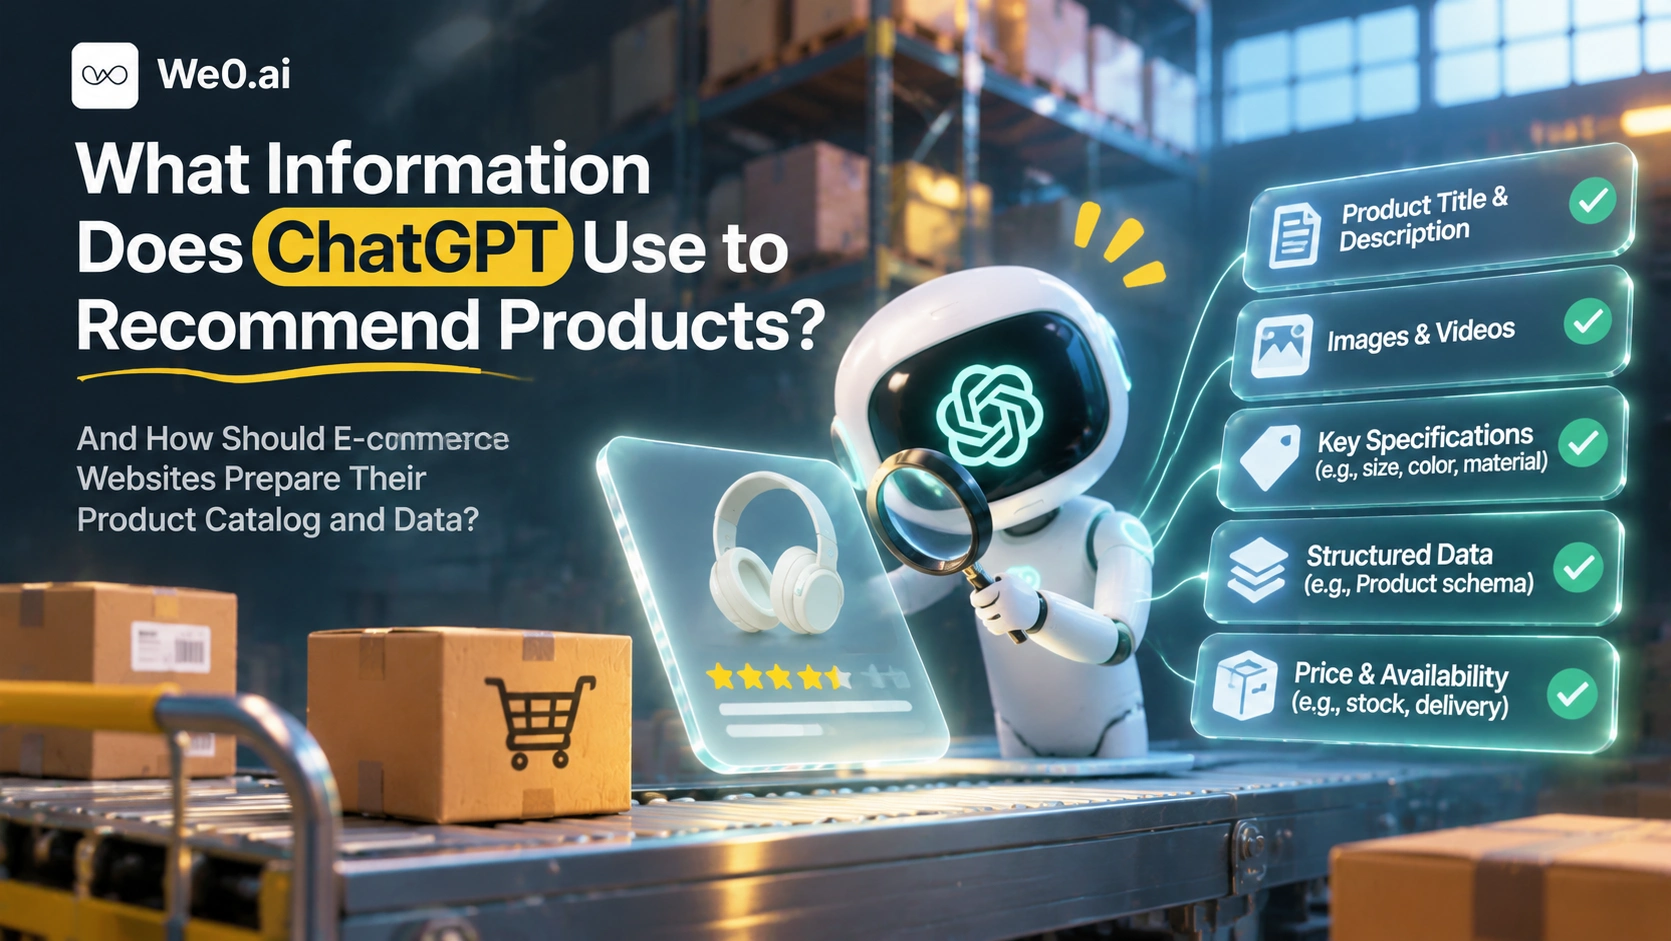
Réponse directe à la question du titre : lorsque ChatGPT recommande des produits, il lit principalement deux types d'entrées.
Le premier est le flux de produits structuré soumis activement par le marchand. Selon les spécifications du flux de produits OpenAI, le flux est la source unique de vérité des données produit ; il couvre le titre, le prix, le stock, les médias et les informations logistiques, et sert à alimenter la recherche de produits, la découverte de produits et, lorsque les conditions sont remplies, le paiement immédiat ; ces données ne sont pas collectées par crawling, mais le marchand pousse un fichier structuré vers un point de terminaison sécurisé, avec des mises à jour à haute fréquence pour garantir l'exactitude (Spécifications du flux de produits ChatGPT).
Le second est l'information de page produit qu'il peut analyser sur le web public : nom du produit, prix actuel, spécifications techniques, cas d'usage, politiques de livraison et de retour. Les guides d'achat obtenus par les utilisateurs dans des scénarios de recherche d'achat incluent généralement des recommandations de produits populaires, des comparaisons des différences clés, des analyses des avantages et inconvénients, et des liens vers les détaillants (Article sur la fonction de recherche d'achat de ChatGPT).
Ce qui détermine réellement le résultat, ce sont donc deux couches : le flux détermine si votre produit peut entrer dans le pool de candidats, la page produit détermine si vous êtes cité correctement. Une incohérence entre les deux est la source de problèmes la plus courante.
Les trois voies par lesquelles ChatGPT obtient des informations produit
- Recherche d'achat : une recherche conversationnelle orientée vers la décision d'achat, qui commence par clarifier le budget, le destinataire et les fonctionnalités recherchées, puis produit des comparaisons et des recommandations, avec des liens cliquables vers les détaillants dans les résultats.
- Flux de produits : le marchand structure son catalogue et le soumet, formant des entrées produits consultables, comparables et recommandables ; la complétude des champs détermine directement si le produit peut être filtré.
- Publicités dans le flux : le 12 mai 2026, OpenAI a lancé le format publicitaire product feed dans ChatGPT ; le marchand connecte son catalogue, définit des critères de filtrage, et le système génère automatiquement les publicités à partir du nom, de l'image, du prix et des attributs du produit ; selon les rapports, un seul annonceur peut couvrir jusqu'à 1 million de SKU, les nouveaux partenaires e-commerce doivent d'abord soumettre un échantillon de 100 produits, et le fichier de flux utilisé est essentiellement le même fichier structuré que celui soumis à Google Shopping (Article sur le lancement des publicités product feed).
Le point commun des trois voies est clair : les entrées sont des champs structurés, toutes sont sensibles à l'exactitude des données, et aucune ne repose sur la densité de mots-clés.
Qu'est-ce qu'un flux de produits
Un flux est un fichier lisible par machine listant des produits : une ligne par produit ou par variante, des champs fixes, un format fixe, des mises à jour régulières. C'est une chose différente de « rendre la page produit belle ». La page produit sert à la lecture et à la conversion par l'humain ; le flux sert à l'appariement et à la comparaison entre machines.
Les spécifications contiennent un détail facile à négliger : le flux est défini comme la source unique de vérité des données produit. Cela signifie que le titre, le prix et le stock d'un même produit dans le flux doivent correspondre à ce qui est présenté sur la page de destination, sinon la plateforme et l'utilisateur verront deux versions des faits.
Un tableau pour voir clairement quels champs préparer

| Champ | Contenu recommandé | Pourquoi c'est important | Problèmes courants |
|---|---|---|---|
| Product Name | Marque + série + modèle + attributs clés | C'est le premier signal d'appariement avec l'intention de la conversation | Accumulation de mots-clés, modèle manquant, nomenclature incohérente pour un même produit |
| Description | Fonctions principales, cas d'usage, public cible | Détermine si le produit est jugé « adapté à ce besoin » | Même texte copié sur tout le site |
| Price | Prix de vente actuel et devise | Sert à la comparaison de prix et au filtrage | Promotions non synchronisées, base fiscale incertaine |
| Availability | En stock / précommande / rupture | Influence la recommandation et la possibilité de commander | Rester longtemps sur « en stock » |
| Variants | Couleur, taille, capacité, modèle | Détermine si les variantes peuvent être appariées individuellement | Produit parent et SKU enfant mélangés |
| Specifications | Paramètres techniques sous forme clé-valeur | Soutient les questions de comparaison de paramètres | Descriptions en longues phrases, unités non uniformes |
| Policies | Conditions de retour, livraison, garantie | Influence la confiance et la décision finale | Politiques incohérentes entre la page et le flux |
| Images | Image principale, vues multiples, images de contexte | Influence l'affichage et le clic | Texte promotionnel sur l'image principale |
Nom, prix et stock doivent être cohérents
Illustrons avec le cas d'une boutique d'électronique. Le même modèle « AuraSound NC-700 écouteurs sans fil à réduction de bruit » apparaît à trois endroits : le site officiel affiche 1299 yuans et en stock, le flux produit indique encore 1499 yuans et marque une rupture de stock, et une plateforme tierce affiche 1199 yuans. Lorsqu'un utilisateur demande « des recommandations d'écouteurs à réduction de bruit à moins de 1500 yuans », le système peut l'ignorer parce que le prix du flux dépasse le budget, ou le recommander parce qu'il lit 1299 yuans sur la page officielle, mais afficher une autre information au moment de l'atterrissage.
Trois solutions : converger le prix et le stock vers une source de données principale ; horodater les mises à jour du prix et du stock, et décider quelle donnée est valide selon l'horodatage ; exécuter une vérification de cohérence multicanale avant la mise en ligne, en comparant un par un les quatre types de champs : nom, prix, stock et lien.
Comment organiser les variantes et les spécifications
Définissez d'abord clairement « ce qu'est un produit », puis parlez des données. Pour les produits à spécifications multiples, recommandez une structure parent-enfant : le produit parent représente le style ou la série, le SKU enfant représente la couleur, la capacité ou le modèle spécifique, et le prix et le stock sont rattachés au SKU enfant. Les noms d'attributs et les unités doivent être uniformes, par exemple l'autonomie de la batterie en « heures », le poids en « grammes », en évitant qu'un même paramètre apparaisse sous des formes mélangées comme « environ 30 h », « environ 30 heures », « 1,2 kg/1200 g ». Utilisez des paires clé-valeur pour les spécifications, ne les enfouissez pas dans une longue description.
Le rôle des images et des descriptions produit

Les trois premières lignes de la description doivent répondre à : qu'est-ce que c'est, à qui cela s'adresse, quel problème cela résout ; ensuite seulement développez les détails. La rédaction vraiment efficace consiste à préciser clairement les scénarios d'utilisation, le public et les limites, par exemple « adapté aux trajets domicile-travail et aux vols long-courriers, la réduction de bruit active est efficace contre les bruits à basse fréquence, ne convient pas aux scénarios de cyclisme nécessitant la perception des sons environnants ». L'accumulation de mots-clés n'apporte presque aucun bénéfice dans l'appariement des grands modèles, et réduit au contraire la lisibilité. Concernant les images, gardez l'image principale propre, sans texte promotionnel ; les vues multiples et les images de contexte avec référence d'échelle aident à juger de la taille et de la forme.
Faut-il des données structurées sur la page produit
Oui, mais il ne faut pas s'y fier uniquement. La page produit doit baliser Product et Offer de schema.org, compléter si nécessaire par les évaluations et les questions fréquentes, et garantir que le prix et le stock de la page correspondent exactement au flux. Vérifiez également que ces informations sont accessibles dans le HTML initial, et non uniquement après le rendu par script front-end ; chaque produit doit avoir une URL indépendante stable et accessible à long terme, et les variantes doivent être distinguées par des liens canoniques plutôt que toutes pointer vers la même adresse.
Creez un site vitrine et genere des leads en quelques minutes
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Comment permettre à l'IA de mieux comprendre les différences entre produits
Les produits similaires ont tendance à se confondre. La méthode consiste à transformer les différences en échelles comparables et en attributs booléens : placez trois écouteurs sur le même ensemble de dimensions de paramètres (profondeur de réduction de bruit, autonomie, poids, version Bluetooth, support du multipoint), et ajoutez pour chacun une phrase « à qui cela ne convient pas ». Pour les produits de générations successives, indiquez explicitement la différence avec la génération précédente, par exemple « le NC-700 offre une autonomie accrue et un poids réduit par rapport au NC-600 ». Pour les modèles de même nom avec des configurations différentes, assurez-vous d'inclure un identifiant distinctif dans le titre, et ne laissez pas deux SKU différents partager le même nom.
Comment synchroniser les changements de prix et de stock
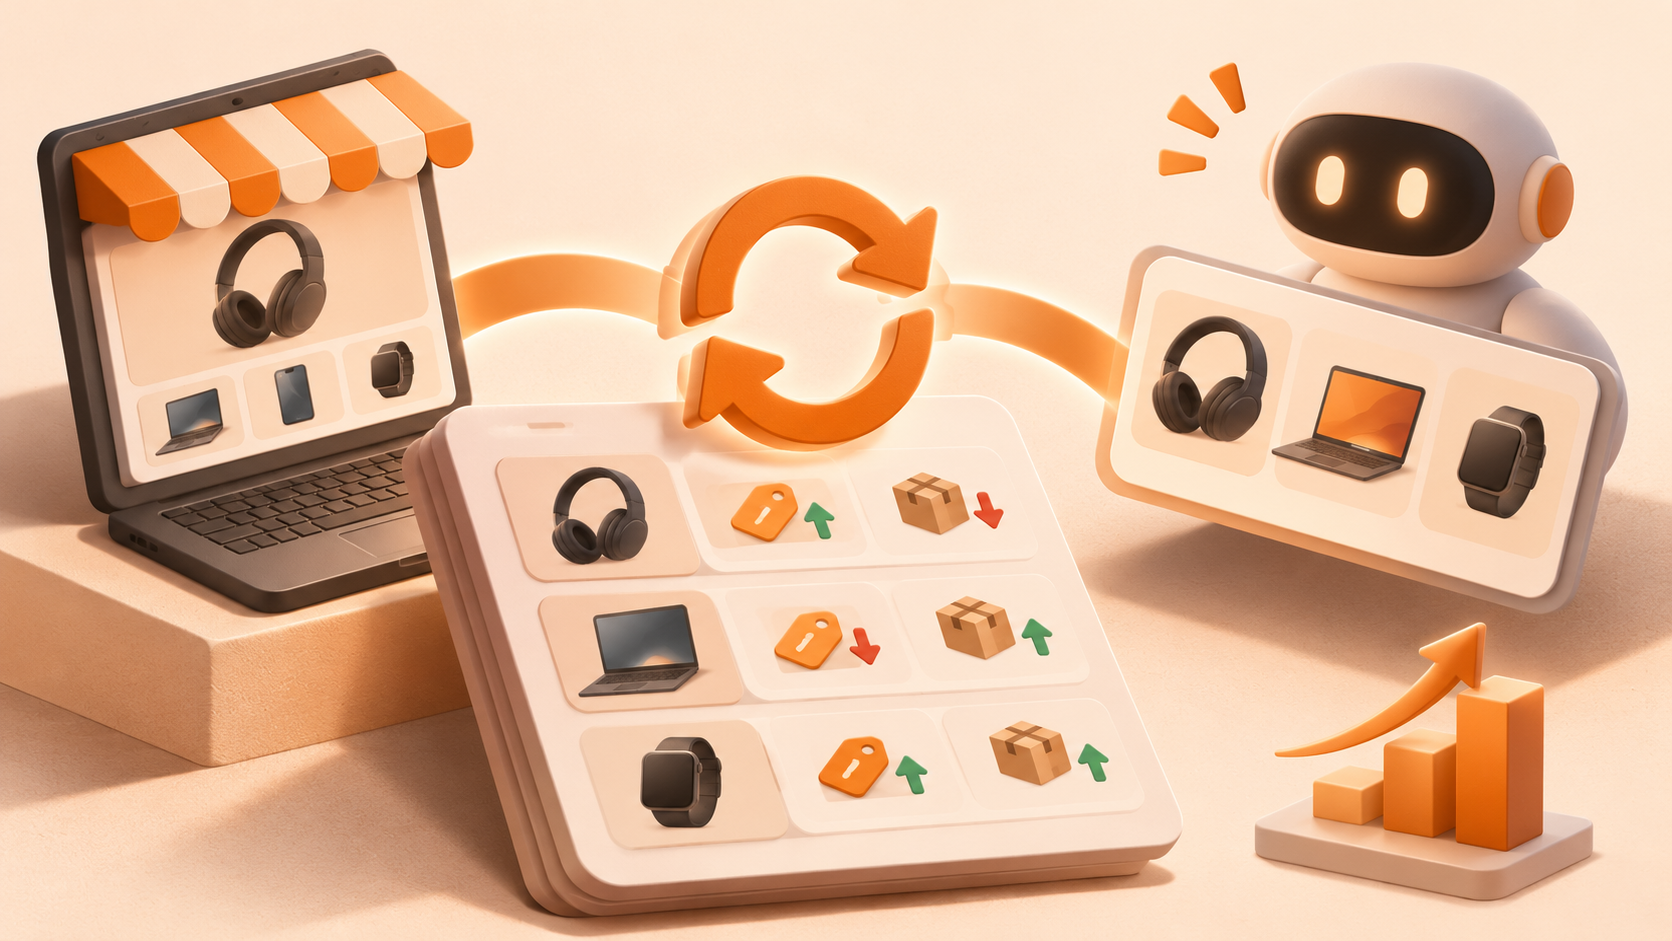
La synchronisation doit passer par la chaîne, pas par des modifications manuelles. Premièrement, les modifications de prix et de stock passent uniformément par l'écriture en back-office dans les données produit principales ; il n'est pas permis de modifier directement le fichier d'export. Deuxièmement, le flux de produits externe et l'affichage de la page sont générés à partir des données principales, les deux provenant de la même écriture. Troisièmement, distinguez les fréquences de mise à jour : prix et stock à haute fréquence, descriptions et spécifications à basse fréquence, pour éviter les secousses dues à des republications complètes. Quatrièmement, conservez l'historique des modifications et la capacité de restauration, afin de pouvoir revenir à une version stable précédente en cas d'anomalie. Cinquièmement, établissez des indicateurs de surveillance, par exemple le taux de champs manquants, le nombre d'écarts de prix entre canaux, le temps écoulé depuis la dernière mise à jour.
Établir une source de données produit unifiée : mise en œuvre en cinq étapes
- Inventaire : listez où se trouvent actuellement les données produit (back-office du site officiel, ERP, tableurs, centres vendeurs des plateformes), et identifiez laquelle est la référence.
- Modélisation : définissez un dictionnaire de champs, en précisant les champs obligatoires, les types, les unités et les énumérations de valeurs.
- Convergence des écritures : ne conservez qu'un seul point d'entrée d'écriture, les autres systèmes récupèrent les données via des interfaces, plutôt que de maintenir chacun sa propre copie.
- Export multicanal : utilisez la même source de données principale pour générer l'affichage de la page produit, le fichier de flux et les données des plateformes tierces, avec une maintenance centralisée des mappages de champs.
- Vérification et surveillance : comparaison avant la mise en ligne, surveillance après, traitez les incohérences comme des défauts, et non comme des corrections temporaires par les opérations.
La liste de décisions associée peut être définie ainsi : autorise-t-on les opérations à modifier directement les prix, jusqu'à quel niveau découper les variantes, faut-il conserver les produits en rupture dans le flux, qui maintient les clauses de politique, quelle est la solution de repli en cas d'échec de poussée du flux.
Ce que les entreprises doivent faire maintenant
- Corrigez d'abord les données, puis parlez des canaux. Améliorez la complétude des titres, catégories, images, prix et stocks de produits ; c'est la condition préalable à tous les scénarios de recommandation automatique.
- Traitez les données produit comme une entrée lisible par machine, et non comme un ensemble de mots-clés destinés aux moteurs de recherche : scénarios, publics, étiquettes d'attributs sont plus utiles que l'empilement de synonymes.
- Établissez une mesure des sources de référence, observez séparément la performance des visites provenant d'entrées conversationnelles en termes de taux de conversion et de panier moyen, puis décidez de l'investissement.
- Faites partager la même source de données principale à la page produit et au flux, et faites de la cohérence une contrainte de processus.
La boutique e-commerce indépendante de We0 permet de maintenir les produits, catégories, spécifications et stocks dans un même back-office ; le back-office CMS permet de mettre à jour en continu le contenu produit ; la génération de code full-stack permet de personnaliser les interfaces de données produit et la logique de synchronisation selon les besoins ; l'optimisation SEO et GEO sert à organiser la structure d'information et les paragraphes citables des pages produit (Boutique e-commerce indépendante We0). Il faut préciser que la connexion directe au flux de produits OpenAI implique des qualifications, des points de terminaison et des mappages de champs, et nécessite encore une validation et un développement séparés ; elle ne peut pas être considérée comme une capacité intégrée.
Questions fréquentes
ChatGPT va-t-il crawler activement mon site e-commerce ?
La voie du flux de produits repose sur un fichier structuré poussé activement par le marchand, et non sur du crawling (spécifications). Les informations produit sur le web public peuvent en revanche être indexées et citées, donc la page produit doit toujours énoncer clairement les faits.
Le nom, le prix et le stock du produit doivent-ils être exactement identiques au flux ?
Oui. Le flux est défini comme la source unique de vérité des données produit ; une incohérence entre le prix, le stock et la page de destination affecte directement la recommandation et l'expérience de commande.
Sous quelle forme faut-il organiser les spécifications produit ?
Sous forme de paramètres techniques en paires clé-valeur, avec des noms d'attributs et des unités uniformes ; n'insérez pas les paramètres dans de longs paragraphes, et n'inventez pas un ensemble de champs distinct pour chaque couleur.
Les données structurées suffisent-elles ?
Non. Les données structurées aident la machine à analyser correctement la page produit, mais l'entrée du produit dans le pool de candidats dépend aussi de la soumission d'un flux de produits complet ; les deux doivent partager la même source de données principale.
Comment synchroniser un changement de prix ?
Écrivez dans les données produit principales depuis le back-office, générez simultanément l'affichage de la page et le fichier de flux à partir des données principales, et conservez l'horodatage de mise à jour, l'historique des modifications et une solution de restauration, pour éviter de modifier manuellement le fichier d'export.
Outils associés
- Back-office de boutique e-commerce indépendante : maintenance unifiée des produits, catégories, variantes et stocks
- Back-office CMS : mise à jour continue des descriptions produit, politiques et pages de contenu
- Génération de code full-stack : personnalisation des interfaces de données produit et de la logique de synchronisation
- Optimisation SEO et GEO : organisation de la structure d'information des pages produit et des paragraphes citables
- Vérification des données structurées : contrôle de la cohérence entre les balisages Product et Offer et la page
Liens associés
- Spécifications du flux de produits ChatGPT (Lengow)
- Article sur la fonction de recherche d'achat de ChatGPT (China.com Logiciel)
- Article sur le lancement du format publicitaire product feed par OpenAI (Stellagent)
- Boutique e-commerce indépendante We0
Résumé
Lorsque ChatGPT recommande des produits, il lit des faits produits structurés : le flux de produits poussé par le marchand détermine si le produit peut entrer dans le pool de candidats, et les informations de page produit analysables publiquement déterminent si le produit est cité avec exactitude. Ce qu'un site e-commerce doit faire, ce n'est pas optimiser la densité de mots-clés, mais converger nom, prix, stock, variantes, spécifications, images et politiques vers une source de données principale unifiée, générer simultanément l'affichage de la page et le flux, et garantir la cohérence multicanale par la vérification et la surveillance. La connexion directe du flux et l'intégration publicitaire sont des chantiers distincts, qui nécessitent une validation séparée selon les exigences de la plateforme.