For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/claude-cowork-mobile-web-agent-harness.md.
Le support mobile et Web de Claude Cowork est bien plus qu'une simple mise à jour d'interface produit. Il montre que le travail des agents d...
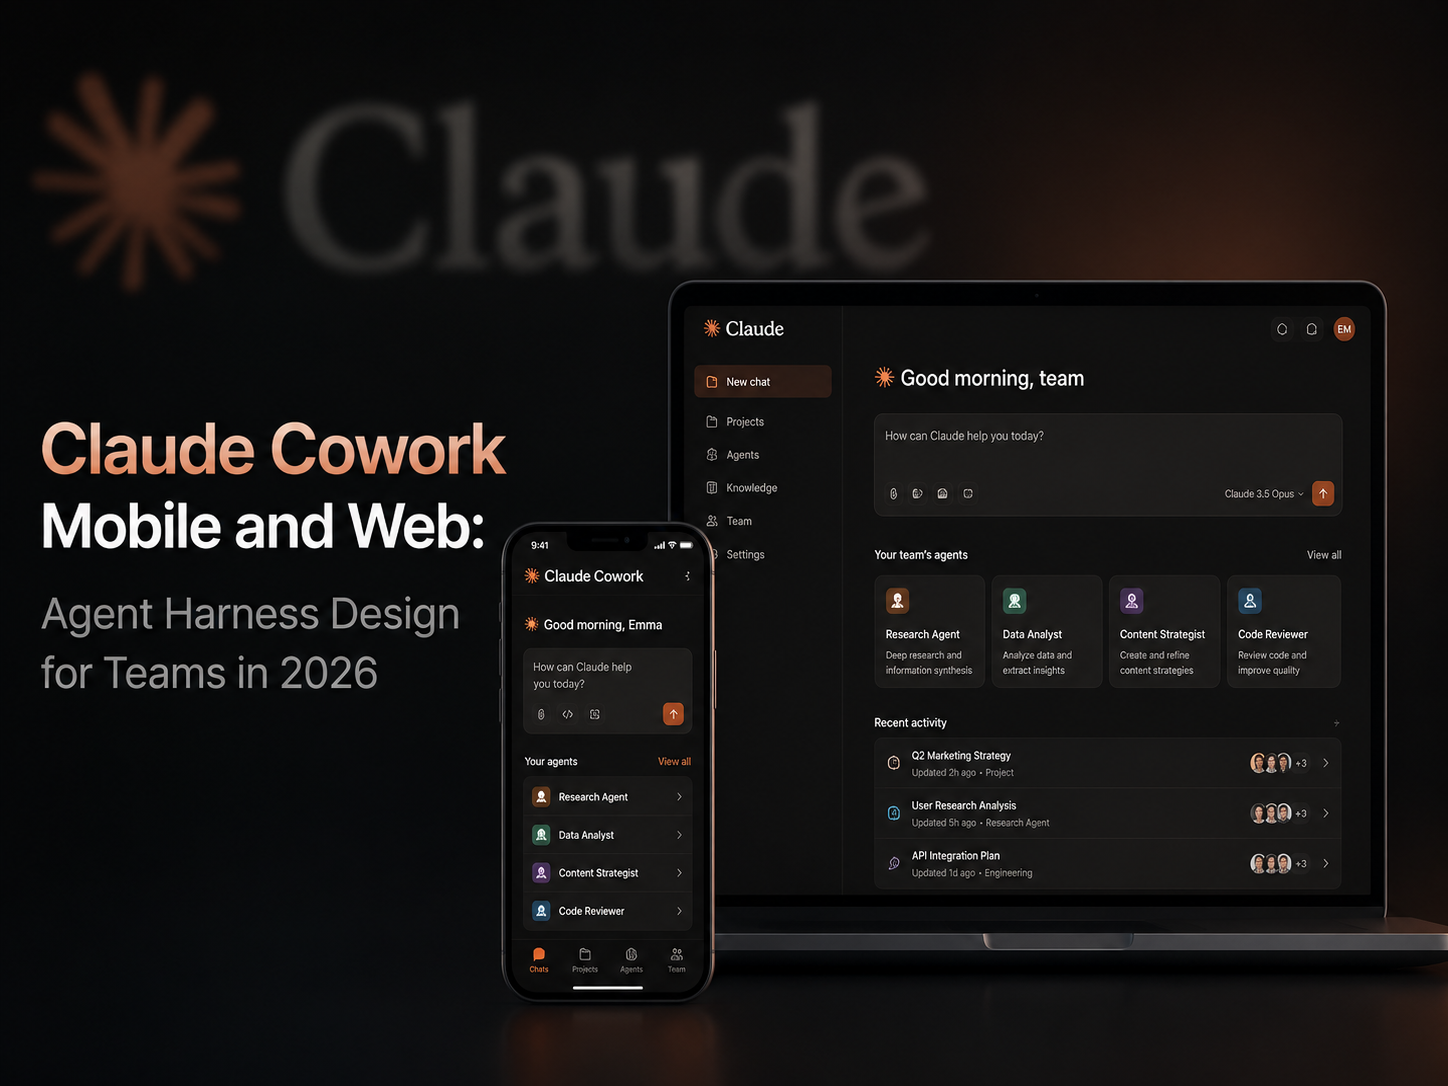
La mise à jour de Claude Cowork d'Anthropic semble simple au premier abord : Cowork s'étend au-delà du bureau pour devenir disponible sur le web et le mobile également. Mais le véritable signal est plus important qu'une nouvelle interface.
Lorsqu'un agent peut continuer à travailler après qu'un utilisateur a quitté son bureau, le produit n'est plus seulement une fenêtre de chat. Il devient un fil de tâches persistant. L'utilisateur peut démarrer une tâche sur son bureau, vérifier l'avancement sur un téléphone, répondre à une demande de clarification depuis un autre appareil, et revenir plus tard pour examiner un artefact.
Ce changement est important pour les équipes utilisant Claude Cowork, Claude Code, Codex, Cursor, GitHub Copilot, NxCode, ou des agents internes. La question n'est plus seulement "Le modèle peut-il résoudre la tâche ?" La meilleure question est : Le système autour du modèle peut-il contrôler le contexte, les outils, l'état, les autorisations, les journaux, la validation et la revue humaine ?
Claude Cowork s'étend d'un flux de travail centré sur le bureau à une expérience web et mobile. L'utilisateur peut démarrer une tâche sur un ordinateur, laisser Claude continuer en arrière-plan, vérifier le statut depuis un téléphone, et revenir plus tard pour examiner le résultat.
Cela change le modèle mental.
Un chatbot attend le message suivant. Un outil de complétion de code suggère la ligne suivante. Un agent en arrière-plan continue de travailler après que l'utilisateur s'est éloigné. Cela signifie que les équipes ne peuvent pas placer toute la gouvernance dans une seule session de bureau ou une seule fenêtre de terminal visible.
La page produit de Cowork d'Anthropic met également l'accent sur le contrôle. Les utilisateurs choisissent les dossiers et les outils, et les administrateurs d'entreprise peuvent configurer l'accès et les autorisations. Cela est important car le travail multi-appareils n'est utile que s'il ne transforme pas accidentellement chaque pression sur un téléphone en une large autorisation.
Pour les équipes d'ingénierie, la leçon n'est pas "déplacer chaque tâche sur mobile". La leçon est que le travail délégué devient durable. Les tâches se poursuivront à travers les onglets, les appareils, les réunions, les notifications et les changements de contexte humain. Le modèle opérationnel doit supposer que le travail peut continuer après la première invite.
Un harnais d'agent est le système autour du modèle qui transforme une requête en travail contrôlé.
Il inclut :
Un modèle fort dans un harnais faible peut encore échouer gravement. Il peut lire les mauvais fichiers, utiliser le mauvais outil, faire une grande
changement dangereux, ou produire un résultat qui semble soigné mais ne peut être révisé.
L'expansion mobile et web de Claude Cowork rend le harnais plus visible. La tâche peut commencer sur un ordinateur de bureau, se poursuivre dans le cloud, demander une approbation sur mobile, et se terminer par des fichiers ou messages prêts pour la révision. Ce flux nécessite un état et des autorisations qui accompagnent la tâche, et non seulement l'appareil.
AWS pousse une idée connexe du côté cloud via Amazon Bedrock AgentCore. Son modèle de harnais se concentre sur l'orchestration, l'exécution des outils, la gestion du contexte, la persistance de l'état, la reprise après panne et les sessions isolées. Les écrits de Lilian Weng sur l'ingénierie des harnais vont dans la même direction d'un point de vue recherche : un meilleur comportement des agents ne vient pas seulement de poids de modèle plus forts, mais aussi de meilleurs environnements, boucles de rétroaction, évaluations, outils et échafaudages.
En termes pratiques, le harnais est l'endroit où les équipes définissent ce que signifie un « bon travail d'agent ».
Les agents multi-appareils ont une valeur évidente.
Un chef de produit peut demander une brève étude client avant de monter dans un train. Un ingénieur peut lancer une investigation de logs, fermer l'ordinateur portable, et approuver un suivi ciblé depuis un téléphone. Un fondateur peut déléguer une mise à jour pour les investisseurs et réviser le brouillon plus tard.
Mais le risque est tout aussi clair. Une tâche qui continue de s'exécuter en arrière-plan peut continuer à utiliser des outils, des fichiers, des applications connectées et du contexte après que l'humain cesse de regarder l'écran.
Les équipes devraient séparer cinq types d'autorités.
| Type d'Autorité | Exemple | Règle par Défaut |
|---|---|---|
| Lire le contexte local | Fichiers du dépôt, docs, notes | Autoriser uniquement les dossiers définis |
| Lire les applications connectées | Slack, email, calendrier, CRM | Utiliser l'approbation par connecteur |
| Écrire des artefacts locaux | Brouillons, branches, feuilles de calcul | Autoriser uniquement avec des diffs révisables |
| Communication externe | Envoyer un email, poster sur Slack, créer un ticket | Exiger confirmation humaine |
| Action destructive ou de production | Supprimer des fichiers, faire tourner des secrets, déployer | Exiger approbation explicite et journaux |
L'accès mobile devrait accélérer la révision, pas l'affaiblir. Un téléphone est utile pour vérifier l'état d'une tâche, répondre à une clarification, ou approuver une étape suivante ciblée. Ce n'est pas le bon endroit pour réviser une grande diff de code, autoriser une migration de production, approuver des changements de facturation, ou accorder un large accès aux données clients.
Une règle opérationnelle simple fonctionne bien :
Le mobile peut diriger, mais une approbation sérieuse devrait avoir lieu là où les preuves sont visibles.
Chaque tâche déléguée a besoin d'une limite écrite.
Un bon périmètre devrait inclure :
Sans ces limites, un agent en arrière-plan n'est qu'une invite longue durée avec des outils attachés. Ce n'est pas un modèle opérationnel sûr.
Un réviseur ne devrait pas avoir à deviner ce que l'agent a fait.
Pour les tâches de code, le rapport final devrait inclure :
pertinent
Pour les tâches de recherche, le rapport final doit inclure :
L'objectif est de rendre le travail de l'agent vérifiable. Une réponse soignée ne suffit pas.
Toutes les tâches n'ont pas besoin du même modèle, de la même fenêtre de contexte ou du même budget.
Les résumés à faible risque, le tri des problèmes, le formatage et les transformations déterministes peuvent souvent utiliser des modèles moins coûteux. Le débogage difficile, la planification d'architecture, les migrations et les travaux sensibles à la sécurité peuvent justifier des modèles plus puissants et une révision plus stricte.
Une politique de routage pratique pourrait ressembler à ceci :
| Type de tâche | Stratégie de modèle suggérée | Niveau de révision |
|---|---|---|
| Mise en forme ou nettoyage | Modèle peu coûteux | Révision légère |
| Résumé ou tri | Modèle peu coûteux | Vérification ponctuelle |
| Petite correction de code | Modèle moyen/élevé selon le risque | Révision diff + test |
| Changement d'architecture | Modèle plus puissant | Révision humaine requise |
| Tâche de sécurité ou de production | Modèle plus puissant + cadre strict | Approbation humaine requise |
| Communication externe client | Modèle plus puissant ou piloté par humain | Approbation avant envoi |
Le but n'est pas de toujours utiliser le modèle le moins cher. Le but est d'utiliser le bon modèle pour le niveau de risque.
Les agents persistants incitent à tout stocker. C'est risqué.
Les équipes doivent stocker des informations stables et réutilisables telles que :
Les équipes doivent éviter de stocker :
Une bonne mémoire améliore la fiabilité du flux de travail. Une mauvaise mémoire transforme l'hypothèse d'hier en instruction cachée de demain.
N'évaluez pas les agents uniquement à travers des démonstrations ou des extraits de réseaux sociaux.
Choisissez des tâches réelles du mois dernier. Incluez des bogues, des refactorisations, des modifications de documentation, du nettoyage de données, des investigations de support et des vérifications de version. Exécutez chaque agent avec le même budget de temps et comparez les résultats.
Mesurez :
Un benchmark local d'équipe est plus précieux qu'un classement générique car il reflète le travail réel que l'équipe effectue.
Un cadre utile n'a pas besoin de commencer comme un grand projet de plateforme. Une version minimale peut être construite avec un fichier d'instructions de dépôt, un modèle de tâche, une liste de vérification de validation et une règle de révision.
Utilisez un modèle de tâche comme celui-ci :
Objectif :
Contexte autorisé :
Outils autorisés :
Actions interdites :
Commande de validation :
Artéfact attendu :
Approbation humaine nécessaire pour :
Arrêter si :
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Ensuite, cartographiez les types de tâches aux flux de travail.
Ce modèle est simple, mais il force l'équipe à rendre visible l'autorisation et la validation.
Pour les flux de travail de type We0 AI, le cadre doit aider les équipes à définir des instructions, exécuter des vérifications reproductibles, comparer les sorties des agents et conserver suffisamment de contexte pour la révision. L'objectif n'est pas de ralentir
adoption. L'objectif est de rendre la délégation suffisamment prévisible pour être digne de confiance.
Ne comparez pas Claude Cowork, Claude Code, Codex, GitHub Copilot, Cursor ou les agents internes sur la base de « sensations » ou d'impressions vagues.
Utilisez des tâches réelles et posez cinq questions :
Exécutez chaque tâche plus d'une fois. Les agents sont stochastiques. Une seule exécution impressionnante ne prouve pas la fiabilité, et une seule mauvaise exécution ne prouve pas que le système est inutile.
Mesurez également la charge de révision. Si un agent crée un artefact volumineux dont la vérification prend plus de temps que d'effectuer la tâche manuellement, il n'est pas utile. Un agent utile réduit le coût pour parvenir à une décision éclairée. Il ne se contente pas de générer plus de résultats.
Claude Cowork mobile et web fait partie d'un changement plus large.
AWS transforme les harnais d'agents en infrastructure cloud gérée. L'agent cloud de GitHub Copilot prend en charge le codage en arrière-plan et les workflows de pull requests. Claude Code, Codex, Cursor et les agents internes poussent tous les équipes vers un travail asynchrone utilisant des outils. Les discussions de recherche autour de l'ingénierie des harnais suggèrent également que de meilleurs systèmes d'agents dépendront d'environnements, d'outils, de boucles de rétroaction et d'évaluations plus solides.
Ce sont différentes histoires de produits, mais elles pointent vers la même réalité opérationnelle : les produits d'IA deviennent des systèmes.
Ils ont besoin :
L'ère du « collez l'invite, obtenez la réponse » n'est pas terminée. Mais pour les équipes sérieuses, ce n'est plus la frontière.
Voici un plan de déploiement pratique sur 30 jours.
Listez chaque outil agent que votre équipe utilise.
Pour chaque outil, enregistrez :
Cela donne à l'équipe une base de référence claire.
Divisez les tâches en risques faible, moyen et élevé.
Cette politique doit être écrite. Si une catégorie de tâche n'est pas claire, traitez-la comme à risque moyen ou élevé jusqu'à ce que l'équipe en décide autrement.
Sélectionnez environ 20 tâches réelles du mois précédent.
Incluez :
Exécutez les workflows actuels et au moins une configuration d'agent alternative. Suivez l'achèvement, le temps de révision, le coût, les échecs et les surprises.
Ajoutez ou améliorez :
Si une tâche
ne peut être vérifié, il ne doit pas être délégué sans un propriétaire humain clair.
L'accès mobile doit être conçu autour d'un contrôle étroit, et non d'une autorité étendue.
Un workflow mobile sécurisé peut permettre aux utilisateurs de :
Il ne doit pas permettre aux utilisateurs de :
Cela ne signifie pas que le contrôle mobile est mauvais. Cela signifie que le contrôle mobile doit être limité aux types de décisions qui peuvent être prises de manière responsable depuis un petit écran.
Le support mobile et web de Claude Cowork est important car il montre où se dirigent les produits agents. Le travail IA sera persistant, multi-appareils, asynchrone et utilisera des outils.
Les équipes qui considèrent les agents uniquement comme des compléments automatiques plus intelligents manqueront le virage. Les équipes qui considèrent les agents comme des collègues entièrement de confiance créeront un risque évitable.
La voie la plus sûre est la délégation contrôlée : des périmètres de tâches restreints, des autorisations explicites, des journaux persistants, une validation déterministe, un routage de modèle et une révision humaine aux bons moments.
Claude Cowork est le produit de travail agentique d'Anthropic qui permet à Claude de gérer des tâches à travers des fichiers, des outils et des workflows pendant que l'utilisateur examine le résultat final. Son support web et mobile rend le workflow plus persistant et multi-appareils.
L'accès mobile est important car il change la façon dont les utilisateurs interagissent avec les agents. Au lieu de rester dans une session de bureau, une tâche peut continuer en arrière-plan pendant que l'utilisateur vérifie la progression, répond à des questions ou examine l'état depuis un autre appareil.
Un harnais d'agent est le système autour du modèle qui gère le contexte, les outils, l'état, les autorisations, la validation, les journaux et la révision humaine. C'est ce qui transforme une réponse de modèle en travail contrôlé.
L'approbation mobile peut être sûre pour des décisions étroites et à faible risque, comme clarifier une exigence ou vérifier la progression. Elle ne doit pas remplacer une révision complète pour les grandes modifications de code, les actions de production, les données clients, les messages externes ou les opérations destructrices.
Utilisez des tâches internes réelles au lieu de démos. Comparez le taux d'achèvement, la charge de révision, le coût, la sécurité, la complexité de retour en arrière, les preuves sources et la capacité à arrêter ou rediriger l'agent aux bons moments.
Un bon modèle doit inclure l'objectif, le contexte autorisé, les outils autorisés, les actions interdites, la commande de validation, l'artefact attendu, les points d'approbation requis et les conditions d'arrêt.
Différentes tâches ont différents niveaux de risque et de complexité. Les résumés simples peuvent ne pas nécessiter le modèle le plus cher, tandis que les changements d'architecture, le débogage, les migrations et les opérations sensibles à la sécurité
Les tâches peuvent nécessiter des modèles plus puissants et une révision plus stricte.
Le principal risque est que l'agent continue d'utiliser des outils, un contexte ou des autorisations après que l'utilisateur a cessé d'y prêter une attention particulière. C'est pourquoi un accès limité, des journaux, des artefacts vérifiables et des points de validation sont essentiels.
La prise en charge mobile et web de Claude Cowork est plus qu'une simple mise à jour d'interface produit. Elle montre que le travail des agents devient persistant, multi-appareils, asynchrone et utilisateur d'outils.
Ce changement rend le cadre de contrôle de l'agent plus important. Les équipes ont besoin de portées de tâches plus claires, d'autorisations plus strictes, de journaux persistants, de routage de modèles, de validation déterministe et d'approbation humaine aux bons moments.
Une bonne prochaine étape n'est pas de courir après chaque nouvelle fonctionnalité d'agent. C'est de construire un petit benchmark interne, définir des niveaux de risque et rendre le travail délégué vérifiable.
Le workflow d'agent le plus fort n'est pas celui qui a le plus d'autonomie. C'est celui qui a les limites les plus claires, les meilleures preuves et le chemin de révision le plus sûr.
Partez d’une phrase et obtenez un site complet en quelques minutes.



