For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/claude-distillation-defenses-and-preserve-b64c5fd8.md.
Anthropic affirme que de nouvelles protections ont réduit d’environ 90 à 99 % la quantité de raisonnement Claude collectée par des acteurs d...
Anthropic affirme que de nouvelles protections ont réduit d’environ 90 à 99 % la quantité de raisonnement Claude collectée par des acteurs de la distillation sur sa propre plateforme. Sa mise à jour du 12 octobre décrit trois couches de défense : des restrictions sur la réutilisation du raisonnement protégé, des classificateurs d’extraction renforcés et des contrôles de comptes qui rendent les tentatives répétées plus coûteuses.
Il existe également une conséquence pratique pour les développeurs ordinaires. Certaines intégrations doivent modifier leur manière de rejouer l’historique des conversations, et certaines requêtes bloquées avant que Claude ne réponde sont désormais facturables. Comprendre ces coûts exige de distinguer les résultats anti-abus de l’entreprise des règles d’API auxquelles les applications sont réellement confrontées.
La distillation entraîne un modèle à l’aide des sorties d’un autre modèle. Il s’agit aussi d’une technique légitime : les développeurs peuvent distiller leurs propres modèles ou utiliser des données pour lesquelles ils disposent d’une autorisation. Le rapport d’Anthropic se concentre sur les campagnes d’extraction non autorisées, impliquant souvent des comptes frauduleux, plutôt que de considérer toute distillation comme un abus.
Dans ce contexte, les réponses finales constituent des données d’entraînement utiles, mais un raisonnement détaillé peut l’être davantage. Une transcription du raisonnement expose les décisions intermédiaires, les approches tentées et les corrections qu’un modèle élève devrait autrement déduire.
Anthropic illustre cette différence avec une expérience qui a entraîné un modèle Claude préentraîné sur des transcriptions de Claude Opus 4.8. Les scores SWE-bench Verified obtenus étaient les suivants :
| Données d’entraînement | Score SWE-bench Verified indiqué |
|---|---|
| Transcriptions avec raisonnement complet | 80,4 % |
| Transcriptions avec raisonnement résumé | 71,8 % |
Cela représente un écart de 8,6 points de pourcentage dans cette expérience. Il confirme la valeur des transcriptions de raisonnement pour cette configuration d’entraînement ; il n’établit pas un avantage universel de même ampleur pour tous les modèles ou toutes les tâches.
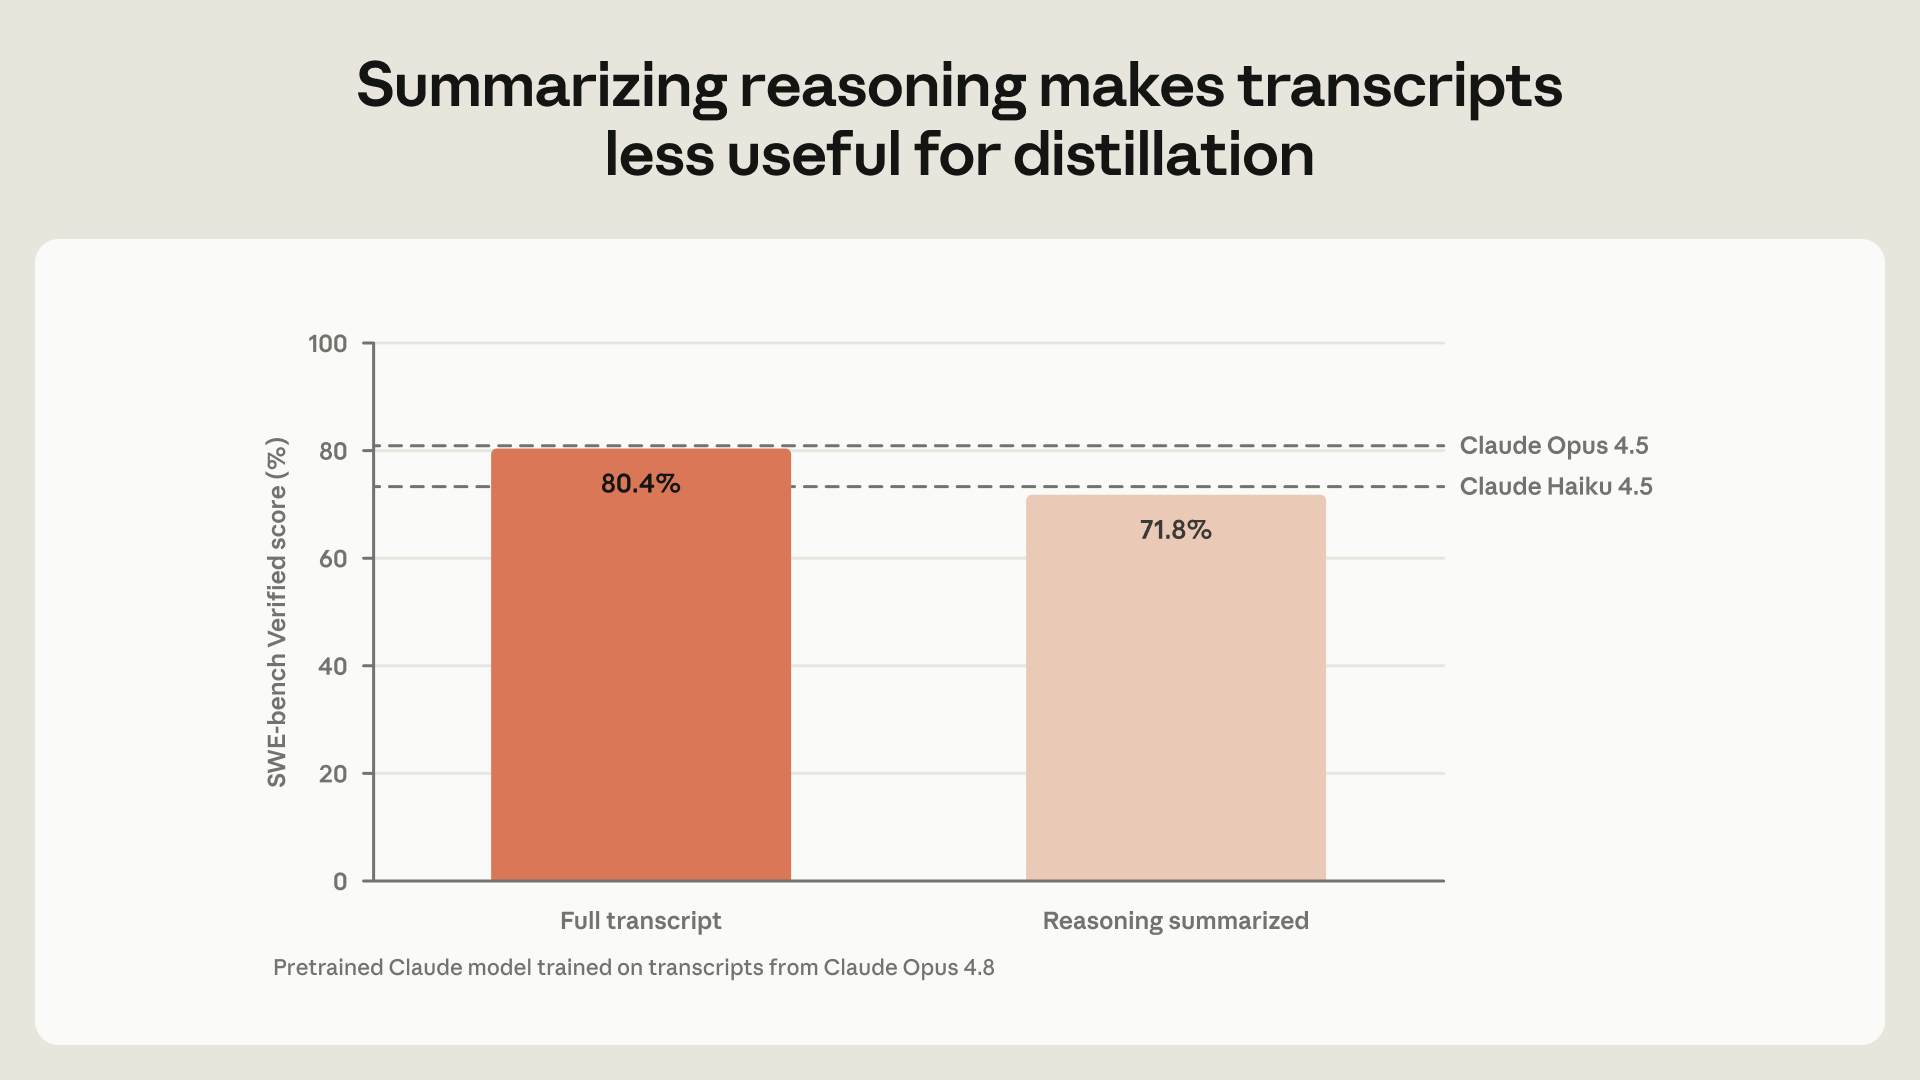
Source : Anthropic. Les barres décrivent le modèle élève entraîné sur des transcriptions d’Opus 4.8, et non une comparaison directe des benchmarks entre les modèles de production affichés sous forme de lignes de référence.
Présenter des résumés réduit la collecte passive, mais incite à obtenir le raisonnement caché au moyen de requêtes de suivi. Anthropic indique qu’un laboratoire a testé 12 000 requêtes d’extraction différentes. L’entreprise décrit également des réseaux de proxys qui répartissent l’activité sur un grand nombre de comptes, notamment un réseau déjà signalé qui gérait simultanément plus de 20 000 comptes frauduleux.
Pour les tâches longues, un modèle peut avoir besoin de reprendre à partir du raisonnement produit lors d’un tour précédent. L’API peut préserver des blocs de réflexion protégée à cette fin sans exposer le raisonnement sous-jacent sous forme de texte ordinaire lisible par l’utilisateur.
Cela crée un problème de contrôle d’accès. Selon Anthropic, des attaquants ont tenté de déplacer le raisonnement entre conversations, modèles ou comptes afin de trouver un contexte dans lequel il pourrait être divulgué. Protéger le bloc exige donc de contrôler sa réutilisation autant que son affichage.
Anthropic a introduit la réflexion préservée avec Claude Fable 5.1 et Claude Opus 5.5. La documentation actuelle décrit deux vérifications centrales :
La vérification du préfixe est appliquée par défaut aux comptes créés à partir du 31 août 2026 à 00:00 UTC. Les comptes plus anciens peuvent activer cette application via les contrôles documentés. La vérification de compatibilité des modèles s’applique à tous les comptes.
L’annonce de recherche décrit également des restrictions au niveau de l’organisation pour le raisonnement de Sonnet 5.5. La documentation actuelle de l’API donne la règle plus précise : les blocs de réflexion de Sonnet 5.5 et Haiku 5.5 ne fonctionnent que dans le compte qui les a produits ou dans un compte lié, lorsque l’application documentée s’applique. Les développeurs doivent s’appuyer sur cette documentation de compatibilité lors de l’implémentation du routage ou de modifications de comptes.
Des comportements courants d’application peuvent modifier un préfixe protégé : reconstruire un prompt système avec un nouvel horodatage, modifier une ancienne sortie d’outil, changer les descriptions des outils ou résumer des tours antérieurs tout en conservant les blocs de réflexion ultérieurs.
Par défaut, un préfixe non valide peut produire une erreur 400 invalid_request_error. Les contrôles bêta documentés permettent aussi de définir thinking.block_binding.prefix_mismatch_behavior sur drop_block, auquel cas les blocs de réflexion non valides et les blocs de réflexion suivants sont supprimés pour cette requête. Cela permet à la requête de continuer, mais ne corrige pas la mutation de l’historique.
Conservez un historique rejoué stable et ajoutez les nouvelles informations en utilisant les modèles pris en charge. Modifier le texte visible d’une conversation tout en continuant à réutiliser l’ensemble de son ancien raisonnement protégé n’est plus une hypothèse sûre.
La deuxième couche d’Anthropic utilise un système de classificateurs à deux étapes inspiré de ses recherches sur les Constitutional Classifiers. L’entreprise teste les tentatives d’extraction avec des équipes rouges internes et externes, puis met à jour les défenses lorsqu’une technique réussit.
L’entreprise affirme que les protections anti-distillation qui en résultent ont un taux de faux positifs inférieur à 0,1 % dans son évaluation. Elle compare leur robustesse à celle de ses défenses contre l’assistance à la création d’armes biologiques. Il s’agit d’une évaluation de l’entreprise dans ses conditions de test, et non d’une garantie qu’une requête légitime donnée ne sera jamais refusée.
Le système évolue aussi au fil du temps. Anthropic décrit le colmatage de techniques visant à révéler le raisonnement protégé via la traduction ou des sorties au format particulier. L’affirmation publiée est que le classificateur détecte les techniques d’extraction décrites dans son rapport de septembre pour les modèles couverts par le système.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
La troisième couche agit sur les comportements répétés. Les comptes qui tentent continuellement l’extraction peuvent recevoir des limites d’utilisation plus strictes, et les comptes associés peuvent être bannis. Anthropic indique avoir banni des dizaines de milliers de comptes, parfois dans les deux heures suivant le début d’une campagne.
Depuis le 24 septembre, Anthropic facture de nouveau les requêtes bloquées avant une réponse du modèle dans certaines catégories de protections dont le taux de faux positifs indiqué est inférieur à 0,1 %, y compris la distillation. La source identifie également les catégories d’usage abusif biologique et de développement de modèles de pointe. Cette politique ne doit pas être généralisée à chaque requête refusée ni à chaque type de filtre de sécurité.
Anthropic estime que les jetons de raisonnement extraits sur sa propre plateforme ont diminué d’un facteur de 10 à 100 après l’introduction du classificateur, parallèlement aux modifications liées à la réflexion préservée. Certains jours comptaient trop peu de jetons extraits pour que l’entreprise puisse les mesurer.
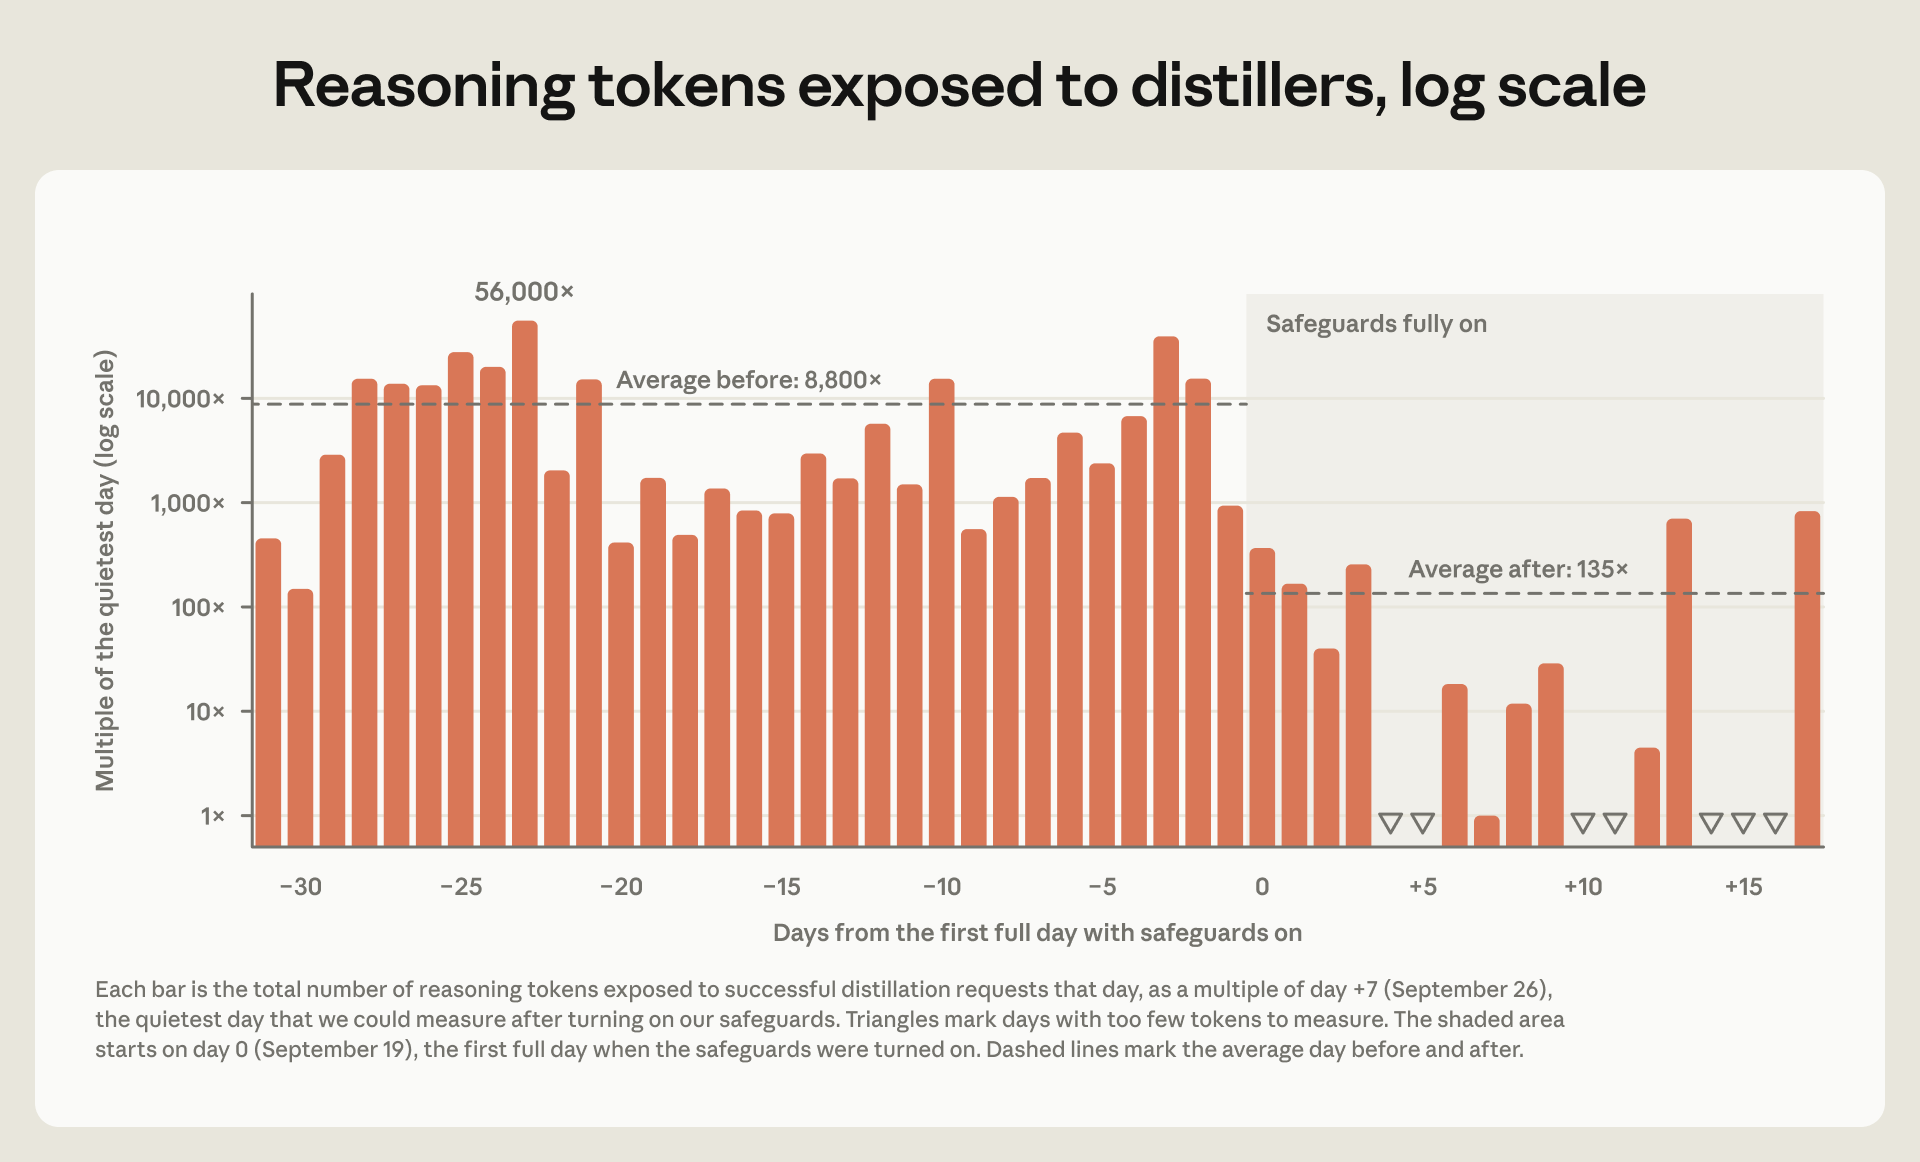
Source : Anthropic. L’axe vertical est logarithmique et normalisé par rapport à une journée de faible extraction, et non par rapport à un nombre absolu de jetons. Les triangles pointant vers le bas indiquent les jours comportant trop peu de jetons pour être mesurés.
Le périmètre est important. Ces chiffres décrivent l’estimation d’Anthropic pour sa propre plateforme ; ils ne mesurent pas l’ensemble des activités de distillation chez des fournisseurs tiers d’inférence. L’entreprise indique également ne pas avoir encore observé de tentative très sophistiquée et persistante visant à contourner les défenses entièrement déployées, et ne pas savoir combien de temps les gains perdureront.
Anthropic reconnaît que les changements n’ont pas été totalement transparents pour les utilisateurs ordinaires. Les intégrations peuvent nécessiter des mises à jour, des requêtes bénignes peuvent être mal classées et ces blocages erronés peuvent désormais entraîner des frais dans les catégories concernées.
La perte de raisonnement réutilisable entraîne un autre coût : le modèle peut devoir reconstruire son travail. Dans un benchmark de programmation multi-tour décrit dans la documentation de l’API, supprimer la réflexion une fois par session a augmenté les jetons de sortie de 20,1 % avec un effort maximal. Il s’agit d’une estimation spécifique à cette charge de travail, assortie de larges marges d’erreur, et non d’un supplément standard ni d’une prévision pour chaque application.
Pour un développeur, la distinction utile se situe entre un bloc d’entrée illisible ou supprimé et une nouvelle sortie générée. Le bloc supprimé lui-même n’est pas facturé, tandis que la reconstruction du raisonnement peut générer des jetons de sortie supplémentaires. Surveiller les incompatibilités de préfixe et tester les propres charges de travail de l’application est plus instructif que de supposer qu’une nouvelle tentative réussie n’a aucun coût.
Dans l’usage d’Anthropic, il s’agit d’une campagne non autorisée visant à collecter les sorties de Claude ou son raisonnement protégé afin d’entraîner un autre modèle. La distillation elle-même est une technique standard d’apprentissage automatique et peut être légitime lorsque le développeur dispose des droits et autorisations nécessaires.
Non. Anthropic indique une réduction estimée de 90 à 99 % du raisonnement collecté sur sa propre plateforme après le déploiement des protections. Ce chiffre ne couvre pas tous les fournisseurs, toutes les attaques ni toutes les futures méthodes d’extraction.
Non, à condition que l’application respecte les règles documentées pour rejouer la réflexion et préserver le préfixe de la conversation. Des problèmes surviennent lorsque le contexte antérieur change alors que l’application continue d’envoyer des blocs de réflexion liés au contexte initial.
Uniquement lorsque les règles documentées de compatibilité des modèles l’autorisent. Un modèle qui ne peut pas lire un bloc s’exécute sans ce bloc ; passer à un modèle moins coûteux ne préserve donc pas nécessairement le raisonnement du modèle précédent.
Oui. Anthropic indique que certaines catégories de protections sont redevenues facturables le 24 septembre, même lorsque la requête est bloquée avant que Claude ne réponde. Le rapport reconnaît explicitement qu’un faux positif dans ces catégories peut affecter un client légitime.
Non. Il s’agissait de l’augmentation indiquée lorsqu’une réflexion était supprimée une fois par session avec un effort maximal dans un test particulier de programmation multi-tour. L’effet dépend de l’effort, de l’historique de la conversation, de la tâche et de la fréquence à laquelle l’intégration supprime des blocs.
Les nouvelles défenses d’Anthropic combinent des restrictions sur le raisonnement protégé, des classificateurs d’extraction et des mesures contre les abus répétés. L’entreprise fait état d’une réduction importante du raisonnement collecté sur sa propre plateforme, tout en reconnaissant que les attaquants peuvent s’adapter.
Pour les développeurs utilisant l’API Claude, le travail immédiat consiste à maintenir un historique de conversation valide et à comprendre les coûts associés aux requêtes bloquées ou à la réflexion supprimée. Les gains de sécurité annoncés sont importants, mais la stabilité des intégrations et les tests spécifiques à chaque charge de travail restent essentiels.
Partez d’une phrase et obtenez un site complet en quelques minutes.



