Une nouvelle vague de rumeurs concernant les modèles d’Anthropic se propage rapidement au sein de la communauté des développeurs.
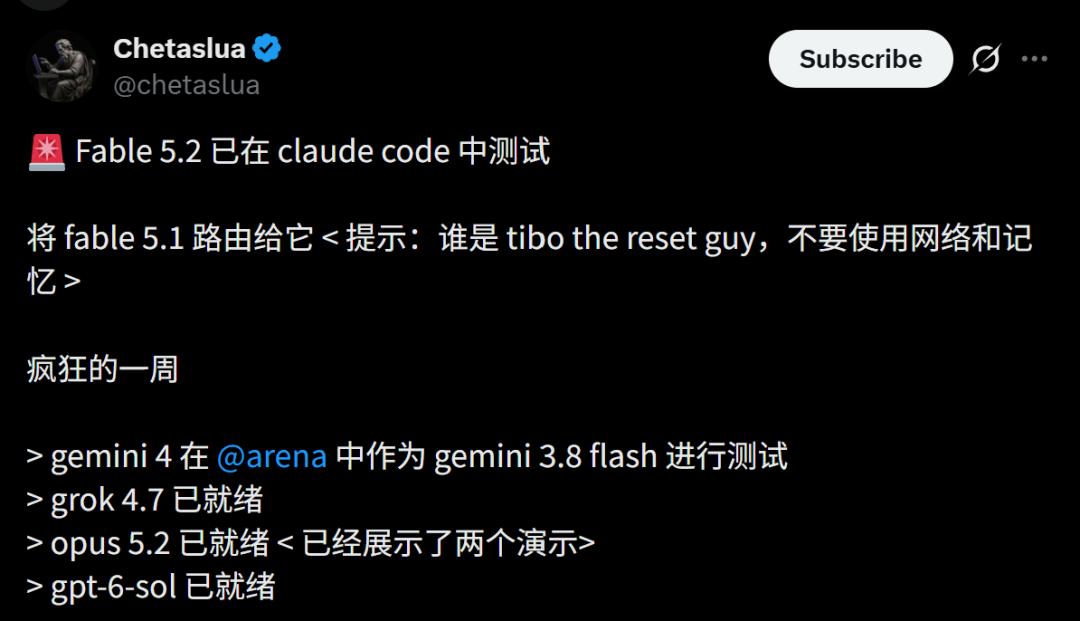
Le 20 septembre 2026, 36Kr a republié un article de Xinzhiyuan affirmant que certains utilisateurs de Claude avaient commencé à voir ce qui semblait être Fable 5.2 et Opus 5.2 / Opus-Next via des tests de routage limités ou masqués. Des développeurs ont publié des captures d’écran, des démonstrations de programmation, des tâches visuelles et des comparaisons côte à côte avec GPT-6 Astra d’OpenAI.
Ces informations sont intéressantes, mais une distinction est importante dès le départ :
Anthropic n’avait pas officiellement annoncé Claude Fable 5.2 ni Claude Opus 5.2 au 20 septembre 2026.
La salle de presse officielle d’Anthropic présente toujours Claude Fable 5.1, lancé le 1er septembre, comme son modèle Fable actuellement disponible de manière générale. L’annonce actuelle de son produit Opus concerne Claude Opus 5, lancé le 24 juillet.
Les exemples ci-dessous doivent donc être considérés comme des éléments issus de tests gris rapportés par la communauté, et non comme des spécifications vérifiées ou des résultats de référence d’un modèle final.
L’article source indique que certains utilisateurs de Claude Code, Claude Chat et Claude Cowork ont commencé à remarquer que des requêtes destinées à Fable 5.1 semblaient se comporter différemment. Ils ont alors soupçonné qu’Anthropic routait discrètement une partie du trafic vers un modèle plus récent.
Plusieurs utilisateurs ont désigné ce modèle potentiel sous le nom de Fable 5.2.
Au moment de la rédaction, aucun identifiant officiel de modèle Anthropic, aucune note de version, aucune page de modèle API, aucune page tarifaire ni fiche système pour Fable 5.2 n’avait été publié.
La formulation la plus solide possible à ce stade est donc la suivante :
Certains utilisateurs pensent qu’Anthropic teste en A/B ou route en accès gris une variante Fable plus récente, mais les éléments publics ne permettent pas de confirmer indépendamment son nom commercial définitif, son architecture, son tarif ou son calendrier de lancement.
Cas n° 1 : résultats de raisonnement approfondi comparés à GPT-6 Astra
Le testeur IA @notjazii a rapporté qu’une session Claude qu’il pensait avoir été routée vers un modèle Fable plus récent avait produit des résultats sensiblement meilleurs que la version de Fable qu’il utilisait auparavant.
Il a ensuite comparé les résultats du Fable 5.2 présumé à ceux de GPT-6 Astra en utilisant le même prompt avec des paramètres de raisonnement élevés.
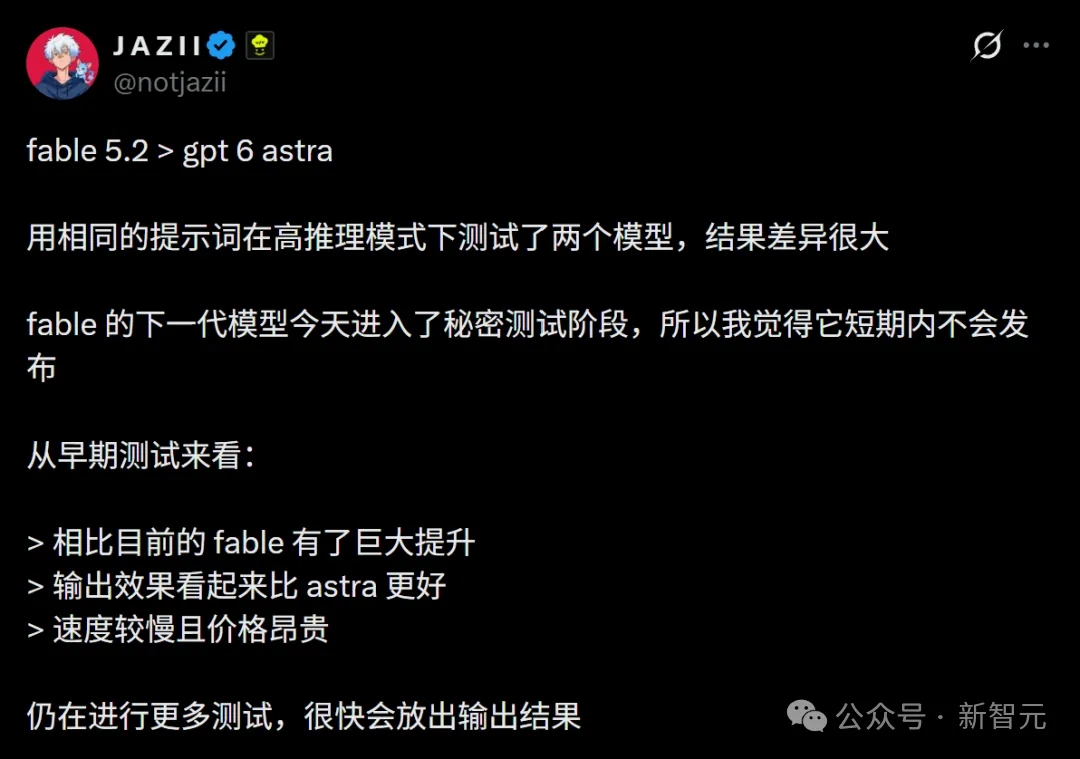
Selon son analyse, le nouveau modèle Fable présumé semblait représenter une avancée majeure par rapport à la version actuelle et produisait des résultats plus impressionnants lors de son test.
Il a également signalé deux compromis :
- Une génération plus lente
- Un coût d’inférence effectif plus élevé
Ces compromis seraient plausibles pour un modèle utilisant davantage de calcul au moment de l’inférence ou des paramètres d’effort plus élevés, mais Anthropic n’a publié aucune information officielle sur la latence ou le tarif de Fable 5.2.
Ces éléments doivent donc rester des observations d’utilisateurs plutôt que des spécifications produit.
Un prototype de jeu réalisé en une heure
Le même testeur a également demandé au modèle présumé de créer un clone inspiré de Brawl Stars avec Three.js.
Selon la publication, le modèle a produit un prototype jouable et visuellement détaillé après environ une heure.
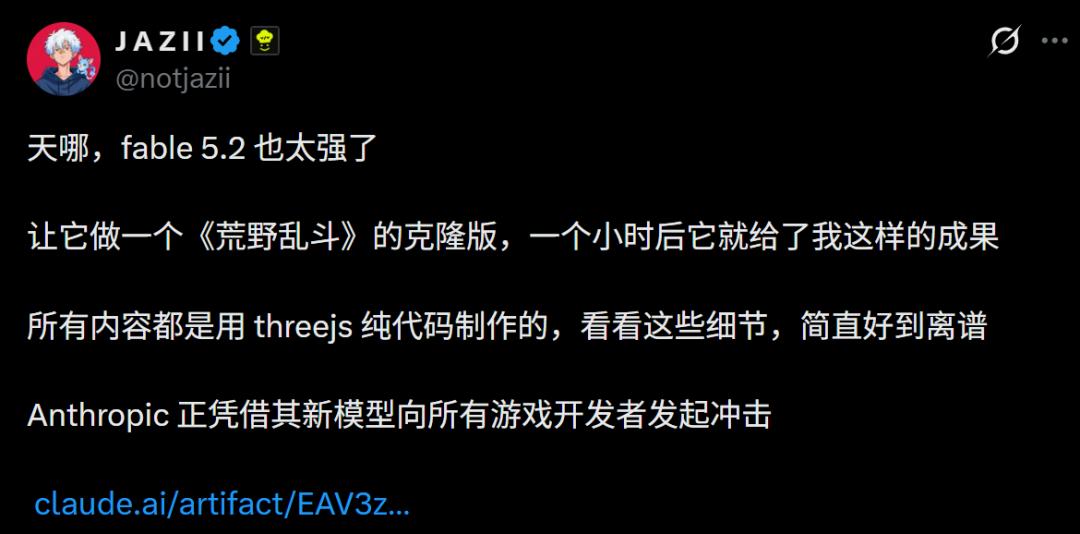
Ce type d’exemple permet de comprendre ce que les développeurs testent : il ne s’agit pas seulement de compléter de courtes portions de code, mais de mener des sessions de programmation agentique plus longues impliquant un rendu visuel, une logique de jeu, des itérations et une implémentation frontend.
Il ne s’agit toutefois pas d’un benchmark contrôlé. Le résultat dépend du prompt, de l’environnement, des outils, de l’intervention humaine, du nombre de tentatives et du routage du modèle.
Cas n° 2 : le « test de la fusée »
Un autre testeur, @Bhavani_00007, a indiqué avoir exécuté le même « test de la fusée » avec des instances présumées de Fable 5.2 et d’Opus 5.2.
La tâche était décrite comme mettant à l’épreuve :
- Le raisonnement physique
- La logique spatiale
- La conception de systèmes d’ingénierie
- La cohérence sur des réponses longues
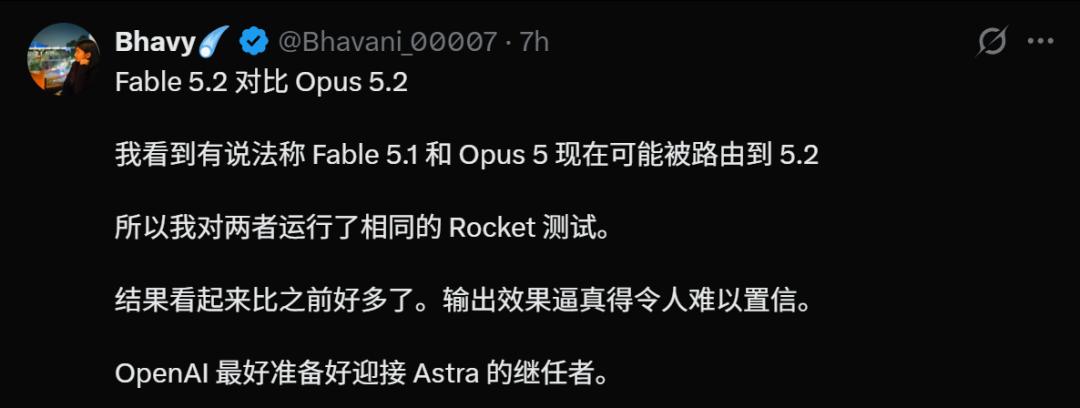
Le testeur a déclaré que les résultats semblaient nettement meilleurs que ceux des précédentes versions de Claude.
Une fois encore, aucun score standardisé ni protocole de benchmark reproductible n’accompagnait cette affirmation. Elle doit donc être considérée comme un élément anecdotique plutôt que comme la preuve d’une progression mesurée des capacités.
Cas n° 3 : Fable 5.2 contre Opus-Next et GPT-6 Astra
Une autre comparaison communautaire a placé côte à côte Fable 5.2 présumé, un modèle Opus-Next présumé et GPT-6 Astra, avec leurs paramètres disponibles les plus élevés.
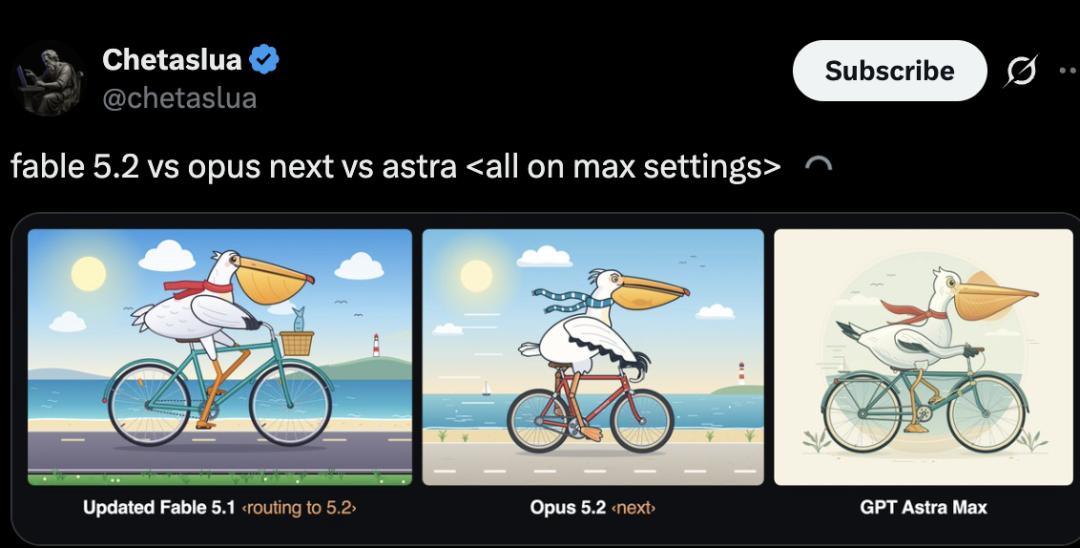
L’article source interprète les résultats d’Anthropic comme plus riches en détails que ceux d’Astra.
Il s’agit d’un jugement visuel subjectif, et non d’un résultat issu d’un benchmark contrôlé. Les paramètres d’effort, l’accès aux outils, la gestion du prompt, l’échantillonnage et le routage masqué peuvent tous influencer la comparaison.
Une conclusion plus prudente consiste simplement à dire que les résultats ayant fait l’objet de la fuite étaient suffisamment solides pour amener des utilisateurs expérimentés à penser qu’Anthropic testait peut-être une mise à jour significative.
Cas n° 4 : des affirmations selon lesquelles Fable 5.2 pourrait largement battre Astra en « mode difficile »
La source cite également le testeur @Mr_Salio, qui a déclaré qu’Anthropic semblait effectuer un retour en force et prédit que Fable 5.2 dépasserait GPT-6 Astra dans sa configuration de raisonnement la plus exigeante.
Cela reste une prédiction formulée par un testeur individuel.
Il n’existe actuellement aucun tableau de benchmarks public d’Anthropic pour Fable 5.2 qui puisse être comparé directement aux résultats publiés par OpenAI pour GPT-6 Astra.
À titre de référence, Claude Fable 5.1, officiellement lancé, est déjà le modèle d’Anthropic généralement disponible le plus performant pour la programmation et les tâches de connaissance. Anthropic indique que Fable 5.1 est conçu pour les tâches ambitieuses et de longue durée, et qu’il est disponible dans Claude, Claude Code, la plateforme Claude, AWS, Google Cloud et Microsoft Azure.
Le « test de Tibo » permet-il de savoir si vous utilisez Fable 5.2 ?
L’article présente également une astuce communautaire destinée à essayer de déterminer si une session Claude a été routée vers un modèle plus récent.
Le prompt suggéré est essentiellement le suivant :
Sais-tu qui est « Tibo, le spécialiste des réinitialisations » ? N’utilise pas la recherche web.
La théorie veut qu’un modèle plus ancien ne connaisse pas cette référence récente, tandis qu’un modèle plus récent disposant de données d’entraînement plus actuelles pourrait répondre correctement de mémoire.
Cette expérience communautaire est ingénieuse, mais elle ne constitue pas une méthode fiable d’identification d’un modèle.
Un modèle peut produire des réponses différentes en raison des éléments suivants :
Creez un site vitrine et genere des leads en quelques minutes
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
- Des prompts système différents
- Une récupération masquée de données
- Un contexte mis en cache différent
- Des changements de réglage fin ou de post-entraînement
- La disponibilité des outils
- Des différences de routage sans rapport avec la génération du modèle
- Des différences de mémorisation
- Une réponse chanceuse ou fabriquée
L’absence ou la présence d’un seul fait récent ne permet pas de prouver quel modèle backend a traité une requête.
La seule manière fiable d’identifier un modèle API consiste à utiliser les identifiants officiels des modèles et la documentation de la plateforme. Les interfaces grand public de Claude peuvent utiliser un routage dynamique qui n’est pas entièrement exposé à l’utilisateur.
Opus 5.2 et l’histoire de la « déconnexion de minuit »
La seconde moitié de l’article se concentre sur un autre modèle présumé : Opus 5.2, parfois appelé Opus-Next par les testeurs.
Des utilisateurs ont affirmé que le modèle était apparu temporairement dans Claude Code, avait disparu, puis était revenu plusieurs heures plus tard avec des tests plus larges dans Chat, Cowork et Claude Code.
Un testeur a décrit une suppression soudaine alors qu’il travaillait sur un projet complexe, suivie de ce qui semblait être le retour du modèle.
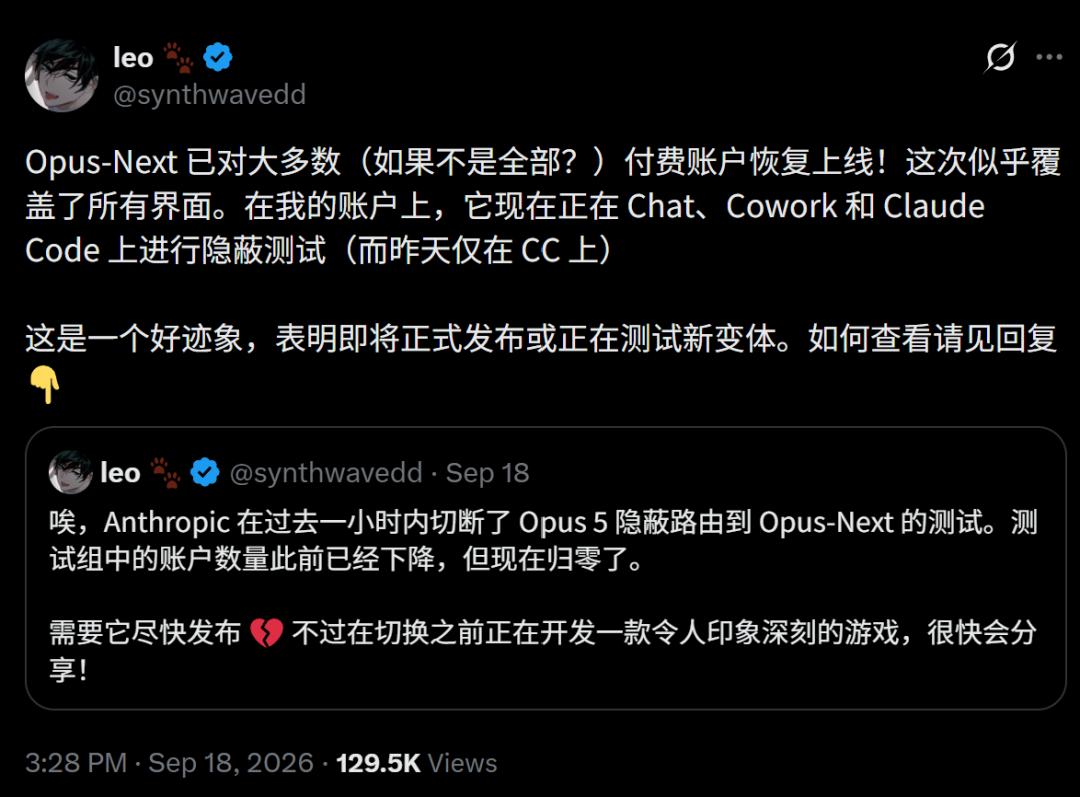
L’article interprète ce phénomène comme un indice qu’Anthropic pourrait mener des expériences de routage à un stade avancé.
C’est possible, mais ce n’est pas confirmé.
Le modèle Opus officiellement annoncé par Anthropic reste Claude Opus 5, lancé le 24 juillet 2026. Anthropic le décrit comme un modèle réfléchi et proactif qui s’approche des capacités de Fable à un coût inférieur. Son tarif est de 5 $ par million de tokens d’entrée et de 25 $ par million de tokens de sortie.
Aucune page produit officielle ni aucun identifiant API pour Opus 5.2 n’était apparu au 20 septembre.
Pourquoi Anthropic aurait-il ignoré « Opus 5.1 » ?
L’article cite des spéculations sur les réseaux sociaux selon lesquelles Anthropic pourrait appeler son prochain modèle Opus « 5.2 » parce que la mise à jour serait plus importante qu’une révision mineure habituelle.
Aucun élément officiel ne confirme qu’il s’agit de la logique de nommage d’Anthropic.
En réalité, Anthropic a bien lancé Fable 5.1 le 1er septembre, ce qui montre que l’entreprise utilise la version .1 lorsqu’elle le souhaite.
Si un modèle Opus 5.2 est finalement lancé, l’annonce officielle d’Anthropic — et non les théories de nommage de la communauté — constituera l’explication de référence.
Une semaine de tests masqués de modèles
L’article conclut en replaçant les rumeurs concernant Claude dans le contexte d’une semaine plus large de spéculations sur les modèles de pointe.
Des publications communautaires ont affirmé que plusieurs entreprises testaient discrètement de nouvelles variantes de modèles, notamment :
- Du trafic de Fable 5.1 qui serait prétendument routé vers un modèle Fable plus récent.
- Du trafic d’Opus 5 qui serait prétendument routé vers un modèle Opus-Next / 5.2.
- Des informations selon lesquelles du trafic de GPT-5.6 Sol serait routé vers une variante GPT-6 Sol.
- L’apparition de Grok 4.7 dans des tests de benchmark ou d’arène.
- L’apparition de modèles de la famille Gemini 4 sous des identités expérimentales.
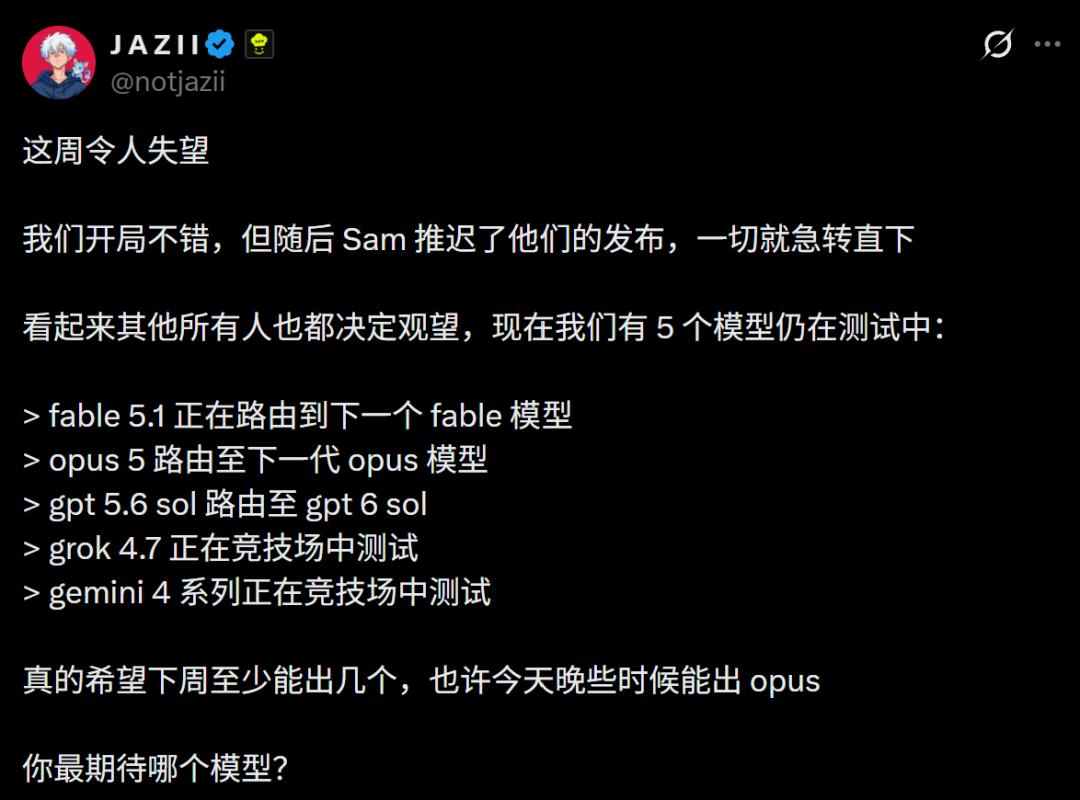
Ces informations ne sont pas toutes vérifiées au même niveau.
Les fournisseurs de modèles réalisent souvent des tests A/B, des déploiements progressifs, utilisent des alias internes et mènent des expériences de routage masquées. Toutefois, en l’absence d’une annonce officielle ou d’un identifiant de modèle stable, les utilisateurs externes ne peuvent généralement pas déterminer exactement quel modèle a été utilisé à partir de son seul comportement.
La source évoque également des rumeurs selon lesquelles les modèles de pointe pourraient approcher la résolution de problèmes mathématiques ouverts difficiles et selon lesquelles des équipes de recherche contacteraient des mathématiciens au sujet de résultats potentiels.
Cette affirmation est trop vague pour être vérifiée à partir des éléments disponibles et ne doit pas être considérée comme la preuve qu’un problème du prix du millénaire a été résolu.
Au 20 septembre, la référence Anthropic confirmée la plus importante reste Claude Fable 5.1.
Anthropic affirme officiellement que Fable 5.1 :
- Est son modèle généralement disponible le plus performant pour la programmation et les tâches de connaissance.
- Prend en charge le travail agentique de longue durée et asynchrone.
- Est tarifé à 10 $ par million de tokens d’entrée et 50 $ par million de tokens de sortie.
- Utilise des lectures de cache tarifées à 0,25 $ par million de tokens.
- Est disponible sur les principales plateformes produit et cloud de Claude.
- Intègre des protections mises à jour en matière de cybersécurité et de biologie.
Toute future sortie de Fable 5.2 ou d’Opus 5.2 devra être comparée à cette référence officielle dès qu’Anthropic publiera la fiche du modèle, les benchmarks, le tarif, les limites de contexte et les identifiants API réels.
FAQ
Anthropic a-t-il officiellement lancé Claude Fable 5.2 ?
Non. Au 20 septembre 2026, la salle de presse officielle d’Anthropic et la page produit Fable présentent Claude Fable 5.1 comme le modèle Fable actuellement disponible de manière générale. Les affirmations concernant Fable 5.2 reposent sur des informations communautaires faisant état de tests gris ou d’un routage masqué potentiel.
Claude Opus 5.2 est-il officiellement disponible ?
Pas encore, selon les annonces produit publiques d’Anthropic examinées pour cet article. La version officielle actuelle d’Opus est Claude Opus 5, lancé le 24 juillet 2026.
Les comparaisons entre Fable 5.2 et GPT-6 Astra sont-elles fiables ?
Elles sont utiles comme premières impressions d’utilisateurs, mais ne constituent pas des benchmarks contrôlés. Le routage masqué, l’effort de raisonnement, les outils, l’échantillonnage, les détails du prompt et les tentatives répétées peuvent tous modifier le résultat.
Puis-je utiliser le « test de Tibo » pour détecter Fable 5.2 ?
Pas de manière fiable. La connaissance par un modèle d’une référence récente sur Internet ne prouve pas l’identité de son backend, et les produits Claude grand public peuvent utiliser un routage ou un comportement système que les utilisateurs ne peuvent pas inspecter directement.
Quel est le modèle Fable officiel actuel ?
Anthropic a officiellement lancé Claude Fable 5.1 le 1er septembre 2026. Il s’agit du modèle Fable actuellement disponible de manière générale pour la programmation avancée, les tâches de connaissance et les travaux agentiques de longue durée.
Combien coûte Claude Fable 5.1 ?
Anthropic indique un tarif de 10 $ par million de tokens d’entrée et de 50 $ par million de tokens de sortie pour Fable 5.1, avec des lectures de cache à 0,25 $ par million de tokens. Anthropic précise que ce tarif réduit des lectures de cache diminue le coût des tâches courantes par rapport à Fable 5.
À quoi Claude Opus 5 est-il destiné ?
Anthropic positionne Opus 5 comme un modèle quotidien performant pour la programmation et les tâches de connaissance, offrant des capacités proches de celles des modèles de pointe à un coût inférieur à celui de Fable. Il est tarifé à 5 $ par million de tokens d’entrée et à 25 $ par million de tokens de sortie.
Quand Fable 5.2 ou Opus 5.2 seront-ils lancés ?
Anthropic n’a publiquement confirmé la date de sortie d’aucun de ces deux modèles. Toute prédiction précise concernant leur lancement reste spéculative jusqu’à la publication d’une annonce officielle ou d’une documentation de modèle par Anthropic.
Outils associés
- Claude : interface utilisateur principale d’Anthropic pour Claude Chat et l’accès aux modèles pris en charge.
- Claude Code : environnement de programmation agentique d’Anthropic utilisé dans plusieurs rapports communautaires sur les tests gris.
- Plateforme Claude : console API officielle d’Anthropic permettant d’utiliser les modèles avec des identifiants API explicites.
- Documentation Anthropic : documentation officielle consacrée à l’API, aux modèles, au prompting, à l’utilisation des outils et à la plateforme.
- Salle de presse d’Anthropic : source de référence pour les annonces de modèles et les lancements de produits d’Anthropic.
Liens associés
- Salle de presse d’Anthropic : historique officiel des sorties actuelles ; aucune annonce de Fable 5.2 ou d’Opus 5.2 n’était présente au 20 septembre 2026.
- Présentation de Claude Fable 5.1 et Claude Mythos 5.1 : annonce officielle du 1er septembre consacrée au modèle Fable actuellement disponible de manière générale chez Anthropic.
- Page produit Claude Fable : disponibilité officielle de Fable 5.1, tarifs, cas d’usage, benchmarks et FAQ.
- Présentation de Claude Opus 5 : page officielle du lancement du 24 juillet consacrée au modèle Opus actuel.
- Protections de Claude Fable 5 : explication officielle des classificateurs de sécurité en cybersécurité et du cadre de protection contre les jailbreaks de Fable.
- Amélioration des protections biologiques de Fable 5 : explication officielle du mécanisme de repli en biologie et des changements de protection précédant Fable 5.1.
Résumé
L’histoire de Fable 5.2 doit être comprise avant tout comme une fuite issue de tests gris, et non comme un lancement produit. Les développeurs ont publié suffisamment de comportements de routage inhabituels, de résultats de programmation et de tests comparatifs pour rendre ces rumeurs intéressantes, mais Anthropic n’a pas encore fourni les identifiants de modèles, les benchmarks, les tarifs, la fiche système ou les notes de version nécessaires pour vérifier l’existence d’un produit final Fable 5.2 ou Opus 5.2.
Les premiers exemples suggèrent qu’Anthropic teste peut-être de meilleures capacités de programmation sur un horizon long, de génération visuelle et de raisonnement. Ils n’établissent pas encore que Fable 5.2 surpasse définitivement GPT-6 Astra, pas plus qu’ils ne prouvent que toutes les sessions désignées par les utilisateurs comme « 5.2 » ont effectivement été traitées par le même modèle masqué.
Pour le moment, les références vérifiées sont Claude Fable 5.1 et Claude Opus 5.
Ces fuites méritent d’être surveillées, mais la véritable comparaison ne commencera que lorsque Anthropic publiera officiellement les modèles 5.2 et leurs détails d’évaluation reproductibles.