Un nouveau modèle de prompt pour Claude Opus 5 se répand rapidement dans la communauté de programmation IA, permettant aux développeurs de c...
Un nouveau schéma de prompt pour Claude Opus 5 se propage rapidement dans la communauté des développeurs IA, car ils l'utilisent pour créer des prototypes de jeux navigateur étonnamment soignés à partir de courtes instructions initiales.
Cette méthode est désormais connue sous le nom de « boucle d'épreuve » (Gauntlet Loop).
L'idée centrale est simple : ne pas laisser le même agent construire une fois, juger son propre travail, puis s'arrêter là. Donnez à l'agent principal un objectif de haut niveau, demandez-lui de décomposer le projet en parties plus petites, de désigner des constructeurs spécialisés, et d'utiliser des agents d'évaluation indépendants pour comparer la sortie réelle à des critères de qualité concrets.
Si le résultat généré ne passe pas la comparaison, on retourne à une nouvelle itération.
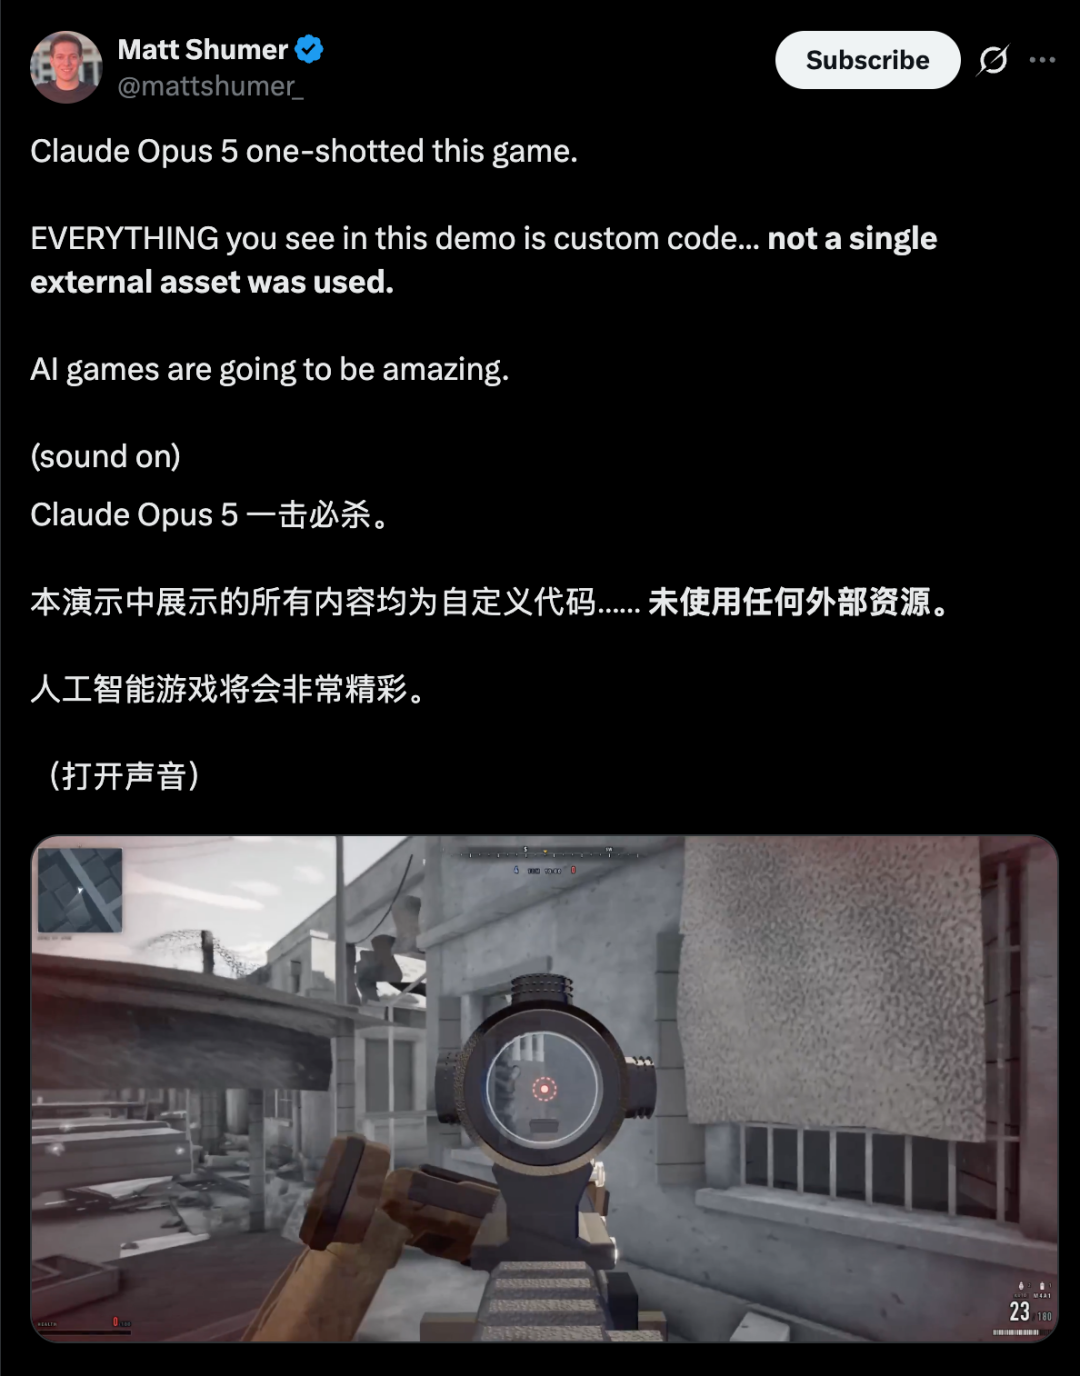
Matt Shumer a popularisé cette approche après avoir créé un jeu de tir à la première personne dans le navigateur inspiré des jeux Call of Duty modernes, en utilisant Claude Code et Opus 5. Il a ensuite publié le prompt, le code source et une explication du flux de travail.
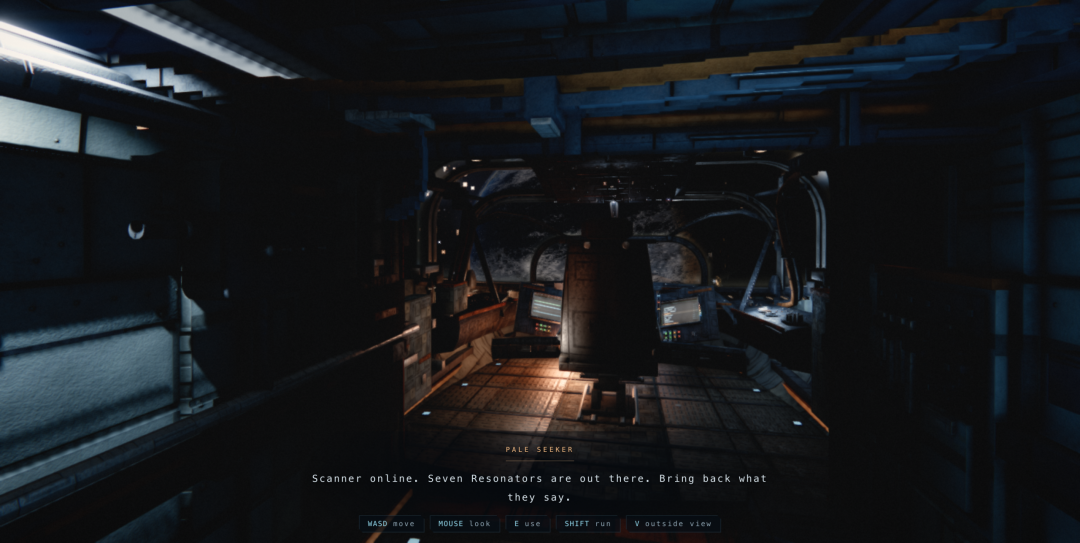
Un autre développeur, Anshu Chimala, a adopté un flux de travail similaire pour construire « Le Long Silence » (The Long Silence), un jeu d'exploration spatiale procédural qui s'exécute dans le navigateur.
Ces projets doivent être décrits avec précision. Ils ne montrent pas qu'un seul prompt peut produire immédiatement un jeu AAA de qualité commerciale. Ils montrent qu'un agent de codage puissant, doté d'outils, de sous-agents, d'un temps d'exécution long, de seuils de qualité mesurables et d'une vérification répétée, peut faire progresser un prototype bien au-delà de ce qu'un prompt unique traditionnel pourrait atteindre.
La tâche initiale de Shumer fixait un objectif volontairement extrême : construire un jeu de tir à la première personne dont l'ambition visuelle rivalise avec les grands titres AAA modernes.
La partie cruciale ne réside pas dans le genre du jeu, mais dans la structure d'évaluation.
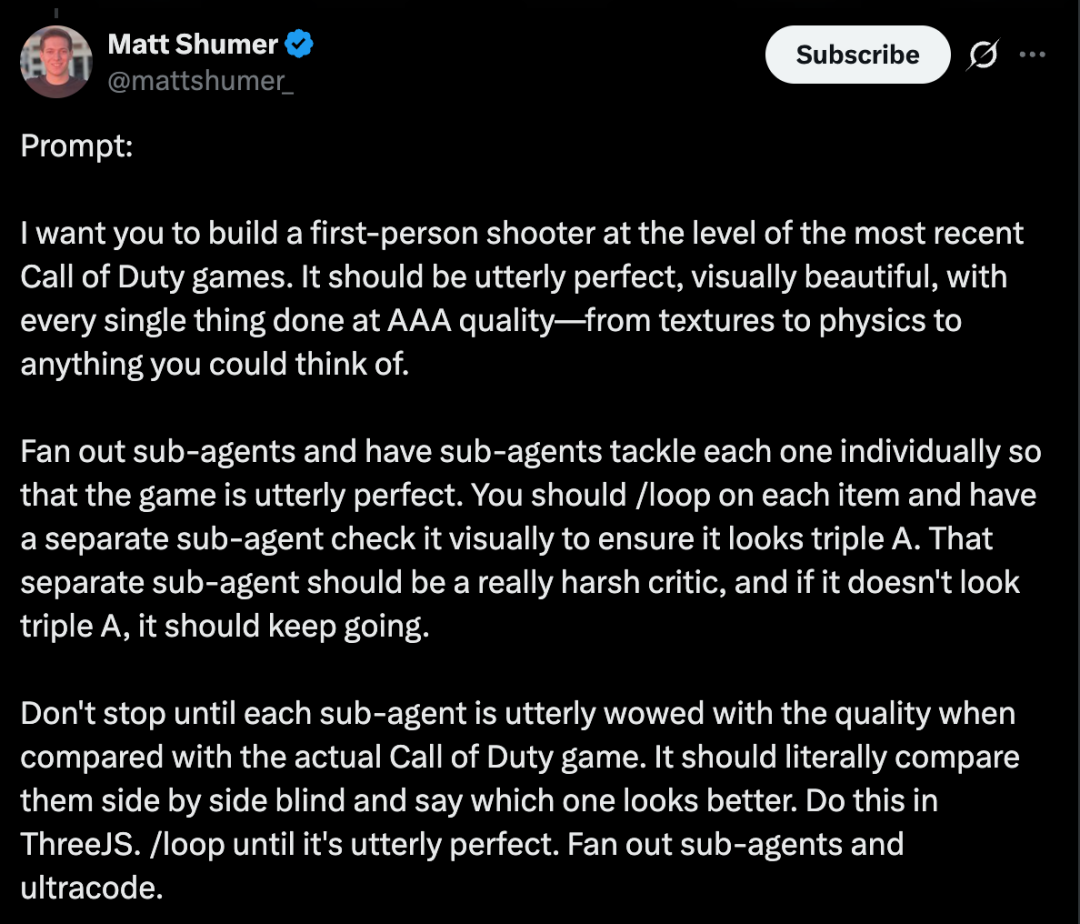
Le flux de travail indiquait à l'agent :
Shumer a ensuite formalisé cette méthode sous le nom de « boucle d'épreuve » (Gauntlet Loop).
Une version simplifiée est présentée ci-dessous :
Objectif
  ↓
Agent principal
  ↓
Décomposition des tâches
  ↓
Agents constructeurs
  ↓
Sortie réelle
  ↓
Évaluation indépendante
  ↓
Comparaison à la référence
  ↓
Réussi ? ── Oui → Intégration
  │
  Non
  ↓
Explication de l'écart maximal
  ↓
Amélioration par le constructeur
  ↓
Répétition
« Faire mieux » est un retour faible, car le modèle doit lui-même définir ce que signifie « mieux ».
La « boucle d'épreuve » donne au juge une référence externe.
Pour un jeu, cela peut être des captures d'écran provenant de titres commerciaux établis.
Pour un site web, cela peut être plusieurs sites leaders dans la même catégorie.
Pour l'ingénierie back-end, cela peut être :
L'objectif n'a pas nécessairement besoin d'être pleinement atteignable. Son rôle est d'empêcher l'agent de déclarer le succès trop tôt.
La deuxième règle clé est l'indépendance.
Le constructeur connaît la raison de chaque choix qu'il a fait et peut facilement défendre ses résultats. Un juge entièrement nouveau reçoit l'artefact réel sans connaître les détails de l'implémentation.
Pour le travail visuel, le juge peut examiner les pixels rendus.
Pour le logiciel, le juge peut vérifier les tests et le comportement à l'exécution.
Pour le travail de performance, le juge peut examiner les mesures réelles.
Le principe plus large est le suivant : la génération et l'évaluation doivent être deux choses distinctes.
La démo initiale de Shumer a été publiée publiquement sous le nom de Claude of Duty.
Son dépôt GitHub décrit un jeu de tir à la première personne basé sur Three.js et WebGL2, comprenant environ 55 000 lignes de code réparties dans ~11 sous-systèmes.
Le dépôt précise que le jeu n'utilise aucune ressource artistique externe. Les textures, les maillages, les animations et les sons sont tous générés procéduralement par le code.
Ses systèmes comprennent :
Dire que le projet a été réalisé « d'un seul coup » ne signifie pas que tout est apparu dans une seule réponse. Selon Shumer, un prompt de haut niveau a lancé une session Claude Code de longue durée, qui a ensuite dérivé des sous-agents, écrit des fichiers, exécuté des outils, rendu le jeu, vérifié les sorties et modifié en continu.
Le dépôt contient les outils suivants :
Son fichier README est également plus prudent que certains posts viraux : il indique clairement que le projet final ne correspond pas au niveau des jeux Call of Duty modernes.
C'est justement ce qui rend l'expérience plus précieuse. Le vrai résultat n'est pas « l'IA a remplacé les studios AAA », mais plutôt : une référence élevée délibérément fixée permet à l'agent de continuer à travailler bien après qu'un prompt ordinaire se serait arrêté.
Ensuite, Anshu Chimala a appliqué un flux de travail similaire à The Long Silence, un jeu d'exploration spatiale procédural dans le navigateur construit avec Claude Opus 5.

Le dépôt public indique que le jeu utilise le WebGL2, un rendu navigateur de style Three.js et du GLSL personnalisé.
Il repose également sur une génération procédurale de contenu basée sur une graine, plutôt que sur le téléchargement d'une bibliothèque d'assets artistiques traditionnels.
L'article source décrit un processus de développement d'environ 24 heures, organisé en trois phases principales.
La première requête demandait de créer un jeu d'exploration spatiale avec Three.js.
Les exigences étaient volontairement de haut niveau :
La majeure partie de la construction du monde et de l'architecture technique était laissée à la discrétion de l'agent.
Cela suit le principe central de cette méthode :
Définir la destination, pas l'itinéraire.
L'article source mentionne également que Claude Code a été connecté à des outils liés à Blender au cours du processus. Le dépôt public contient un répertoire de compétences Claude pour la modélisation de surfaces dures dans Blender, confirmant que des instructions Blender réutilisables font désormais partie du projet.
Une fois la première version jouable terminée, le projet est entré dans une longue phase de raffinement visuel.
Plusieurs sous-agents traitaient chacun différentes zones, tandis qu'un agent d'évaluation comparait des captures d'écran à des références de jeux spatiaux soignés.
L'objectif n'était pas simplement de dire à Opus 5 « rends le jeu plus beau ». L'agent d'évaluation devait identifier les écarts visibles et renvoyer les zones faibles pour une nouvelle itération.
L'article source mentionne que des œuvres comme Starfield ont été utilisées comme références de qualité.
La boucle longue nécessitait également des conditions d'arrêt. Les points d'arrêt utiles incluaient :
La boucle est un mécanisme de pression, et non une garantie que le résultat final sera « parfait ».
Le processus n'était pas entièrement sans intervention humaine.
Selon l'article source, Chimala a supervisé l'avancement à distance et est intervenu lorsque l'agent investissait trop d'efforts dans un domaine précis.
Après la fin de la longue exécution, des sessions Claude supplémentaires ont été utilisées pour :
Ensuite, le modèle a été invité à consolider les leçons réutilisables sous forme de compétence.
Le dépôt public contient :
.claude/skills/blender-hardsurface
C'est un modèle utile pour le travail d'agent sur de longues durées. Un projet peut ainsi produire non seulement des artefacts, mais aussi des connaissances opérationnelles réutilisables : quels outils fonctionnent, quels tests sont importants, ce qui a échoué, et comment les tâches futures devraient être structurées.
L'une des parties les plus remarquables du dépôt public est la
boîte à outils de validation.
Le README documente les commandes suivantes :
node tools/play.mjs
node tools/survey.mjs
node tools/probe.mjs "" --shot out.png
node tools/sheet.mjs a.png b.png --out s.png
node tools/levels.mjs shots/*.png
node tools/judgeset.mjs
Les usages documentés de ces commandes sont :
play.mjs : 17 assertions interactives couvrant le vol, le scan, le repli et le sautsurvey.mjs : captures d'écran des scènes principales et rapport de performancesprobe.mjs : exécution d'une seule expression JavaScript dans le navigateur avec une seule capture d'écransheet.mjs : planche-contact de vignettes pour comparaison visuellelevels.mjs : statistiques de tonalité et d'expositionjudgeset.mjs : reconstruction de l'ensemble d'évaluation visuelle
Le point essentiel est que l'agent n'a pas seulement créé le jeu lui-même, mais aussi les mécanismes permettant de l'évaluer.
C'est l'une des raisons pour lesquelles un agent en exécution longue peut améliorer un résultat de manière plus fiable qu'un simple flux de travail « générer puis s'arrêter ».
Le README documente plusieurs décisions graphiques concrètes :
Le dépôt précise également que la vérification dans le navigateur a été effectuée sur de véritables instances Chromium avec rastérisation GPU activée.
Ces détails sont importants car ils montrent comment le modèle se comporte face à des contraintes d'ingénierie familières : performances, précision, reproductibilité, comportement navigateur et qualité visuelle.
The Long Silence est jouable publiquement dans le navigateur.
Son dépôt fournit les commandes de développement standard :
npm install
npm run dev
npm run build
Le jeu comprend le vol spatial, le scan, des environnements procéduraux, la navigation, des objectifs d'exploration et plusieurs systèmes d'interface.
Cela en fait bien plus qu'un simple modèle statique.
Mais cela ne le rend pas pour autant comparable à un jeu AAA commercial développé par un grand studio sur plusieurs années.
La production de niveau AAA exige généralement de grandes équipes pour couvrir :
La conclusion la plus défendable est la suivante : un développeur peut aujourd'hui orchestrer des agents de codage de pointe pour créer des prototypes jouables, visuellement ambitieux et techniquement non triviaux, à une vitesse qui n'était pas réaliste auparavant.
Les développeurs de la communauté ont commencé à réutiliser ce modèle
Après que Shumer a publié le prompt et le code, ce flux de travail s'est rapidement répandu.
Ryan Campbell a adopté un modèle similaire
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Il a fait progresser en boucle un projet de course de karts dans le navigateur, en itérant sans cesse sur le rendu, les contrôles, le comportement de la caméra et les performances mobiles.
Le répertoire Gauntlet Loop rendu public par Shumer présentait plus tard une expérience de course jouable dans le navigateur, créée avec cette méthode.
Le designer Yogi Suria a partagé un projet Three.js à l'esthétique cyberpunk, inspiré du même modèle de prompt.
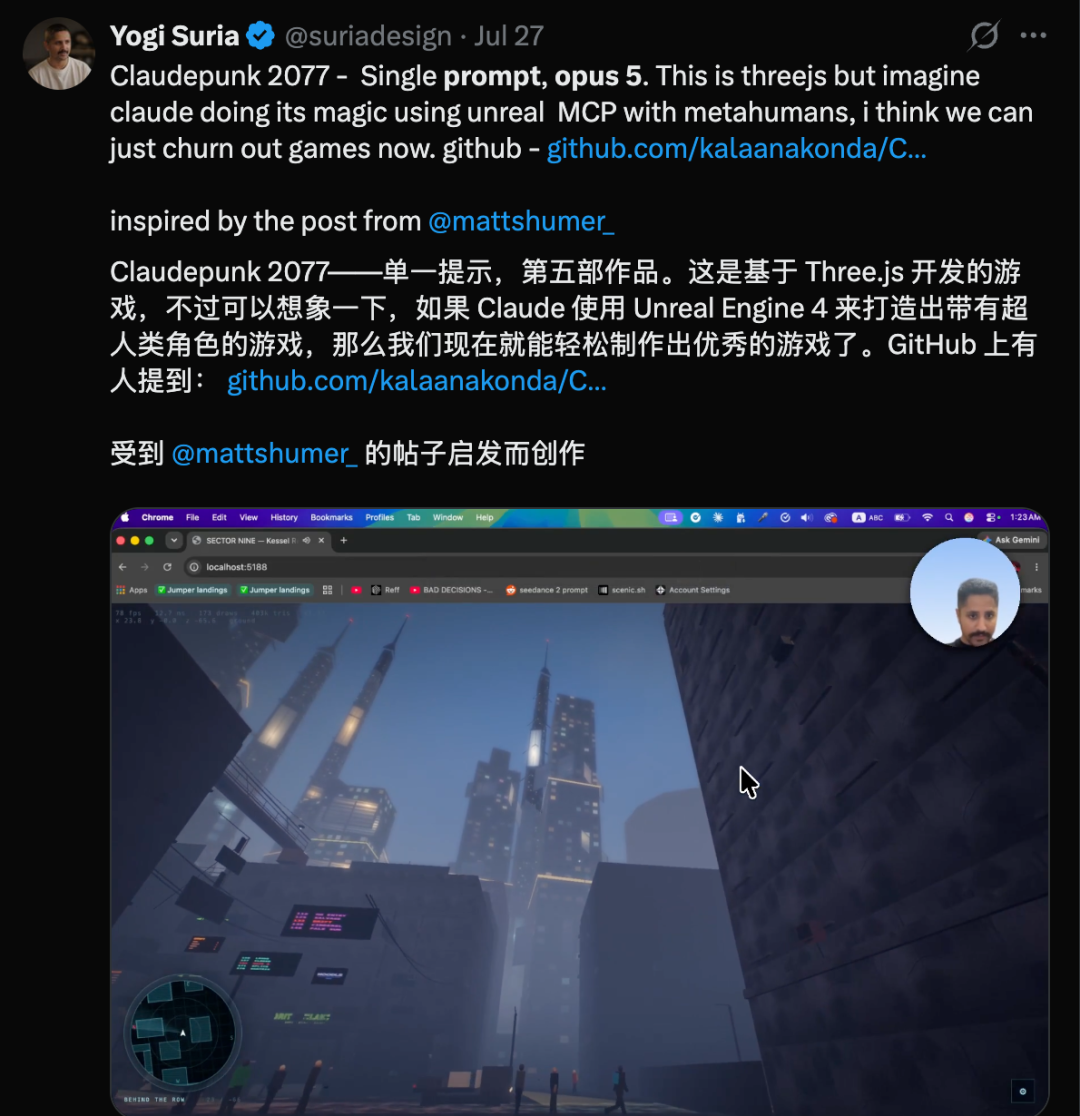
Cet exemple montre que cette méthode ne se limite pas à un genre de jeu particulier. La référence visée, la direction artistique et la chaîne d'outils peuvent changer, tandis que la structure « construire-critiquer-répéter » reste inchangée.
La source d'information a également montré un développeur essayant un prompt similaire avec GPT-5.6 Sol via Codex.
Ce développeur a rapporté un temps de construction d'environ deux heures et a décrit le résultat comme correct, bien que moins raffiné que la démonstration de Shumer.
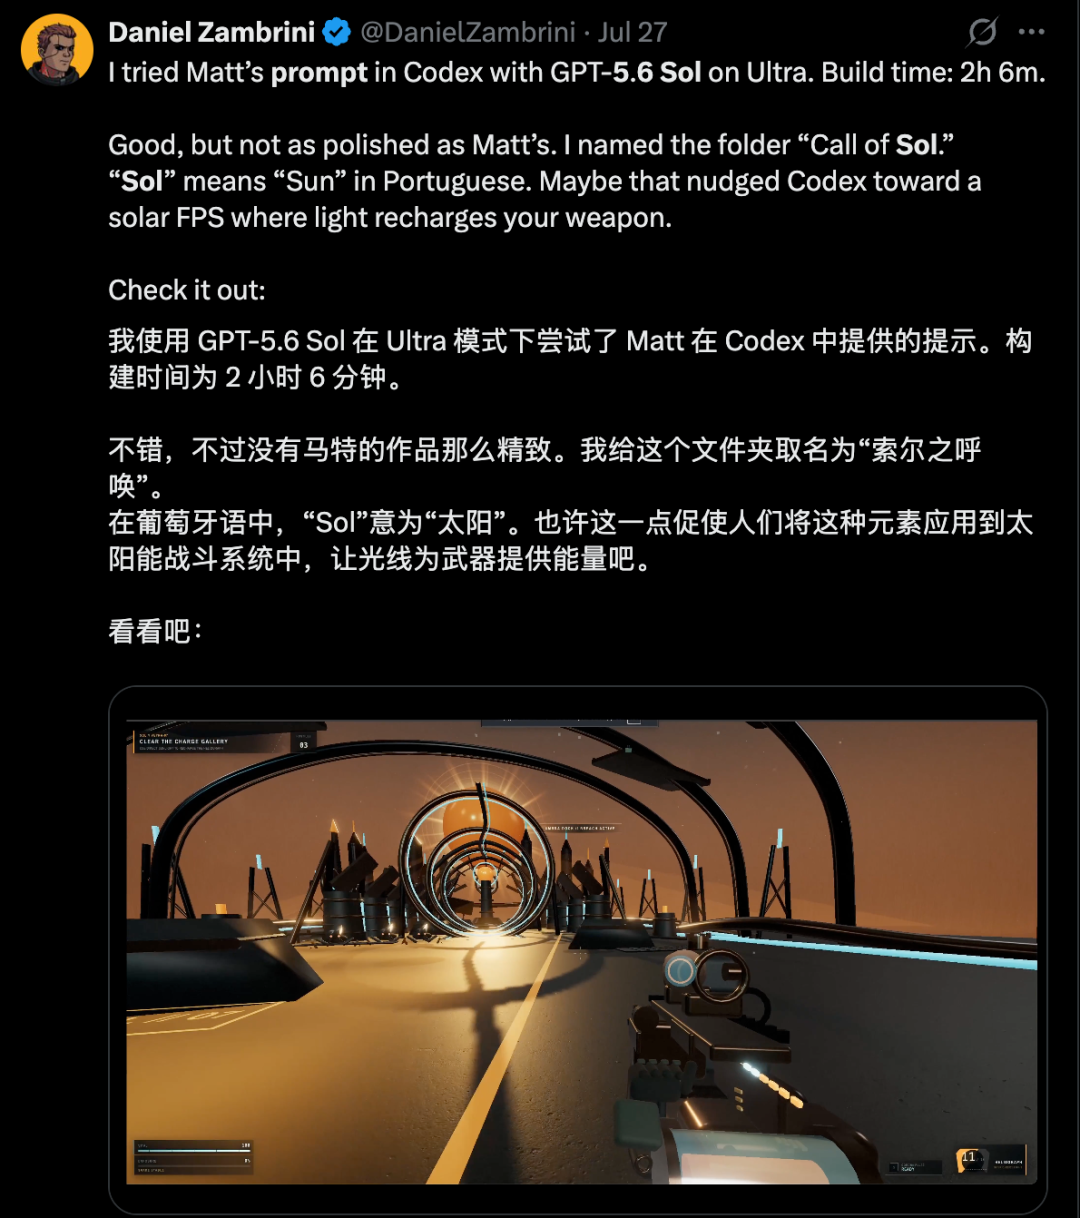
Cela montre que Gauntlet Loop n'est pas intrinsèquement exclusif à Claude.
Ce modèle repose sur un environnement d'agent capable de :
Différents modèles peuvent avoir des performances variables dans la boucle, mais l'architecture est portable.
Le flux de génération traditionnel est généralement le suivant :
Utilisateur → Modèle → Sortie → Utilisateur
Gauntlet Loop ajoute une couche d'évaluation :
Utilisateur
  ↓
Agent principal
  ↓
Constructeur
  ↓
Production
  ↓
Critique indépendant
  ↓
Mesure de l'écart
  ↓
Révision par le constructeur
  ↓
Nouvelle production
Cela crée davantage d'opportunités pour détecter les sorties de faible qualité avant la livraison.
Dire « la page devrait maintenant être réactive » est moins convaincant que d'ouvrir la page à une largeur mobile et de la vérifier réellement.
« Le jeu devrait être plus rapide » est moins convaincant que de mesurer le temps de frame.
« Le rendu semble meilleur » est moins convaincant que de comparer des captures d'écran.
Les meilleurs signaux de retour sont ancrés dans la production réelle.
Le constructeur se souvient de chaque compromis qu'il a fait.
Cela peut biaiser l'évaluation.
Un critique indépendant peut poser une question plus simple : le résultat atteint-il réellement le niveau requis ?
Cela reflète les flux de travail humains. Les développeurs utilisent des tests et des revues de code. Les designers utilisent des revues visuelles et des tests utilisateurs. Les auteurs utilisent des éditeurs.
Les agents IA peuvent reproduire cette séparation à une fréquence plus élevée.
Anthropic a publié Claude Opus 5 le 24 juillet 2026.
Son annonce officielle
met en avant des performances renforcées en matière de codage, de travail multi-étapes de longue durée, de vérification et d'itération.
Anthropic a spécifiquement noté qu'Opus 5 est meilleur pour :
Ces comportements correspondent étroitement à Gauntlet Loop.
Ce prompt ne donne pas de nouvelles capacités au modèle. Il crée une structure qui force le modèle à utiliser à plusieurs reprises ses capacités existantes.
Anthropic a également indiqué qu'Opus 5 est plus efficace qu'Opus 4.8 au même prix de base : 5 $ par million de tokens d'entrée et 25 $ par million de tokens de sortie.
Les agents à longue exécution peuvent toujours rencontrer les problèmes suivants :
Par conséquent, les points de contrôle humains restent utiles.
Le flux de travail le plus puissant n'est pas « ne plus jamais regarder l'agent », mais « laisser l'agent travailler plus longtemps entre deux interventions humaines à forte valeur ajoutée ».
Cette méthode peut être généralisée au-delà du jeu vidéo.
Décrire le résultat souhaité, sans prescrire chaque détail d'implémentation.
Créer un jeu d'exploration spatiale soigné pour le navigateur, avec des contrôles fluides,
une ambiance visuelle forte et des performances stables.
Utiliser des éléments vérifiables par le commentateur.
Pour le travail visuel :
Comparer la lumière, la profondeur, la composition et le raffinement de l'interface à une sélection de captures d'écran de jeux commerciaux de haute qualité.
Pour le logiciel, utiliser des tests, des benchmarks ou des implémentations de référence.
L'agent peut diviser les composants, par exemple :
Pour les composants importants, utiliser :
Le critique doit indiquer la différence opérationnelle la plus significative, plutôt que de dresser une longue liste de plaintes vagues.
Continuer à itérer jusqu'à atteindre un point d'arrêt en termes de qualité, de budget ou de temps.
Des agents parallèles peuvent produire un travail localement bon mais globalement incohérent.
L'agent d'intégration final peut vérifier :
Stocker les parties utiles du processus sous forme de :
Les exécutions suivantes devraient commencer par les leçons apprises précédemment.
Gauntlet Loop est le plus efficace lorsque la qualité peut être mesurée à plusieurs reprises.
Les candidats appropriés incluent :
Mais ce modèle est moins efficace lorsque le critique ne dispose pas de signaux fiables.
Un critique sans captures d'écran, tests,
benchmarks, références ou retours utilisateurs réels pourrait simplement amener le modèle à produire une « opinion » supplémentaire.
Les workflows multi-agents de longue durée peuvent consommer une quantité considérable de ressources de calcul.
Chaque cycle de révision peut nécessiter :
Les moyens pratiques de contrôle budgétaire incluent :
Un critique strict peut améliorer la qualité, mais il peut aussi faire fonctionner le système très longtemps alors que les améliorations restantes ne valent plus la peine.
La boucle Gauntlet est une méthode de prompt multi-agents popularisée par Matt Shumer. Un agent principal décompose l'objectif en tâches plus petites, un agent constructeur produit les résultats, et un agent critique indépendant compare la sortie réelle à une référence concrète — les résultats insuffisants sont renvoyés pour révision.
Selon Shumer, le projet a commencé avec un prompt de haut niveau, mais il n'a pas été généré en une seule réponse de modèle. Claude Code a ensuite travaillé pendant plusieurs heures, créé des sous-agents, écrit environ 55 000 lignes de code, utilisé des outils, vérifié les sorties et itéré.
Non. Ces démonstrations sont des jeux navigateur et des prototypes techniquement impressionnants, mais ils ne sont pas équivalents à des productions AAA commerciales. Le dépôt de code de Claude of Duty indique lui-même que le résultat final ne peut pas être comparé aux jeux Call of Duty modernes utilisés comme référence de qualité.
The Long Silence est un jeu d'exploration spatiale procédurale basé sur navigateur créé par Anshu Chimala. Son dépôt public montre qu'il a été construit avec Claude Opus 5 et comprend un rendu personnalisé, du contenu généré procéduralement et des outils de validation basés sur navigateur.
Un critique entièrement nouveau est moins susceptible de défendre les choix d'implémentation du constructeur. Il peut examiner le produit réel et le comparer à des tests, des captures d'écran, des références ou des exemples avant d'exiger une nouvelle révision.
Non. Cette architecture peut être appliquée à d'autres agents de codage qui prennent en charge les outils, l'édition de fichiers, l'exécution de code, l'inspection visuelle et le travail itératif. La source inclut un exemple avec GPT-5.6 Sol et Codex.
Le flux de travail complet nécessite un environnement d'exécution d'agents, et non une simple interface de chat. Claude Code est une option car il peut gérer des fichiers, exécuter des commandes, connecter des outils et coordonner des tâches de codage de longue durée.
Lorsque les critères de qualité sont flous ou impossibles à mesurer, les boucles de longue durée peuvent gaspiller du temps et des ressources de calcul. Le propriétaire humain doit toujours définir un budget, vérifier la progression, réajuster les priorités si nécessaire et décider du moment où toute itération supplémentaire perd de sa valeur.
Couvre les capacités d'Opus 5 en matière de codage, validation, itération et tâches à cycle long.
Les expériences de jeux Opus 5 devenues virales doivent être comprises comme une démonstration de workflow, et non comme une « génération unique » magique. La boucle Gauntlet combine décomposition des tâches, constructeurs experts, critiques indépendants, critères de qualité concrets et itérations répétées.
The Long Silence montre ce que ce modèle peut accomplir dans un projet d'agent d'environ une journée. Son dépôt public comprend non seulement un jeu jouable, mais aussi des scripts de validation, des outils de capture d'écran, des assertions interactives et des instructions d'agent réutilisables.
Cette méthode repose toujours sur le jugement humain, un budget de calcul, de bonnes références et un environnement de travail pour agents. Elle ne rend pas les prototypes navigateur équivalents aux jeux AAA produits en studio.
Le vrai changement est qu'un objectif de haut niveau peut désormais lancer une boucle « construire – mesurer – critiquer – améliorer » de longue durée, accomplissant bien plus de travail avant qu'un humain n'ait besoin d'intervenir.
Partez d’une phrase et obtenez un site complet en quelques minutes.



