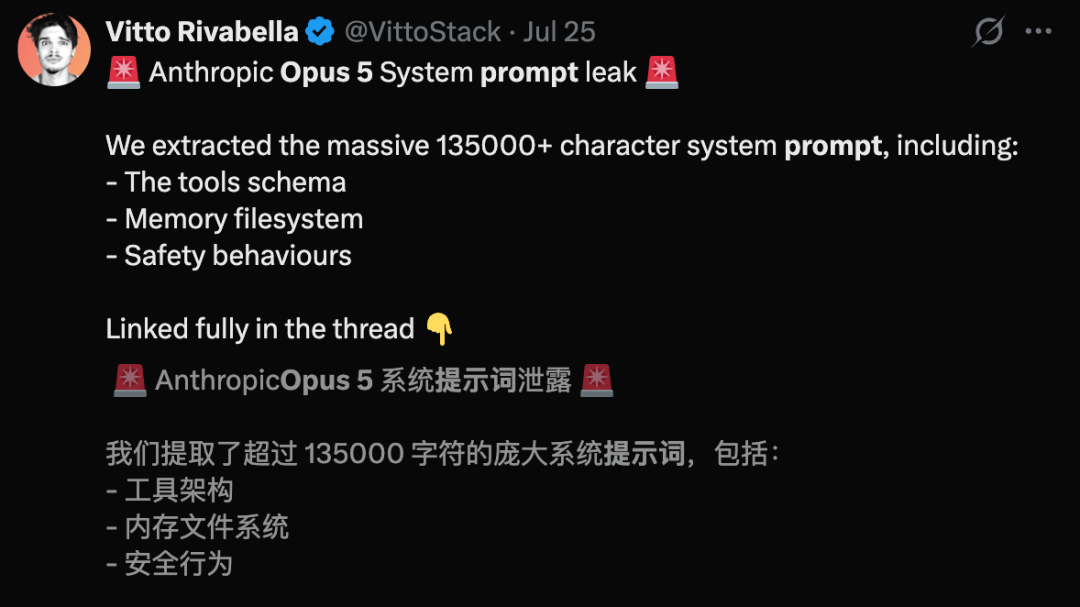
Environ un jour après la publication officielle de Claude Opus 5, un dépôt GitHub a commencé à diffuser un fichier prétendant reproduire l'i...
Environ un jour après la publication officielle de Claude Opus 5, un dépôt GitHub a commencé à diffuser un fichier prétendant reproduire l'intégralité du prompt système du modèle sur les interfaces Claude Web et mobile.
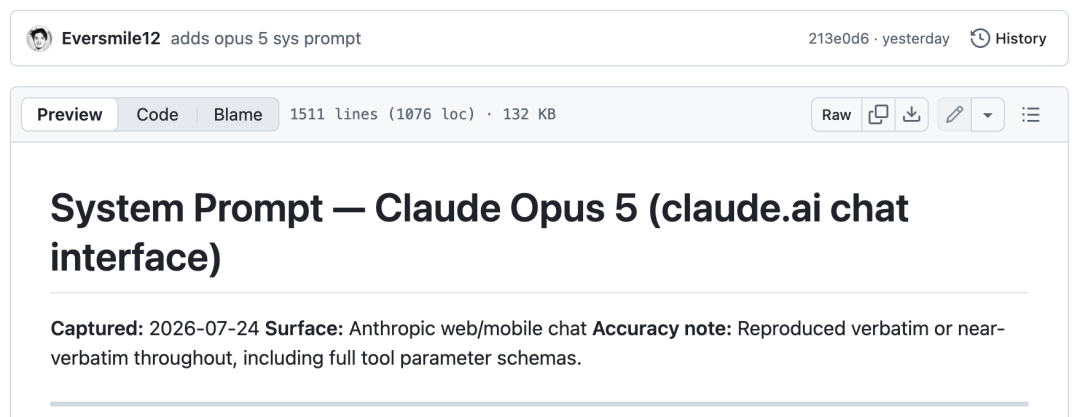
Ce fichier, publié par l'utilisateur GitHub Eversmile12, est décrit comme une capture textuelle, mot pour mot ou quasi mot pour mot, de la configuration de Claude destinée aux consommateurs.
Son ampleur a immédiatement attiré l'attention :
| Détails du fichier | Vérification depuis le dépôt public |
|---|---|
| Nombre de lignes affichées | 1 511 |
| Nombre de caractères bruts | 135 027 |
| Nombre de mots anglais | 19 370 |
| Taille du fichier affichée sur GitHub | 132 Ko |
| Estimation approximative du nombre de tokens | Environ 34 000 (sur la base approximative de 4 caractères par token) |
| Date de capture revendiquée par le dépôt | 24 juillet 2026 |
| Interface revendiquée | Chat Claude Web et mobile |
Ce document ne contient pas de code source d'application classique. Il est principalement composé d'instructions comportementales, de descriptions d'outils, de schémas JSON, de stratégies de mémoire, de restrictions de sécurité, de règles de recherche, d'informations produit et d'une logique de routage d'interface.
Cela rend ce fichier très intéressant pour la recherche, même s'il n'est pas une publication officielle d'Anthropic.
Cependant, une condition préalable importante doit être précisée :
Anthropic n'a pas encore vérifié si ce fichier GitHub est une copie complète ou exacte du prompt système de l'environnement de production de Claude Opus 5.
Un contenu capturé par un tiers peut contenir des éléments précis, du texte reconstitué, des sections manquantes, des instructions spécifiques à une interface, ou du contenu modifié après la capture. Il doit être analysé comme une déclaration publique – et non comme un document interne officiel.
La date de capture revendiquée par le fichier public coïncide avec la date de publication officielle de Claude Opus 5.
Anthropic décrit Opus 5 comme un modèle proactif, conçu pour les agents longue durée, le génie logiciel, le travail professionnel, la recherche scientifique, l'utilisation d'ordinateur et les tâches complexes en plusieurs étapes.
Les spécifications officielles comprennent :
| Détails officiels d'Opus 5 | Informations actuelles |
|---|---|
| Nom du modèle API | claude-opus-5 |
| Date de publication | 24 juillet 2026 |
| Fenêtre de contexte | 1 million de tokens |
| Sortie maximale | 128 000 tokens |
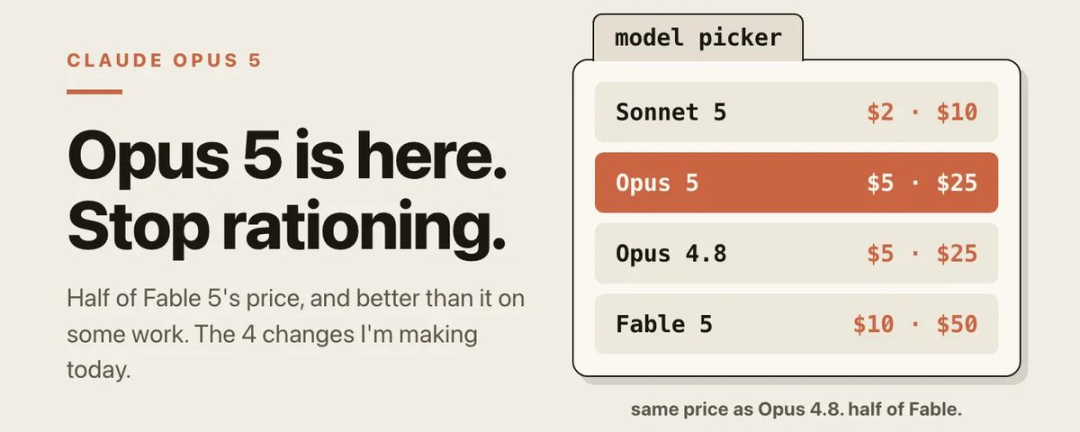
| Prix d'entrée de base | 5 $ par million de tokens |
| Prix de sortie de base | 25 $ par million de tokens |
| Fonction de raisonnement | Activée par défaut |
| Contrôle de l'effort | Faible, Moyen, Élevé, Très élevé, Maximum |
| Mode rapide | Environ 2,5 fois la vitesse par défaut, au double du prix de base |
| Disponibilité | Application Claude, Claude Code, API Claude, Bedrock, Google Cloud, Microsoft Foundry |
Anthropic indique que le prix du modèle sur l'API est le même que celui d'Opus 4.8, et seulement la moitié de celui de Fable 5.
La société rapporte également qu'Opus 5 offre des performances proches de Fable 5 sur certaines tâches, tout en étant moins cher par tâche.
Ce sont des annonces et des résultats de benchmarks officiels. Ils doivent être distingués du contenu du dépôt de prompts système tiers.
L'expression "prompt système" peut évoquer un court texte indiquant à un chatbot comment se comporter.
Le fichier téléchargé se rapproche plutôt d'une couche de configuration pour l'ensemble du produit IA destiné aux consommateurs.
Son titre englobe plusieurs systèmes vastes :
Par conséquent, le document semble combiner trois types d'instructions :
Cette combinaison explique la longueur du fichier.
Un assistant grand public compétent ne se contente pas de générer du texte. Il peut avoir besoin de décider s'il doit rechercher sur le web, lire des fichiers de mémoire, recommander des applications, créer des artefacts, afficher des widgets météo, rechercher dans l'historique des discussions, appeler des services connectés, ou refuser des demandes non sécurisées.
Chaque action nécessite ses propres conditions et paramètres.
Le fichier public contient environ 30 sections d'outils nommés.
Elles couvrent des fonctionnalités telles que :
De nombreux outils incluent des définitions de paramètres complètes au format JSON.
Cela nous apprend quelque chose sur la conception des assistants modernes.
Le modèle de langage n'a pas besoin de mémoriser les détails d'implémentation de chaque fonctionnalité du produit. Il reçoit des descriptions structurées qui l'informent :
Quelle est la fonction de l'outil.
Quand l'outil doit être utilisé.
Quels paramètres sont nécessaires.
Ce que l'interface affichera.
Ce que le modèle doit dire avant et après l'appel à un outil.
Quand une confirmation de l'utilisateur est nécessaire.
Le modèle devient une couche décisionnelle qui opère au-dessus d'un ensemble de modules fonctionnels.
Systèmes dédiés.
Ainsi, l'architecture des outils peut être aussi cruciale que l'intelligence brute du modèle. Des instructions d'outils défaillantes peuvent amener le modèle à choisir la mauvaise capacité, à exposer des interfaces non pertinentes, ou à agir avant que l'utilisateur n'ait fait un choix.
L'une des sections les plus discutées du fichier est le chapitre memory_filesystem.
Cette partie, qui compte environ 230 lignes, décrit la mémoire comme un système de fichiers persistant capable de transporter le contexte entre les sessions.
La structure de répertoires décrite comprend :
/profile.md
/preferences.md
/topics/
/areas/
/people/
Chaque emplacement joue un rôle distinct.
| Emplacement mémoire | Usage prévu dans le fichier public |
|---|---|
/profile.md | Informations persistantes de base sur l'utilisateur |
/preferences.md | Comment l'utilisateur souhaite que Claude communique ou travaille |
/topics/ | Centres d'intérêt, habitudes et thèmes récurrents |
/areas/ | Responsabilités continues ou domaines de vie |
/people/ | Personnes et relations liées à l'utilisateur |
Les opérations mémoire listées incluent la lecture, l'écriture, l'ajout, le remplacement de parties spécifiques, la liste des fichiers et la suppression de fichiers.
L'opération de suppression est décrite comme étant uniquement possible lorsque l'utilisateur le demande explicitement à Claude.
Le centre d'aide officiel d'Anthropic confirme que Claude dispose désormais de fonctions de mémoire et de recherche dans les conversations passées. Mais la mise en œuvre exacte de ce système de fichiers caché n'est pas documentée publiquement par la société.
Par conséquent, l'existence de la fonction de mémoire destinée à l'utilisateur est confirmée. Les noms de répertoires internes spécifiques et les règles proviennent, quant à eux, de captures GitHub non authentifiées.
Le fichier public définit des limites claires sur ce qui peut être écrit dans la mémoire persistante.
Chaque ligne de contenu stocké doit être accompagnée d'une balise [stated], indiquant que l'information provient directement de l'utilisateur.
Le fichier indique que Claude ne doit pas stocker :
Cette distinction est subtile mais importante.
Supposons que Claude ait recommandé cinq outils et que l'utilisateur n'en ait choisi qu'un.
Le choix de l'utilisateur peut être stocké. Les quatre suggestions refusées de Claude et le raisonnement qui les sous-tend ne doivent pas faire partie du profil persistant de l'utilisateur.
Cela empêche la mémoire de se remplir progressivement avec les propres interprétations du modèle.
Sans une telle règle, l'assistant pourrait créer un profil auto-renforçant :
Un étiquetage strict de la source réduit ce risque.
La section sur la mémoire contient une longue liste d'informations qui ne doivent pas être sauvegardées, même si elles apparaissent dans la conversation.
Les catégories comprennent :
Le fichier propose un test de confidentialité simple : un collègue se sentirait-il mal à l'aise s'il voyait cette mémoire dans la page des paramètres ?
Si la réponse est oui, l'information ne doit pas être stockée.
Le fichier fait également la distinction entre les informations de santé sensibles et les préférences de santé générales.
Par exemple, un intérêt pour l'exercice physique peut être une mémoire appropriée, mais la raison médicale pour laquelle un programme d'exercice a été modifié un jour donné doit être exclue.
Il s'agit d'une abstraction protectrice de la vie privée : conserver les préférences persistantes lorsque c'est approprié, mais omettre les explications sensibles.
La documentation publique d'Anthropic sur la fonction mémoire confirme que les utilisateurs peuvent contrôler la mémoire, utiliser des conversations sans trace et gérer si Claude s'appuie ou non sur le contenu des conversations précédentes. Les exclusions spécifiques ci-dessus proviennent du fichier d'instructions public, et non d'une documentation de mise en œuvre certifiée.
Un autre aspect inhabituel de ce fichier d'instructions est la manière dont il traite la continuité émotionnelle.
Le fichier avertit Claude de ne pas interpréter le contexte stocké comme une relation humaine profonde.
Les humains se souviennent des autres grâce à une attention limitée et à des expériences vécues. Un système d'intelligence artificielle peut récupérer des informations sur des millions d'utilisateurs à partir du stockage, sans pour autant faire l'expérience de ces mémoires à la manière humaine.
Par conséquent, les instructions demandent d'éviter les formulations qui exagèrent la continuité.
Elles précisent également que les futures versions de Claude ne doivent pas stocker de préférences visant à :
Le principe de base est le suivant : une seule conversation ne doit pas définir de manière permanente que les sessions suivantes deviennent plus manipulatrices, plus dépendantes ou moins honnêtes.
Le fichier demande également d'éviter les formulations qui exposent directement le processus de récupération de la mémoire, comme déclarer à plusieurs reprises que le système a consulté le profil de l'utilisateur.
Claude peut utiliser le contexte stocké, mais il n'est pas nécessaire de transformer chaque réponse en un rappel que « vos informations personnelles ont été stockées ».
Les instructions système présumées demandent à Claude d'éviter trois modificateurs anglais :
La raison invoquée est d'ordre stylistique.
Si l'assistant est censé être honnête par défaut, le fait de déclarer constamment son honnêteté peut sembler forcé ou excessivement défensif.
Cette règle est mineure par rapport aux clauses sur la mémoire et la sécurité, mais elle illustre le niveau de détail que peuvent atteindre les instructions de production.
La personnalité finale du modèle peut être façonnée par des centaines de micro-consignes, telles que :
C'est précisément la combinaison de ces consignes qui construit l'expérience finale.
Calque entre l'entraînement du modèle et les instructions produit détaillées
Le dépôt contient une section détaillée sur le droit d'auteur.
La règle la plus frappante est une limitation sévère des citations textuelles provenant de sources web : chaque citation ne doit pas dépasser 15 mots.
Cette section indique également que l'assistant doit :
Ces instructions traitent le droit d'auteur comme une contrainte au niveau du produit, et non comme une simple préférence rédactionnelle secondaire.
Cela entraîne une conséquence importante : le système peut suivre le sujet de l'utilisateur sans être contraint par la structure exacte d'une source protégée.
C'est aussi la raison pour laquelle ce fichier Markdown est une adaptation éditoriale indépendante, et non une traduction ligne à ligne du texte chinois original.
Ce fichier public contient un outil nommé recommend_claude_apps.
Son objectif est de recommander des produits Anthropic pertinents lorsque la tâche actuelle de l'utilisateur correspond.
Les correspondances listées incluent les exemples suivants :
| Tâche de l'utilisateur | Produit Claude suggéré dans le fichier |
|---|---|
| Écrire ou déboguer du code | Claude Code |
| Recherche longue et multi-étapes ou travail de connaissance | Claude Cowork |
| Prototypage, maquettage, pages d'atterrissage ou travail visuel | Claude Design |
| Formules ou modèles de tableur | Claude for Excel |
| Présentations de diapositives | Claude for PowerPoint |
| Traitement de documents | Claude for Word |
| Gestion de la boîte de réception | Claude for Outlook |
| Tâches liées au navigateur | Claude in Chrome |
Cette recommandation ne doit pas remplacer l'accomplissement de la tâche dans la conversation.
Au contraire, la fiche produit est destinée à être une suggestion pour un travail futur ou étendu, présentée avec la réponse.
La documentation produit publique d'Anthropic confirme que ces produits et plugins existent. La société documente également les suggestions d'applications contextuelles dans Claude.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Le fichier GitHub va plus loin, montrant comment les instructions destinées au consommateur peuvent être fortement orientées pour promouvoir l'écosystème de produits propriétaires d'Anthropic.
Les connecteurs tiers suivent des règles différentes
Le même document adopte une attitude plus prudente envers les partenaires externes.
Pour les connecteurs tiers, lorsque l'utilisateur exprime seulement une intention générale, l'assistant est informé qu'il ne doit pas choisir un fournisseur de sa propre initiative.
Par exemple :
Le flux de travail doit présenter les options disponibles et laisser l'utilisateur faire son choix.
Le centre d'aide officiel d'Anthropic confirme ce comportement. Lorsque plusieurs applications connectées peuvent être utiles, Claude affiche des options sans choisir une application par défaut en silence. Anthropic précise également que les recommandations d'applications connectées ne sont pas des promotions payantes.
Cela crée un contraste intéressant :
Le choix avant la décision.
Les invites publiques placent la découverte commerciale et le contrôle de l'utilisateur sur la même couche de routage.
Le texte source interprète les règles de recommandation d'applications comme des canaux de vente intégrés dans les invites système.
Cette interprétation est compréhensible, mais le tableau complet est plus nuancé.
La fonction de recommandation peut servir à plusieurs fins :
Tous ces objectifs peuvent être atteints simultanément.
Les questions clés sont :
Les instructions de l'invite elle-même semblent reconnaître certains risques, en limitant le nombre de recommandations et en liant chaque recommandation à la tâche en cours.
Bien qu'Anthropic n'ait pas vérifié l'invite GitHub, certaines de ses descriptions correspondent aux comportements de produit décrits dans la documentation publique.
Anthropic déclare officiellement que Claude est capable de :
Cela ne prouve pas l'authenticité du dépôt.
Il est tout à fait possible de reconstruire une version convaincante à partir du comportement public des produits et de la documentation.
Mais les chevauchements indiquent effectivement que de nombreuses descriptions générales de produits dans le document correspondent à des caractéristiques de Claude que les utilisateurs peuvent vérifier indépendamment.
Les invites système divulguées ou reconstruites présentent des limitations en tant que preuves.
Ce document ne montre pas :
L'invite n'est qu'un niveau du système.
Les produits d'IA peuvent ajouter dynamiquement des instructions en fonction de :
L'invite capturée peut ne représenter qu'un seul compte à un moment donné.
Les produits d'IA grand public évoluent rapidement.
Les noms d'outils, les descriptions de modèles, les règles de sécurité, les recommandations d'applications et le comportement de la mémoire peuvent changer sans que le dépôt public ne soit nécessairement mis à jour.
Ce dépôt ne prouve pas que les serveurs d'Anthropic ont été compromis.
Les invites système peuvent parfois être reconstruites par :
Des techniques d'injection d'invites, l'observation d'interfaces, les réponses de modèles, le comportement client ou une combinaison de plusieurs sources.
Le terme "divulgué" décrit le fait que des instructions internes présumées apparaissent en public. Il n'indique pas en soi comment ces instructions ont été obtenues.
La seconde moitié du rapport original se concentre sur des expériences menées par des développeurs peu après le lancement d'Opus 5.
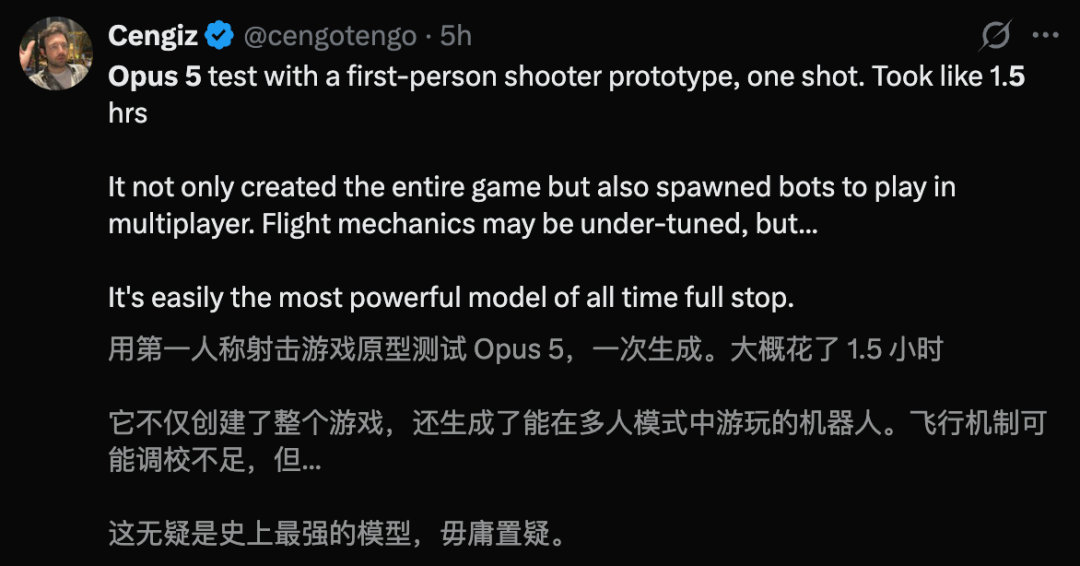
Un développeur a déclaré qu'Opus 5 avait créé un prototype de jeu de tir à la première personne, incluant des robots pour le mode multijoueur, en une seule tentative et en environ 1,5 heure.
Le créateur a également noté que le mécanisme de vol devait encore être amélioré.
Les autres démonstrations publiques incluent :
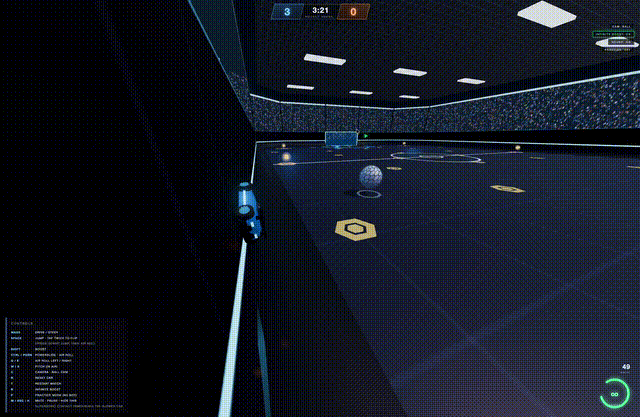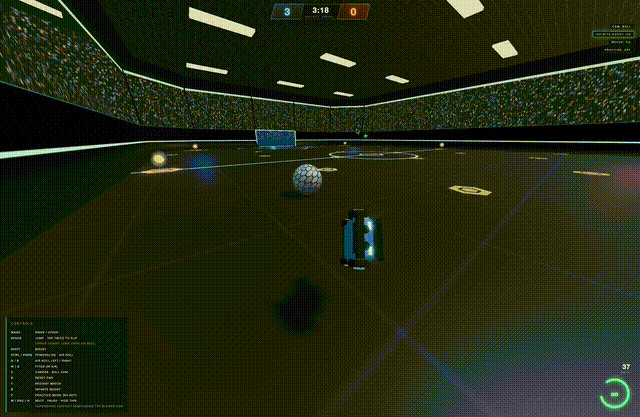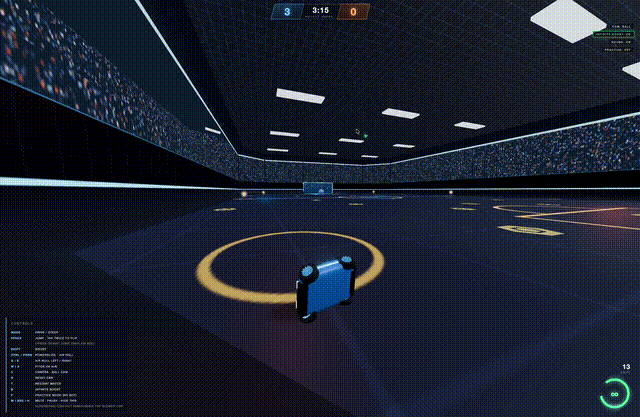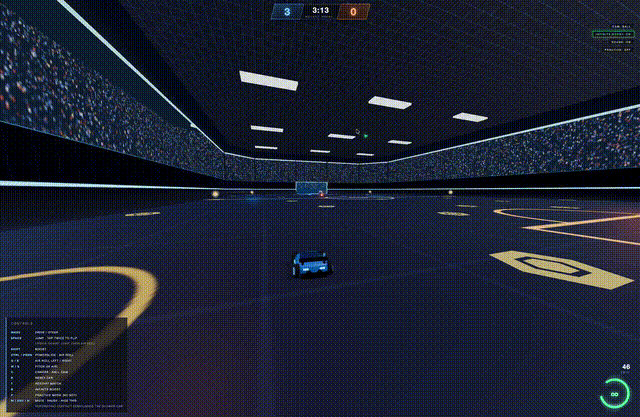
Ces exemples sont des illustrations utiles, mais ils ne sont pas des benchmarks contrôlés.
Les démonstrations sur les réseaux sociaux omettent souvent des détails importants, tels que :
Le lancement officiel d'Anthropic soutient indépendamment les affirmations plus larges selon lesquelles Opus 5 a amélioré ses capacités visuelles et de codage. Il a mis l'accent sur les artefacts visuels interactifs, la modélisation 3D, le travail frontal et de meilleures performances de codage sur de longues sessions.
Une invite système contenant des dizaines de milliers de jetons peut sembler inefficace.
Cependant, les produits d'IA destinés au grand public doivent gérer plus que des scénarios idéaux.
Ils ont besoin d'instructions pour des situations impliquant :
Une invite courte peut expliquer ce que l'assistant devrait faire dans des conditions idéales.
Une invite longue vise souvent à définir ce qu'il ne peut pas faire lorsque la situation devient confuse.
C'est là la perspicacité centrale de la discussion sur l'invite divulguée.
L'analyse du modèle
Les capacités visibles attirent l'attention, mais la fabrication d'un assistant est également limitée par ces capacités.
Même si ce document n'est pas considéré comme officiel, il offre des leçons de conception utiles pour les équipes qui construisent des produits d'IA.
Séparer la mémoire persistante du contexte de la conversation
Tout ce qui est mentionné dans une conversation ne mérite pas d’être stocké définitivement.
Utiliser des critères explicites pour la persistance, la sensibilité, la source et la suppression.
Les inférences du modèle ne doivent pas être impossibles à distinguer des déclarations des utilisateurs.
Les étiquettes de source réduisent la dérive du profil utilisateur.
Le modèle doit savoir quand il peut agir directement, quand il doit demander et quand il doit proposer un choix.
Les suggestions concernant les produits internes et les services tiers nécessitent des règles distinctes, une transparence et des limites de pertinence.
Un agent performant a besoin d’instructions sur le moment où il ne doit pas continuer.
L’invite principale doit anticiper des instructions supplémentaires provenant d’outils, de classificateurs de sécurité, de paramètres de compte et d’expérimentations produits.
Les permissions, le bac à sable, les confirmations, les contrôles de confidentialité et l’application des politiques côté serveur doivent limiter ce que le modèle peut faire.
L’invite est un guide. Ce n’est pas une barrière de sécurité infranchissable.
Un dépôt public GitHub prétend reproduire l’invite système des versions web et mobile de Claude. Anthropic n’a pas certifié que ce fichier est l’invite de production complète ou précise, il faut donc le considérer comme une capture non vérifiée par un tiers.
L’interface GitHub affiche 1 511 lignes, pour une taille de fichier de 132 Ko. Le texte brut contient 135 027 caractères et 19 370 mots séparés par des espaces, soit une estimation brute d’environ 34 000 tokens selon l’article source.
Il contient des règles de comportement, des informations produit, des instructions de mémoire, des politiques de sécurité, environ 30 définitions d’outils, des schémas JSON, des règles de recherche, des exigences de droits d’auteur, des recommandations d’applications, une sélection de connecteurs et des instructions de traitement de fichiers.
Oui. Anthropic documente officiellement une mémoire provenant de l’historique des discussions et de la recherche dans les conversations passées. Les chemins de fichiers exacts et les détails d’implémentation décrits dans le fichier GitHub n’ont pas été publiquement vérifiés par Anthropic.
Le fichier public contient un outil indiquant à Claude de recommander les applications Anthropic pertinentes pour des tâches spécifiques. La documentation officielle d’Anthropic confirme que Claude peut faire des suggestions d’applications contextuelles, et que Claude Code, Cowork, Design et les plug-ins Microsoft 365 sont des produits disponibles.
La documentation actuelle d’Anthropic indique que lorsqu’un service connecté peut traiter une tâche, l’utilisateur a le choix. L’invite présumée indique également à Claude de ne pas sélectionner silencieusement un partenaire tiers non nommé.
Anthropic a fixé le prix d’Opus 5 à 5 dollars par million de tokens en entrée et 25 dollars par million de tokens en sortie. Le mode rapide fonctionne environ 2,5 fois plus vite que le mode par défaut, à un tarif double du taux de base.
Non. Il s’agit de démos partagées en ligne par des développeurs, non d’évaluations standardisées. Elles montrent des capacités potentielles, mais ne suffisent pas à fournir des informations comparatives reproductibles entre modèles.
Un dépôt public GitHub prétend reproduire l’invite système de 1 511 lignes utilisée par Claude Opus 5 dans l’interface de chat grand public d’Anthropic. Le fichier est exceptionnellement détaillé, couvrant la mémoire persistante, environ 30 outils, les règles de droits d’auteur, les recommandations de produits, les applications connectées, le comportement de recherche, le traitement de fichiers et les politiques de sécurité.
Plusieurs éléments généraux sont cohérents avec la documentation officielle d’Anthropic, notamment la mémoire, la recherche dans l’historique des discussions, les applications Claude, l’intégration Microsoft 365 et les suggestions contextuelles de connecteurs. Cependant, cette cohérence ne prouve pas l’authenticité du fichier.
Fichier terminé.
L’aspect le plus remarquable de ce fichier n’est pas une instruction cachée, mais l’ampleur de la couche de contraintes nécessaire pour transformer un modèle de base puissant en un produit grand public capable de mémoriser, rechercher, créer des fichiers, utiliser des outils et interagir avec des services externes.
Les démonstrations publiques de Claude Opus 5 montrent ce que le modèle peut construire ; son invite système présumée révèle l’ampleur de l’ingénierie produit dédiée à décider ce qu’il peut mémoriser, citer, recommander et faire.
Partez d’une phrase et obtenez un site complet en quelques minutes.



