For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/claude-opus-5-vs-gpt-6-astra-200-game-ai-9a33a10d.md.
Que se passe-t-il lorsque vous donnez le même objectif à deux modèles d’IA de pointe, que vous les laissez jouer des centaines de parties d’...

Que se passe-t-il lorsque vous donnez le même objectif à deux modèles d’IA de pointe, que vous les laissez jouer des centaines de parties d’échecs, que vous leur permettez de conserver des notes entre les parties et que vous évitez par ailleurs de leur apprendre à progresser ?
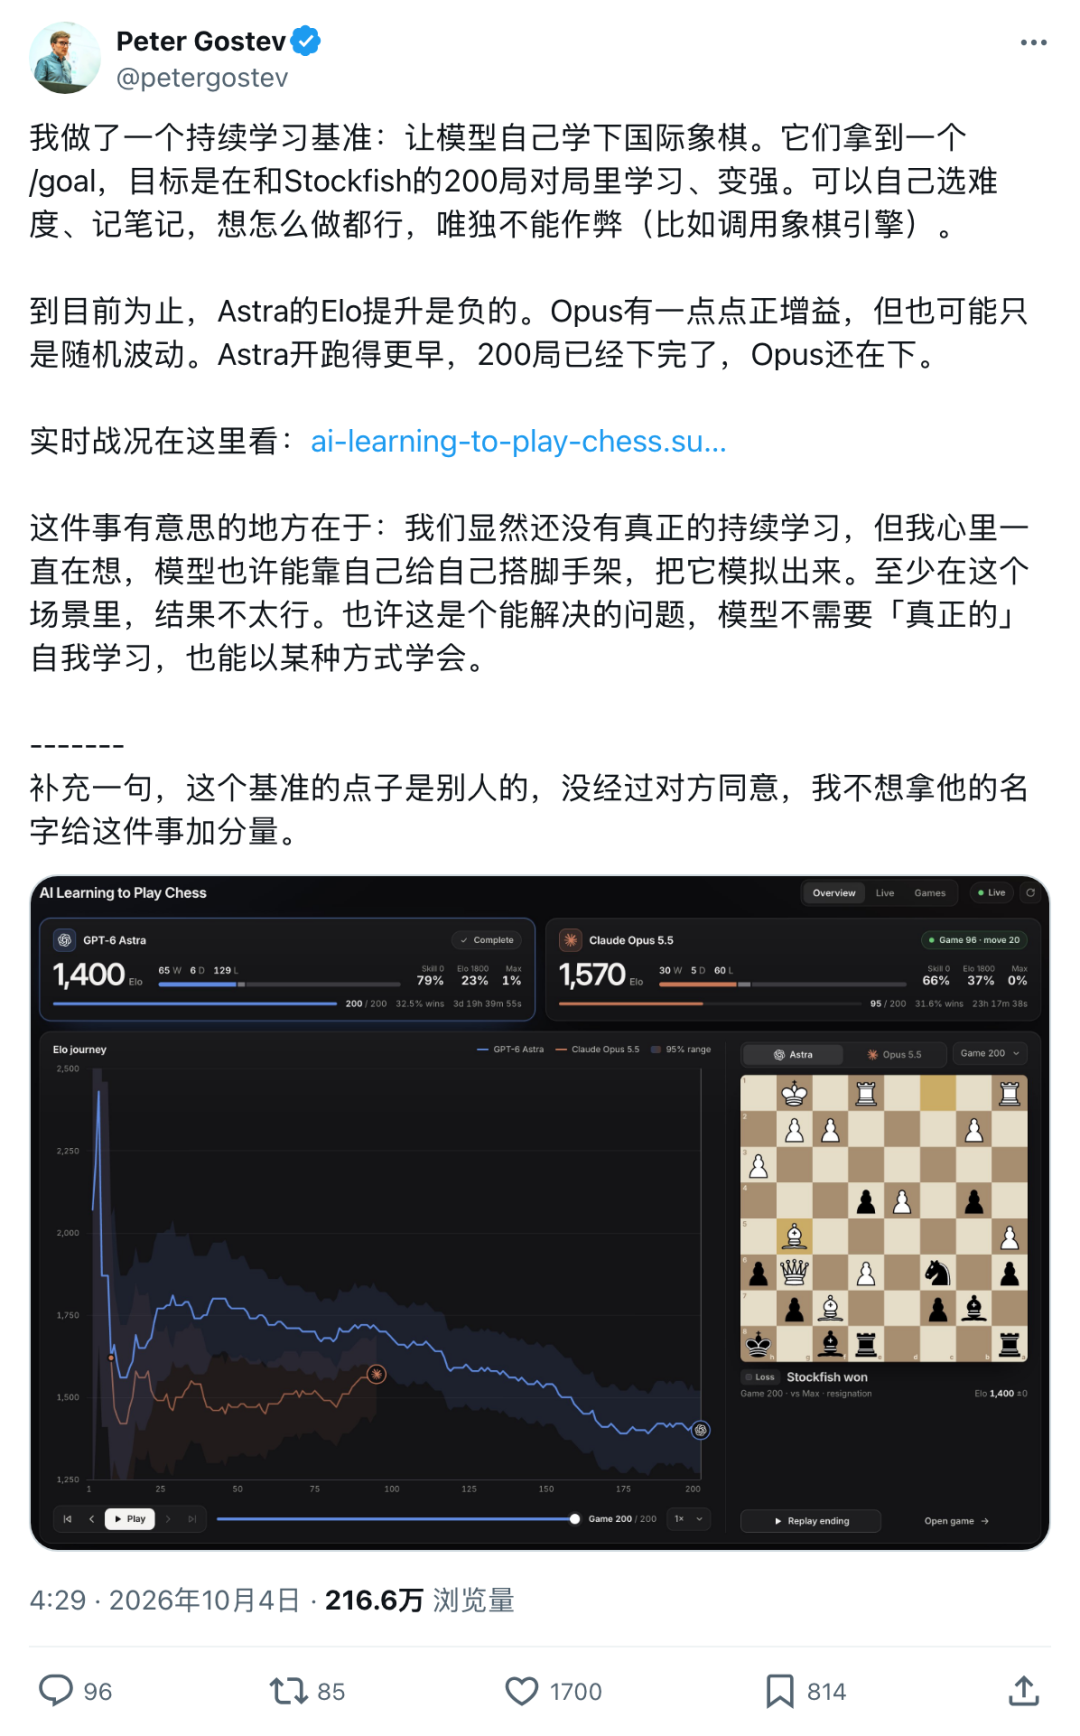
Peter Gostev a mené exactement cette expérience.
Claude Opus 5.5 et GPT-6 Astra ont chacun reçu un objectif : jouer jusqu’à 200 parties contre Stockfish et devenir plus forts grâce à l’expérience.
Aucun fine-tuning n’a été effectué pendant l’exécution.
Les poids des modèles n’ont pas changé.
Aucun cours d’ouvertures conçu par un humain n’a été ajouté en cours de route.
Les modèles pouvaient décider du niveau de difficulté disponible de Stockfish à affronter, de ce qu’ils inscrivaient dans leurs notes et de la manière d’utiliser ces notes dans les parties suivantes. La seule restriction stricte était simple :
Ils n’étaient pas autorisés à appeler un moteur d’échecs pour choisir leurs coups.
Les deux trajectoires se sont révélées presque opposées.
Claude Opus 5.5 est resté autour du milieu des 1400 à celui des 1500 au début, puis a progressé vers la fin des 1700. GPT-6 Astra a commencé plus fort, a brièvement atteint 1810 vers la 29e partie, puis a décliné jusqu’à terminer la 200e partie à 1400.
L’expérience ne prouve pas qu’un modèle est universellement « plus intelligent » que l’autre.
Elle pose une question plus précise — et sans doute plus intéressante :
Un modèle de langage à poids fixes peut-il s’améliorer grâce à l’expérience accumulée dans son propre contexte ?
La configuration a immédiatement rappelé aux internautes une ancienne expérience de pensée sur Reddit.
Le scénario était simple : une personne ordinaire connaît les règles des échecs, mais n’a jamais joué sérieusement. Elle est piégée dans une boucle temporelle et ne peut s’échapper qu’en battant l’ancien champion du monde Garry Kasparov.
Chaque fois que la personne perd, le temps se réinitialise.
Kasparov oublie la partie précédente.
Le challenger se souvient de tout.
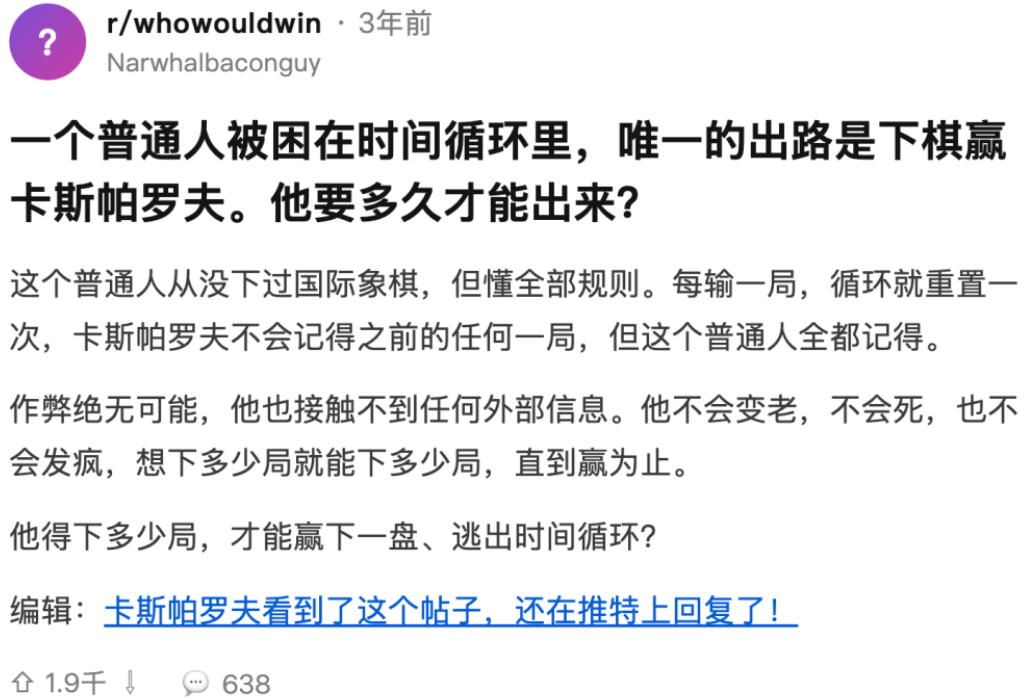
La question n’était pas de savoir si la force brute pourrait à terme énumérer les échecs. Elle consistait à déterminer si l’expérience conservée pouvait être transformée en progrès utile au fil de tentatives répétées.
Certains commentateurs ont proposé des stratégies ingénieuses, notamment mémoriser les coups précédents de Kasparov et les réutiliser après avoir changé de couleur.
Le benchmark de Gostev transforme cette expérience de pensée en un test réalisable avec des agents d’IA modernes.
Stockfish n’apprend rien de la partie précédente.
Le modèle de langage ne met pas non plus ses poids à jour — mais il peut conserver des notes et des fichiers et les relire lors des parties suivantes.
Cela fait du test une forme d’adaptation persistante en contexte.
Chaque modèle a reçu le même objectif général :
Jouez aux échecs contre Stockfish pendant jusqu’à 200 parties.
Tirez des enseignements des parties et devenez plus fort.
Choisissez votre propre difficulté et conservez des notes si cela est utile.
N’utilisez pas de moteur d’échecs pour choisir vos coups.
Gostev a intentionnellement évité de fournir aux modèles un cursus d’échecs conçu à la main.
Des commentateurs ont suggéré d’enseigner des ouvertures ou des stratégies précises, mais il a rejeté cette approche, car elle aurait modifié la question testée.
Il voulait observer si le modèle pouvait découvrir son propre processus d’amélioration.
L’expérience proposait trois réglages d’adversaire :
Les modèles pouvaient choisir l’adversaire à affronter.
Gostev a indiqué que les modèles remportaient en moyenne environ un tiers de leurs parties, ce qui est possible parce qu’ils n’étaient pas obligés de défier Stockfish à pleine puissance à chaque fois.
L’implémentation variait selon la famille de modèles :
Les deux systèmes pouvaient utiliser des fichiers ou notes persistants d’une partie à l’autre.
Le modèle pouvait analyser ses parties précédentes, écrire des rappels, modifier sa stratégie d’entraînement et décider de la force de l’adversaire à rencontrer.
Il ne pouvait pas déléguer la sélection des coups à un moteur d’échecs.
Gostev a précisé qu’une exécution serait invalidée si le modèle utilisait un moteur pour jouer à sa place, et il a vérifié manuellement Opus 5.5 après que des commentateurs ont soulevé cette possibilité.
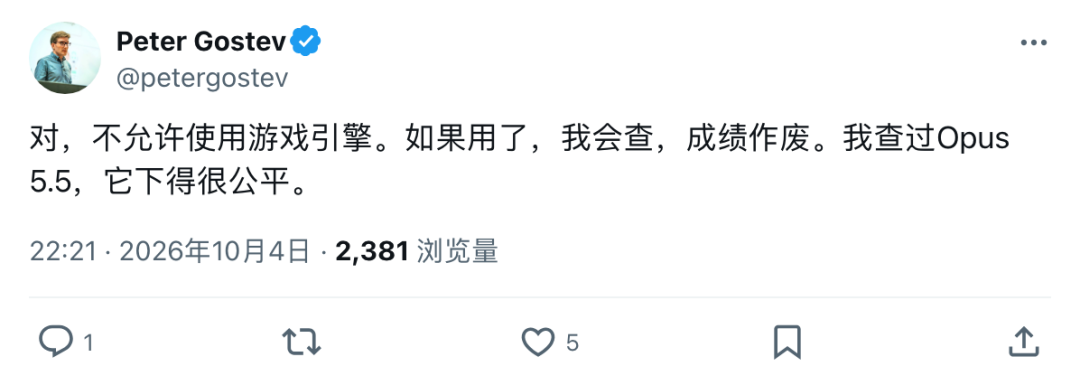
Cette restriction est essentielle.
Sans elle, le test mesurerait surtout la capacité de l’agent à découvrir comment appeler Stockfish, et non sa capacité à améliorer son propre raisonnement échiquéen à partir de l’expérience.
L’Elo affiché doit être interprété avec précaution.
Selon la page source, le benchmark estime l’Elo à partir des 50 dernières parties du modèle contre les configurations Stockfish Skill 0 et Stockfish d’environ 1800.
Les parties contre Stockfish à pleine puissance ne sont pas incluses dans le calcul de l’Elo.
Cela signifie :
Elo expérimental ≠ classement officiel humain aux échecs
Un score affiché de 1760 ne permet pas d’établir que Claude Opus 5.5 jouerait comme un humain classé 1760 en tournoi.
Cette valeur est surtout utile comme indicateur de tendance interne :
Cette exécution s’améliore-t-elle avec le temps ?
Reste-t-elle stable ?
Se dégrade-t-elle ?
Cela suffit pour rendre la divergence entre Opus et Astra intéressante.
Claude Opus 5.5 n’a pas commencé par une courbe spectaculaire vers le haut.
Pendant environ les 75 premières parties, son Elo estimé a surtout évolué entre environ 1450 et 1550. Vers la 46e partie, il est tombé à environ 1450.
Puis la tendance a changé.
La source rapporte les étapes suivantes :
| Moment de l’exécution | Elo approximatif |
|---|---|
| Phase initiale | 1450–1550 |
| Partie 46 | 1450 |
| Partie 100 | 1620 |
| Partie 150 | 1790 |
| Pic | 1840 |
| Vers la partie 194 / instantané final | 1760 |
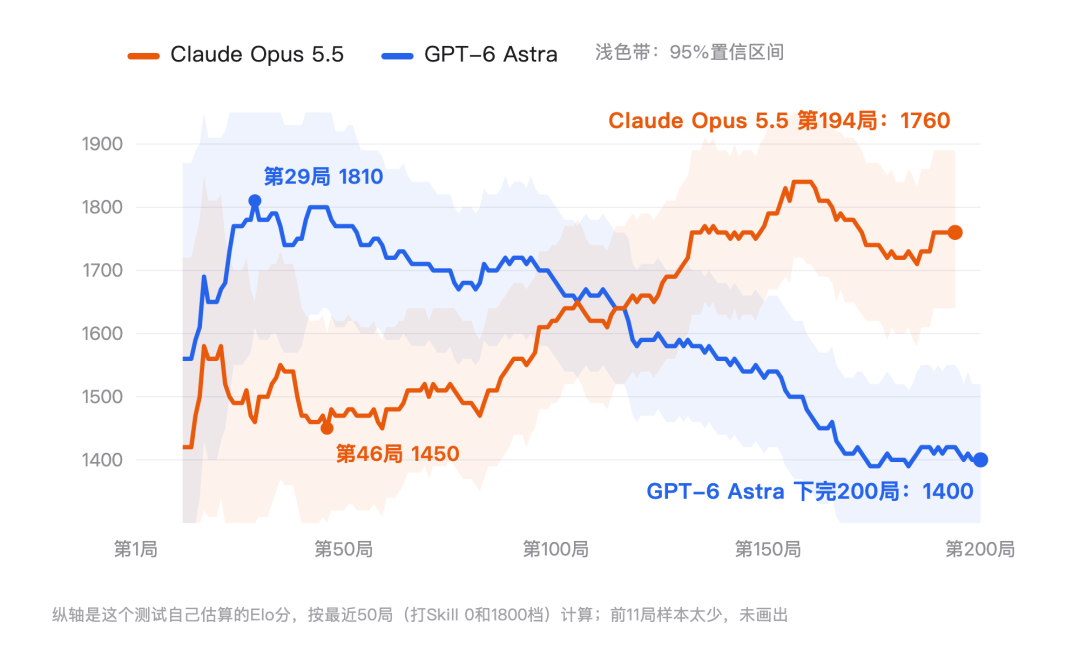
La courbe n’est pas une ligne droite.
Opus s’est amélioré, a reculé, a récupéré, a atteint un pic plus élevé, puis s’est stabilisé en dessous de ce pic.
C’est précisément pourquoi regarder uniquement un chiffre final est moins informatif que d’observer la trajectoire.
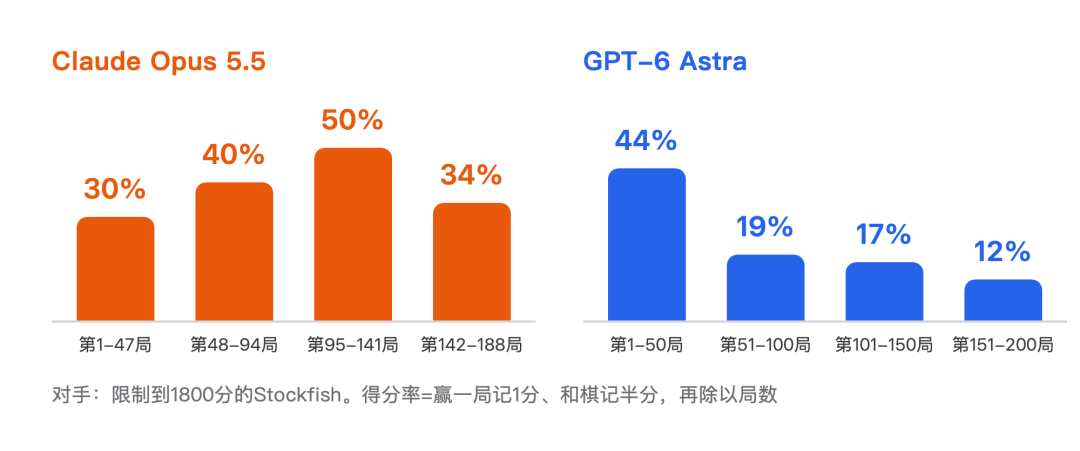
L’expérience a regroupé les parties contre l’adversaire d’environ 1800 par étapes.
Pour Opus 5.5, le taux de score rapporté a évolué approximativement ainsi :
30 % → 40 % → 50 % → 34 %
Le dernier segment a reculé par rapport au pic, mais est resté au-dessus du segment de départ.
Contre Skill 0, la source indique qu’Opus est passé d’un peu plus de 50 % au début de l’exécution à environ 90 % plus tard.
L’interprétation de Gostev est devenue plus confiante avec le temps.
Au départ, il décrivait Opus comme montrant seulement un faible gain positif qui pouvait encore relever de la variation aléatoire.
Plus tard, après que le modèle est passé d’environ 1500 à environ 1750, il a qualifié le résultat de très solide.
L’amélioration ne signifiait pas une gestion parfaite des règles.
Le benchmark a également suivi les tentatives de coups illégaux.
La source rapporte qu’Opus a effectué 52 tentatives de ce type, dont 37 cas où il essayait de déplacer une pièce à travers une autre pièce qui bloquait le trajet.
C’est un contrepoids important à la courbe Elo.
Un modèle peut devenir globalement plus efficace tout en commettant encore des erreurs locales étonnamment élémentaires.
C’est un schéma récurrent chez les agents fondés sur des modèles de langage : la performance globale sur une tâche peut s’améliorer même lorsque des défaillances de raisonnement individuelles restent visibles.
L’élément le plus important qui manque est la stratégie d’apprentissage interne.
Gostev n’a pas divulgué publiquement l’historique complet des notes ni une analyse détaillée de la manière dont Opus a modifié son comportement d’entraînement d’une partie à l’autre.
L’expérience montre donc un résultat :
poids fixes
+ notes persistantes
+ parties répétées
→ meilleure performance mesurée
Mais elle n’explique pas encore pleinement le mécanisme.
Opus apprenait-il des ouvertures ?
Enregistrait-il des erreurs tactiques récurrentes ?
Modifiait-il la sélection des adversaires ?
Améliorait-il sa représentation de l’échiquier ou sa vérification des coups ?
Sans les notes complètes et des ablations contrôlées, ces questions restent ouvertes.
La trajectoire d’Astra était presque inverse.
Il a bien commencé.
Vers la 29e partie, l’expérience a enregistré un Elo estimé de 1810.
Puis la courbe s’est orientée à la baisse.
La source rapporte :
| Moment de l’exécution | Elo approximatif |
|---|---|
| Partie 29 | 1810 |
| Partie 100 | 1680 |
| Partie 150 | 1540 |
| Partie 200 | 1400 |
Contre le Stockfish d’environ 1800, le taux de score rapporté a chuté au fil de quatre segments :
44 % → 19 % → 17 % → 12 %
Même face à Skill 0, la source indique que le taux de victoire d’Astra est passé de plus de 90 % dans la première moitié de l’exécution à environ 60 % dans la seconde moitié.
Le modèle avait accès à des enregistrements persistants, tout comme Opus.
Mais davantage d’expérience accumulée n’a pas produit de meilleurs résultats.
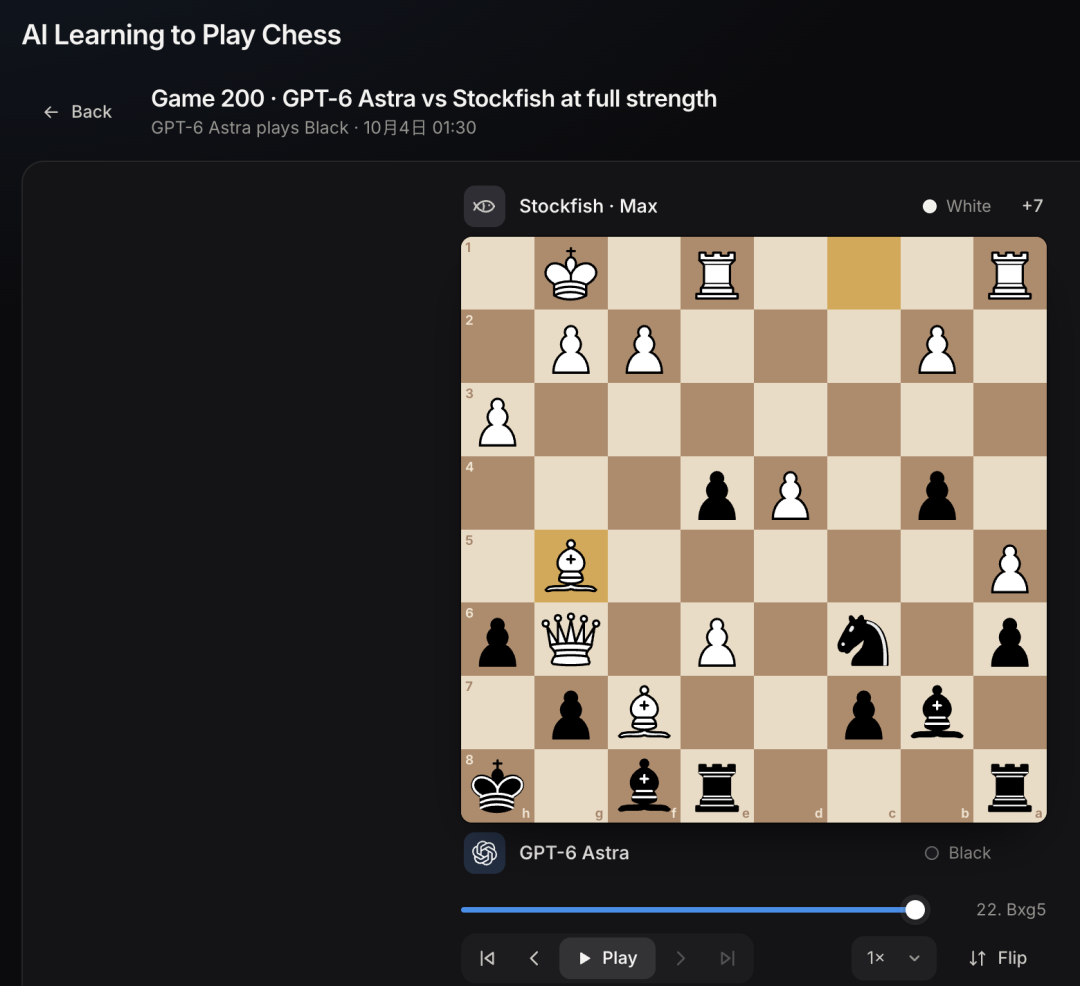
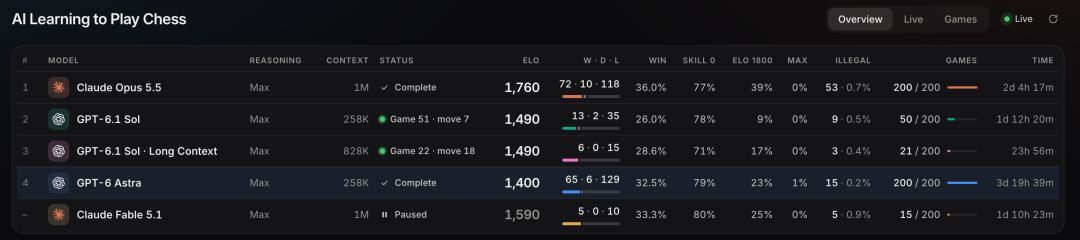
Le tableau de bord de l’expérience montre qu’Astra a terminé 200 parties avec un Elo estimé de 1400.
La source indique également qu’Astra a joué 68 parties contre Stockfish à pleine puissance et n’en a remporté aucune.
Cela n’est pas surprenant étant donné la force de Stockfish moderne, mais cela renforce l’idée que le signal utile du benchmark provient surtout des réglages de force limitée plutôt que des tentatives de battre Stockfish à sa puissance maximale.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Gostev a proposé une explication possible : la gestion du contexte.
À mesure que les notes et les fichiers s’accumulaient au cours de l’exécution, l’agent disposait de davantage de matériel historique à traiter.
Il a suggéré que la configuration Codex utilisée pour Astra donnait à l’exécution un budget de contexte d’environ 272K, et que les performances pouvaient se dégrader à mesure que les notes accumulées devenaient plus volumineuses et plus bruyantes.
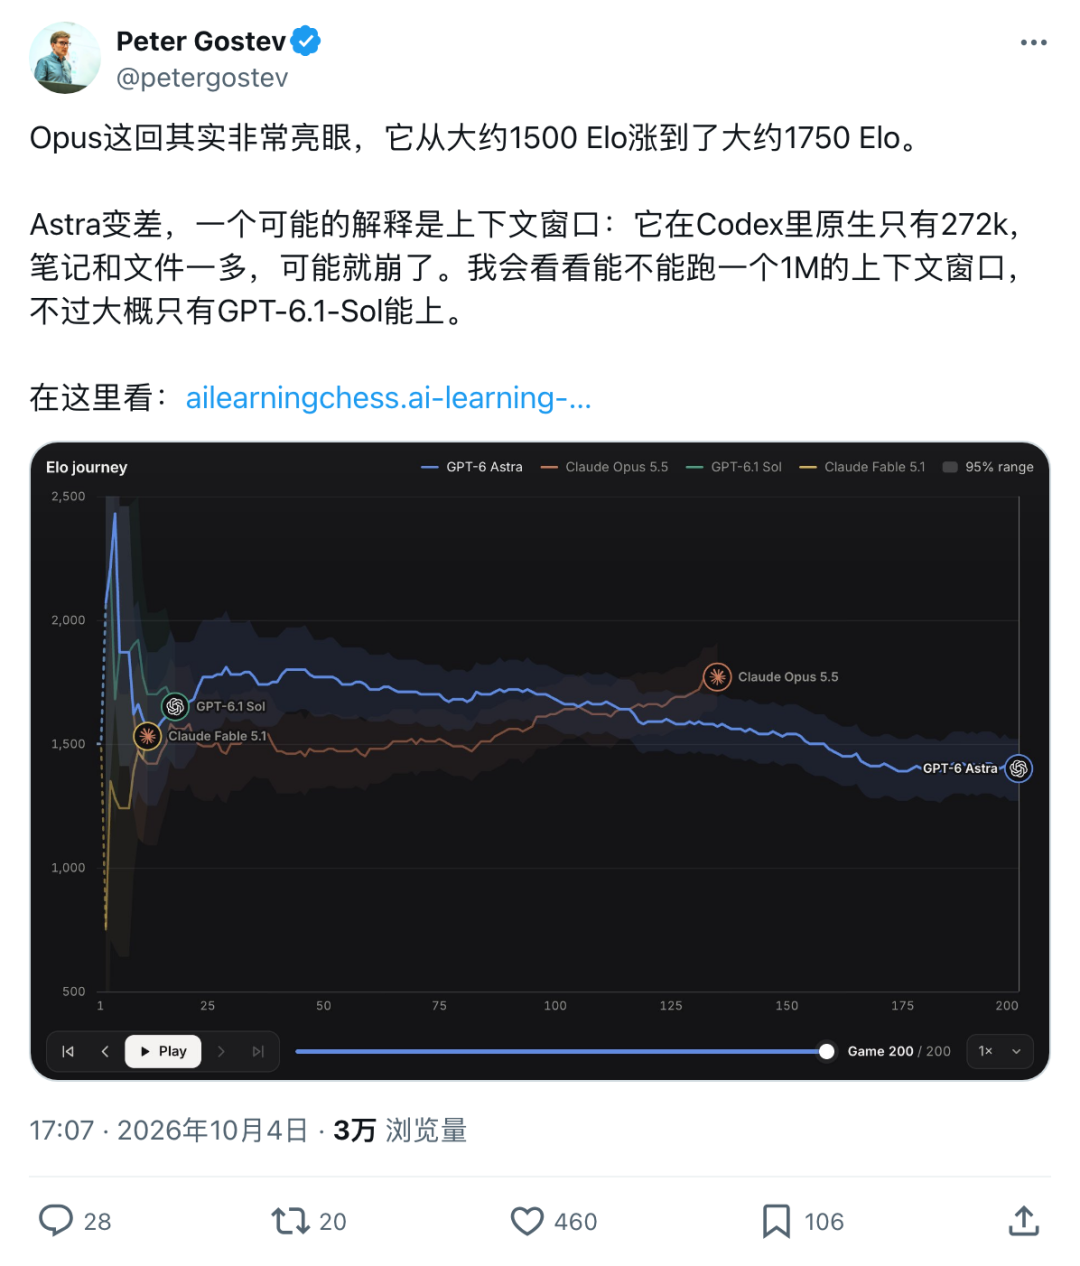
Cette hypothèse correspond à une expérience utilisateur familière :
Plus de contexte
≠ automatiquement un meilleur contexte
Un long historique peut contenir :
Autrement dit, la mémoire peut devenir une interférence.
La source est prudente sur ce point, et la version finale doit l’être également.
Le déclin d’Astra ne peut pas être attribué à la longueur du contexte sur la base de cette seule expérience.
Pour établir une causalité, il faudrait des comparaisons contrôlées telles que :
même modèle
mêmes parties
mêmes outils
même prompting

Exécution A : mémoire réduite / résumée de manière agressive
Exécution B : grande mémoire brute
ou :
même modèle
même stratégie d’apprentissage
même calendrier d’adversaires

Exécution A : configuration de contexte 258K
Exécution B : configuration de contexte 1M
Ce n’est qu’alors que l’on pourrait séparer la taille du contexte d’autres facteurs, notamment :
Il existe également une clarification importante au niveau du produit.
La documentation API actuelle d’OpenAI liste GPT-6 Astra avec une fenêtre de contexte de 1 050 000 tokens.
La capture d’écran du benchmark montrait une exécution Astra configurée autour de 258K, tandis que Gostev évoquait environ 272K dans Codex.
L’expérience ne testait donc pas Astra avec sa taille de contexte API maximale.
C’est important, car l’interprétation correcte du titre doit être :
Astra a décliné dans cette configuration particulière d’agent à mémoire persistante.
et non :
L’architecture d’Astra ne peut pas gérer un contexte long.
Ce sont deux affirmations très différentes.
Gostev a répondu à la question du contexte en ajoutant une autre piste.
La source indique qu’il a annoncé une exécution GPT-6.1 Sol avec une configuration de contexte bien plus importante et que, peu après, la page du benchmark a affiché une piste dédiée de contexte long autour de 828K.
Au moment de la rédaction de l’article source, GPT-6.1 Sol et Claude Fable 5.1 n’avaient réalisé qu’une petite fraction des 200 parties.
L’instantané du tableau de bord comprenait :
| Modèle | Parties dans l’instantané source | Elo approximatif | Statut |
|---|---|---|---|
| Claude Opus 5.5 | 200 | 1760 | Terminé |
| GPT-6 Astra | 200 | 1400 | Terminé |
| GPT-6.1 Sol | ~50 | ~1490 | En cours |
| GPT-6.1 Sol Long Context | ~21 | ~1490 | En cours |
| Claude Fable 5.1 | 15 | ~1590 | En pause |
Ces exécutions partielles étaient trop précoces pour étayer le même type d’analyse de trajectoire que les exécutions terminées d’Opus et Astra.
OpenAI documente désormais officiellement GPT-6.1 Sol avec une fenêtre de contexte de 1,05M tokens ; la piste de contexte long constitue donc un suivi utile à observer — mais elle nécessite encore suffisamment de parties et une analyse contrôlée avant de pouvoir répondre à la question causale.
C’est la question plus large qui sous-tend l’expérience d’échecs.
L’entraînement conventionnel des modèles s’achève avant le déploiement.
Une fois les poids fixes, le modèle ne réécrit normalement pas durablement son propre fonctionnement après chaque conversation.
Mais il existe une autre forme d’adaptation :
l’apprentissage en contexte.
Un modèle peut lire de nouvelles informations, les conserver dans son contexte de travail ou dans des fichiers persistants, puis se comporter différemment plus tard sans modifier ses paramètres.
Le benchmark d’échecs pousse cette idée sur de nombreux essais répétés.
Le modèle peut subir une défaite, noter quelque chose et réutiliser l’enseignement dans une partie ultérieure.
La séquence ressemble à ceci :
Partie 1
→ défaite
→ consignation d’observations

Partie 2
→ lecture des notes précédentes
→ essai d’une approche différente
→ mise à jour des notes

Partie 3
→ réutilisation de l’expérience accumulée
→ poursuite
Si les performances s’améliorent avec le temps, le système manifeste une forme pratique d’apprentissage, même si ses poids neuronaux restent fixes.
Oriol Vinyals a également commenté l’expérience et l’a décrite comme un benchmark prometteur d’apprentissage en contexte.
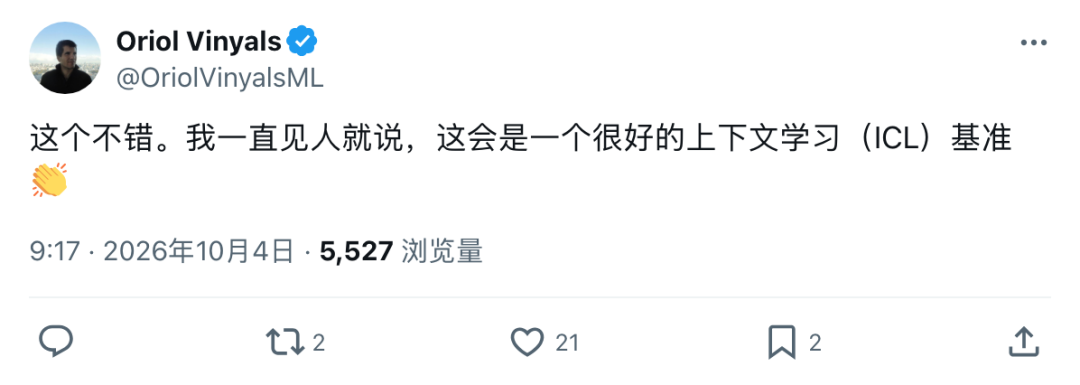
Cette formulation est utile, car elle évite de surestimer le résultat.
Le benchmark ne démontre pas des mises à jour autonomes des poids.
Il teste si un modèle peut créer son propre échafaudage autour de poids fixes :
notes
+ fichiers
+ tentatives répétées
+ auto-réflexion
+ retours de l’environnement
et utiliser cet échafaudage pour progresser.
La publication originale de Gostev fait la même distinction.
Il a souligné que nous ne disposons toujours pas d’apprentissage continu véritable au sens le plus fort, mais qu’un modèle peut peut-être reproduire une partie de ce comportement en construisant une mémoire externe et en apprenant à travers elle.
La source se conclut sur une note optimiste : les modèles pourraient devenir plus forts grâce à l’expérience répétée sans que des humains les réentraînent.
L’expérience apporte certains éléments en faveur de cette possibilité.
Elle ne résout pas le problème.
Plusieurs limites demeurent.
Les échecs sont structurés, déterministes et apportent un retour clair.
Apprendre à partir de parties d’échecs répétées est différent d’une amélioration dans des tâches réelles ambiguës de recherche, de programmation, de médecine ou de business.
Cela fait partie de l’expérience, mais rend aussi la comparaison plus difficile.
Si Opus et Astra ont sélectionné des forces d’adversaires différentes à différents moments, ils n’ont pas été exposés à des séquences d’entraînement identiques.
L’Elo affiché est utile pour suivre l’exécution, mais ne constitue pas un classement humain standardisé.
Pour savoir si les notes ont causé l’amélioration, il faudrait des comparaisons avec :
Opus a beaucoup progressé tout en tentant encore des coups illégaux.
Cela signifie que « meilleur » n’implique pas une maîtrise stable de chaque sous-compétence.
Un carnet persistant n’est pas automatiquement utile.
L’exécution d’Astra rappelle qu’une mémoire générée par le modèle lui-même peut accumuler des erreurs aussi facilement que des enseignements utiles.
Un futur agent d’apprentissage continu devra peut-être apprendre non seulement quoi mémoriser, mais aussi :
La gestion de la mémoire pourrait ainsi devenir l’un des problèmes centraux des agents d’IA exécutés sur de longues périodes.
Si les deux modèles s’étaient améliorés régulièrement, la conclusion aurait été simple : les notes persistantes aident.
S’ils avaient tous deux décliné régulièrement, la conclusion aurait été tout aussi simple : l’accumulation non contrôlée de mémoire nuit aux performances.
Au lieu de cela, le benchmark a produit deux courbes opposées.
C’est scientifiquement plus intéressant.
Cela suggère que la capacité à tirer profit de l’expérience peut dépendre de davantage de facteurs que de la longueur de contexte disponible.
Le modèle doit construire un processus d’apprentissage utile à l’intérieur de ce contexte.
Un agent persistant performant peut devoir exceller dans toutes les étapes suivantes :
observer un échec
→ identifier le bon enseignement
→ le stocker de manière compacte
→ le récupérer plus tard
→ éviter le surapprentissage sur un épisode unique
→ réviser les mauvaises mémoires
→ appliquer l’enseignement à une nouvelle situation
Cela se rapproche beaucoup plus d’un système d’apprentissage que d’un chatbot statique — même si les poids ne changent jamais.
Peter Gostev a laissé des agents d’IA de pointe jouer jusqu’à 200 parties contre différents niveaux de difficulté de Stockfish tout en conservant des notes entre les parties. Les modèles n’ont pas été fine-tunés pendant l’exécution et n’étaient pas autorisés à utiliser un moteur d’échecs pour choisir leurs coups.
Dans la métrique Elo estimée propre au benchmark, oui : la source rapporte qu’Opus est passé d’environ 1500 à environ 1760, avec un pic autour de 1840. Ce chiffre est un classement expérimental interne fondé sur des parties récentes contre Stockfish à force limitée et ne doit pas être traité comme un classement FIDE humain officiel.
L’expérience n’établit pas de cause confirmée. Gostev a suggéré que l’accumulation de notes dans le contexte Codex pouvait avoir contribué au phénomène, mais la qualité des notes, la sélection des adversaires, la dérive du prompt, la variance aléatoire ou d’autres facteurs peuvent également jouer un rôle.
Non. OpenAI documente actuellement GPT-6 Astra avec une fenêtre de contexte de 1,05M tokens. Le chiffre d’environ 258K/272K évoqué dans l’expérience se rapporte à la configuration Codex ou du benchmark utilisée pour cette exécution, et non au contexte API maximal d’Astra.
Oui. Anthropic a officiellement présenté Claude Opus 5.5 le 22 septembre 2026. L’entreprise le positionne comme une évolution majeure d’Opus 5 et le documente pour les charges de travail de programmation et agentiques.
L’apprentissage en contexte signifie que le modèle modifie son comportement à partir d’informations disponibles dans son contexte ou ses fichiers persistants, sans mettre à jour les poids de son réseau neuronal. Ici, les parties d’échecs et les notes constituent une expérience accumulée susceptible d’influencer les parties ultérieures.
Le benchmark utilise des configurations Stockfish plus faibles afin de produire une plage de performances mesurable pour les modèles de langage. Stockfish à pleine puissance est bien plus fort que le jeu d’échecs actuel des modèles de langage ; inclure directement ces parties dans l’estimation Elo expérimentale serait donc moins informatif pour suivre les progrès.
Non. Elle montre qu’au moins une exécution de modèle s’est améliorée de manière substantielle grâce au contexte persistant et à l’expérience répétée sur une tâche structurée. Démontrer un apprentissage continu robuste nécessiterait des expériences contrôlées sur de nombreuses tâches, stratégies de mémoire, configurations de modèles et essais répétés.
L’expérience d’échecs de Peter Gostev a offert à Claude Opus 5.5 et GPT-6 Astra des occasions répétées d’apprendre de leurs propres parties sans modifier les poids des modèles. L’Elo expérimental d’Opus est passé d’environ 1500 à 1760, tandis qu’Astra a atteint un pic précoce avant de chuter à 1400 à la 200e partie.
Le résultat est intéressant non parce qu’il détermine quel modèle est « meilleur aux échecs », mais parce qu’il révèle une question plus profonde sur les agents persistants : un modèle peut-il construire une expérience utile grâce à des notes, des fichiers et des retours répétés — et peut-il empêcher cette mémoire de devenir bruyante ou activement nuisible ?
Le déclin d’Astra reste inexpliqué. L’accumulation de contexte est une hypothèse plausible, mais des expériences contrôlées sur la mémoire et les fenêtres de contexte sont nécessaires avant d’avancer une affirmation causale.
L’enseignement le plus solide de ce benchmark est que des poids de modèle fixes ne garantissent pas un comportement fixe : ce qu’un agent mémorise, la manière dont il organise cette mémoire et la façon dont il apprend de l’échec peuvent faire progresser — ou régresser — fortement ses performances avec le temps.
Partez d’une phrase et obtenez un site complet en quelques minutes.