Anthropic a indiqué que Claude Sonnet 5.5 et Haiku 5.5 suivraient Opus 5.5 « dans les semaines à venir ».
Sonnet 5.5 est arrivé seulement six jours plus tard.
Le nouveau modèle Claude de milieu de gamme n’est pas simplement une version réduite d’Opus 5.5. Sur certains benchmarks de programmation, il obtient même de meilleurs résultats.
L’exemple le plus frappant est Terminal-Bench 4.0 :
Claude Sonnet 5.5 : 70,6 %
Claude Opus 5.5 :   66,4 %
Claude Sonnet 5 :   10,3 %
En revanche, pour les tâches professionnelles plus générales, Opus 5.5 conserve une légère avance.
Anthropic rapporte les résultats suivants :
GDPval-AA v2.1
Opus 5.5 :   1846 Elo
Sonnet 5.5 : 1844 Elo

OSWorld 2.1
Opus 5.5 :   81,8 %
Sonnet 5.5 : 80,1 %
Sonnet 5.5 se retrouve ainsi exceptionnellement proche du modèle phare d’Anthropic sur plusieurs tâches mesurables, tout en conservant le niveau de prix inférieur de la gamme Sonnet.
Mais la distinction entre les deux modèles reste importante.
Anthropic affirme qu’Opus 5.5 demeure nettement plus performant pour les tâches complexes et ouvertes qui nécessitent un jugement soutenu sur de longues périodes. Sonnet 5.5 cible davantage les tâches quotidiennes bien définies, notamment :
- Programmation
- Correction de bugs
- Revue de code
- Documents
- Présentations
- Feuilles de calcul
- Tâches d’agents structurées
- Flux de travail itératifs rapides
La conclusion utile n’est donc pas que Sonnet 5.5 a « remplacé » Opus.
C’est plutôt que l’écart de performance est devenu beaucoup plus faible pour de nombreuses charges de travail courantes et axées sur la programmation.
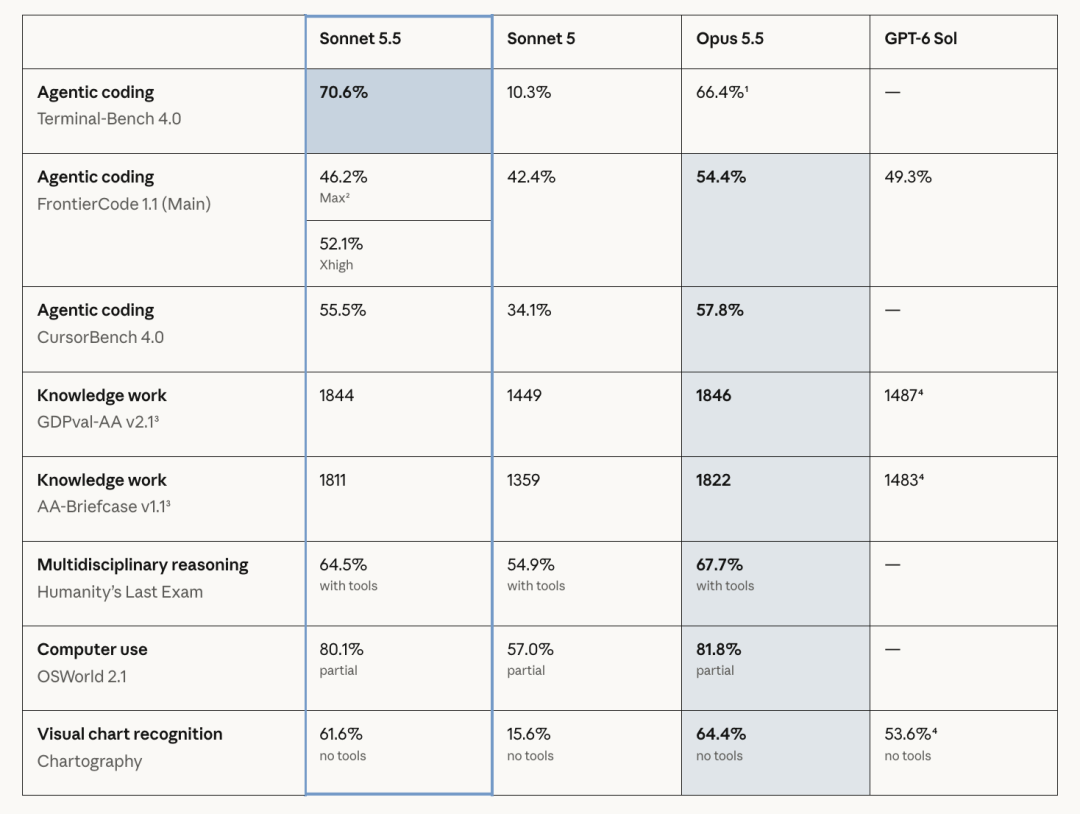
L’article original décrit Sonnet 5.5 comme le « gobelet moyen » qui poursuit le « grand gobelet ».
Cette métaphore correspond étonnamment bien au tableau des benchmarks.
| Évaluation | Sonnet 5.5 | Opus 5.5 | Sonnet 5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 66,4 % | 10,3 % | — |
| FrontierCode 1.1 Main | 52,1 % à Xhigh | 54,4 % | 42,4 % | jusqu’à 52,1 % |
| CursorBench 4.0 | 55,5 % | 57,8 % | 34,1 % | — |
| GDPval-AA v2.1 | 1844 | 1846 | 1449 | 1487 |
| Humanity’s Last Exam | 64,5 % | 67,7 % | 54,9 % | — |
| OSWorld 2.1 | 80,1 % | 81,8 % | 57,0 % | — |
| Chartography | 61,6 % | 64,4 % | 15,6 % | 53,6 % |
Le tableau montre la tendance réelle.
Sonnet 5.5 remporte un benchmark de programmation important, se rapproche fortement des résultats d’Opus sur plusieurs autres évaluations, mais ne le surpasse pas systématiquement.
Anthropic fait lui-même la même distinction : les scores de benchmark ne représentent qu’un aspect de la qualité d’un modèle, et Opus reste plus performant lorsqu’une tâche est ambiguë, ouverte ou nécessite un jugement soutenu sur une longue durée.
Sonnet 5.5 utilise les outils plus efficacement
L’amélioration ne concerne pas uniquement les scores bruts.
Les premiers testeurs ont également constaté que Sonnet 5.5 modifie sa manière de travailler.
Par rapport à Sonnet 5, le modèle est davantage disposé à regrouper les appels d’outils lorsque les tâches peuvent être exécutées en parallèle, au lieu de tout traiter action après action.
Les retours clients d’Anthropic incluent une évaluation de programmation dans laquelle Sonnet 5.5 a utilisé :
~1/3 d’appels d’outils en moins
~1/2 du nombre d’exécutions shell
pour réaliser le même type de tâche.
Cela compte pour les systèmes d’agents, car chaque appel d’outil supplémentaire peut ajouter :
- De la latence
- Une consommation de jetons
- Des coûts d’infrastructure
- Un risque d’échec
- Un état supplémentaire à gérer
Un modèle qui parvient au même résultat avec moins d’interactions avec les outils peut être sensiblement moins cher, même si son prix par jeton affiché ne change pas.
Base44 : des résultats similaires en deux fois moins d’itérations
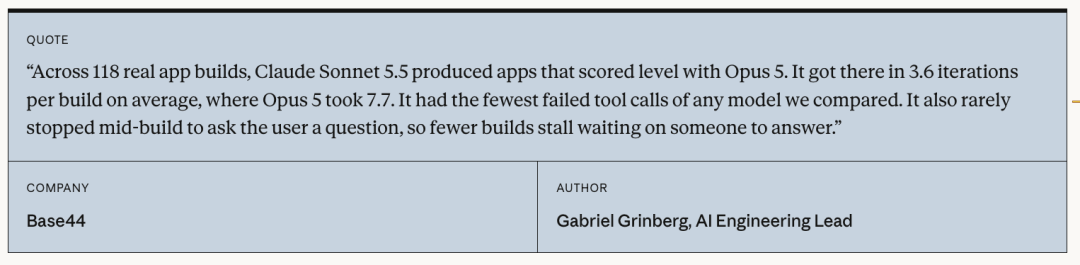
Base44 a testé Sonnet 5.5 sur 118 tâches réelles de création d’applications.
Le résultat rapporté est particulièrement concret.
Sonnet 5.5 a produit des applications obtenant des scores du même niveau qu’Opus 5, tout en nécessitant :
Sonnet 5.5 :
3,6 itérations par création en moyenne

Opus 5 :
7,7 itérations par création en moyenne
Base44 a également indiqué que Sonnet 5.5 avait enregistré le plus petit nombre d’appels d’outils échoués parmi tous les modèles de la comparaison.
Cela rappelle que le « coût du modèle » ne se résume pas à :
prix des jetons d’entrée
+
prix des jetons de sortie
Dans les flux de travail réels avec des agents, le coût total dépend également des éléments suivants :
nombre d’itérations
nombre d’appels d’outils
actions échouées
nouvelles tentatives
interventions humaines
temps nécessaire pour obtenir un résultat accepté
Si un modèle termine une tâche en deux fois moins d’itérations, la différence de coût réelle peut être beaucoup plus importante que ne le laisse penser le tableau des prix de l’API.
Epic Games l’a testé sur de grandes bases de code
Epic Games a testé Sonnet 5.5 sur des systèmes logiciels beaucoup plus importants.
Selon les retours clients publiés par Anthropic, le modèle a géré des dizaines de milliers de lignes de code de systèmes de gameplay pour des tâches telles que :
- Audits de conception de systèmes
- Revues des flux de données
- Tâches de programmation de plusieurs heures
Epic Games a déclaré que le modèle atteignait un niveau de qualité normalement attendu d’un modèle de gamme supérieure, tout en nécessitant des instructions moins prescriptives.
C’est exactement le type de charge de travail dans lequel un modèle plus petit peut devenir précieux.
Un développeur peut toujours vouloir utiliser Opus 5.5 pour définir l’architecture ou résoudre les problèmes ambigus les plus difficiles, mais Sonnet 5.5 peut prendre en charge une part beaucoup plus importante du travail d’implémentation et de revue à moindre coût.
Unity ne compte une tâche que lorsque le projet s’exécute
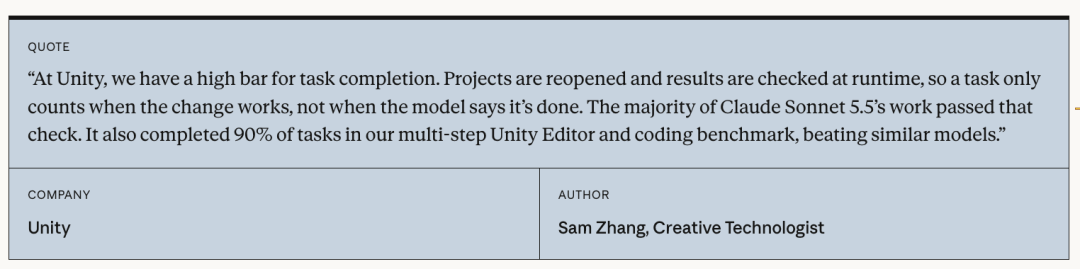
Unity a utilisé un critère de réussite plus strict.
Au lieu d’accepter une modification de code simplement parce que le modèle indiquait qu’elle était terminée, Unity a rouvert le projet et vérifié que le résultat fonctionnait réellement à l’exécution.
Dans cette évaluation, Sonnet 5.5 a terminé :
90 %
des tâches du benchmark en plusieurs étapes de l’éditeur et de programmation de Unity.
Ce type de test est plus instructif que la seule qualité de génération de code.
Une modification peut sembler correcte et pourtant échouer en raison de :
- Dépendances manquantes
- État incorrect du projet
- Erreurs de compilation
- Hypothèses liées à l’exécution
- Erreurs d’utilisation des outils
- Modifications dépassant le périmètre demandé
Le benchmark de Unity cherche à mesurer la tâche réelle de bout en bout, plutôt que la seule réponse textuelle.
Sonnet 5.5 peut terminer Pokémon Rouge à partir de captures d’écran
Anthropic a également poursuivi l’une de ses démonstrations récurrentes sur les tâches à long horizon.
Sonnet 5.5 est devenu le premier modèle Sonnet de la famille Claude à battre Pokémon Rouge en travaillant uniquement à partir de captures d’écran.
Ce test n’est pas directement utile comme benchmark de programmation.
Sa valeur est différente.
Le jeu exige que le modèle soit capable de :
- Interpréter un état visuel
- Se souvenir d’objectifs à long terme
- Planifier sur de nombreuses étapes
- Se remettre de ses erreurs
- Continuer à agir sur un horizon étendu
Ces mêmes propriétés sont importantes pour les agents utilisant un ordinateur et les flux de travail logiciels de longue durée.
Les tâches de conception et de bureautique progressent également
L’article original souligne que Sonnet 5.5 n’est pas seulement plus performant en programmation.
Anthropic le positionne également pour les documents, les présentations, les feuilles de calcul et les travaux visuels de qualité.
Le modèle est conçu pour suivre les conventions visuelles existantes plutôt que de créer chaque élément à partir de zéro.
Par exemple, à partir d’un modèle de présentation existant, il peut continuer à utiliser les mêmes éléments :
- Mise en page
- Espacement
- Hiérarchie visuelle
- Conventions stylistiques
- Langage de conception
Anthropic affirme que cela réduit la quantité de retouches manuelles nécessaires après la génération.
Sonnet 5.5 est ainsi particulièrement pertinent pour les flux de travail professionnels dans lesquels la tâche est bien définie, mais doit tout de même conserver une cohérence visuelle.
Le prix de l’API n’a pas augmenté
Malgré le bond de performance, Sonnet 5.5 conserve la même tarification API de base que Sonnet 5.
Anthropic affiche actuellement les prix suivants :
| Type de jeton | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| Entrée | 2 $ / 1 M | 4 $ / 1 M |
| Sortie | 10 $ / 1 M | 20 $ / 1 M |
| Lecture du cache | 0,20 $ / 1 M | 0,20 $ / 1 M |
| Écriture dans le cache | 2,50 $ / 1 M | 5 $ / 1 M |
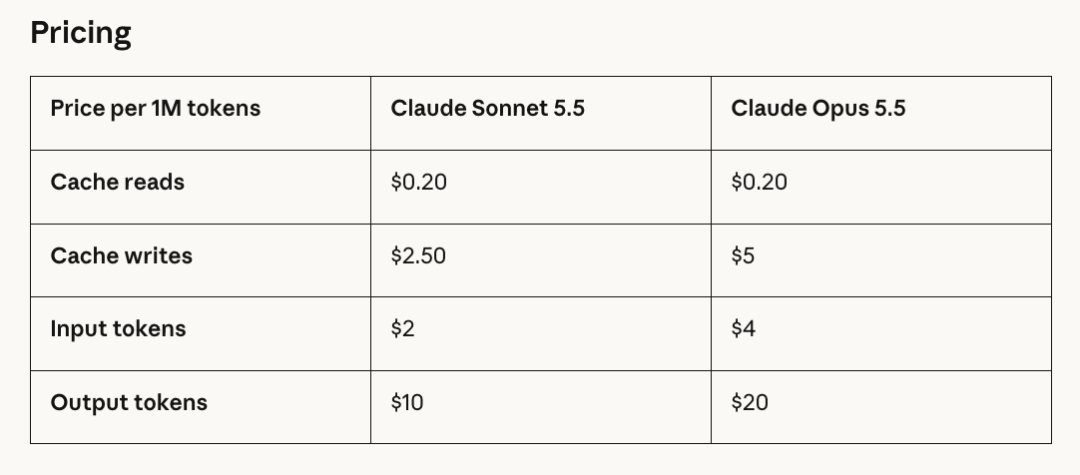
Au niveau des prix affichés, les jetons d’entrée et de sortie standard de Sonnet 5.5 coûtent exactement deux fois moins cher que ceux d’Opus 5.5.
Mais Anthropic met désormais davantage l’accent sur une autre mesure :
Le coût par tâche terminée.
Le coût par tâche diminue même si le prix des jetons reste inchangé
Anthropic affirme que Sonnet 5.5 génère les sorties plus de 30 % plus rapidement que Sonnet 5.
L’entreprise indique également que le modèle nécessite généralement moins de jetons et moins d’étapes pour effectuer le même travail.
Anthropic rapporte ainsi que Sonnet 5.5 peut coûter :
jusqu’à 30 % de moins par tâche
que Sonnet 5 pour la plupart des charges de travail.
C’est pourquoi se concentrer uniquement sur le tarif de 2 $ / 10 $ par jeton ne permet pas de saisir toute l’ampleur de la mise à niveau.
Creez un site vitrine et genere des leads en quelques minutes
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Le tarif nominal est resté identique.
La quantité de travail du modèle nécessaire pour terminer une tâche a diminué.
Terminal-Bench : un niveau d’effort moyen peut surpasser Sonnet 5 pour une fraction du coût
Anthropic propose désormais plusieurs niveaux d’effort.
Un niveau d’effort plus élevé permet au modèle de raisonner plus longtemps et de vérifier davantage son travail.
Un niveau d’effort plus faible le rend plus rapide et moins cher.
Dans Claude Code et les applications grand public d’Anthropic, le niveau d’effort par défaut est Medium. Sur Claude Platform, le niveau par défaut est High.
Sur Terminal-Bench 4.0, le graphique coût-performance d’Anthropic montre que Sonnet 5.5 avec un niveau d’effort Medium surpasse déjà le meilleur résultat de Sonnet 5, tout en coûtant environ dix fois moins cher par tentative.
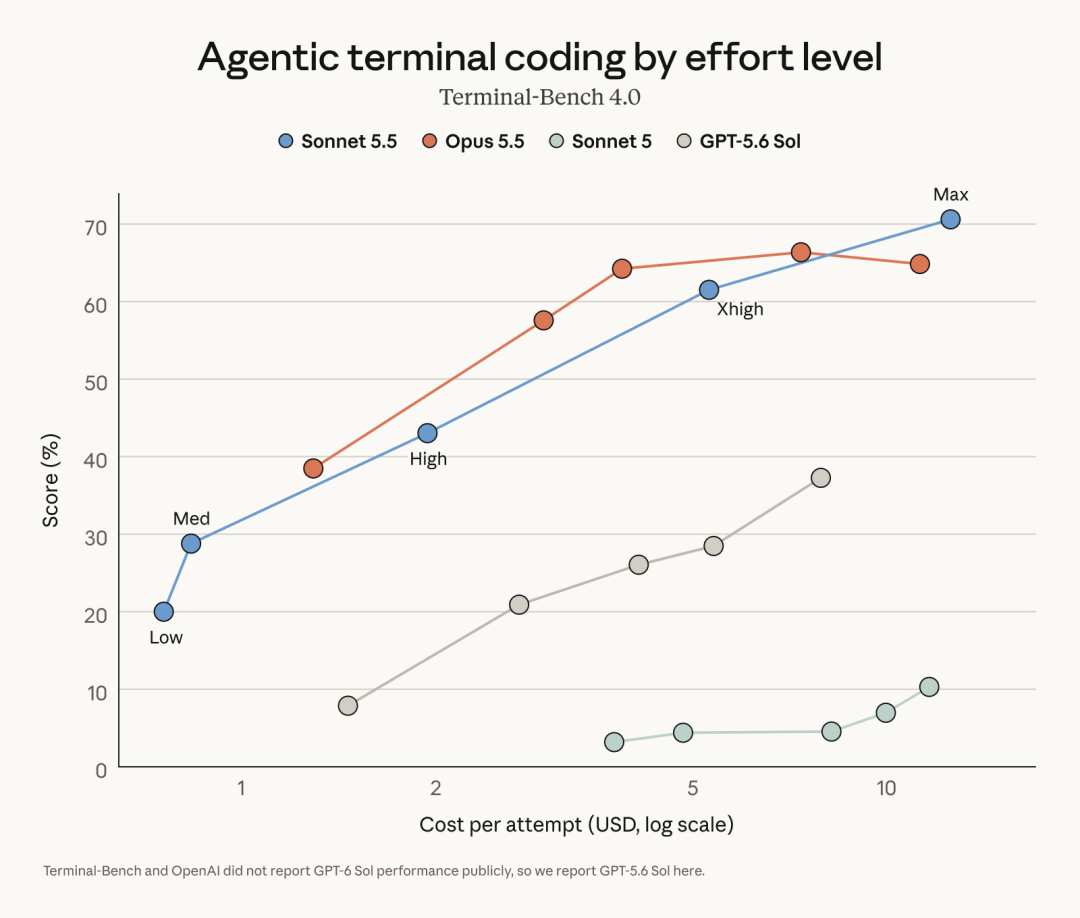
Il ne faut pas en déduire que Medium constitue toujours le bon réglage.
L’essentiel est qu’un développeur peut désormais ajuster plus directement la qualité et le coût.
Pour la programmation courante, un niveau d’effort inférieur peut déjà suffire.
Pour les tâches difficiles, augmenter l’effort donne à Sonnet davantage de temps pour raisonner.
CursorBench montre une tendance similaire
CursorBench 4.0 évalue le travail de programmation à partir de sessions réelles dans Cursor.
Sonnet 5.5 atteint :
55,5 %
contre :
57,8 %
pour Opus 5.5.
Le graphique de coûts d’Anthropic montre que, même avec un niveau d’effort relativement faible, Sonnet 5.5 peut dépasser le meilleur score de Sonnet 5 pour environ un dixième du coût par tâche.
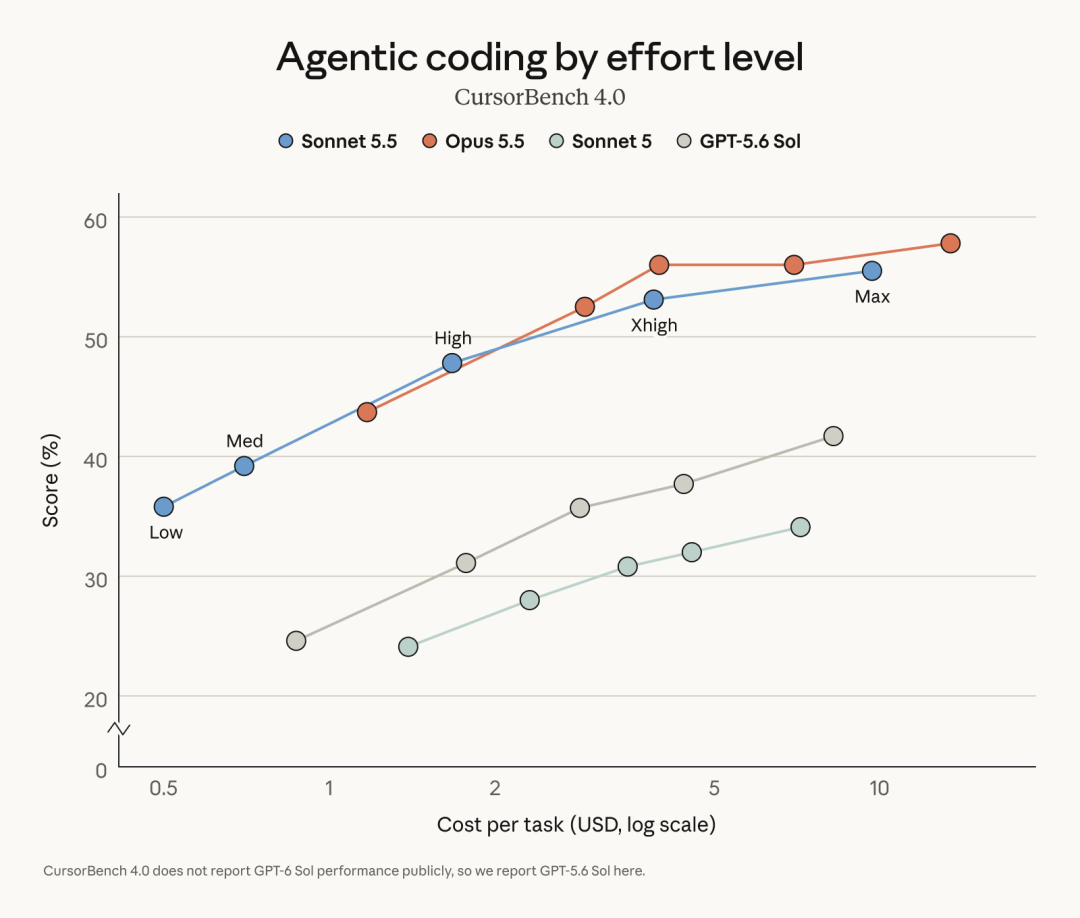
C’est à ce niveau que le nouveau Sonnet devient particulièrement intéressant.
L’écart absolu avec Opus peut être suffisamment faible pour que le modèle moins coûteux soit souvent le meilleur choix de production pour la programmation à grand volume.
FrontierCode compare Sonnet 5.5 à GPT-6 Sol
L’article original accorde une attention particulière à FrontierCode 1.1, car la comparaison inclut GPT-6 Sol.
Le graphique publié par Anthropic montre que Sonnet 5.5 atteint son meilleur score FrontierCode avec un niveau d’effort Xhigh, tandis que les différents niveaux d’effort de GPT-6 Sol se situent dans une plage de scores similaire.
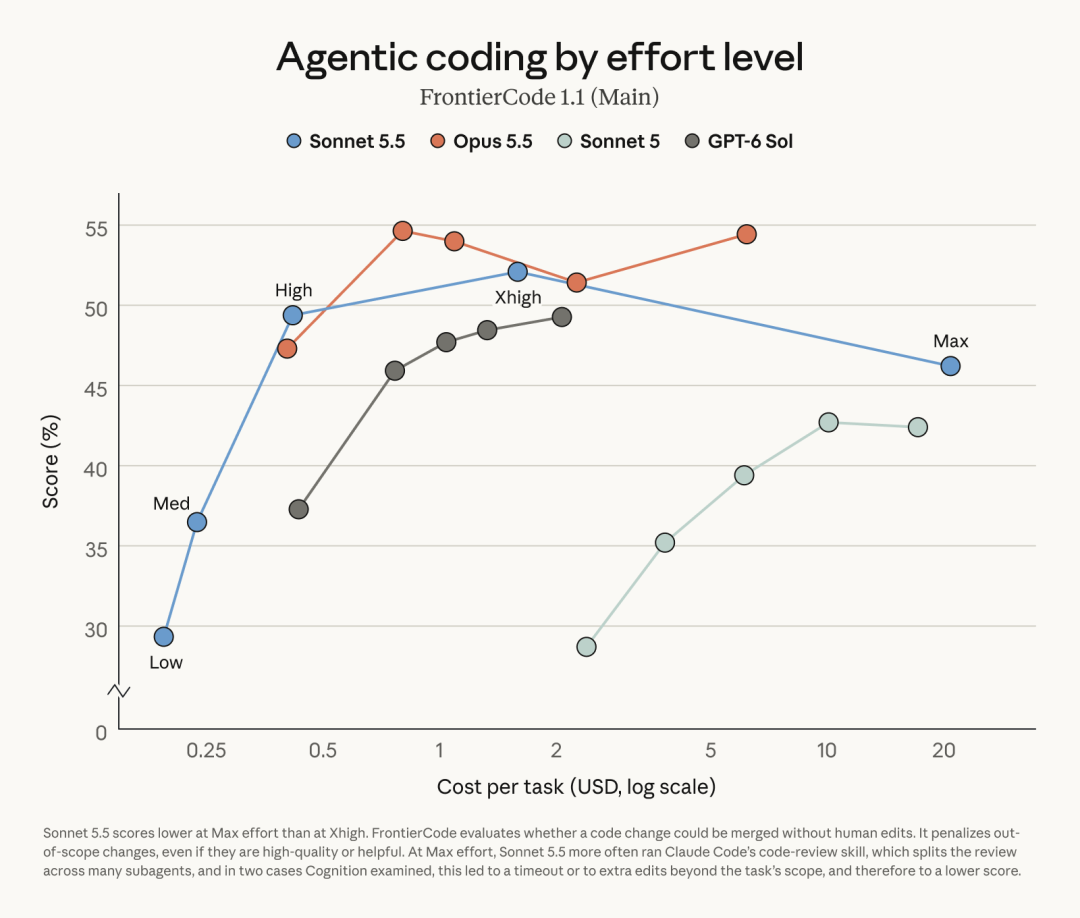
Avec un niveau d’effort High, Sonnet 5.5 se situe déjà dans la plage de scores des configurations testées les plus performantes de GPT-6 Sol, tandis qu’Anthropic estime que son coût par tâche est nettement inférieur.
L’article original résume l’écart de la manière suivante :
Coût par tâche de Sonnet 5.5 :
~1/5 de celui de GPT-6 Sol
pour le point comparable mis en évidence dans le graphique d’Anthropic.
Ce chiffre doit être compris comme une comparaison du coût par tâche spécifique à un benchmark, et non comme un ratio universel de prix de l’API.
Les modèles :
- Ont des structures tarifaires différentes
- Utilisent des quantités de raisonnement différentes
- Produisent des volumes de jetons différents
- Peuvent nécessiter un nombre différent de nouvelles tentatives
- Sont comparés avec des niveaux d’effort spécifiques
Il est donc plus prudent de dire que le graphique de benchmark d’Anthropic montre que Sonnet 5.5 atteint, dans cette configuration, une qualité FrontierCode similaire à un coût mesuré par tâche beaucoup plus faible.
Cela ne signifie pas que chaque charge de travail Sonnet coûte exactement 80 % de moins que celle de GPT-6 Sol.
Sonnet 5.5 ne remplace pas Opus 5.5
Les titres consacrés aux benchmarks peuvent inciter à conclure que le modèle Sonnet moins cher a rendu Opus inutile.
Anthropic rejette explicitement cette interprétation.
Ses propres tests et les retours clients montrent encore qu’Opus 5.5 est nettement plus performant pour les tâches qui nécessitent :
- Un raisonnement ouvert
- Un jugement soutenu plus long
- Une planification plus ambiguë
- Des décisions d’architecture
- Des recherches complexes
- Des décisions à enjeux élevés en plusieurs étapes
Une stratégie pratique d’orientation entre modèles ressemble donc plutôt à ceci :
Opus 5.5
→ architecture
→ planification difficile
→ recherche ambiguë
→ tâches de complexité maximale

Sonnet 5.5
→ implémentation
→ correction de bugs
→ revues
→ tâches d’agents courantes
→ documents et travail bureautique
→ programmation à grand volume
Un client d’Anthropic a décrit cette relation de manière similaire : laisser Opus définir l’architecture, puis laisser Sonnet l’implémenter.
C’est probablement la meilleure façon de comprendre la famille 5.5.
Les mesures de sécurité ont été renforcées avec les capacités de programmation
L’article original se concentre principalement sur la performance et le coût, mais un détail officiel mérite d’être souligné.
Anthropic affirme que les capacités de cybersécurité de Sonnet 5.5 se sont suffisamment améliorées pour qu’il soit le premier modèle Sonnet à être lancé avec des mesures de sécurité et des mécanismes de repli similaires à ceux utilisés pour les modèles les plus performants d’Anthropic.
Anthropic précise également que ces mesures ciblent un ensemble limité de demandes à haut risque et ne sont pas conçues pour perturber le développement logiciel courant.
Cela compte, car de meilleures performances en programmation et dans l’utilisation des outils peuvent aussi accroître les capacités de sécurité à double usage.
Sonnet 5.5 est disponible sur les plateformes Claude
Anthropic indique que Sonnet 5.5 est disponible via :
- Claude.ai
- Claude Code
- Claude Platform / API
- Amazon Web Services
- Google Cloud
- Microsoft Foundry
L’identifiant du modèle API est :
claude-sonnet-5-5
Anthropic prend également en charge la conservation nulle des données pour Sonnet 5.5 dans les configurations API éligibles.
Pour les équipes qui migrent depuis Sonnet 5, Anthropic recommande d’examiner les nouveaux contrôles d’effort et de réflexion, plutôt que de supposer que tous les anciens réglages d’exécution doivent être copiés sans modification.
Haiku 5.5 est le prochain modèle
L’article source se termine en se tournant vers le prochain membre de la famille Claude 5.5.
Anthropic indique que Haiku 5.5 suivra dans les semaines à venir.
Son positionnement est déjà clair :
débit élevé
+
charges de travail sensibles aux coûts
Si Sonnet 5.5 est le modèle polyvalent rapide destiné aux tâches générales et qu’Opus 5.5 est le modèle dédié au jugement ouvert et difficile, Haiku 5.5 devrait pousser encore plus loin l’économie des déploiements à grand volume.
La direction de la famille Claude 5.5 devient claire.
Anthropic ne se contente pas de rivaliser sur les scores bruts des benchmarks.
L’entreprise présente de plus en plus ses modèles autour des critères suivants :
qualité
+
vitesse
+
coût par tâche terminée
Pour les développeurs, il pourrait s’agir d’un indicateur de déploiement plus utile que le seul score de benchmark.
FAQ
Qu’est-ce que Claude Sonnet 5.5 ?
Claude Sonnet 5.5 est le dernier modèle Sonnet d’Anthropic et la deuxième sortie de la famille Claude 5.5. Il est conçu comme un complément plus rapide et moins coûteux à Opus 5.5 pour la programmation, les agents, le travail intellectuel, les documents, les présentations et d’autres tâches bien définies.
Sonnet 5.5 est-il meilleur qu’Opus 5.5 ?
Sur certains benchmarks, oui. Sonnet 5.5 obtient 70,6 % sur Terminal-Bench 4.0 contre 66,4 % pour Opus 5.5, mais Opus reste en tête sur la plupart des évaluations plus générales et demeure plus performant pour les tâches complexes et ouvertes nécessitant un jugement soutenu.
Combien coûte Claude Sonnet 5.5 ?
Anthropic affiche un prix API standard de 2 $ par million de jetons d’entrée et de 10 $ par million de jetons de sortie. La lecture du cache coûte 0,20 $ par million de jetons et l’écriture dans le cache 2,50 $ par million de jetons.
Sonnet 5.5 est-il moins cher que Sonnet 5 ?
Les prix par jeton sont identiques, mais Anthropic affirme que Sonnet 5.5 utilise généralement moins de jetons et termine les tâches plus efficacement. Selon ses tests, cela réduit le coût par tâche jusqu’à 30 % pour de nombreuses charges de travail.
À quelle vitesse fonctionne Sonnet 5.5 ?
Anthropic affirme que la génération de sorties est plus de 30 % plus rapide que celle de Sonnet 5. Des testeurs externes signalent également moins d’appels d’outils, moins d’exécutions shell et moins d’itérations pour de nombreuses tâches de programmation.
Comment Sonnet 5.5 se compare-t-il à GPT-6 Sol ?
Le graphique coût-performance de FrontierCode publié par Anthropic montre que Sonnet 5.5 atteint une plage de qualité similaire à celle des configurations GPT-6 Sol testées, avec un coût par tâche mesuré nettement inférieur dans ce benchmark. Il ne s’agit pas d’un ratio de coût universel et cela ne doit pas être interprété comme la preuve que Sonnet est supérieur pour toutes les charges de travail de programmation ou de raisonnement.
Quel identifiant de modèle les développeurs doivent-ils utiliser ?
L’identifiant officiel du modèle de l’API Claude est :
claude-sonnet-5-5
Anthropic indique également que le modèle est disponible via AWS, Google Cloud et Microsoft Foundry.
Quand Claude Haiku 5.5 sera-t-il lancé ?
Anthropic indique que Haiku 5.5 arrivera dans les semaines à venir. Il est destiné aux applications à débit élevé et sensibles aux coûts.
Outils associés
- Claude : interface grand public d’Anthropic pour travailler avec les modèles Claude.
- Claude Code : environnement de programmation agentique d’Anthropic pour le développement logiciel à l’échelle d’un dépôt.
- Claude API : documentation officielle de l’API pour intégrer
claude-sonnet-5-5dans des applications. - Amazon Bedrock : plateforme AWS proposant les modèles Claude pour les applications d’entreprise.
- Google Vertex AI : plateforme Google Cloud donnant accès aux modèles Claude.
- Microsoft Foundry : plateforme de développement IA de Microsoft proposant des modèles Claude.
Liens associés
- Article original de BAAI Hub : article de QbitAI en langue chinoise adapté et vérifié dans cette publication.
- Anthropic — Présentation de Claude Sonnet 5.5 : annonce principale présentant les benchmarks, les évaluations clients, les tarifs, les graphiques de coût par tâche et les informations de sécurité.
- Page produit Claude Sonnet : présentation officielle des cas d’usage, de la disponibilité et des tarifs de Sonnet 5.5.
- Claude Opus 5.5 : annonce officielle d’Opus 5.5 permettant de comparer le modèle phare d’Anthropic.
- Documentation de l’API Anthropic : documentation officielle de l’API et recommandations d’intégration des modèles.
- Tarifs Anthropic : informations tarifaires actuelles concernant les modèles Claude et les offres produit.
Résumé
Claude Sonnet 5.5 réduit l’écart entre les modèles de milieu de gamme et les modèles phares d’Anthropic bien plus que ne le laisse penser son nom. Il dépasse Opus 5.5 sur Terminal-Bench 4.0, n’est qu’à deux points Elo sur GDPval-AA et se rapproche fortement d’Opus sur OSWorld et CursorBench.
L’enjeu principal pour le déploiement est l’efficacité. Sonnet 5.5 conserve la même tarification de 2 $ / 10 $ par jeton que Sonnet 5, mais Anthropic affirme qu’il s’exécute plus de 30 % plus rapidement et peut réduire jusqu’à 30 % le coût par tâche terminée. Des testeurs externes signalent également moins d’appels d’outils, moins d’exécutions shell et beaucoup moins d’itérations.
Opus 5.5 reste le meilleur choix pour les tâches difficiles et ouvertes qui nécessitent un jugement soutenu. Sonnet 5.5 doit plutôt être considéré comme le modèle de production à grand volume qui atteint désormais une qualité proche de celle d’un modèle phare sur un nombre croissant de tâches bien définies.
La mise à niveau la plus importante de Sonnet 5.5 n’est pas une victoire sur un benchmark : c’est la proximité du modèle avec la qualité d’un modèle phare, tout en conservant le prix de Sonnet et un coût par tâche terminée beaucoup plus faible.