For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/cuda-agent-trains-llms-to-write.md.
L'équipe Seed de ByteDance, en collaboration avec l'Institut de recherche sur l'industrie de l'IA (AIR) de l'Université Tsinghua, a lancé CU...
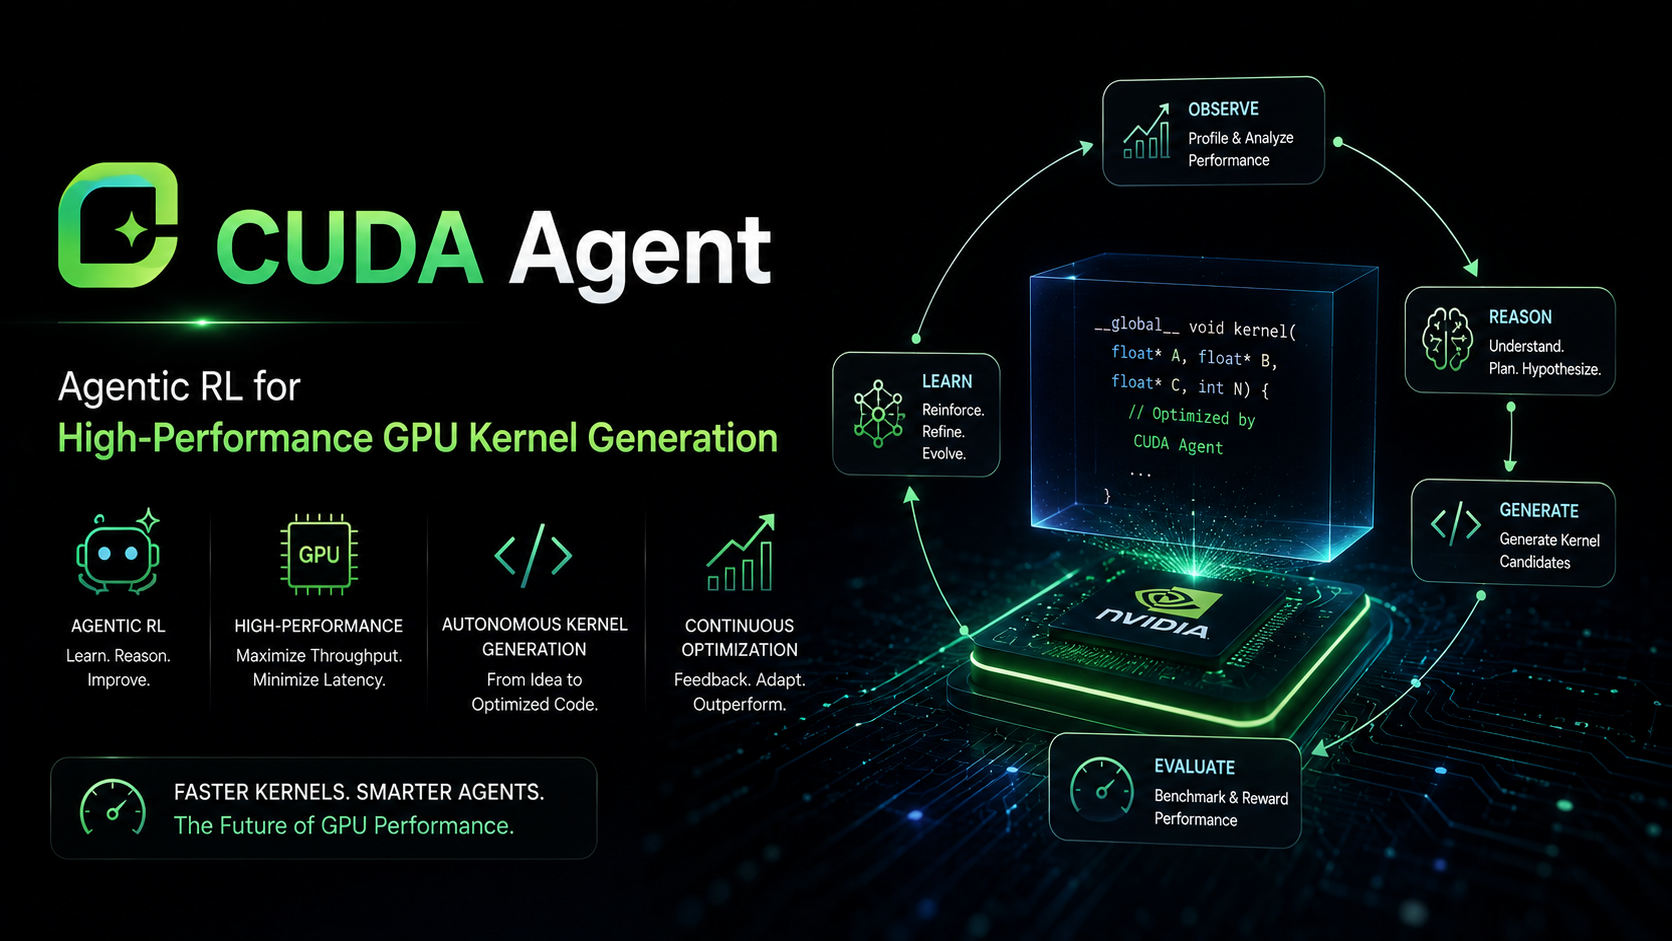
L'équipe Seed de ByteDance, en collaboration avec l'Institut de recherche sur l'industrie de l'IA (AIR) de l'Université Tsinghua, a lancé CUDA Agent, un système d'apprentissage par renforcement à grande échelle pour agents intelligents, conçu pour apprendre aux modèles de langage à générer des kernels CUDA hautes performances.
Ce travail cible une faiblesse de longue date dans la génération de code de bas niveau par l'IA. Les modèles de langage de pointe parviennent souvent à générer du code CUDA compilable et fonctionnellement correct, mais pour les charges de travail GPU de production, la simple exactitude ne suffit pas. Les kernels générés doivent également être compétitifs face aux implémentations produites par des compilateurs hautement optimisés.
CUDA Agent est précisément construit autour de ce second problème : non seulement générer du code CUDA valide, mais aussi apprendre à analyser, valider et optimiser itérativement les kernels par profilage, jusqu'à obtenir des améliorations de performance significatives.
Avant l'introduction de l'apprentissage par renforcement pour agents, le modèle de base Seed1.6 démontrait déjà de solides capacités d'écriture CUDA sur KernelBench.
Sur les 250 tâches KernelBench de niveaux 1 à 3 utilisées par les chercheurs, Seed1.6 atteignait un taux de réussite de 74,0 %. En d'autres termes, il pouvait générer des solutions fonctionnellement correctes pour la majorité des tâches de référence du modèle de base.
Mais les performances étaient une tout autre histoire.
Seulement 27,2 % des kernels générés par le modèle de base étaient plus rapides que torch.compile, avec une vitesse géométrique moyenne de seulement 0,69× par rapport à la ligne de base du compilateur.
| Modèle | Taux de réussite | Plus rapide que torch.compile | Vitesse géométrique moyenne vs torch.compile |
|---|---|---|---|
| Modèle de base Seed1.6 | 74,0 % | 27,2 % | 0,69× |
| CUDA Agent | 98,8 % | 96,8 % | 2,11× |
Cet écart met en évidence le principal défi de la génération automatique de kernels GPU.
Les modèles de langage peuvent comprendre la syntaxe CUDA, mais peuvent néanmoins produire des accès mémoire inefficaces, des lancements de kernels excessifs, de mauvais choix de tuilage, des intermédiaires inutiles...
Profilage des performances
Le fichier SKILL.md restreint également les raccourcis susceptibles de fausser les résultats des benchmarks. Par exemple, l'agent ne peut pas simplement recourir à des opérations PyTorch arbitraires dans ses implémentations de kernels personnalisés.
Cela est important car les systèmes d'apprentissage par renforcement pourraient trouver des moyens de maximiser la récompense sans résoudre le problème d'optimisation attendu.
Les chercheurs utilisent l'optimisation de politique proximale (PPO) pour entraîner CUDA Agent.
Un défi majeur est que l'optimisation GPU est intrinsèquement une tâche à long horizon. Le modèle peut devoir traverser plusieurs cycles d'édition de code, compilation, débogage, profilage et optimisation supplémentaire avant d'atteindre le résultat souhaité.
Par conséquent, l'article adopte différentes longueurs de contexte et phases d'entraînement pour stabiliser l'apprentissage.
Le modèle de base est Seed1.6, un modèle à mélange d'experts avec 230 milliards de paramètres totaux et 23 milliards de paramètres activés.
Pour l'apprentissage par renforcement de l'agent :
Cela est plus complexe qu'un simple affinage du modèle sur des paires de requêtes et réponses CUDA.
L'objectif est d'apprendre au modèle comment améliorer ses propres kernels grâce à des interactions répétées avec le retour d'exécution.
Une mesure fiable des performances est cruciale, car la vitesse d'exécution fait partie de la récompense.
Par conséquent, les chercheurs ont construit une architecture sandbox avec découplage des ressources CPU-GPU.
Un sandbox terminal basé sur Docker gère les tâches orientées CPU (comme la compilation), tandis que la validation et le profilage des performances sont répartis vers un pool de sandbox GPU dédié contenant 128 GPU NVIDIA H20.
Cette séparation a un double objectif.
Premièrement, elle isole la compilation et les interactions de l'agent des tests de référence GPU. Deuxièmement, l'allocation GPU dédiée réduit les interférences entre les charges de travail concurrentes, rendant les mesures de latence plus stables.
C'est important pour l'apprentissage par renforcement : si les mesures de timing sont bruitées, le modèle reçoit des signaux de récompense peu fiables et pourrait apprendre des comportements d'optimisation incorrects.
Le système final a été évalué sur 250 tâches de KernelBench niveaux 1 à 3.
CUDA Agent atteint :
torch.compiletorch.compileCes résultats représentent une amélioration considérable par rapport au point de départ Seed1.6.
Le modèle non seulement s'améliore pour générer du code passant les tests de correction, mais ses kernels générés sont également plus susceptibles de surpasser les lignes de base du compilateur.
Résultats par niveau de difficulté KernelBench
Les gains de performance restent solides sur les trois niveaux de difficulté de KernelBench.
| Difficulté KernelBench | Taux de réussite | Proportion plus rapide que torch.compile | Accélération géométrique moyenne vs torch.compile |
|---|---|---|---|
| Niveau 1 | 100,0 % | 97,0 % | 1,87× |
| Niveau 2 | 100,0 % | 100,0 % | 2,80× |
| Niveau 3 | 94,0 % | 90,0 % | 1,52× |
La performance au niveau 2 est particulièrement remarquable.
Ces tâches impliquent des séquences d'opérateurs où les opportunités d'optimisation par fusion et déplacements mémoire ne sont pas toujours efficacement exploitées par les heuristiques statiques des compilateurs.
Les auteurs de l'article estiment que l'optimiseur par apprentissage itératif peut explorer un espace plus large de stratégies d'implémentation, y compris les modes d'accès mémoire spécifiques au matériel, le tuilage et les choix de fusion.
Actuellement, les poids complets du modèle entraîné ne sont pas inclus dans la version publique du projet.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Cependant, les chercheurs ont publié plusieurs composants importants de la pile d'entraînement.
Le jeu de données CUDA-Agent-Ops-6K contient 6 000 tâches d'entraînement synthétiques au niveau opérateur.
Son processus de construction comprend :
torch, transformers, etc.La phase de filtrage élimine les cas présentant de l'aléatoire, trop simples, invalides, ou trop similaires aux tâches d'évaluation.
Ce jeu de données est publié sur Hugging Face sous licence CC BY 4.0.
Le dépôt GitHub contient également le fichier d'instructions SKILL.md orienté CUDA ainsi que l'environnement de travail de l'agent.
Ces documents documentent le flux de travail d'optimisation, les outils disponibles, les contraintes et la configuration de l'environnement d'exécution utilisée pour guider l'agent.
L'article et le dépôt décrivent la conception des récompenses, la phase de préchauffage, l'initialisation du critique et le schéma d'entraînement basé sur PPO pour stabiliser le processus d'optimisation à long cycle.
Cela est particulièrement utile pour les chercheurs intéressés par l'entraînement d'agents pour la programmation système, au-delà de la simple reproduction des scores finaux des benchmarks.
L'optimisation des kernels CUDA sous-tend une grande partie de l'infrastructure moderne de l'IA.
Des kernels plus rapides peuvent améliorer :
L'article original d'AIBase souligne son importance dans l'IA...
Applications potentielles dans les domaines des infrastructures, des services d'inférence pour grands modèles, de la conduite autonome et du trading quantitatif — où de minuscules différences de latence peuvent s'avérer cruciales.
Les résultats de CUDA Agent ne signifient pas que les compilateurs traditionnels sont obsolètes.
torch.compile reste une baseline automatique puissante, et l'évaluation de CUDA Agent repose elle-même sur un environnement de benchmark contrôlé et un environnement GPU spécifique.
Les conclusions démontrées par cette recherche, bien que plus restreintes, n'en demeurent pas moins importantes : avec un retour d'exécution suffisant et un apprentissage par renforcement dédié, les modèles de langage peuvent apprendre des stratégies d'optimisation qui surpassent la baseline du compilateur statique sur la grande majorité des tâches de kernels GPU testées.
Cela implique de transformer l'ingénierie de performance sous-jacente en un domaine pertinent pour l'apprentissage par agent, et non plus seulement en une génération de code en une seule passe.
CUDA Agent est un système d'apprentissage par renforcement multi-agents à grande échelle développé par ByteDance Seed, l'Institut de recherche sur l'industrie intelligente (AIR) de l'Université Tsinghua et leur SIA-Lab conjoint. Il entraîne des modèles de langage à écrire, valider, analyser et optimiser itérativement des kernels CUDA.
La recherche utilise Seed1.6 comme modèle de base. L'article le décrit comme un modèle à mélange d'experts avec 230 milliards de paramètres totaux et 23 milliards de paramètres activés.
KernelBench est un benchmark ouvert qui évalue si les modèles de langage peuvent générer des kernels GPU corrects et efficaces pour des programmes PyTorch. CUDA Agent a été évalué sur 250 tâches couvrant les niveaux 1 à 3 de KernelBench.
torch.compile ?Sur l'ensemble du benchmark, CUDA Agent atteint une accélération géométrique moyenne de 2,11 fois par rapport à torch.compile. Ses kernels générés sont plus rapides que la baseline du compilateur sur 96,8 % des tâches évaluées.
Oui. Le système utilise PPO, combiné à un préchauffage multi-phases, un pré-entraînement du modèle de valeur, une conception de récompense robuste et des trajectoires d'agent multi-tours de longue durée.
Le roll-out d'entraînement permet jusqu'à 150 tours d'agent, tandis que l'évaluation permet jusqu'à 200 tours. La fenêtre de contexte d'entraînement de l'agent est de 131 072 tokens.
Le projet a publié son dépôt GitHub, l'environnement d'agent, SKILL.md, la recette d'entraînement et le jeu de données CUDA-Agent-Ops-6K. Les poids complets du modèle entraîné ne figurent pas dans les éléments publiés publiquement actuellement.
CUDA-Agent-Ops-6K est un jeu de données de 6 000 tâches synthétiques d'entraînement CUDA au niveau des opérateurs. Il est spécialement conçu pour l'apprentissage par renforcement multi-agents à grande échelle et comprend des étapes de filtrage pour garantir que les tâches sont exécutables, déterministes, non triviales et séparées de l'ensemble d'évaluation KernelBench.
SKILL.md et les matériaux de projet publiés.torch.compile sont des baselines clés dans la recherche.torch.compile : Baseline du compilateur utilisée dans la recherche.CUDA Agent résout une faiblesse spécifique du code système généré par les grands modèles de langage : le code CUDA généré doit non seulement être correct, mais aussi réellement plus rapide que les alternatives générées par compilateur.
À partir de Seed1.6, les chercheurs ont utilisé un environnement d'agent spécialisé CUDA, un retour d'exécution, une conception de récompense robuste et un entraînement PPO à long horizon pour faire passer le taux de réussite de 74,0 % à 98,8 %, et la proportion de kernels plus rapides que torch.compile de 27,2 % à 96,8 %.
Le projet publie également un jeu de données d'entraînement de 6 000 tâches, SKILL.md, des matériaux d'environnement d'agent et une recette d'entraînement, offrant aux chercheurs une base concrète pour poursuivre les travaux sur l'optimisation GPU apprise.
La principale contribution de CUDA Agent est de démontrer que l'ingénierie de performance elle-même peut être apprise par une boucle d'agent itérative — et non pas seulement approximée par une génération de code en une seule passe.
Partez d’une phrase et obtenez un site complet en quelques minutes.



