For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/deepseek-flash-1017-harness-0-2-1-benchma-1cbf9b44.md.
DeepSeek a mis à jour V4.1 Flash avec **DeepSeek-V4.1-Flash-1017**, une version axée sur le raisonnement, le codage, les flux de travail age...
DeepSeek a mis à jour V4.1 Flash avec DeepSeek-V4.1-Flash-1017, une version axée sur l’amélioration du raisonnement, du codage, des flux de travail agentiques et des tâches visuelles. Son principal argument en matière d’efficacité est qu’elle permet d’obtenir de meilleurs résultats avec une durée d’exécution des tâches réduite et des réponses plus courtes.
La note de version du 17 octobre indique que le site officiel, l’application et l’API ont été mis à jour. Les utilisateurs de l’API continuent d’appeler le modèle avec deepseek-flash ; cette mise à jour ne modifie ni la méthode d’appel ni la tarification du modèle.
DeepSeek recommande également de passer à DeepSeek Harness 0.2.1-rc.1 ou à une version ultérieure pour bénéficier de l’expérience prévue. Cette version cible spécifiquement Harness et d’autres plateformes agentiques, notamment Tencent CodeBuddy et WorkBuddy, et ne se limite donc pas à améliorer les réponses d’un chatbot autonome.
Le rapport fourni fait état d’un crédit limité de 6 RMB accordé aux nouveaux utilisateurs éligibles qui se connectent à Harness pour la première fois. Ce crédit est valable sept jours après réception et dépend des disponibilités. Il s’agit d’une promotion signalée, et non d’un droit permanent lié à l’API ; l’éligibilité réelle et la date d’expiration affichées sur le compte déterminent si elle s’applique.
La fiche officielle du modèle présente cette version comme une mise à jour mineure de V4.1 Flash, mais les variations de benchmarks rapportées sont importantes dans plusieurs tests axés sur les agents. Par exemple, le score de Terminal-Bench 4.0 passe de 31,2 à 42,3, tandis que celui de ProgramBench passe de 20,3 à 29,1.
Le tableau ci-dessous reprend les comparaisons figurant dans la source et dans la fiche officielle du modèle. Il s’agit de scores de benchmark rapportés, et non de mesures issues d’une nouvelle évaluation indépendante.
| Benchmark | Flash-1017 | V4.1 Flash précédent | Kimi K3 | GLM-5.3 | GPT-5.6 Sol | Claude Opus 5 |
|---|---|---|---|---|---|---|
| HLE, sans outils | 42,6 (44,0*) | 36,8 (39,1*) | 43,5 | 42,0* | 44,5 | 56,3 |
| Terminal-Bench 4.0 | 42,3 | 31,2 | 12,6 | 37,9 | 39,9 | 51,8 |
| DeepSWE v1.1 | 77,0 | 74,2 | 67,5 | 66,9 | 73,0 | 74,0 |
| ProgramBench | 29,1 | 20,3 | 17,5 | 19,0 | 23,0 | 37,0 |
| NL2Repo-Bench | 68,2 | 65,4 | 58,0 | 58,0 | 56,8 | 75,3 |
| Automation-Bench v1.0.6 | 60,5 | 54,8 | 46,7 | 48,8 | 45,8 | 50,3 |
| Agents' Last Exam | 35,4 | 31,8 | 27,6 | 28,5 | 26,7 | 28,6 |
| Apex Bench v1.1 | 72,1 | 64,6 | 47,8 | 56,6 | 54,3 | 65,8 |
| Chartography, avec outils | 83,0 | 78,9 | 68,1 | Non indiqué | 79,9 | 84,0 |
| BabyVision, avec outils | 92,5 | 89,6 | 85,7 | Non indiqué | 88,9 | 94,1 |
| ZeroBench-main, avec outils | 51,0 | 49,0 | 41,0 | Non indiqué | 53,0 | 52,0 |
* désigne le sous-ensemble de HLE limité au texte. Terminal-Bench 4.0 a utilisé le harness Claude Code, et DeepSWE v1.1 a utilisé Mini-SWE-V2 ; la source précise que le score de ZeroBench-main correspond à Pass@5. Les scores obtenus sur ces tâches et dans ces conditions d’évaluation différentes ne doivent pas être agrégés en un taux de réussite général.
L’affirmation la plus distinctive concerne le compromis entre les résultats et les dépenses. DeepSeek indique avoir réduit la durée d’exécution et la longueur des réponses tout en améliorant les performances, ce qui étend la frontière performance-coût sur plusieurs harnesses.
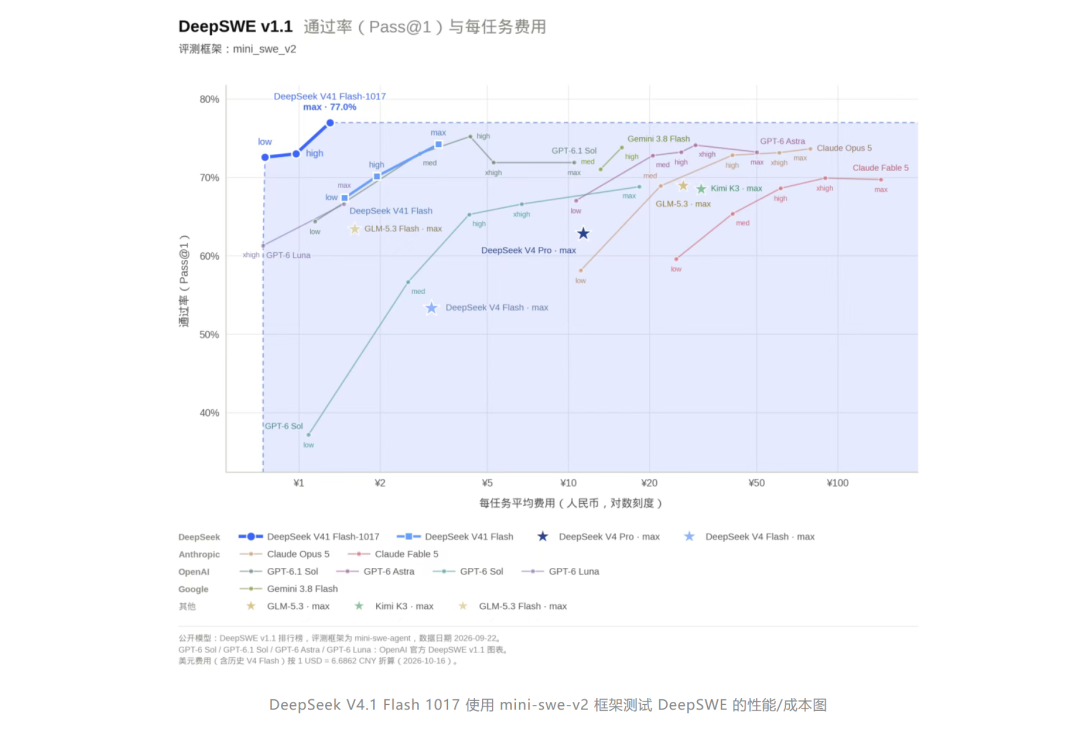
Le graphique compare des exécutions précises de tâches, des harnesses et des paramètres de raisonnement. Il ne signifie pas que tous les projets coûteront moins cher ni qu’un score donné est garanti dans un autre environnement. L’exécution des outils, les nouvelles tentatives, la longueur des réponses et la manière dont la tâche est définie influent toujours sur le coût.
La source décrit les démonstrations de codage de cette version comme une évolution vers une approche où l’utilisateur décrit le résultat souhaité et laisse l’agent poursuivre les étapes de planification, de mise en œuvre, d’exécution, d’inspection et de révision. Elle attribue ce comportement itératif à un apprentissage par renforcement reposant sur l’autocorrection.
L’un des résultats présentés est une scène 3D navigable inspirée de la Cité interdite. Il ne s’agit pas d’une simple image fixe : l’exemple présente du code qui génère une scène dont le point de vue peut changer.
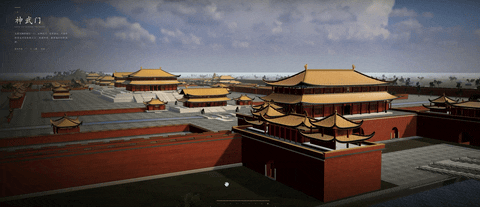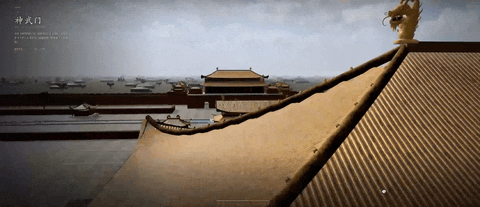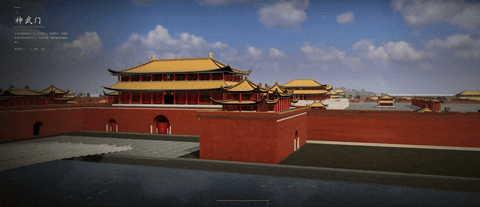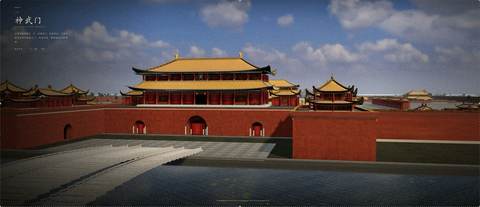
Parmi les autres exemples figurent un jeu de course dans un navigateur, un projet Godot inspiré de Portal et un monde 3D dynamique traversant différentes périodes historiques.
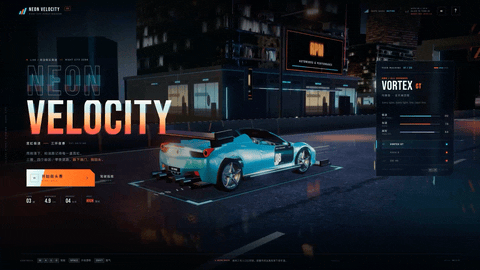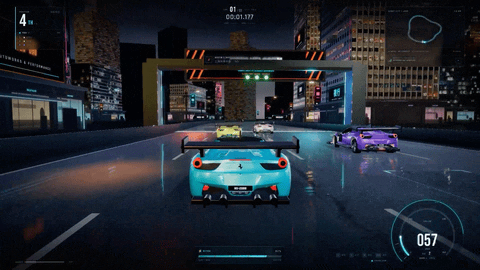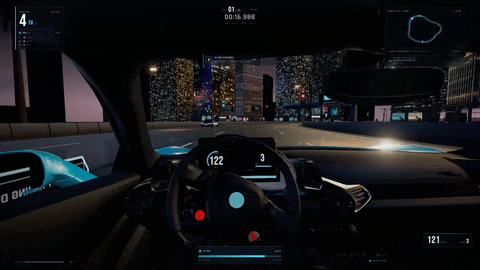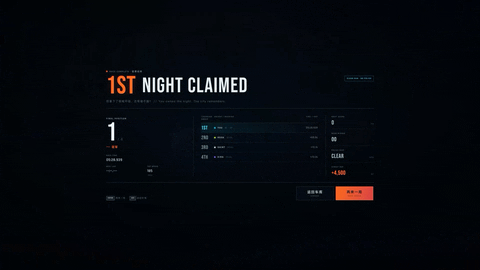
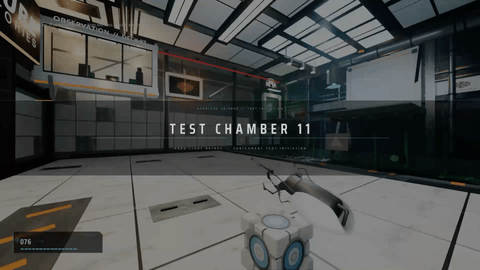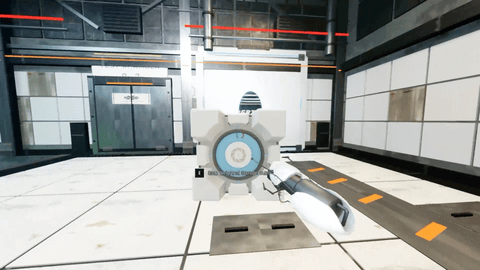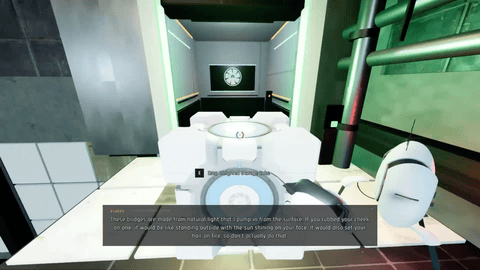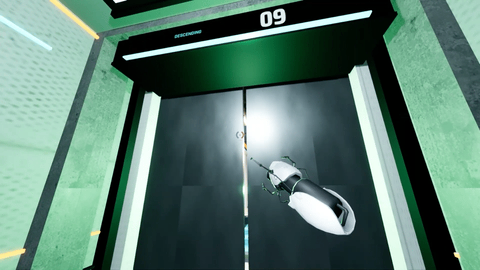
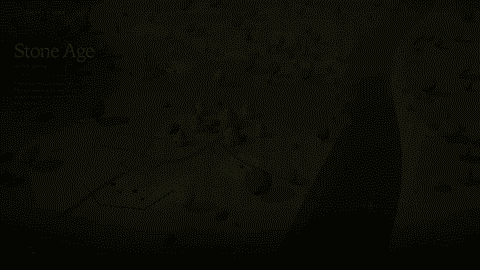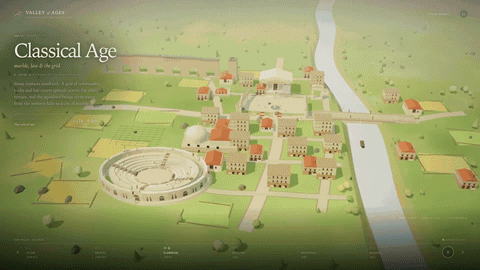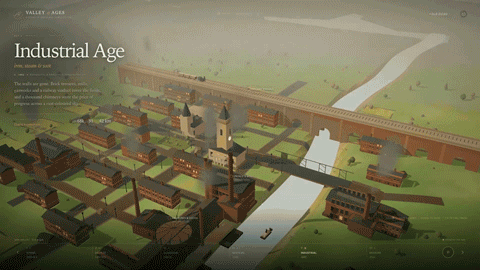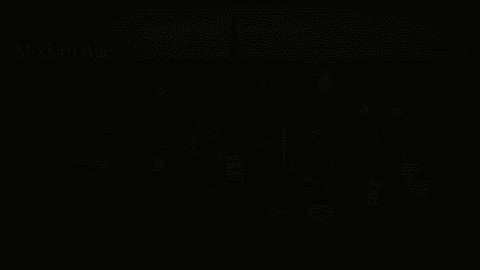
Ces captures montrent les exemples retenus pour la couverture de la version. Elles ne révèlent ni un taux de réussite complet pour tous les prompts, ni l’ensemble des interventions manuelles, ni la régularité avec laquelle un nouvel utilisateur pourrait reproduire le même résultat. Un projet convaincant en capture d’écran nécessite tout de même des tests fonctionnels et une vérification du code généré.
Avant l’annonce, des utilisateurs auraient repéré dans une liste de modèles une entrée éphémère se terminant par 1017. La source mentionne également une modification de l’empreinte système de deepseek-flash ainsi que des témoignages informels faisant état de réponses plus rapides et plus concises.
Une modification d’empreinte peut signaler un changement de service ou de configuration ; à elle seule, elle ne prouve ni l’identité ou l’architecture d’un modèle, ni sa qualité. De même, les scènes comparatives partagées par des utilisateurs constituent des exemples individuels, et non des comparaisons contrôlées.
La note de version publiée par la suite et le dépôt du modèle apportent une confirmation plus solide : la version DeepSeek-V4.1-Flash-1017 existe bien et dispose d’un tableau de benchmarks documenté ainsi que d’un service hébergé mis à jour. Il n’est pas nécessaire d’en déduire l’existence à partir des indices antérieurs.
Le dépôt indique que le code et les poids sont sous licence MIT. Il renvoie également les développeurs vers la référence d’encodage et les instructions d’inférence ; cette version ne comprend pas de modèle de conversation au format Jinja. Ces détails de mise en œuvre importent davantage pour l’auto-hébergement qu’une commande de démarrage rapide générique générée automatiquement.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Parallèlement à la mise à jour du modèle, DeepSeek a ouvert deux interfaces vers son propre système de recherche. Search repère les pages pertinentes, tandis que Fetch récupère le contenu d’une URL sélectionnée au format Markdown.
| API | Point de terminaison | Fonction |
|---|---|---|
| Search | POST https://api.deepseek.com/v1/tools/search | Renvoie des résultats de recherche classés, avec le contenu des pages en option. |
| Fetch | POST https://api.deepseek.com/v1/tools/fetch | Renvoie le titre d’une page et son contenu au format Markdown. |
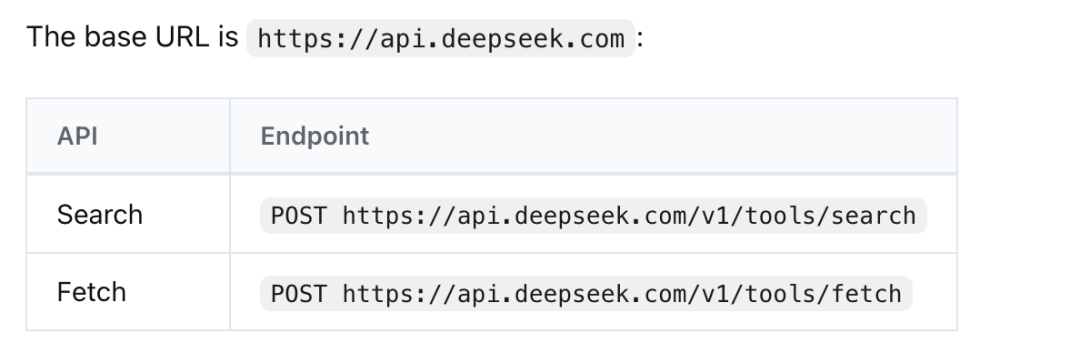
Ces API utilisent une clé d’API DeepSeek pour l’authentification. Search prend en charge des opérateurs permettant d’inclure ou d’exclure des sites, de limiter les résultats à une langue et de filtrer selon la date de publication. Un agent peut d’abord rechercher des sources, puis récupérer les pages sélectionnées et utiliser leur contenu à l’étape suivante de son analyse.
La récupération reste soumise à la disponibilité du site cible et à ses règles d’accès. L’ouverture de l’API Search ne donne pas à un agent un accès sans restriction à toutes les pages d’Internet.
Les deux API sont facturées par requête réussie, indépendamment des frais liés aux jetons du modèle. Le guide chinois indique un tarif de 5 RMB pour 1 000 requêtes réussies pour Search et pour Fetch ; le guide en anglais indique 0,75 $ pour 1 000 requêtes pour chacune. Il s’agit des tarifs publiés dans les guides correspondants, et non d’une conversion de devises calculée ici.
Une requête facturable doit renvoyer le code HTTP 200 et un résultat exploitable : une liste de résultats non vide pour Search, ou le contenu de la page pour Fetch. Les requêtes échouées, les recherches sans résultat et les délais d’attente dépassés ne sont pas facturés. Augmenter le nombre de résultats demandés à Search avec count ne modifie pas le tarif par requête.
Les guides ajoutent une règle transitoire précise pour les utilisateurs accédant à DeepSeek via Harness, Claude Code ou Codex. Les appels aux outils Search et Fetch effectués côté serveur dans ces flux de travail ne sont actuellement pas facturés ; leur facturation par requête doit commencer à 00:00, heure de Pékin, le 1er novembre 2026. Cela ne signifie pas que l’inférence du modèle ou toutes les requêtes directes à l’API sont gratuites jusqu’à cette date.
Il s’agit de la mise à jour du 17 octobre de DeepSeek V4.1 Flash. DeepSeek fait état d’améliorations du raisonnement, du codage, des tâches agentiques et des benchmarks visuels, ainsi que de réponses plus courtes et de durées d’exécution réduites.
La note de version indique qu’il faut continuer à utiliser deepseek-flash pour l’API hébergée. Cette version ne modifie ni la méthode d’appel ni la tarification du modèle.
DeepSeek recommande la version 0.2.1-rc.1 ou une version ultérieure pour le modèle mis à jour. Vérifiez la version via le mécanisme de mise à jour officiel du produit plutôt que de supposer que toute version 0.2 antérieure offre la même intégration.
Non. La couverture montre des exemples sélectionnés, et non un taux de réussite mesuré pour des prompts arbitraires. Pour reproduire un projet interactif, il faut vérifier l’exécution, les commandes, les ressources et le code généré dans l’environnement réel.
Search trouve des pages candidates et renvoie des résultats classés, avec leur contenu en option. Fetch lit une URL indiquée et renvoie le titre et le contenu de la page au format Markdown, sous réserve de son accessibilité.
La période temporaire sans facturation indiquée dans le guide concerne spécifiquement les appels d’outils côté serveur effectués via les flux de travail agentiques mentionnés. La facturation par requête de ces appels commence à 00:00, heure de Pékin, le 1er novembre 2026 ; la facturation des jetons du modèle est distincte.
DeepSeek-V4.1-Flash-1017 associe de meilleurs résultats rapportés sur les benchmarks agentiques à une volonté de réduire les ressources nécessaires aux tâches. Les intégrations hébergées existantes conservent l’alias deepseek-flash, tandis que les utilisateurs de Harness doivent passer à la version recommandée.
Search et Fetch ajoutent la découverte de sources et la lecture de pages au flux de travail ; leur facturation par requête doit être distinguée des coûts liés aux jetons du modèle.
Partez d’une phrase et obtenez un site complet en quelques minutes.



