For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/deepseek-flash-api-update-claims-what-is-2cceab91.md.
Certains utilisateurs de DeepSeek estiment que l’API officielle est devenue nettement meilleure pour produire des démonstrations de code vis...
Certains utilisateurs de DeepSeek estiment que l’API officielle est devenue nettement meilleure pour produire des démonstrations de code visuel. Dans un rapport du 15 octobre, QbitAI a rassemblé des exemples de scènes plus détaillées, d’animations plus fluides et d’un éclairage amélioré, les utilisateurs situant ce changement apparent autour du 12 octobre.
C’est un signal intéressant, mais une question importante reste ouverte : le modèle sous-jacent a-t-il changé, ou un ensemble de générations exceptionnellement réussies a-t-il créé cette impression ? Le mappage des modèles documenté publiquement est clair. La mise à jour supposée d’octobre n’est pas confirmée par les sources officielles examinées pour cet article.
Les exemples du rapport de QbitAI se concentrent en grande partie sur des projets visuels générés. Les utilisateurs citent des scènes de type jeu vidéo, un projet dans le style de Minecraft et le défi bien connu consistant à représenter un pélican à vélo. Leur attention porte sur la qualité du résultat : des détails plus riches, des mouvements plus convaincants et une présentation générale plus forte.
Certains signalent également une génération plus lente. Cela peut compter dans un flux de travail de programmation, où un meilleur livrable final peut justifier une attente supplémentaire, mais ces témoignages n’établissent pas une évolution mesurée de la latence du service dans l’ensemble de l’API.
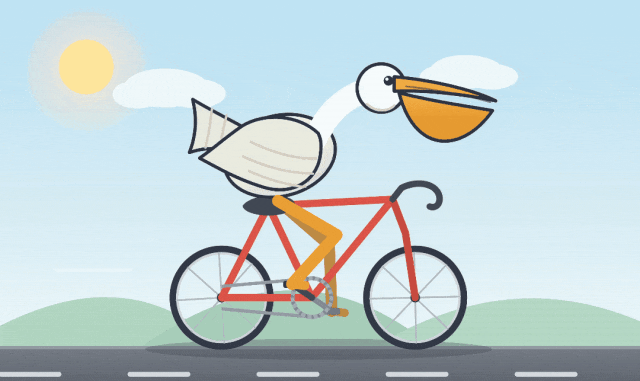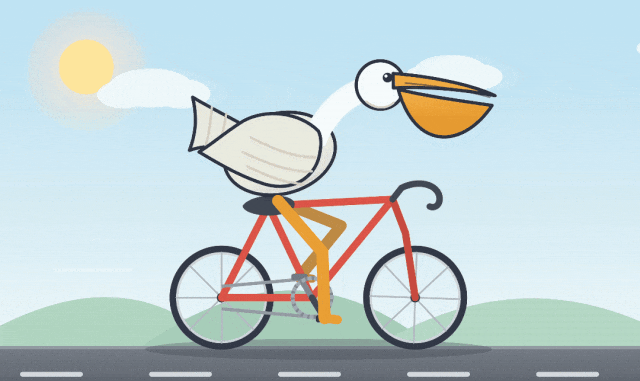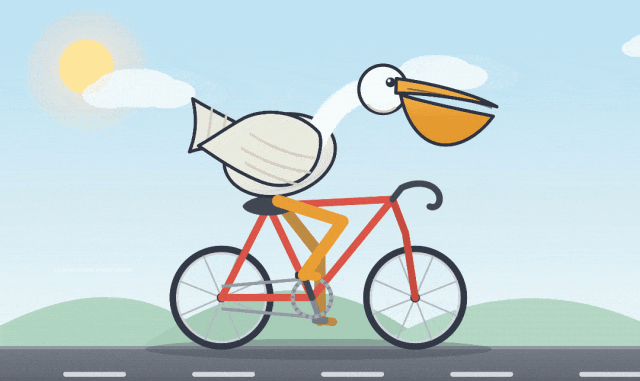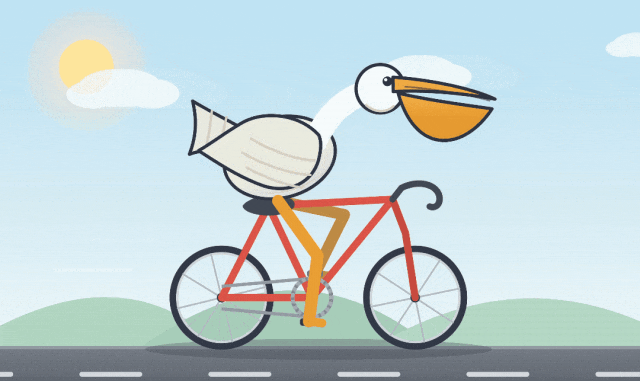
Source : QbitAI via BAAI Hub. Ce résultat illustratif est l’un des exemples examinés dans le rapport ; il ne constitue pas une preuve permettant d’identifier un point de contrôle de modèle particulier.
La source fait aussi état de désaccords. D’autres testeurs n’ont pas constaté d’amélioration nette, et la variation aléatoire reste une explication plausible. Ces observations divergentes font partie de l’histoire, plutôt que d’être un détail à écarter au profit des captures d’écran les plus impressionnantes.
L’introduction à l’API de DeepSeek répertorie actuellement deepseek-flash et deepseek-v4-pro comme noms de modèles documentés. Elle associe deepseek-flash à DeepSeek-V4.1-Flash.
L’annonce de publication du 10 septembre identifie DeepSeek-V4.1-Flash comme le modèle publié. La page des mises à jour, examinée le 15 octobre, affichait cette publication de septembre comme entrée visible la plus récente, sans annonce distincte datée du 12 octobre.
| Nom ou affirmation | Ce que les sources examinées établissent |
|---|---|
deepseek-flash | Le nom d’API documenté associé à DeepSeek-V4.1-Flash. |
deepseek-v4-pro | Un modèle documenté séparément qui reste disponible. |
deepseek-v4-flash | Un alias historique dont le modèle sous-jacent retiré est redirigé vers V4.1-Flash. |
deepseek-v4-flash-vision-exp | Un autre alias historique accepté, redirigé vers V4.1-Flash. |
| Une publication d’octobre appelée V4.2 Flash | Une spéculation communautaire mentionnée dans le rapport ; non confirmée par les sources officielles vérifiées. |
Ce détail de routage rend les comparaisons plus complexes. Deux requêtes portant des noms différents peuvent atteindre le même modèle sous-jacent documenté ; comparer un ancien alias à deepseek-flash ne constitue donc pas automatiquement une comparaison entre deux générations de modèles.
L’absence d’entrée dans le journal des modifications ne prouve pas qu’aucun ajustement du backend n’a eu lieu. Elle signifie que le registre officiel disponible ne permet pas d’étayer les affirmations précises concernant une nouvelle version qui circulent actuellement.
QbitAI décrit plusieurs explications concurrentes proposées par les utilisateurs : une éventuelle publication de V4.2 Flash, un point de contrôle V4.1 révisé ou une modification impliquant une autre configuration de modèle. Aucune ne peut être établie en examinant simplement une scène générée.
Une démonstration de code peut paraître meilleure grâce à une conception visuelle plus réussie, tout en contenant des défauts de gestion des entrées, de logique de collision ou de performances. Quelques succès sélectionnés disent également peu de choses sur le taux d’échec dans les tâches ordinaires.
La configuration de l’API compte également. La référence de complétion de chat de DeepSeek documente les contrôles de réflexion et l’effort de raisonnement ; une comparaison utile doit donc enregistrer ces paramètres en même temps que le prompt. Une requête qui utilise un budget de raisonnement différent n’est pas un test équivalent, même si ses instructions visibles sont identiques.
Une erreur particulièrement facile consiste à supposer que des paramètres d’échantillonnage connus se comportent de la même manière dans chaque mode. La référence actuelle indique que temperature n’a aucun effet en mode réflexion. Elle décrit également un comportement spécifique au mode pour top_p, qu’il convient de vérifier avant d’attribuer un résultat à une modification de paramètre.
Le suivi le plus utile est une comparaison reproductible à l’aide de tâches qui vous importent réellement. Elle peut être modeste, mais doit comporter suffisamment de détails pour distinguer une véritable amélioration du flux de travail d’une génération unique impressionnante.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
La réponse de l’API inclut des champs tels que model, system_fingerprint, created, l’utilisation et finish_reason. Ils peuvent rendre une comparaison plus facile à auditer. La documentation décrit system_fingerprint comme un identifiant de configuration backend ; il ne doit pas être considéré comme un décodeur public des poids exacts d’un modèle ni comme l’annonce d’une publication nommée.
Pour les équipes qui utilisent déjà l’API en production, un ensemble d’évaluation sauvegardé fournit également une base de référence pratique pour les changements futurs. Un résultat peut alors être décrit précisément : par exemple, davantage de tâches ont réussi avec une configuration enregistrée, avec une différence de latence mesurée. C’est plus exploitable qu’affirmer simplement que le modèle semble plus intelligent.
Le rapport est utile pour réévaluer un modèle sur des tâches où les résultats antérieurs étaient insuffisants. Il n’établit pas une nouvelle exigence de déploiement, un nouvel endpoint ni un modèle de remplacement confirmé.
DeepSeek continue de documenter l’URL de base compatible OpenAI comme https://api.deepseek.com et l’URL de base compatible Anthropic comme https://api.deepseek.com/anthropic. Il s’agit d’adresses de service d’API, et non de liens destinés à afficher une page de documentation classique dans un navigateur. Les intégrations existantes doivent suivre la référence officielle actuelle plutôt que de modifier les noms de modèles sur la base d’une supposition provenant des réseaux sociaux.
Lorsque le budget compte, consultez la page de tarification actuelle en fonction du modèle réel et du profil d’utilisation. Une amélioration de qualité perçue ne permet pas, à elle seule, d’établir que la longueur des réponses, la latence ou le coût nécessaire pour terminer une tâche sont restés constants.
Aucune annonce de ce type n’a été trouvée dans le journal officiel des modifications vérifié le 15 octobre 2026. QbitAI rapporte des observations d’utilisateurs autour de cette date, qui ne confirment pas à elles seules une publication.
deepseek-flash utilise-t-il actuellement ?L’introduction officielle de l’API l’associe à DeepSeek-V4.1-Flash. Les développeurs doivent consulter cette documentation en direct lorsqu’ils ont besoin du mappage actuel, plutôt que de le déduire des résultats générés.
La documentation indique que deepseek-v4-flash et deepseek-v4-flash-vision-exp restent acceptés, mais que leurs modèles sous-jacents d’origine ont été retirés. Les requêtes passant par ces alias sont redirigées vers V4.1-Flash et facturées aux tarifs Flash.
system_fingerprint prouve-t-il qu’un nouveau modèle a été publié ?Non. Ce champ identifie la configuration backend et peut aider à documenter les différences entre les exécutions, mais il n’identifie pas indépendamment un point de contrôle nommé et ne prouve pas une modification spécifique des poids.
La référence actuelle de complétion de chat indique que temperature n’a aucun effet en mode réflexion. Enregistrez les paramètres de réflexion et d’effort de raisonnement, gardez la tâche fixe et utilisez des essais répétés au lieu de supposer que la température rendra ces exécutions équivalentes.
Séparez l’évaluation visuelle des tests fonctionnels. Vérifiez les commandes, les changements d’état, le chargement et les erreurs d’exécution, puis comparez plusieurs tentatives avec les mêmes exigences et paramètres enregistrés.
Le rapport de QbitAI indique qu’un groupe d’utilisateurs observe de meilleures sorties de code visuel avec DeepSeek, tandis que d’autres testeurs restent peu convaincus. La documentation officielle associe deepseek-flash à V4.1-Flash, mais le journal des modifications examiné ne confirme pas la mise à jour supposée d’octobre.
Considérez ces exemples comme une raison de mener une évaluation contrôlée, et distinguez une amélioration revendiquée d’une histoire non confirmée sur une nouvelle version de modèle.
Partez d’une phrase et obtenez un site complet en quelques minutes.



