DeepSeek V4 Flash 0731 a suscité une combinaison inhabituelle de réactions. Les développeurs sont impressionnés par ses scores en tant qu'ag...
DeepSeek V4 Flash 0731 a suscité une combinaison inhabituelle de réactions.
Les développeurs sont impressionnés par ses scores en matière d'agents de codage.
Les équipes d'infrastructure s'intéressent à son contexte d'un million de jetons et à son faible nombre de paramètres actifs.
Les plateformes d'IA proposent une utilisation gratuite et des remises agressives.
Et les réseaux sociaux se remplissent de captures d'écran de prototypes dont les factures d'inférence rapportées se mesurent en centimes plutôt qu'en dollars.
Les exemples les plus largement partagés dans l'article source comprenaient :
Ces exemples capturent l'enthousiasme, mais ils peuvent aussi brouiller plusieurs choses distinctes :
Le modèle est véritablement peu coûteux.
Cela ne signifie pas que chaque application coûtera sept centimes.
La question utile n'est pas de savoir si une démo virale est exactement reproductible. C'est de savoir comment DeepSeek a réalisé un bond de capacité aussi important sans modifier l'architecture de base — et ce que la nouvelle économie signifie pour les développeurs.
Le prix officiel de l'API était déjà bas avant l'application des promotions tierces.
DeepSeek liste actuellement les prix suivants par million de jetons :
| Type d'utilisation | Prix DeepSeek V4 Flash |
|---|---|
| Entrée, correspondance de cache | $0,0028 |
| Entrée, absence de correspondance de cache | $0,14 |
| Sortie | $0,28 |
L'API prend en charge :
low, high et max.Ces prix officiels constituent la référence.
Les plateformes peuvent ensuite choisir de :
C'est pourquoi un développeur peut payer le prix catalogue de DeepSeek tandis qu'un autre ne paie rien pendant une période limitée.
OpenCode a déclaré publiquement que DeepSeek Flash a traité 8 billions de jetons le 1er août via sa plateforme.
Le post décompose le chiffre comme suit :
5 T de jetons d'utilisation gratuite
+
3 T de jetons via OpenCode Go

La documentation Zen actuelle d’OpenCode répertorie une option DeepSeek V4 Flash Gratuit disponible pour une durée limitée.
C’est une distinction importante.
Le chiffre de huit billions de tokens décrit le trafic via OpenCode, et non l’utilisation directe rapportée par DeepSeek sur toutes les plateformes.
C’est néanmoins un signal fort que les modèles à faible coût peuvent générer une demande énorme lorsqu’ils sont intégrés dans un flux de travail d’agent de codage populaire.
Nous Research a annoncé une promotion de sept jours offrant DeepSeek V4 Flash 0731 à 90 % de réduction via Nous Portal, en partenariat avec Novita Labs.

Le message promotionnel a comparé le coût réduit avec Claude Fable 5 et a affirmé une différence de prix de plus de 1 000 fois sur des tâches comparables.
Cette comparaison dépend de plusieurs choix :
Une comparaison prix par token est utile, mais la mesure la plus significative est :
Coût total par tâche acceptée
Un modèle qui utilise moins de tokens coûteux peut être moins cher qu’un modèle à bas prix qui réessaie à plusieurs reprises.
À l’inverse, lorsqu’un modèle à bas prix est également suffisamment performant pour terminer la tâche rapidement, l’avantage de coût peut devenir énorme.
Cline a d’abord annoncé une utilisation gratuite de V4 Flash 0731 via son agent de codage.
Un message public ultérieur a indiqué que le quota gratuit avait été triplé, car l’économie semblait durable.

Le catalogue de modèles actuel de Cline et le matériel ClinePass incluent DeepSeek V4 Flash comme option rapide et axée sur la valeur pour les tâches de codage ciblées.
Les quotas gratuits et la disponibilité des modèles peuvent changer, les utilisateurs doivent donc consulter la page du fournisseur en direct plutôt que de se fier à une ancienne capture d’écran.
La leçon plus large est plus durable.
Lorsque l’inférence devient suffisamment bon marché, une plateforme d’agents peut utiliser l’accès gratuit comme acquisition de clients sans absorber
le même coût qu'il aurait avec un modèle frontal premium.
L'article source comprend un tableau de bord montrant :
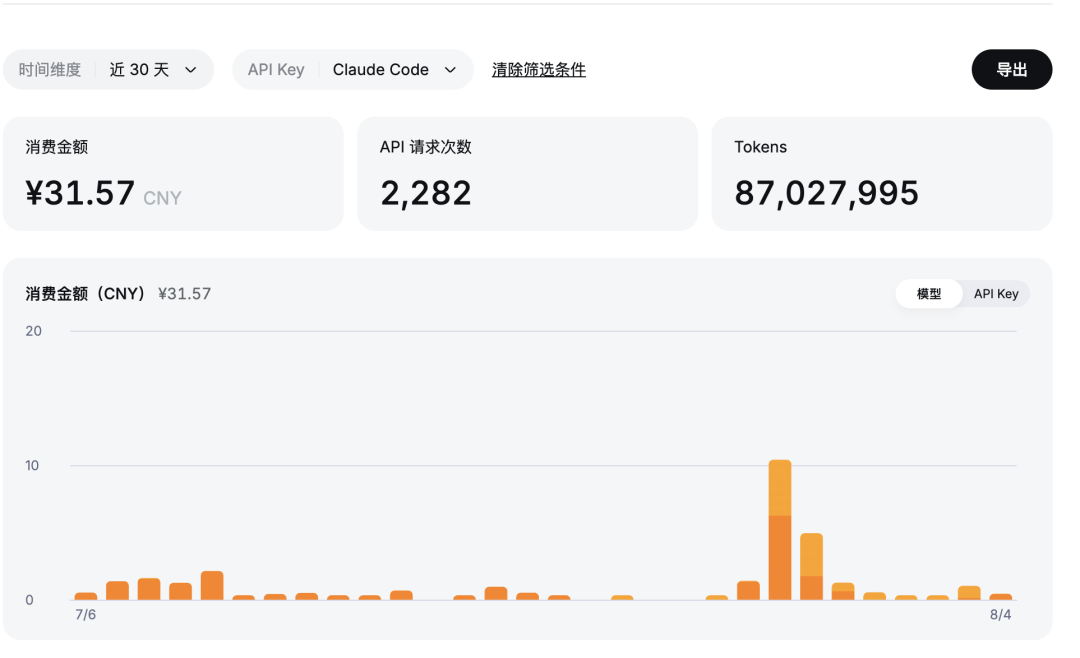
La capture d'écran est utile car elle démontre l'ordre de grandeur que les développeurs peuvent observer dans des schémas d'utilisation favorables.
Elle ne révèle pas suffisamment d'informations pour reconstruire la facture avec précision.
Les variables manquantes comprennent :
Une longue invite système répétée peut être extrêmement bon marché lorsqu'elle touche le cache.
Une longue invite unique envoyée une seule fois est facturée au prix d'entrée sans hit de cache.
La sortie est également beaucoup plus coûteuse que l'entrée en cache.
Pour les systèmes d'agents, ces différences dominent la facture finale.
DeepSeek V4 Preview a été lancé le 24 avril 2026.
La famille comprenait :
La version Preview a établi l'architecture principale :
V4 Flash Preview a été positionné comme l'alternative plus petite, plus rapide et moins chère à V4 Pro.
La mise à jour du 31 juillet a changé sa position concurrentielle.
DeepSeek déclare que V4 Flash 0731 utilise la même architecture et la même taille de modèle que V4 Flash Preview.
La mise à jour a été produite en exécutant un nouveau processus de post-entraînement.
Sous forme simplifiée :
Même architecture de base pré-entraînée
+
nouveau post-entraînement et optimisation d'agent
=
comportement d'agent de codage beaucoup plus fort
Cela importe car cela montre combien de capacité peut rester latente dans un modèle pré-entraîné.
L'architecture et le nombre de paramètres ne constituent pas l'intégralité du produit.
Le post-entraînement détermine l'efficacité avec laquelle le modèle :
La fiche modèle originale de V4 Flash décrit le modèle de base comme suit :
| Spécification | DeepSeek V4 Flash |
|---|---|
| Paramètres MoE de base totaux | 284B |
| Paramètres activés | 13B |
| Longueur du contexte | 1M |
| Licence | MIT |
| Modalité principale | Texte |
| Précision de base | FP8 / précision mixte faible selon le point de contrôle |
La fiche modèle 0731 indique que la nouvelle version a la même structure que la variante DSpark et comprend un module de décodage spéculatif attaché.
Cela explique pourquoi certaines métadonnées de fichiers de modèle peuvent afficher
un nombre total de points de contrôle plus important que le chiffre de 284B du MoE de base.
La description la plus claire est :
Le modèle MoE sous-jacent de V4 Flash reste d’environ 284B au total avec 13B paramètres actifs, tandis que la version 0731 inclut le composant supplémentaire de décodage spéculatif DSpark dans le point de contrôle publié.
Le décodage spéculatif utilise un processus de rédaction rapide pour proposer plusieurs jetons futurs.
Le modèle principal vérifie ensuite ces propositions.
Lorsque les prédictions sont acceptées, le système peut produire plusieurs jetons avec moins de travail séquentiel.
La fiche du modèle 0731 de DeepSeek fournit un support explicite de DSpark pour vLLM et SGLang.
Pour vLLM, la configuration pertinente est :
--speculative-config '{"method":"dspark","num_speculative_tokens":7,"draft_sample_method":"greedy"}'
Pour SGLang, la fiche du modèle utilise :
--speculative-algorithm DSPARK
DSpark n’améliore pas en soi le raisonnement du modèle.
Il s’agit d’une optimisation d’inférence destinée à réduire la latence de décodage ou à augmenter le débit tout en préservant la distribution de sortie du modèle cible dans la configuration prise en charge.
DeepSeek publie la comparaison suivante pour V4 Flash 0731 :
| Benchmark | V4 Flash 0731 | V4 Flash Preview | V4 Pro Preview |
|---|---|---|---|
| Terminal Bench 2.1 | 82,7 | 61,8 | 72,1 |
| NL2Repo | 54,2 | 39,4 | 38,5 |
| CyberGym | 76,7 | 38,7 | 52,7 |
| DeepSWE | 54,4 | 7,3 | 12,8 |
| Toolathlon-Verified | 70,3 | 49,7 | 55,9 |
| Agents’ Last Exam | 25,2 | 15,8 | 16,5 |
| AutomationBench Public | 25,1 | 10,8 | 12,8 |
| DSBench-FullStack | 68,7 | 37,0 | 41,8 |
| DSBench-Hard | 59,6 | 25,8 | 31,1 |
L’augmentation la plus spectaculaire est DeepSWE :
7,3 → 54,4
CyberGym double presque :
38,7 → 76,7
Terminal Bench 2.1 augmente de plus de vingt points :
61,8 → 82,7
Le nouveau modèle Flash dépasse également V4 Pro Preview sur tous les benchmarks du tableau publié par DeepSeek.
C’est un changement majeur pour un modèle initialement positionné principalement comme l’option moins chère et plus rapide.
Le tableau ne doit pas être lu comme une pure comparaison des points de contrôle bruts.
La fiche du modèle de DeepSeek comprend plusieurs notes importantes.
Pour les tâches publiques d’agents de code, l’entreprise a utilisé :
DeepSeek Harness mode minimal
Effort de raisonnement : max
Température : 1,0
Top-p : 0,95
DeepSeek Harness n’avait pas été publié publiquement au moment de la vérification.
Cela signifie que les chercheurs extérieurs ne peuvent pas encore reproduire l’environnement logiciel exact utilisé pour les résultats publiés des agents de code.
Deux tests sont également internes :
Les benchmarks internes peuvent être utiles pour le développement de produits, mais les équipes indépendantes ne peuvent pas inspecter leurs tâches cachées ni leurs contrôles de contamination.
L’interprétation correcte est la suivante :
DeepSeek rapporte une grande amélioration dans sa pile d’agents et sa configuration d’évaluation choisies. La reproductibilité publique s’améliorera lorsque le harness, les prompts, les journaux et la configuration complète d’évaluation seront disponibles.
Un benchmark de codage mesure souvent un système complet :
Modèle
+
prompt système
+
outils de dépôt
+
terminal
exécution
+
gestion du contexte
+
politique de nouvelle tentative
+
retour de test
+
logique de soumission de patch
Le même modèle peut obtenir des scores différents lorsqu'un seul composant change.
Un meilleur harnais peut :
Cela ne rend pas le modèle inutile.
Cela signifie que le résultat du benchmark appartient à la combinaison modèle-et-harnais.
Les chiffres élevés de 0731 suggèrent que DeepSeek a amélioré à la fois le comportement d'agent du modèle et le processus d'évaluation environnant.
Artificial Analysis rapporte un score d'indice d'intelligence d'environ 50 pour DeepSeek V4 Flash 0731, soit environ dix points de plus que la version Flash précédente.
La société indépendante d'analyse des modèles décrit également V4 Flash comme exceptionnellement peu coûteuse par rapport à d'autres systèmes frontaliers bien connus.
Reuters a résumé les conclusions d'Artificial Analysis en rapportant un coût moyen de test de référence d'environ trois cents américains selon sa méthodologie.
Cette comparaison soutient l'argument de la valeur.
Cela ne signifie pas que chaque tâche de production coûte trois cents.
Artificial Analysis rapporte également des résultats plus faibles sur certaines mesures de fiabilité des connaissances.
Son article sur V4 Flash 0731 note :
Ces chiffres sont un rappel utile.
Un modèle peut être :
« Meilleure valeur » n'est pas la même chose que « meilleur pour chaque tâche ».
Le prix direct de l'API DeepSeek est :
| Catégorie de facturation | Prix par million de jetons |
|---|---|
| Entrée avec cache atteint | 0,0028 $ |
| Entrée sans cache | 0,14 $ |
| Sortie | 0,28 $ |
L'écart de prix entre un cache atteint et un cache manqué est énorme :
0,14 $ ÷ 0,0028 $ = 50
L'entrée en cache est cinquante fois moins chère que l'entrée non mise en cache.
Pour les agents de longue durée, la structure du prompt devient une architecture de coûts.
Supposons qu'une requête utilise :
100 000 jetons d'entrée sans cache
20 000 jetons de sortie
Le coût direct du modèle est :
Entrée :
100 000 / 1 000 000 × 0,14 $
= 0,014 $

Sortie :
20 000 / 1 000 000 × 0,28 $
= 0,0056 $

Total :
0,0196 $
Cela représente moins de deux cents américains.
Supposons maintenant que le même préfixe de 100 000 jetons soit mis en cache :
Entrée en cache :
100 000 / 1 000 000 × 0,0028 $
= 0,00028 $

Sortie :
20 000 / 1 000 000 × 0,28 $
= 0,0056 $

Total :
0,00588 $
La sortie domine désormais la facture.
Ces exemples expliquent pourquoi les prototypes de codage à faible coût sont plausibles.
Ils n'incluent pas :
Le codage par agent est rarement une seule requête.
Un flux de travail typique peut inclure :
échec.
7. Modifiez à nouveau.
8. Exécutez à nouveau les tests.
9. Examinez la différence.
10. Produisez la réponse finale.
Chaque étape peut générer un nouvel appel au modèle.
Une tâche apparemment simple peut devenir coûteuse lorsque :
V4 Flash réduit le coût de ces erreurs.
Il ne les élimine pas.
DeepSeek utilise une mise en cache du contexte basée sur le disque.
Lorsque le même préfixe est réutilisé, les jetons d’entrée correspondants peuvent bénéficier du prix réduit applicable aux accès au cache.
De bons candidats pour un préfixe stable incluent :
Une conception d’invite simplifiée est :
Préfixe stable réutilisable
+
nouvelle demande utilisateur
+
dernier résultat d’outil
Une conception moins favorable à la mise en cache est :
Instructions réordonnées
+
résumé du dépôt réécrit
+
horodatages changeants
+
métadonnées de requête aléatoires
+
nouvelle demande utilisateur
De petits changements dans le préfixe peuvent réduire la réutilisation du cache.
Les développeurs doivent inspecter les champs d’utilisation des jetons plutôt que de supposer qu’une longue invite a été mise en cache.
DeepSeek propose également l’isolation par user_id pour la confidentialité et l’ordonnancement. La réutilisation du cache et l’isolation des utilisateurs doivent être conçues ensemble afin que le contexte d’un client ne soit pas accidentellement mélangé à celui d’un autre.
L’URL de base officielle reste :
https://api.deepseek.com
L’identifiant du modèle est :
deepseek-v4-flash
DeepSeek indique que l’identifiant API stable sert automatiquement la dernière version officielle de Flash.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
C’est pratique, mais les équipes de production doivent enregistrer l’empreinte du modèle renvoyée et tester les modifications, car le comportement derrière un identifiant stable peut être mis à niveau.
from openai import OpenAI

client = OpenAI(
    api_key="VOTRE_CLÉ_API_DEEPSEEK",
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-v4-flash",
    messages=[
        {
            "role": "user",
            "content": "Examinez cette fonction et proposez une refactorisation sûre.",
        }
    ],
)

print(response.choices[0].message.content)
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -d '{
    "model": "deepseek-v4-flash",
    "messages": [
      {
        "role": "user",
        "content": "Écrivez un petit CLI Python qui valide des fichiers JSON."
      }
    ]
  }'
Les développeurs doivent consulter la référence API en direct pour connaître les champs exacts d’effort de raisonnement et de mode de réflexion pris en charge par leur point de terminaison et leur version du SDK.
La documentation du mode de réflexion de DeepSeek indique que lorsqu’un tour inclut des appels d’outils, le reasoning_content du message de l’assistant doit être renvoyé dans les requêtes suivantes.
Un agent multitour doit conserver :
contentreasoning_content
tool_callsL'abandon de l'état de raisonnement peut réduire la continuité ou provoquer des problèmes de validation des requêtes.
C'est particulièrement pertinent lors de l'intégration via un client compatible OpenAI qui ignore normalement les champs de raisonnement spécifiques au fournisseur.
DeepSeek fournit plus d'une interface.
Utilisez l'URL de base standard DeepSeek et l'ID du modèle :
deepseek-v4-flash
DeepSeek documente également une interface au format Anthropic.
Cela peut aider les logiciels conçus autour des messages de style Claude à se connecter à DeepSeek avec moins de modifications applicatives.
La compatibilité ne garantit pas un comportement identique.
Les champs spécifiques au fournisseur, l'historique de raisonnement, les schémas d'outils, le comportement de sécurité et la gestion des erreurs nécessitent toujours des tests.
DeepSeek indique que la version 0731 prend nativement en charge le format de l'API Responses et a été adaptée pour une utilisation de type Codex.
Cela importe pour les produits d'agents de codage qui dépendent de plus en plus d'objets de réponse avec état, d'appels d'outils et de boucles d'agents structurées.
DeepSeek a publié les poids de V4 Flash 0731 sur Hugging Face sous licence MIT.
Cela permet aux développeurs d'inspecter, de modifier, de déployer et de redistribuer le modèle conformément aux termes de la licence.
La publication des poids ouverts offre plus de contrôle qu'un modèle accessible uniquement par API.
Les équipes peuvent :
La barrière pratique est le matériel.
« Poids ouverts » ne signifie pas « fonctionne sur un ordinateur portable standard ».
La fiche modèle officielle 0731 fournit un exemple vLLM pour un seul nœud 4×GB300 :
vllm serve deepseek-ai/DeepSeek-V4-Flash-0731 \
  --trust-remote-code \
  --kv-cache-dtype fp8 \
  --block-size 256 \
  --data-parallel-size 4 \
  --enable-expert-parallel \
  --moe-backend deep_gemm_mega_moe \
  --attention-config '{"use_fp4_indexer_cache": true}' \
  --speculative-config '{"method":"dspark","num_speculative_tokens":7,"draft_sample_method":"greedy"}'
Cet exemple illustre la classe d'infrastructure attendue pour un service de pleine qualité.
Il ne doit pas être interprété comme la seule configuration prise en charge.
La recette vLLM pourrait ajouter la prise en charge d'autres topologies GPU au fil du temps.
L'exemple officiel SGLang est :
sglang serve \
  --trust-remote-code \
  --model-path deepseek-ai/DeepSeek-V4-Flash-0731 \
  --tp 4 \
  --moe-runner-backend flashinfer_mxfp4 \
  --speculative-algorithm DSPARK \
  --mem-fraction-static 0.90 \
  --chunked-prefill-size 4096 \
  --swa-full-tokens-ratio 0.1
Les poids cibles et de brouillon proviennent du même point de contrôle, donc la documentation indique de ne pas définir de chemin séparé pour le modèle de brouillon spéculatif.
Les moteurs d'inférence évoluent rapidement.
Utilisez la fiche modèle actuelle et la recette du moteur de service plutôt que de copier une ancienne commande de lancement de la version Preview.
Même si seulement environ
13B paramètres sont actifs pour un jeton, les poids complets du modèle doivent rester disponibles sur l’ensemble du système de service.
La planification du déploiement doit prendre en compte :
Des quantifications plus petites peuvent permettre des expérimentations sur différents matériels, mais elles peuvent modifier la qualité, la vitesse ou la longueur de contexte prise en charge.
Pour la plupart des développeurs individuels, l’API directe ou un fournisseur hébergé sera plus facile et moins coûteux que l’auto-hébergement.
Il existe trois façons courantes d’utiliser V4 Flash.
| Route | Principal avantage | Principal compromis |
|---|---|---|
| API DeepSeek | Tarification officielle et modèle officiel actuel | Les données quittent votre environnement ; l’ID stable peut être mis à jour |
| Plateforme tierce | Quotas gratuits, agents intégrés, facturation simplifiée | Les promotions et le routage peuvent changer |
| Poids auto-hébergés | Contrôle maximal et confidentialité | Exigences matérielles et techniques importantes |
La route la moins chère dépend de la charge de travail.
Un quota gratuit de Cline ou OpenCode peut être idéal pour l’expérimentation.
L’API directe peut être idéale pour une utilisation à petite échelle prévisible.
L’auto-hébergement peut devenir attrayant uniquement à un volume soutenu suffisamment élevé ou lorsque les exigences de confidentialité dominent.
L’article source compare l’IA peu coûteuse à la production de masse des automobiles.
L’analogie est imparfaite mais utile.
Lorsqu’une technologie devient nettement moins chère, le marché n’achète pas simplement la même quantité pour moins cher.
De nouvelles utilisations deviennent possibles.
Des modèles d’agents à faible coût peuvent soutenir des expériences qui auraient auparavant été rejetées avant même d’être testées.
Les exemples incluent :
La valeur n’est pas que le modèle remplace tout le génie logiciel.
Elle réduit le coût de la question :
Cette idée vaut-elle la peine d’être développée davantage ?
La génération peu coûteuse peut produire une première démo convaincante.
Un produit en production nécessite toujours :
Une facture de modèle de sept cents ne signifie pas une entreprise de sept cents.
Cela signifie que la première expérience computationnelle peut être assez peu coûteuse pour être tentée.
Cela change qui peut participer et combien d’idées peuvent être testées.
L’article source inclut un espace de travail documentaire léger présenté comme un exemple de ce que les développeurs construisaient avec des agents de codage peu coûteux.
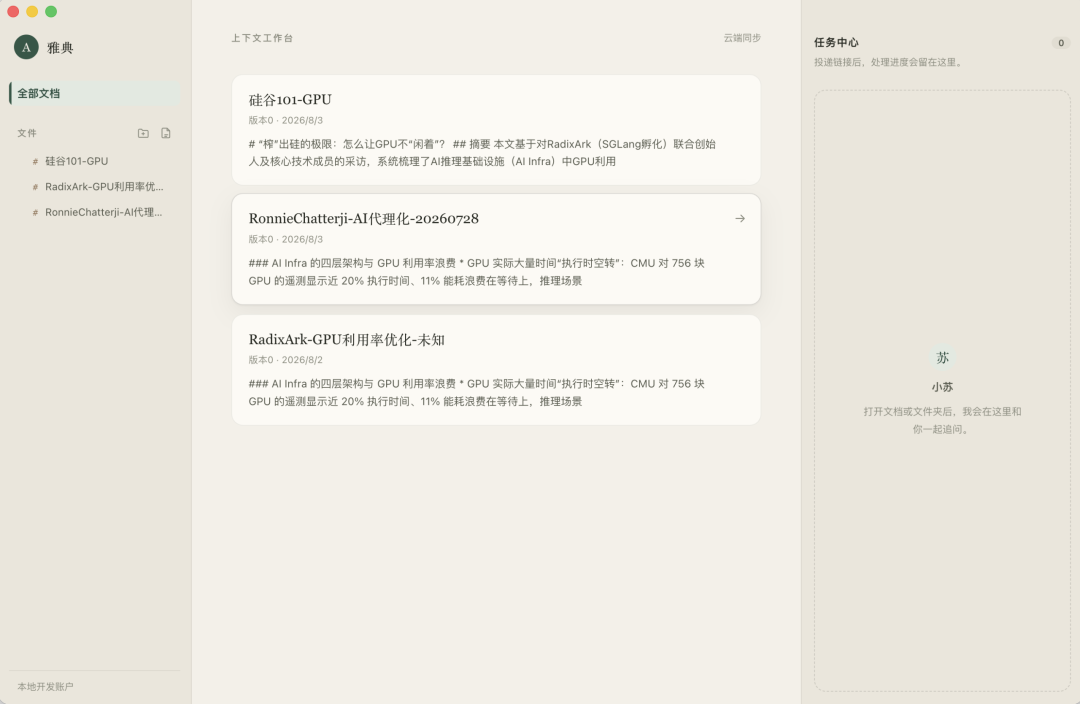
Une capture d'écran ne peut pas établir quelle partie de l'application a été produite par le modèle, quelle quantité de modification humaine a été nécessaire, ni si le produit est sécurisé et maintenable.
Elle montre néanmoins le type de projet que les modèles de codage à faible coût rendent plus facile à prototyper.
V4 Flash 0731 est particulièrement intéressant lorsque :
Il peut être moins adapté lorsque :
Un routeur de modèles peut combiner Flash avec un système plus puissant ou plus spécialisé.
Par exemple :
Modifications de routine du référentiel
→ V4 Flash

Décisions d'architecture ou de sécurité à haut risque
→ modèle plus puissant + examen humain
Lorsque les appels de modèles sont coûteux, les développeurs essaient de minimiser chaque requête.
Lorsque les appels deviennent bon marché, un agent peut se permettre de :
Cela peut améliorer la fiabilité.
Cela peut aussi gaspiller des jetons.
L'objectif n'est pas une utilisation minimale de jetons.
C'est :
Le coût total le plus bas qui atteint la qualité requise
DeepSeek décrit l'API Flash officielle comme une version bêta publique.
Les prix, le comportement, les limites et les versions du modèle peuvent changer.
Les équipes de production devraient maintenir des tests de régression.
Les meilleurs résultats d'agents de codage utilisent une configuration de harnais non publiée.
Une reproduction indépendante exacte n'est pas encore simple.
La sortie, les tentatives, les outils et le contexte non mis en cache peuvent dominer le coût final.
Une fenêtre d'un million de jetons est une limite de capacité, pas une recommandation d'envoyer un million de jetons dans chaque requête.
Les charges de pré-remplissage importantes augmentent la latence et le coût.
L'évaluation indépendante montre que la valeur et la force du codage peuvent coexister avec un taux d'hallucination élevé lors des tests factuels.
Les faits critiques doivent être vérifiés par rapport aux sources.
Les modèles à faible coût peuvent générer plus de code qu'une équipe ne peut en inspecter en toute sécurité.
Les tests automatisés, l'analyse statique, l'analyse des dépendances et la révision humaine restent nécessaires.
Les modèles gratuits et les remises de tiers peuvent disparaître.
Ne construisez pas un modèle économique permanent autour d'une subvention de sept jours ou à durée limitée.
L'identifiant de modèle deepseek-v4-flash pointe vers la version actuelle.
Une mise à niveau derrière cet identifiant peut modifier les sorties sans changement de code dans votre application.
Maintenez la cohérence des instructions système et des définitions d'outils pour améliorer la réutilisation du cache.
Ne vous fiez pas uniquement au nombre total de jetons d'entrée.
Définissez un budget de sortie réaliste pour la tâche.
Réservez max aux tâches qui bénéficient d'une réflexion plus longue.
Arrêtez les boucles qui ne progressent pas.
Utilisez des linters, des tests, des validateurs de schéma et des contrôles déterministes.
Faites remonter uniquement lorsque la tâche échoue à un test ou dépasse un seuil de risque.
Incluez les tentatives échouées et la vérification humaine.
L'article source se termine par une possible prochaine étape dans l'écosystème de développement de DeepSeek.
Tianyi Cui, identifié dans la source comme la personne responsable de DeepSeek Harness, a publié un message de recrutement pour des développeurs de projets open source de type harness pour agents.
Le message invitait les développeurs intéressés à partager un compte GitHub et des travaux open source représentatifs pour participer aux tests internes.
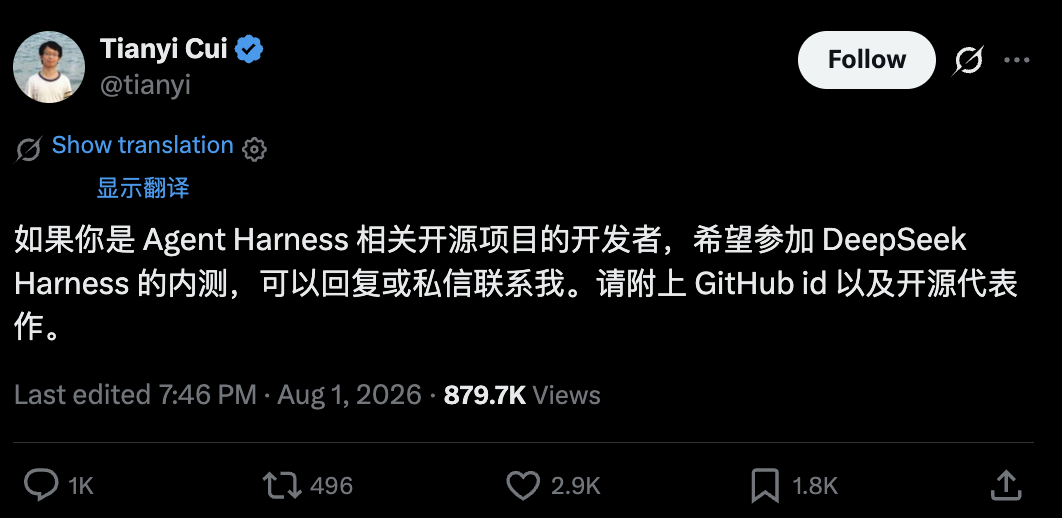
Le journal des modifications du 31 juillet de DeepSeek indique également que le mode minimal de DeepSeek Harness utilisé pour l'évaluation des benchmarks est « à venir prochainement ».
Au moment de la vérification, je n'ai pas localisé :
Les éléments disponibles confirment cette conclusion plus restreinte :
DeepSeek teste un harness pour agents et prévoit de publier au moins une partie du framework, mais le nom final du produit, la portée publique et le calendrier de lancement restent non confirmés.
Le modèle, l'API et les poids ouverts sont disponibles dès maintenant.
Le harness reste un composant futur de l'écosystème.
Un harness de première partie pourrait aider DeepSeek à contrôler toute la pile des agents de codage.
Il pourrait fournir :
DeepSeek documente déjà des intégrations avec des harness et des agents de codage externes.
Un outil interne pourrait transformer les optimisations spécifiques aux benchmarks en un produit utilisable par les développeurs ordinaires.
Il pourrait également révéler quelle part de l’amélioration des benchmarks de V4 Flash 0731 provient du checkpoint et quelle part provient de l’environnement d’exécution de l’agent.
Plusieurs évolutions détermineront si le moment V4 Flash devient un changement durable de l’écosystème.
DeepSeek indique que la sortie officielle de V4 Pro suivra la mise à jour Flash.
L’écart de performance et de prix entre Pro et Flash influencera les décisions de routage.
Une version publique améliorerait la reproductibilité des benchmarks et fournirait aux développeurs un framework agent natif au modèle.
Le prix direct est déjà bas, mais les promotions de tiers pourraient ne pas durer.
Une inférence bon marché attire un trafic très élevé.
La latence, les limites de débit et la fiabilité compteront à mesure que l’utilisation évolue.
vLLM, SGLang, les fournisseurs de matériel et les projets de quantification détermineront l’accessibilité de l’auto-hébergement.
Davantage d’évaluations publiques devraient tester :
DeepSeek V4 Flash 0731 est la version officielle du 31 juillet de V4 Flash, actuellement servie via l’API deepseek-v4-flash en version bêta publique. DeepSeek indique qu’elle conserve l’architecture et la taille de base du modèle Preview tout en améliorant considérablement les capacités d’agent grâce à un nouveau post-entraînement.
L’API officielle de DeepSeek liste 0,14 $ par million de jetons d’entrée avec échec de cache, 0,0028 $ par million de jetons d’entrée avec succès de cache, et 0,28 $ par million de jetons de sortie. Les plateformes tierces peuvent proposer des prix différents, des quotas gratuits ou des réductions temporaires.
L’article source cite un exemple communautaire avec ce coût de modèle signalé. L’exemple n’est pas accompagné de prompts complets, de journaux de jetons, de données de cache, de nouvelles tentatives, de coûts d’outils ou d’enregistrements de travail humain, il doit donc être considéré comme une anecdote plutôt qu’un budget garanti.
DeepSeek rapporte 82,7 sur Terminal Bench 2.1, 76,7 sur CyberGym, 54,4 sur DeepSWE, 70,3 sur Toolathlon-Verified et 54,2 sur NL2Repo. Les évaluations publiques d’agents de code ont utilisé le mode minimal non publié de DeepSeek Harness avec un effort de raisonnement maximal.
Les poids du modèle et le dépôt sont publiés sous licence MIT, donc « poids ouverts » et « utilisation largement permissive » sont des descriptions exactes. L’exécution complète du checkpoint nécessite toujours une infrastructure multi-GPU substantielle.
Oui, DeepSeek publie les poids et les instructions de service pour vLLM et SGLang. Les exemples officiels à grande échelle utilisent du matériel multi-GPU avancé, donc un ordinateur portable normal n’est pas l’environnement cible pour le modèle complet.
L’API officielle et la fiche du modèle spécifient une fenêtre de contexte de 1 million de jetons. L’API liste également une
longueur de sortie maximale de 384 000 jetons, mais l'utilisation du contexte ou de la sortie maximaux peut considérablement augmenter la latence et l'utilisation des ressources.
DeepSeek a publiquement mentionné un mode minimal du harnais et a recruté des développeurs open source de harnais pour des tests internes. Un dépôt public complet, une spécification finale du produit et une date de sortie confirmée n'ont pas été trouvés lors de la vérification.
reasoning_content lors des appels d'outils.DeepSeek V4 Flash 0731 conserve la base du modèle Preview.
Architecture et taille, mais utilise un nouveau post-entraînement pour produire une forte progression des performances des agents de codage. DeepSeek rapporte 82,7 sur Terminal Bench 2.1, 76,7 sur CyberGym et 54,4 sur DeepSWE, bien que les meilleurs résultats publics d'agents de codage dépendent d'une configuration DeepSeek Harness non publiée.
Le prix officiel de l'API est exceptionnellement bas : 0,14 $ par million de jetons d'entrée non mis en cache, 0,0028 $ par million de jetons d'entrée mis en cache et 0,28 $ par million de jetons de sortie. Les quotas gratuits et les réductions de tiers peuvent rendre l'accès encore moins cher, mais ces promotions sont temporaires et ne doivent pas être confondues avec le prix catalogue permanent.
La publication open-weight sous licence MIT, le contexte d'un million de jetons, les API compatibles Responses et Anthropic, ainsi que la prise en charge dans vLLM et SGLang rendent le modèle accessible via des voies hébergées et auto-gérées. Le déploiement local complet reste un projet d'infrastructure multi-GPU sérieux.
Les prototypes viraux à sept et cinquante cents sont des exemples plausibles de la faiblesse possible de la facture marginale du modèle, mais ils ne constituent pas des études complètes de coût produit. Les boucles d'agents, la longueur de sortie, les échecs de cache, les outils, les tests et le travail humain comptent toujours.
DeepSeek V4 Flash 0731 est important non pas parce que chaque application coûte désormais quelques centimes, mais parce que le codage agentique performant est devenu suffisamment abordable pour que beaucoup plus de développeurs puissent expérimenter à une échelle significative.
Partez d’une phrase et obtenez un site complet en quelques minutes.



