For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/flux-3-image-klein-specs-gpu-memory-api-a-c62c858a.md.
Black Forest Labs a publié **FLUX 3 Image Klein** le 15 octobre en tant que modèle à poids ouverts destiné à générer et modifier des images....
Black Forest Labs a publié FLUX 3 Image Klein le 15 octobre en tant que modèle à poids ouverts destiné à générer et modifier des images. Un seul modèle gère les requêtes de génération texte-vers-image, les modifications à partir d’une référence et les compositions à partir de plusieurs références.
Son générateur d’images compte 5,6 milliards de paramètres. Ce chiffre exclut l’encodeur de texte distinct, un détail important pour comparer la taille des modèles ou planifier le matériel local. BFL propose à la fois un checkpoint de base pour l’adaptation et un checkpoint distillé pour une génération plus rapide, ainsi qu’un accès par API.
Cette publication associe un générateur plus petit à la prise en charge de jusqu’à dix images de référence, à la génération 4K native et au guidage par boîtes englobantes. Les décisions de déploiement dépendent toutefois du checkpoint, de la précision, de l’implémentation d’inférence et des conditions de licence.
Le modèle accepte un prompt et jusqu’à dix images de référence, puis renvoie une image. Les références peuvent aider à ancrer un sujet ou à combiner des éléments provenant de plusieurs sources, tandis que la légende écrite contrôle la scène et la composition souhaitées.
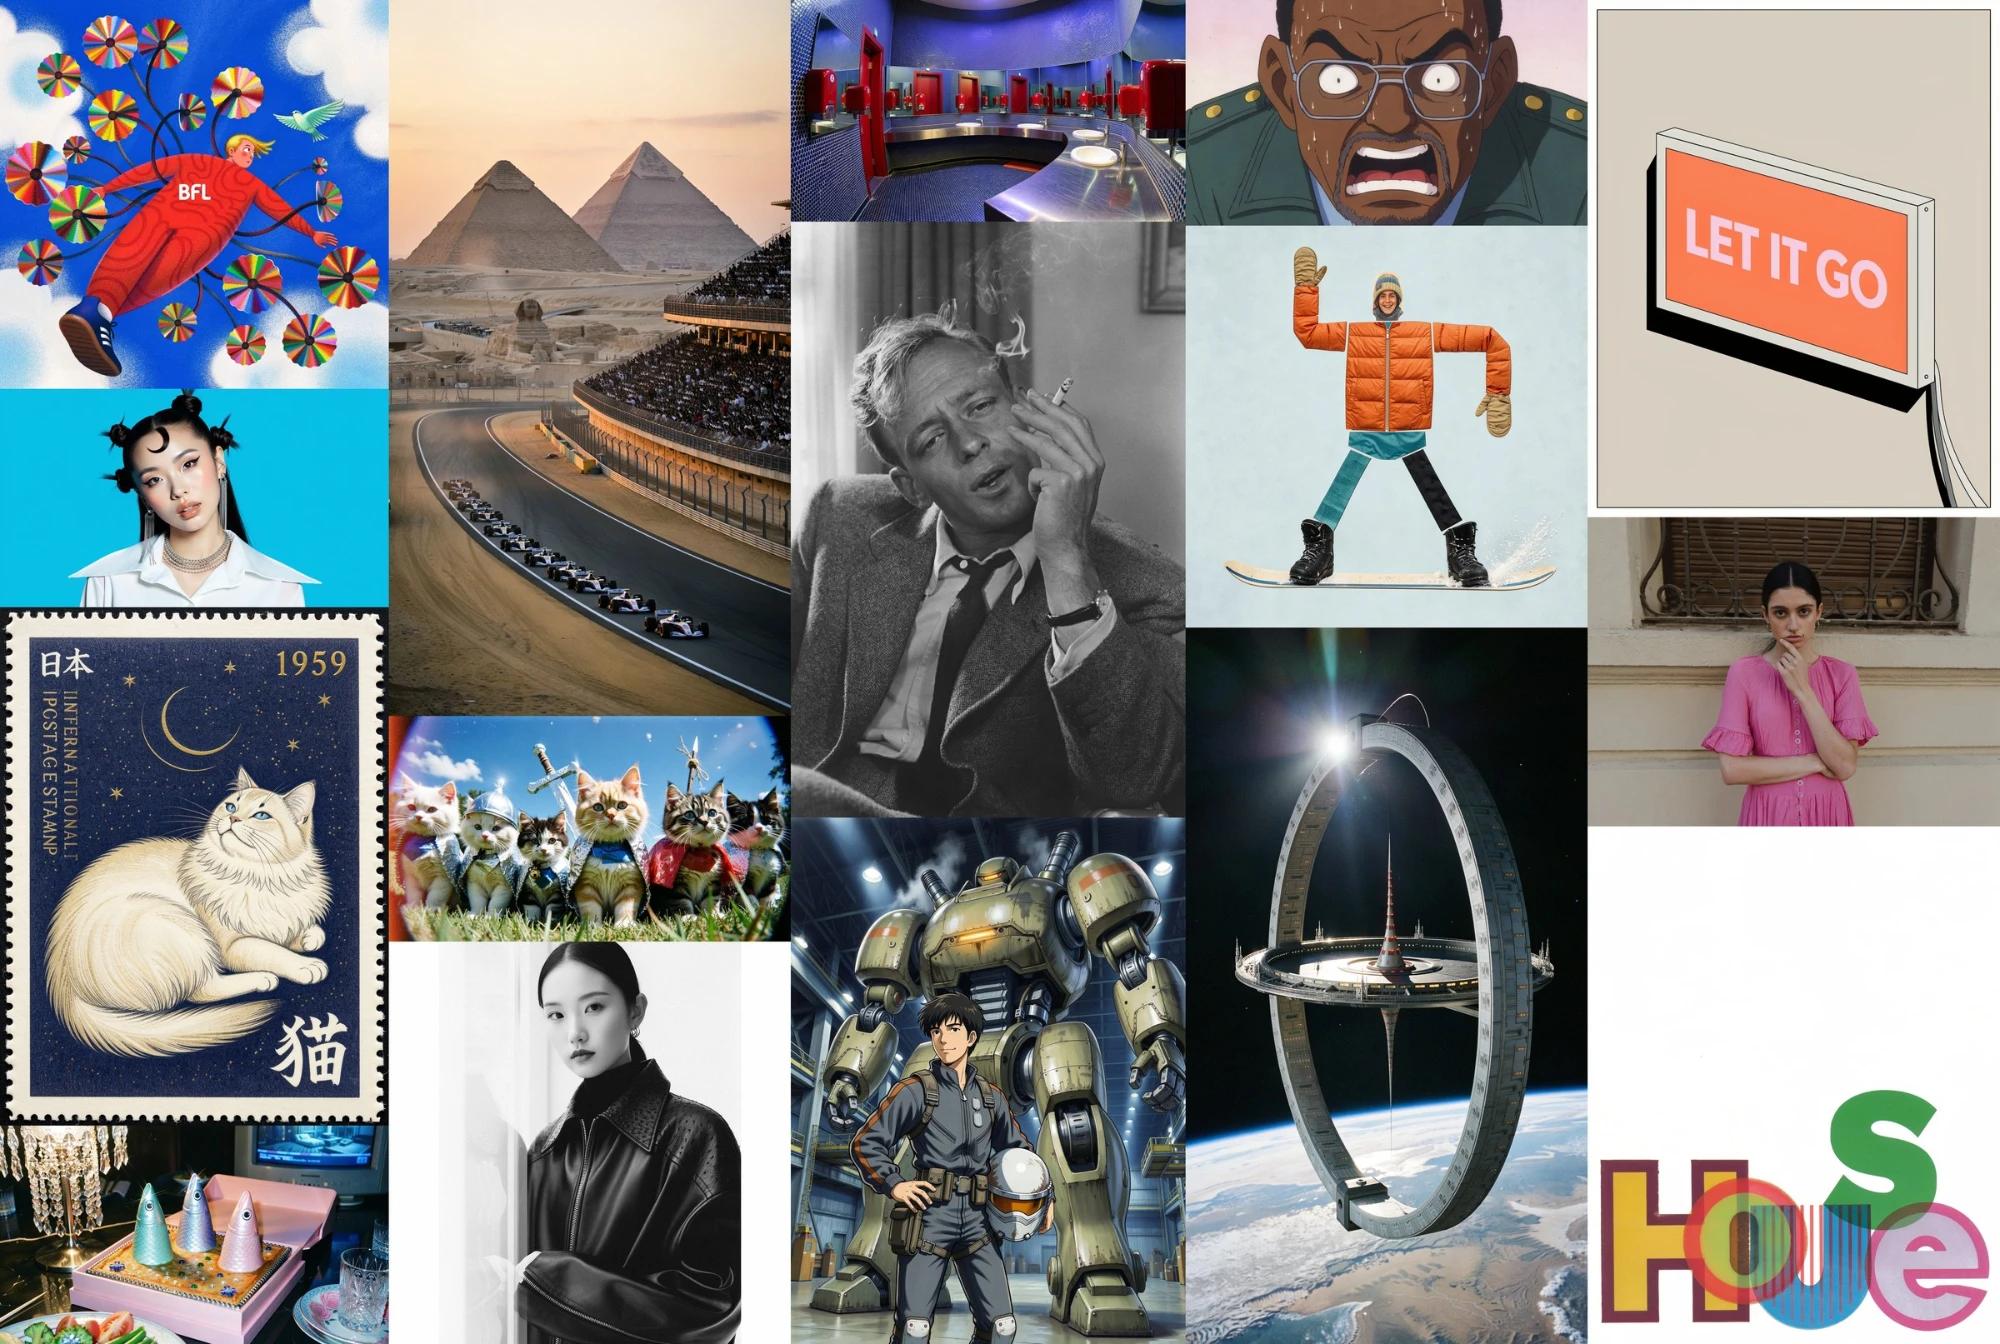
Source : Black Forest Labs. Il s’agit d’une sélection de résultats générés par l’éditeur, et non d’une évaluation indépendante de la qualité.
BFL indique que le modèle s’appuie sur des enseignements partagés issus des recherches de la famille FLUX 3 sur l’image, la vidéo et l’audio. Pour Image Klein lui-même, l’interface publiée concerne la génération et l’édition d’images ; ce contexte de recherche ne signifie pas que le checkpoint génère de l’audio ou de la vidéo.
Les boîtes englobantes guident le placement et l’échelle des éléments. La fiche modèle officielle définit une grille de coordonnées allant de 0 à 1000 et ordonne chaque boîte comme suit : haut, gauche, bas, droite. Elle avertit également que les boîtes ne sont pas des masques de pixels stricts : des éléments peuvent les dépasser, de petits éléments peuvent disparaître et les modifications peuvent toucher des zones hors de la région demandée.
L’API hébergée de BFL ajoute la restauration de pixels, conçue pour préserver exactement les régions non modifiées. Cette fonctionnalité de service ne doit pas être considérée comme une propriété inconditionnelle de l’inférence à partir du checkpoint brut.
Les deux principaux checkpoints répondent à des usages différents :
| Checkpoint | Réglage de pas publié | Réglage de guidage | Usage prévu |
|---|---|---|---|
| Klein Base | 50 | 3,5 | Affinage, entraînement LoRA et recherche |
| Klein | 16 | Aucun | Génération, édition et inférence auto-hébergée |
Source : fiche modèle officielle de BFL. Le checkpoint distillé est également le modèle utilisé par l’API hébergée Image Klein.
Le modèle utilise Qwen3-VL-4B-Instruct comme encodeur de texte distinct. Le package Hugging Face comprend le transformeur d’images, l’encodeur de texte et l’autoencodeur d’images ; les variantes BF16, FP8 et NVFP4 y sont décrites, tandis que l’annonce de lancement identifie également des versions INT8 prises en charge par NVIDIA.
Pour l’adaptation, BFL oriente les développeurs vers le modèle de base. Le lancement mentionne la prise en charge par Diffusers, AI Toolkit d’Ostris et NVIDIA NeMo AutoModel pour LoRA et d’autres workflows d’entraînement.
BFL indique qu’Image Klein arrive en tête de ses comparaisons internes de génération texte-vers-image, d’édition et de références multiples face aux alternatives sélectionnées. Son article de lancement souligne des gains de 91 Elo en texte-vers-image et de 70 Elo en édition par rapport à FLUX.2 [klein] 9B, tout en utilisant 38 % de paramètres de générateur en moins.
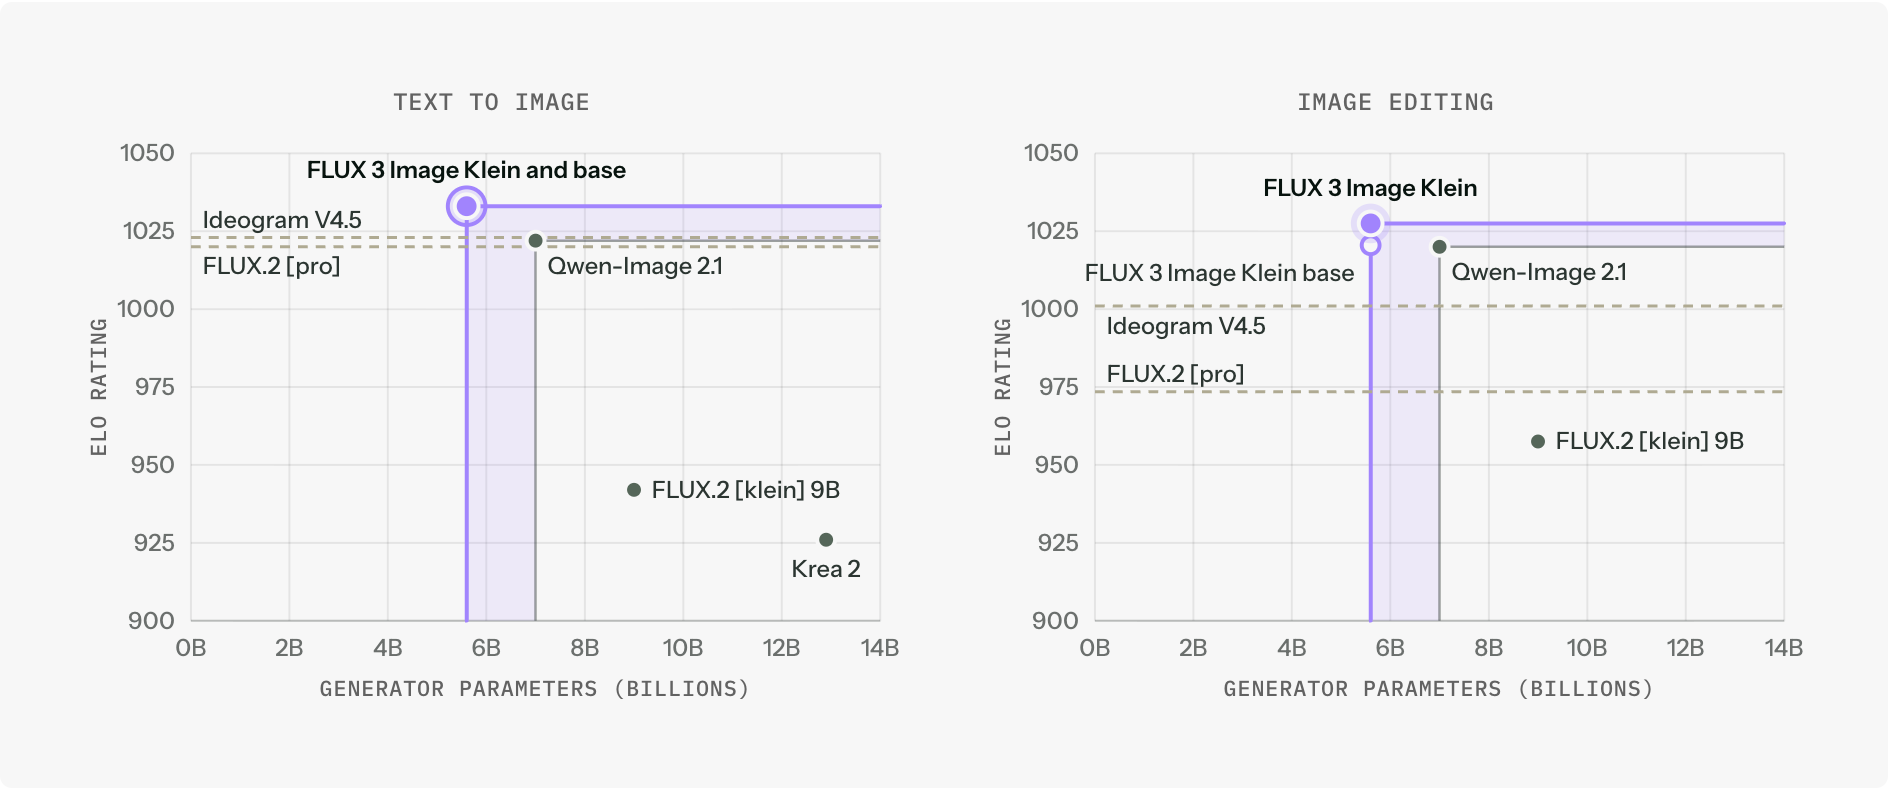
Source : Black Forest Labs. Les nombres de paramètres du générateur excluent les encodeurs de texte ; Krea 2 est absent de la comparaison d’édition car il ne prend pas en charge cette tâche.
Ces évaluations décrivent le jeu de comparaison et la procédure d’évaluation de BFL. Elles ne démontrent pas que le modèle produira le meilleur résultat pour chaque prompt, style, langue ou contrainte d’édition. Pour un workflow de production, testez les types de références et de modifications réellement rencontrés dans ce workflow.
L’annonce de lancement indique des besoins en poids de générateur de 11,2 Go en BF16 et 5,6 Go en FP8. Il s’agit de tailles de poids, et non de budgets complets de mémoire GPU.
BFL affirme qu’une version INT8 optimisée peut fonctionner sur des GPU GeForce RTX avec seulement 8 Go de VRAM via des configurations ComfyUI ou Diffusers prises en charge. Cette affirmation dépend de la version et de l’implémentation ; elle ne signifie pas que le pipeline de référence non modifié tient dans 8 Go.
La fiche modèle rapporte les pics de mémoire suivants pour le code de référence sur un B200 à 1024 par 1024 pixels, avec l’outil d’enrichissement de prompts désactivé :
| Précision | Pic de mémoire GPU rapporté |
|---|---|
| BF16 | 31 Go |
| FP8 | 26 Go |
| NVFP4 | 25 Go |
La même fiche indique que l’outil d’enrichissement de prompts ajoute environ 28 Go sur un GPU de 80 Go. L’encodage de texte, les activations intermédiaires, la résolution et le traitement des références expliquent notamment pourquoi la mémoire totale est supérieure aux seuls poids stockés du générateur.
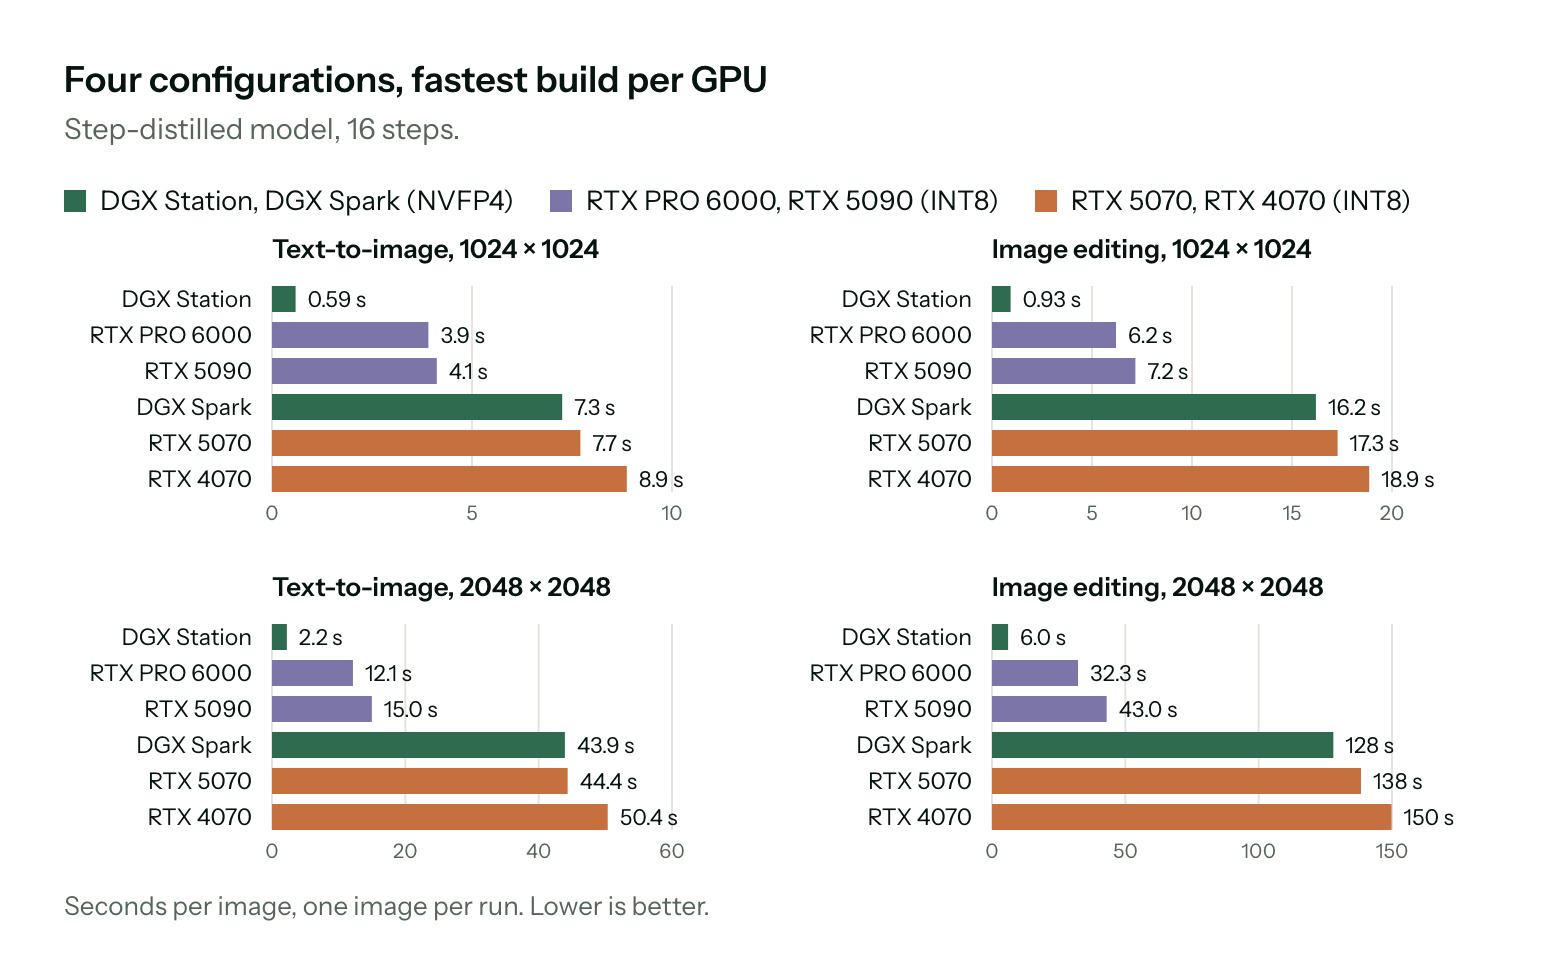
Source : BFL, mesures réalisées par NVIDIA. Le graphique utilise une image par exécution et la version répertoriée la plus rapide pour chaque GPU ; les mesures RTX utilisent ComfyUI. Il s’agit de temps de génération, et non de temps de réponse API complets.
Pour le checkpoint distillé à 16 pas, le graphique indique 4,1 secondes pour un résultat texte-vers-image de 1024 par 1024 sur une RTX 5090 et 8,9 secondes sur une RTX 4070. L’édition prend davantage de temps dans ces mesures, et les configurations plus grandes de 2048 par 2048 sont considérablement plus lentes.
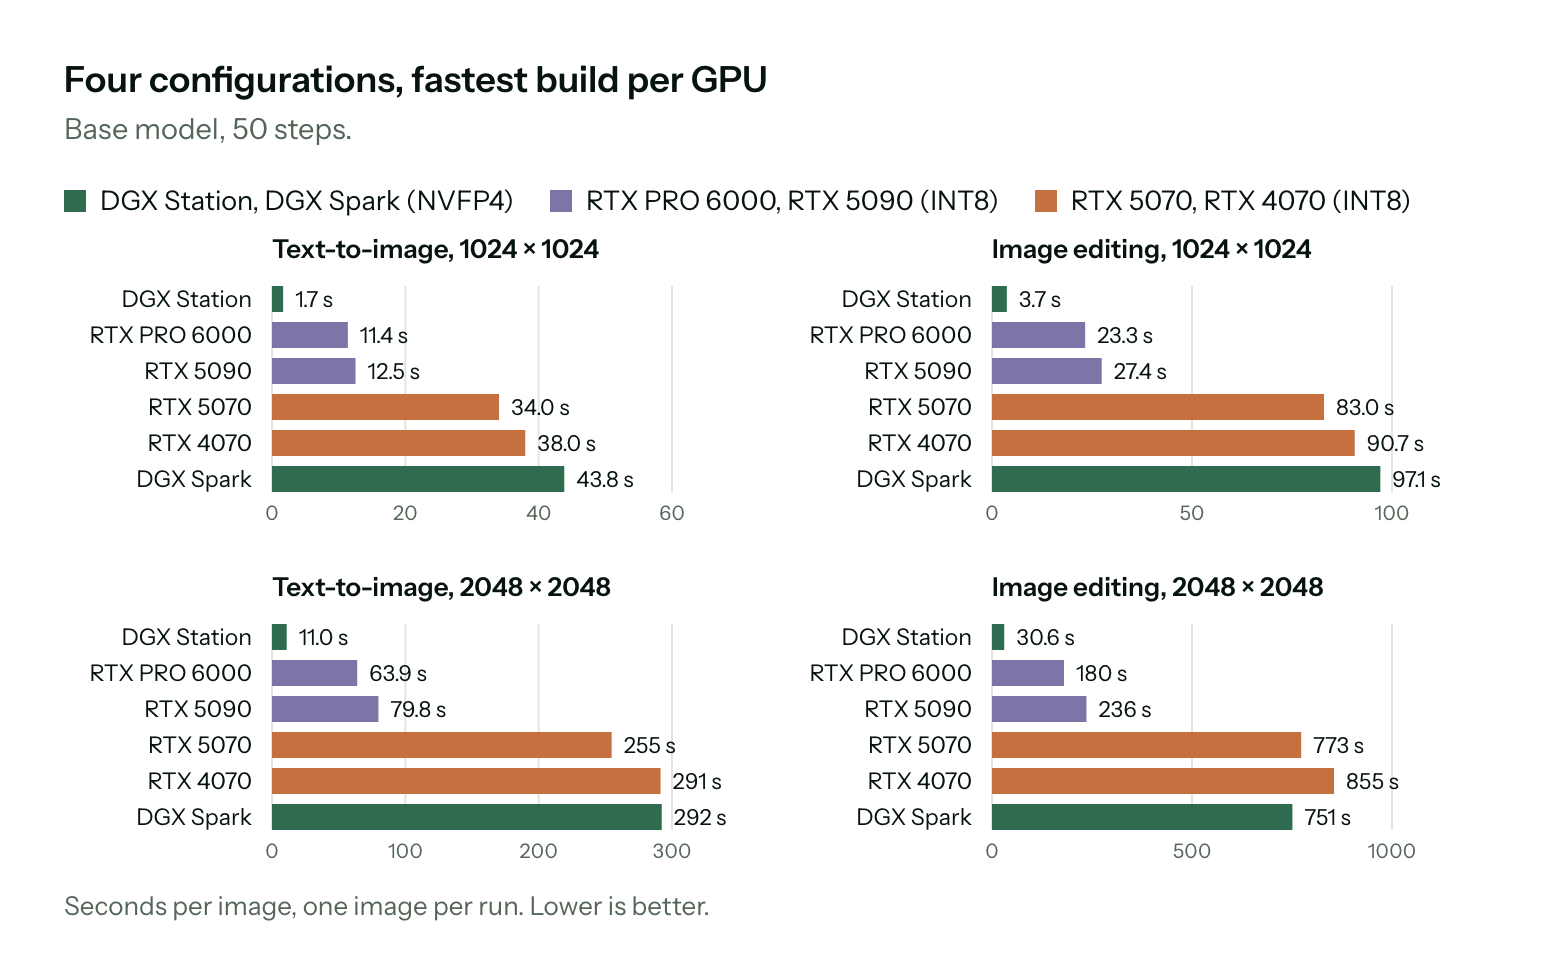
Source : BFL, mesures réalisées par NVIDIA. Ce graphique utilise le checkpoint de base à 50 pas et la version la plus rapide présentée pour chaque GPU.
Le modèle de base à 50 pas présente un profil de vitesse différent. Il est utile de séparer ses résultats de ceux du modèle distillé, en particulier pour estimer le temps d’itération consacré à l’entraînement ou à l’édition d’images de référence.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
L’API BFL expose le modèle distillé sous le nom flux-3-image-klein. L’annonce de lancement indique que les prix commencent à 0,009 $ par image de 1K et incluent l’enrichissement de prompts ainsi que la restauration de pixels dans l’offre hébergée. Consultez la documentation API actuelle et les tarifs de votre compte avant d’estimer une facture de production.
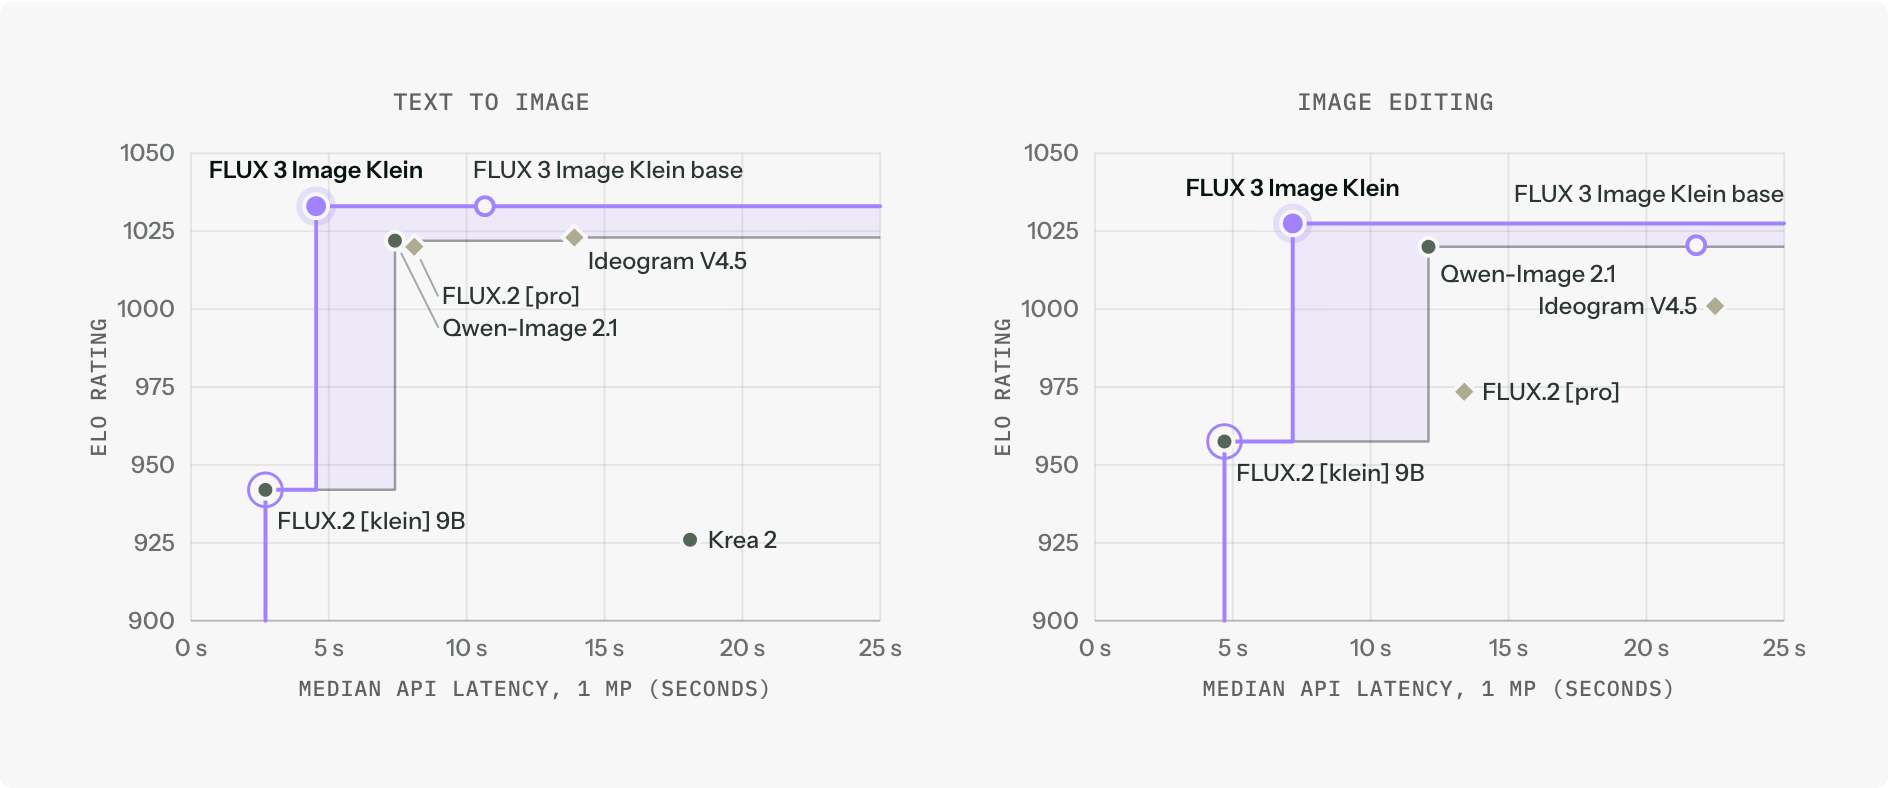
Source : Black Forest Labs. La comparaison publiée utilise des images finales de 1 MP et inclut le temps d’attente ; BFL a mesuré son propre modèle sur ses serveurs, tandis que les mesures des concurrents ont été réalisées côté client et incluaient l’interrogation et le temps réseau.
Ces différences de mesure sont importantes pour interpréter le classement de vitesse. Le temps de génération locale, la durée côté serveur et la latence API observée par le client répondent à des questions liées, mais différentes. Une application doit mesurer le délai entre l’envoi de sa propre requête et l’obtention d’un résultat exploitable.
La fiche modèle officielle insiste sur l’utilisation de descriptions complètes de scène. De courtes instructions envoyées directement au modèle d’image peuvent produire des résultats génériques ou recadrer involontairement une modification.
Une séquence d’évaluation pratique est la suivante :
L’interface en ligne de commande de référence charge l’outil d’enrichissement de prompts de BFL par défaut. Diffusers ne l’appelle pas automatiquement ; cette étape doit donc être gérée séparément avec le pipeline modulaire documenté.
L’annonce de publication contient un bloc de citation, reproduit ici pour l’attribution :
@misc{bfl2026flux3imageklein,
  author       = {{Black Forest Labs}},
  title        = {{FLUX} 3 Image Klein},
  year         = {2026},
  url          = {https://bfl.ai/blog/flux-3-image-klein},
}
Image Klein utilise la FLUX Kommunity License v1.0. La fiche modèle décrit une utilisation non commerciale et une exception de génération de résultats commerciaux pour les utilisateurs éligibles réalisant moins de 5 millions de dollars américains de revenus annualisés bruts, y compris les sociétés affiliées, sous réserve de l’accord.
Cette exception ne constitue pas une autorisation générale pour tous les accords commerciaux d’entraînement, de redistribution ou de services. Les grandes organisations et les autres usages doivent consulter les conditions de licence commerciale de BFL ou utiliser l’API hébergée selon les conditions applicables. L’encodeur de texte Qwen distinct utilise la licence Apache-2.0.
BFL indique avoir appliqué un filtrage des données d’entraînement, des mesures d’atténuation après entraînement, des exercices internes de red teaming et une évaluation par Cinder. Ces mesures ne suppriment pas les limites énoncées dans la fiche modèle : le texte généré peut être inexact, le suivi des prompts peut échouer, des biais peuvent apparaître et l’édition peut modifier des régions non voulues.
Il s’agit du modèle d’image à poids ouverts de BFL destiné à la génération texte-vers-image, à l’édition d’images et aux compositions à références multiples. Le chiffre de 5,6 milliards de paramètres décrit le transformeur d’images et exclut son encodeur de texte distinct.
BFL indique que des configurations INT8 optimisées prises en charge peuvent fonctionner sur des GPU disposant d’aussi peu que 8 Go de VRAM. Son implémentation de référence présente des pics de mémoire documentés bien plus élevés ; l’adéquation du matériel dépend donc de la configuration complète de l’environnement d’exécution.
Klein Base est le checkpoint non distillé destiné à l’affinage, à LoRA et à la recherche, avec une configuration publiée de 50 pas. Klein est distillé pour la génération et l’édition, avec une configuration publiée de 16 pas et sans guidage.
Non. La fiche modèle officielle indique que les boîtes guident le placement et l’échelle plutôt que d’imposer un masque strict. La fonctionnalité de restauration de pixels de l’API hébergée constitue une partie distincte du workflow de service.
La licence comprend une exception de résultats commerciaux pour les utilisateurs éligibles sous le seuil de 5 millions de dollars américains de revenus annualisés bruts, sous réserve de l’ensemble des conditions. L’affinage commercial, la distribution et les autres accords exigent de vérifier l’accord complet plutôt que de se fonder uniquement sur le seuil de revenus.
Le pipeline Diffusers documenté n’exécute pas lui-même l’outil d’enrichissement de prompts. BFL recommande d’exécuter d’abord son outil ou un autre modèle de langage adapté, puis de transmettre la description complète obtenue au pipeline d’image.
FLUX 3 Image Klein réunit la génération texte-vers-image, l’édition basée sur des références et le guidage de mise en page dans un générateur d’images à poids ouverts plus compact. Les checkpoints de base et distillé offrent aux développeurs des voies distinctes pour l’adaptation et l’inférence plus rapide.
Les principaux détails de déploiement vont au-delà du nombre de paramètres : utilisation complète de la mémoire, enrichissement des prompts, comportement d’édition et portée de la licence. Choisissez et évaluez le pipeline complet, plutôt que de considérer une taille de poids ou une référence de lancement comme une spécification de déploiement complète.
Partez d’une phrase et obtenez un site complet en quelques minutes.
