For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/gemini-4-argon-arc-agi-3-97-5-score-cost-f02ba71b.md.
ARC Prize a annoncé un **score vérifié de 97,5 % pour Gemini 4 Argon sur ARC-AGI-3**, faisant de Google DeepMind le deuxième laboratoire de ...
ARC Prize a annoncé un score vérifié de 97,5 % pour Gemini 4 Argon sur ARC-AGI-3, faisant de Google DeepMind le deuxième laboratoire de pointe à dépasser 95 % sur ce benchmark, selon l’organisateur.
Le résultat s’accompagne d’une comparaison tout aussi importante : la même famille de modèles a obtenu 49,8 % avec le harnais Standard, contre 97,5 % avec un Provider Adapter. Les coûts d’évaluation annoncés s’élevaient respectivement à environ 5 800 $ et 4 800 $.
Il s’agit de résultats obtenus avec des systèmes configurés. Pour tirer des conclusions à partir du chiffre mis en avant, il faut comprendre le benchmark, le niveau de raisonnement, le harnais et les évaluations incomplètes.
L’annonce d’ARC Prize donne les chiffres suivants :
| Benchmark et configuration | Score annoncé | Coût d’évaluation annoncé |
|---|---|---|
| ARC-AGI-1, meilleure configuration annoncée | 98,5 % | Environ 0,16 $ par tâche |
| ARC-AGI-2, meilleure configuration annoncée | 91,3 % | Environ 0,32 $ par tâche |
| ARC-AGI-3, Provider Adapter, raisonnement faible | 97,5 % | Environ 4 800 $ pour l’évaluation |
| ARC-AGI-3, Standard, raisonnement faible | 49,8 % | Environ 5 800 $ pour l’évaluation |
Les unités de coût diffèrent. Les montants indiqués pour ARC-AGI-1 et ARC-AGI-2 sont calculés par tâche ; ceux d’ARC-AGI-3 correspondent à une évaluation complète. Il ne faut pas les comparer sur une même échelle de coûts sans tenir compte de cette différence.
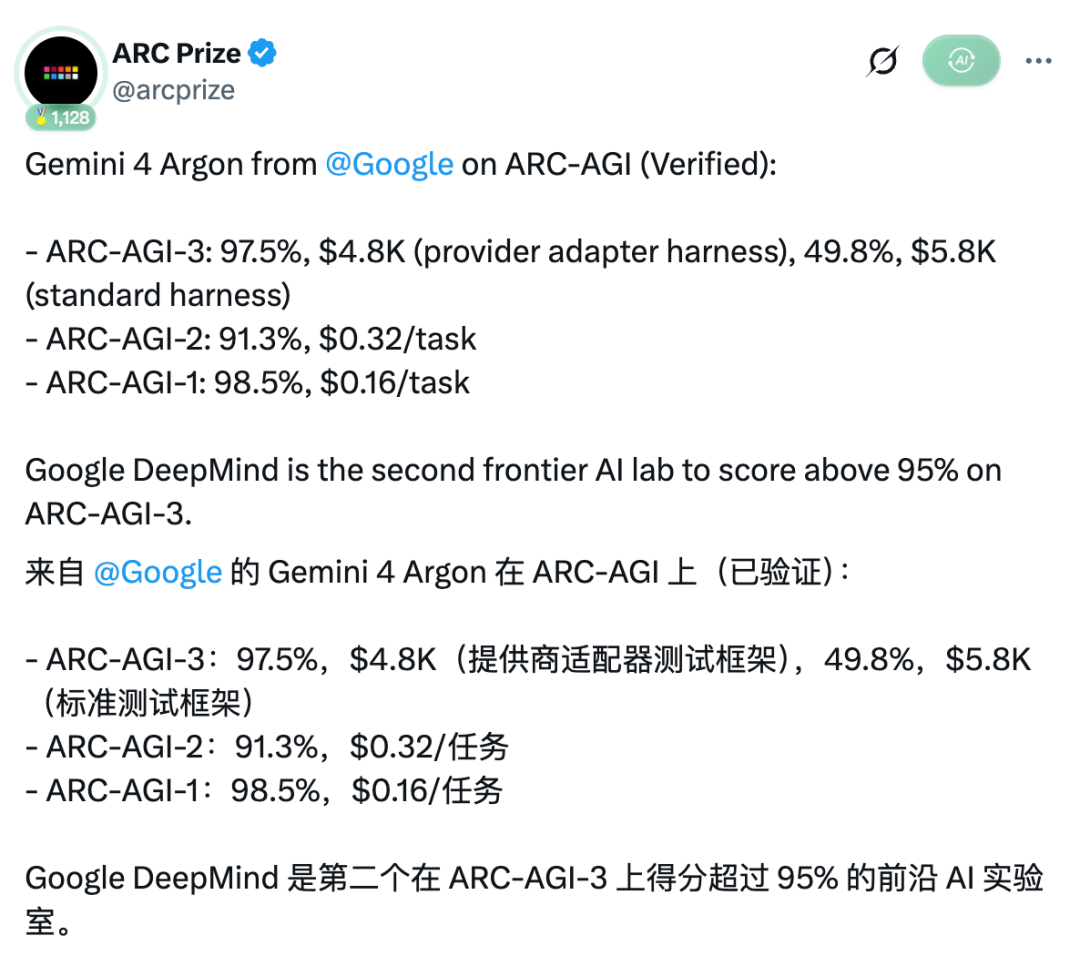
Annonce des scores vérifiés d’ARC Prize, telle que reproduite dans le rapport source.
Le tableau en ligne indique des coûts plus précis pour les meilleures configurations : 0,162 $ par tâche pour ARC-AGI-1 et 0,325 $ pour ARC-AGI-2. Il affiche 91,3 % pour ARC-AGI-2, comme dans l’annonce, bien que le paragraphe accompagnant la page de résultats indique 91,2 %. Cet article reprend la valeur annoncée et celle du tableau, tout en signalant l’écart.
ARC-AGI-3 diffère des deux premières générations. Au lieu de déduire une grille de sortie à partir d’exemples statiques, un agent explore des environnements interactifs inconnus, découvre le fonctionnement des actions et apprend à atteindre des objectifs sans instructions en langage naturel expliquant le jeu.
ARC Prize décrit le test comme une mesure de l’efficacité de l’acquisition de compétences, de l’adaptation et de la planification dans le temps. Son score ne correspond donc pas simplement au « pourcentage de jeux gagnés ». Selon l’explication du benchmark, un score de 100 % suppose de terminer les jeux aussi efficacement que la référence humaine.
La source retrace l’évolution des scores des modèles de pointe, inférieurs à 1 % au lancement d’ARC-AGI-3 en mars, jusqu’à des résultats proches du plafond plus tard dans l’année. Elle met en avant le résultat antérieur de GPT-6 Astra d’OpenAI, suivi de l’arrivée de Gemini au-dessus de 95 %.
Il s’agit d’une progression considérable sur cette évaluation. Cela ne signifie pas que l’organisateur a testé toutes les formes de raisonnement possibles ni établi que l’un ou l’autre de ces systèmes peut apprendre n’importe quelle nouvelle tâche comme le ferait une personne.
Le rapport fait également état d’une grande efficacité dans l’exécution des actions sur 25 jeux publics : 62 % d’actions en moins que la référence humaine, trois jeux avec des records de vitesse égaux ou supérieurs aux records de speedrun, et six autres à moins de 10 % de ces records. Ces comparaisons particulières sont des observations rapportées sur l’ensemble public ; elles ne doivent pas être généralisées aux 55 tâches de l’évaluation ni à des jeux arbitraires.
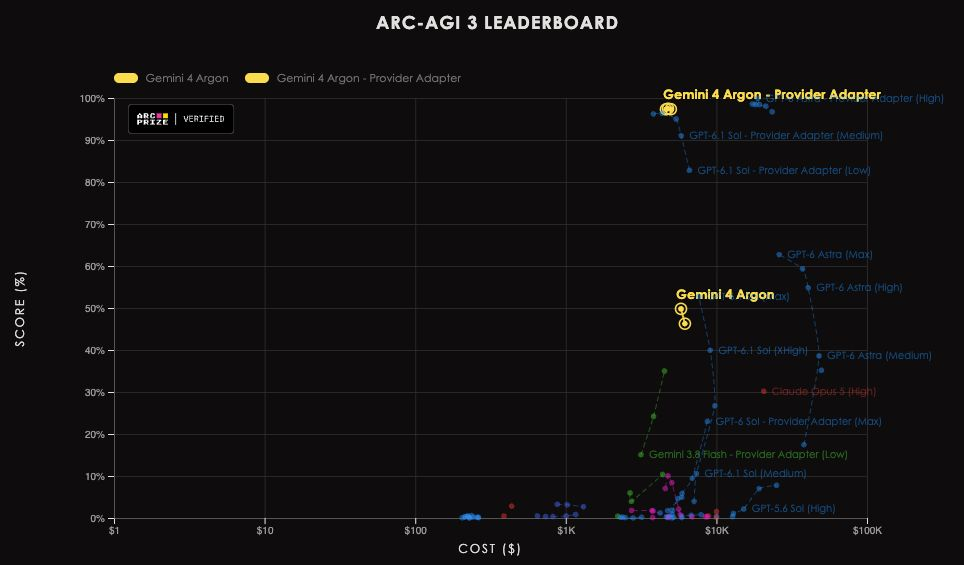
Capture d’écran du classement conservée dans le rapport ; la page de résultats en ligne fournit les détails actuels sur les configurations.
Un harnais d’agent contrôle les interactions autour d’un modèle : la façon dont les observations lui sont transmises, la manière dont les actions sont envoyées, le contexte conservé et ce qui se passe lorsque la conversation s’allonge.
ARC Prize définit séparément ses deux conditions :
Pour Gemini 4 Argon, les résultats en ligne indiquent :
| Niveau de raisonnement | Harnais Standard | Harnais Provider Adapter |
|---|---|---|
| Faible | 49,8 % | 97,5 % |
| Moyen | 46,3 % | 97,3 % |
| Élevé | Aucun point de comparaison complet annoncé | 97,3 % |
L’écart au niveau de raisonnement faible est de 47,7 points de pourcentage. Il montre que le système d’interaction configuré influence sensiblement le résultat mesuré, mais ne permet pas d’isoler un mécanisme causal unique. La gestion du contexte, les conditions d’exécution, la fiabilité de l’API et d’autres paramètres doivent être pris en compte en plus de la désignation du harnais.
ARC Prize signale notamment des problèmes d’API qui ont empêché de terminer les évaluations Standard. Les évaluations avec les niveaux faible, moyen et élevé ont été menées à terme pour 42, 46 et 19 tâches sur 55, respectivement. Les scores agrégés annoncés incluent les 55 tâches et conservent les crédits partiels des évaluations incomplètes ; ces nombres de tâches terminées ne signifient pas que 42 ou 46 jeux ont nécessairement été entièrement résolus.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Le point Standard au niveau de raisonnement élevé, incomplet, a été exclu du graphique. Dans cette évaluation, l’effort de raisonnement plus élevé n’a donc pas produit de série de résultats Standard comparables et menés à terme.
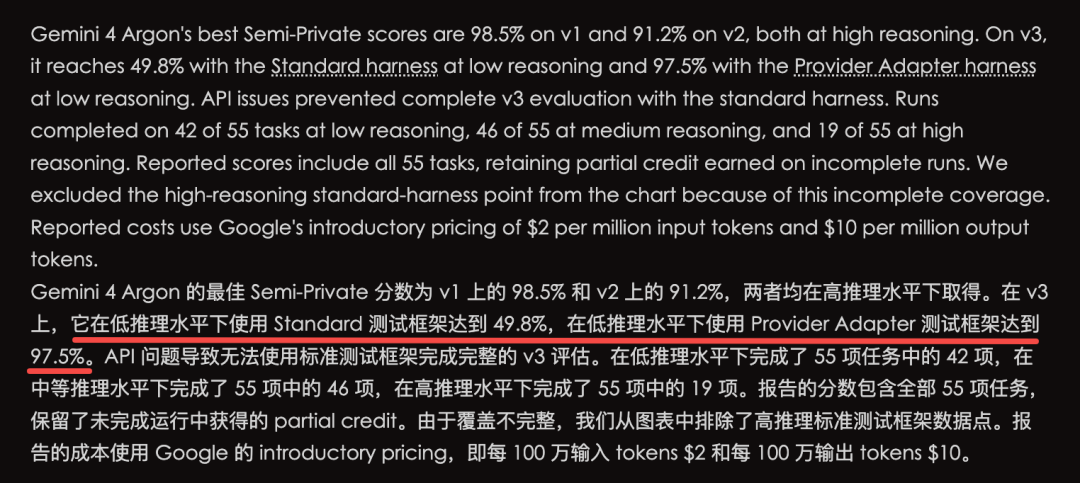
Note sur la configuration et la couverture reproduite dans le rapport source ; consultez la page de résultats en ligne pour les mises à jour.
Selon ARC Prize, les estimations de coût reposent sur les tarifs de lancement de l’API Google : 2 $ par million de jetons en entrée et 10 $ par million de jetons en sortie. Elles ne correspondent pas à un prix fixe pour résoudre une nouvelle tâche du monde réel et peuvent évoluer en fonction des tarifs ou de la configuration.
La principale leçon pratique de la source est pertinente : le nom d’un modèle et un pourcentage unique ne rendent pas compte de l’ensemble du système évalué. Deux scores associés au même nom de modèle peuvent répondre à des questions différentes si leurs interfaces de gestion du contexte diffèrent.
La politique d’ARC Prize précise qu’elle présente séparément les deux harnais, car ils répondent à des questions d’évaluation différentes. Ses résultats vérifiés proviennent d’évaluations réalisées par l’organisateur selon une méthodologie publiée. Ils constituent des éléments de preuve plus solides qu’une diapositive de fournisseur non étayée, tout en restant limités à la distribution de tâches et aux conditions testées.
Pour comparer ces résultats, il est utile de vérifier, dans l’ordre, la version du benchmark, la configuration exacte du modèle, le niveau de raisonnement, le harnais, la couverture des tâches, les règles de notation et l’unité de coût. Cela permet de distinguer plus facilement une véritable amélioration d’une comparaison entre expériences différentes.
Des performances proches du plafond soulèvent également une question de recherche : quelle marge de progression reste-t-il dans un test ? Cela ne fait pas disparaître les limites restantes et ne transforme pas l’expression « benchmark AGI » en preuve d’intelligence générale.
ARC Prize annonce 97,5 % avec le harnais Provider Adapter et un niveau de raisonnement faible. Le résultat Standard au niveau de raisonnement faible est de 49,8 %, dans une condition d’évaluation différente comportant des évaluations incomplètes.
Non. ARC-AGI-3 mesure les performances à l’aide d’un système de notation fondé sur l’efficacité et peut attribuer des crédits partiels. Il ne faut pas interpréter directement le score comme le nombre de jeux terminés.
Le harnais Standard est une interface minimale, neutre vis-à-vis du fournisseur, qui conserve les notes choisies par le modèle. Le Provider Adapter peut utiliser des fonctions de gestion du contexte propres au fournisseur, notamment la préservation de l’état de raisonnement et la condensation des conversations.
Les évaluations annoncées au niveau de raisonnement faible ont coûté environ 4 800 $ avec le Provider Adapter et 5 800 $ avec le harnais Standard. ARC Prize indique que ces estimations reposent sur les tarifs de lancement des jetons ; il s’agit de coûts totaux d’évaluation, et non de prix par tâche.
ARC Prize qualifie les résultats de vérifiés et publie sa politique de test ainsi que la page de résultats propre au modèle. Cet article a consulté ces documents, mais n’a pas relancé l’évaluation ni reproduit les scores de manière indépendante.
Non. Aucun benchmark unique ne permet d’établir cette conclusion. Le résultat démontre de solides performances sur ARC-AGI-3 avec la configuration système indiquée ; la fiabilité et la généralisation au-delà de ce cadre nécessitent des éléments supplémentaires.
Les résultats vérifiés de Gemini 4 Argon sur ARC-AGI montrent de solides performances sur des tests statiques et interactifs. Le score mis en avant de 97,5 % sur ARC-AGI-3 correspond à une configuration précise de Provider Adapter avec un niveau de raisonnement faible, pour un coût d’évaluation annoncé d’environ 4 800 $.
Le résultat obtenu avec le harnais Standard, les évaluations incomplètes et les différences de gestion du contexte sont indispensables pour interpréter la comparaison. Il faut lire ensemble le modèle, le harnais et les conditions d’évaluation : le pourcentage seul ne prouve pas l’existence d’une AGI.
Partez d’une phrase et obtenez un site complet en quelques minutes.



