For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/gemini-4-argon-launch-access-api-pricing-cf4e0dbb.md.
L’[annonce de Gemini 4 Argon par Google](https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-argon/...
L’annonce de Gemini 4 Argon par Google présente un modèle destiné à des travaux difficiles et étendus : modifications importantes de code, création visuelle, raisonnement scientifique et tâches qui se poursuivent au-delà d’un court échange. Le lancement couvre à la fois des produits pour développeurs et des expériences grand public, bien que les conditions d’accès diffèrent entre ces deux contextes.
L’essentiel se trouve dans ces détails. La tarification API de lancement a une date de fin, la limite d’un million de jetons est partagée entre plusieurs types de contenu, et une accélération logicielle mise en avant s’applique à une partie précise d’une charge de travail. La lecture de la documentation sous-jacente facilite considérablement l’évaluation de cette annonce.
Google décrit un accès API payant via AI Studio et la plateforme Gemini, la disponibilité pour les développeurs s’étendant également à Android Studio. Les abonnés Google AI Ultra accèdent au modèle via Antigravity et AI Studio, tandis que le déploiement de l’application grand public Gemini et du mode IA de Search inclut les abonnés Google AI Pro et Ultra.
Il s’agit de produits distincts, avec des droits d’accès distincts. L’accès Google AI Pro à une expérience grand public n’implique pas automatiquement que le même forfait inclut l’accès développeur à Argon dans AI Studio ou un quota API gratuit.
Pour une intégration, vérifiez les exigences actuelles d’accès pour les développeurs au lieu de vous appuyer sur un titre général de lancement. La page de tarification d’AI Studio identifie le modèle API comme gemini-4-argon et n’indique aucun niveau gratuit pour celui-ci.
Au 15 octobre, la documentation de tarification API standard de Google indique deux périodes pour Gemini 4 Argon. Les prix ci-dessous sont exprimés en dollars américains par million de jetons.
| Catégorie de jetons | Jusqu’au 30 novembre 2026 | À partir du 1er décembre 2026 |
|---|---|---|
| Entrée | 2,00 $ | 4,00 $ |
| Sortie, raisonnement inclus | 10,00 $ | 20,00 $ |
| Entrée mise en cache implicitement | 0,10 $ | 0,20 $ |
Les tarifs d’entrée et de sortie de lancement présentés dans l’annonce sont donc limités dans le temps, et non des prix permanents. La tarification des entrées mises en cache représente une réduction de 95 % par rapport au tarif d’entrée correspondant, mais elle s’applique aux entrées éligibles mises en cache implicitement ; la page n’indique pas que la mise en cache explicite est prise en charge pour ce modèle.
Les prix par jeton ne décrivent pas nécessairement le coût total d’une application. Des outils facturés séparément et les requêtes répétées d’un workflow peuvent augmenter les coûts ; une estimation de production doit donc refléter le modèle réel de requêtes et la documentation actuelle.
La documentation sur le décodage long de Google décrit une limite unifiée de 1 048 576 jetons partagée entre l’entrée, le raisonnement et la sortie. Elle ne promet pas un million de jetons d’entrée plus un autre million de jetons de sortie générée.
L’API Interactions limite normalement la sortie synchrone ou diffusée en continu à 65 536 jetons. Générer au-delà nécessite le mode arrière-plan, un paramètre max_output_tokens plus élevé et le stockage activé, comme indiqué dans la documentation. Le serveur effectue la génération plus longue par étapes de continuation.
Deux détails sont importants lors de la planification d’une telle tâche. Premièrement, max_output_tokens comprend le raisonnement ainsi que la sortie renvoyée. Deuxièmement, les étapes de continuation peuvent comptabiliser de nouveau les entrées, avec la remise de mise en cache implicite documentée lorsqu’elle est applicable ; le décodage long n’est pas une extension illimitée et gratuite d’une requête.
Cette capacité peut aider à réaliser une implémentation longue ou une analyse approfondie, mais une grande allocation de sortie ne garantit pas l’exactitude. Le résultat doit toujours être vérifié, et l’entrée consomme une partie du même budget total.
Google indique avoir utilisé Argon pour une refactorisation portant sur des centaines de fichiers dans Chrome, dont la base de code compterait environ 40 millions de lignes, y compris une zone historique d’environ six millions de lignes. L’entreprise affirme que le travail est passé d’une tâche à l’échelle de plusieurs mois à une tâche à l’échelle de plusieurs semaines. Il s’agit de résultats de projet rapportés par Google, et non d’une promesse générale concernant des modifications de dépôts arbitraires.
L’article d’ingénierie ADK fournit un cas plus facilement vérifiable. Il porte sur un dépôt Python d’environ 205 000 lignes réparties sur près de 800 fichiers source, soutenu par une vaste suite de tests publics.
Le travail s’est déroulé en deux phases. Une première tentative de deux heures a révélé des lacunes ; une exécution ultérieure durant la nuit a utilisé des compétences de projet et un objectif Antigravity. Le modèle a proposé six optimisations dans 32 fichiers, mais les mainteneurs n’en ont conservé que deux et en ont rejeté quatre. Le travail final fusionné a combiné les modifications des deux phases sur 22 fichiers et a ajouté 17 fonctions de test.
Les optimisations retenues concernaient le filtrage des données avant leur copie dans le service de session en mémoire et les importations paresseuses de paquets. Le commit public fusionné rend le code obtenu disponible pour inspection.
Le benchmark est utile parce qu’il distingue plusieurs mesures de temps au lieu de présenter une seule accélération comme universelle.
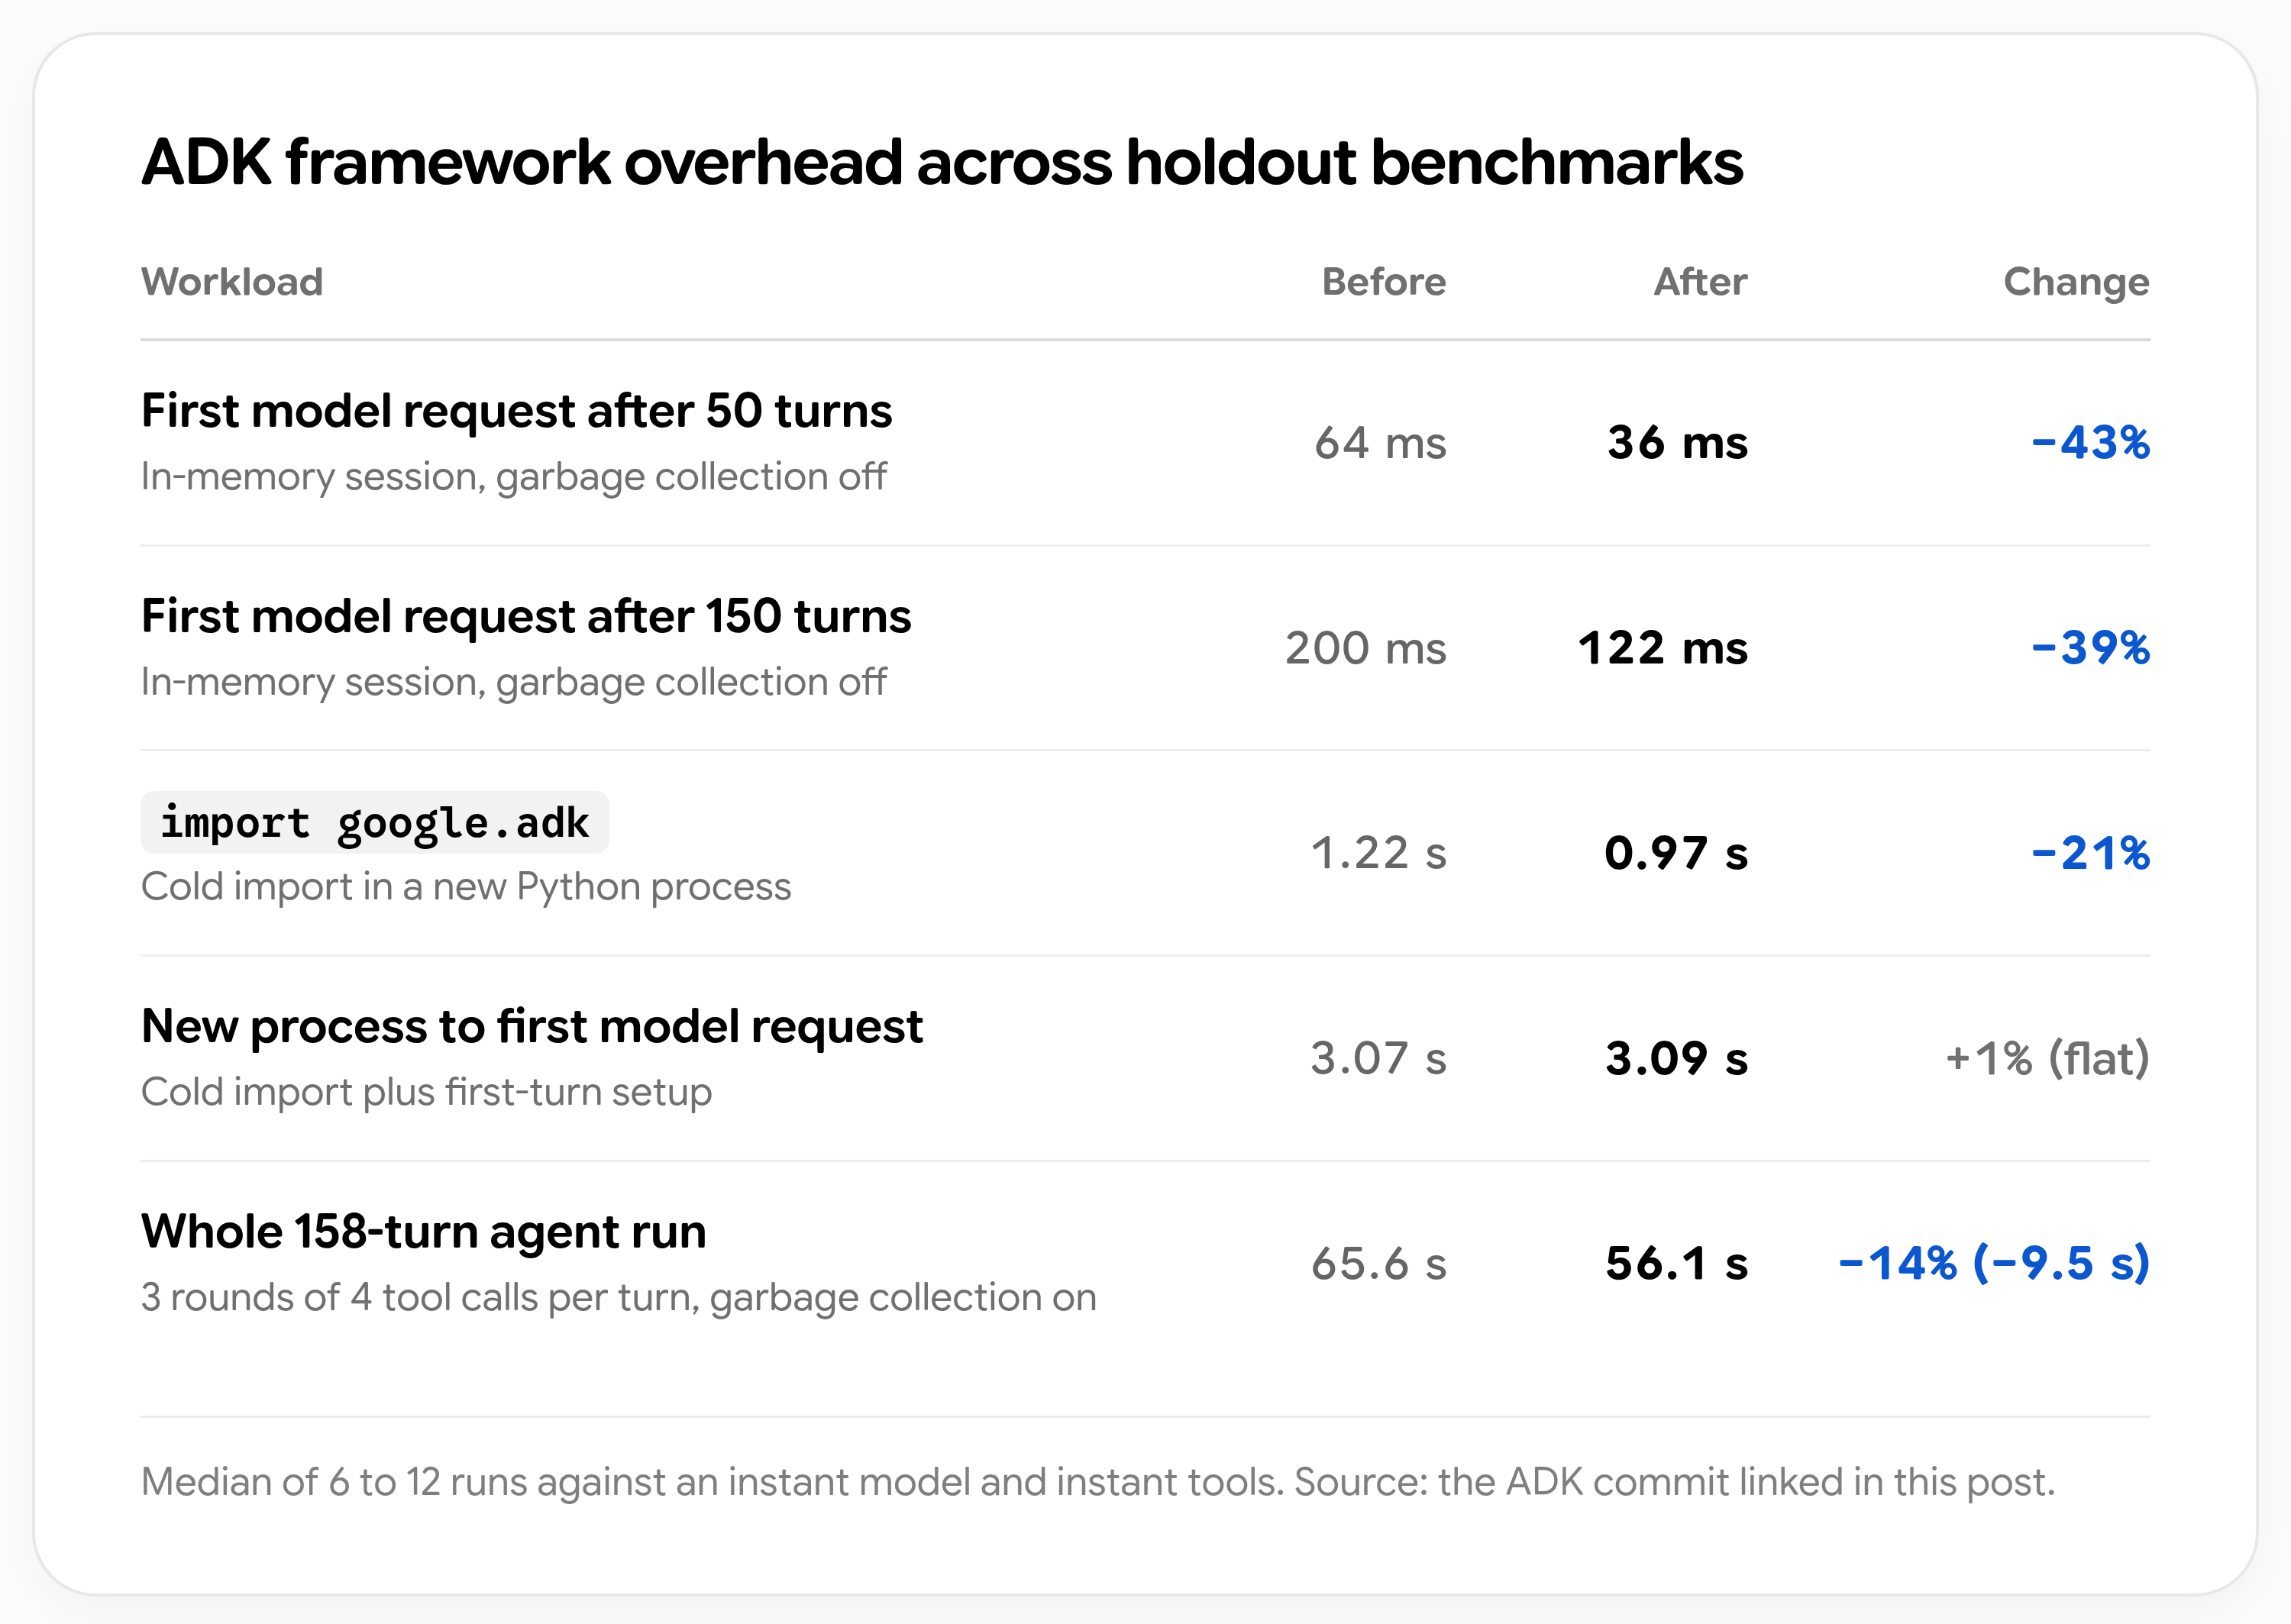
Source : Google Developers Blog, étude d’optimisation ADK. Les mesures utilisent un modèle instantané et des outils afin d’isoler la surcharge du framework, avec des médianes issues de plusieurs exécutions.
| Mesure | Avant | Après | Évolution rapportée |
|---|---|---|---|
| Première requête de modèle après 50 tours | 64 ms | 36 ms | 43 % plus rapide |
| Première requête de modèle après 150 tours | 200 ms | 122 ms | 39 % plus rapide |
| Importation à froid | 1,22 s | 0,97 s | 21 % plus rapide |
| Nouveau processus jusqu’à la première requête | 3,07 s | 3,09 s | Pratiquement inchangé |
| Exécution complète de 158 tours | 65,6 s | 56,1 s | 14 % plus rapide |
Le gain d’environ 40 % concerne un parcours de préparation de session dans le service en mémoire testé. Il ne faut pas le présenter comme une accélération de 40 % pour toutes les applications ADK, en particulier lorsqu’un déploiement utilise un autre backend de stockage ou passe l’essentiel de son temps à attendre les réponses du modèle et des outils.
Les importations à froid se sont améliorées, mais le temps entre le démarrage d’un processus et la première requête n’a pas diminué. C’est un rappel pratique qu’il faut mesurer le workflow visible par l’utilisateur plutôt que de supposer qu’une optimisation locale améliore chaque métrique de bout en bout.
La modification proposée a passé les 16 892 tests unitaires publics, mais 25 cibles de tests internes ont échoué parce que des importations supprimées devaient rester modifiables par patch. Les mainteneurs ont résolu le problème de compatibilité avec des accesseurs paresseux, au lieu de considérer une suite de tests publics entièrement réussie comme une preuve suffisante de sûreté.
D’autres modifications proposées ont été rejetées pour des raisons comprenant des données mises en cache obsolètes, une dépendance à un attribut OpenTelemetry privé, une lisibilité réduite sans bénéfice de bout en bout et une optimisation dont le gain n’apparaissait que dans une charge de travail synthétique.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Cet exemple est donc plus utile qu’un récit de réussite du codage sans supervision. Le modèle a produit des améliorations candidates ; les mainteneurs ont évalué les éléments de preuve, rejeté les correctifs inadaptés et résolu un problème de compatibilité avant de fusionner les travaux retenus.
Google rapporte également une optimisation de l’inférence Gemma 4 E2B utilisant vLLM sur une NVIDIA A100. Dans cette configuration précise, le débit est passé de 37 900 à 108 000 jetons par seconde, soit une amélioration rapportée de 2,85 fois avec parité de jetons.
Il s’agit d’un résultat propre à cette configuration. Il n’établit pas la même accélération pour un autre modèle, GPU, modèle de lot ou pile de déploiement, et il ne faut pas le confondre avec le prix ou la latence d’une requête vers l’API Argon hébergée.
Les démonstrations créatives du lancement incluent un temple tridimensionnel construit avec Blender et une critique visuelle, ainsi qu’une expérience de course inspirée d’une photo de bureau, assemblée à l’aide de plusieurs outils. Cette dernière combine Blender MCP, des textures générées, Three.js et des capacités multimédias supplémentaires ; l’artefact final est donc le résultat d’un workflow, et non la preuve qu’un seul appel en texte brut crée chaque ressource sans assistance.
Ces exemples montrent les types de projets que Google souhaite voir les développeurs tenter. Ils ne remplacent pas les tests directs du code généré, du comportement physique, des licences des ressources ou des performances dans un navigateur.
Le lancement va au-delà de l’ingénierie logicielle et couvre plusieurs domaines de recherche. Chaque résultat concerne un problème plus restreint que ne le suggère le nom de son domaine.
La démonstration robotique suit le même principe. Le robot Apollo de Google observe une personne jouer au cornhole, construit une simulation, puis réussit sept lancers consécutifs dans le monde réel lors de la démonstration rapportée. Cela constitue un élément de preuve concernant l’exécution présentée, et non une estimation de fiabilité pour des robots, des environnements ou des tâches physiques arbitraires.
Google indique que les soumissions de code internes ont augmenté de 35 % et que les taux de retour en arrière ont diminué d’environ un tiers. Il s’agit de chiffres internes rapportés par l’entreprise ; l’article de lancement ne les présente pas comme une prédiction contrôlée de ce qu’une autre organisation obtiendra.
Le cas ADK offre une manière plus pratique d’évaluer cette affirmation plus générale. Commencez par une tâche dont la référence est mesurable, maintenez les tests et vérifications de compatibilité, puis évaluez le correctif final accepté. Le temps consacré à la revue et à la correction d’une modification doit également faire partie du résultat.
Pour les travaux de recherche, la question correspondante est de savoir si la sortie résiste à la vérification propre au domaine : une preuve, une expérience en laboratoire, un calcul indépendant ou une évaluation soigneusement conçue. Une explication plausible produite par le modèle n’est qu’une étape de ce processus.
La page de tarification d’AI Studio consultée le 15 octobre 2026 n’indique aucun niveau gratuit pour gemini-4-argon. L’accès par abonnement grand public et l’accès API pour développeurs ont des conditions différentes ; une fonctionnalité grand public Google AI Pro ne doit donc pas être présumée inclure le modèle API.
Les tarifs standard de lancement documentés sont de 2 $ par million de jetons d’entrée et de 10 $ par million de jetons de sortie, raisonnement inclus, jusqu’au 30 novembre 2026. À partir du 1er décembre, la page indique respectivement 4 $ et 20 $ ; les entrées éligibles au cache implicite sont facturées séparément, et les frais d’outils peuvent s’ajouter au total.
Non. Google documente un budget partagé de 1 048 576 jetons pour l’entrée, le raisonnement et la sortie. Une entrée plus longue laisse donc moins d’espace pour les autres parties de l’interaction.
La documentation sur le décodage long exige le mode arrière-plan, le stockage et une valeur max_output_tokens supérieure à la limite habituelle. Les étapes de continuation restent soumises au budget partagé et au comportement de facturation documenté ; les applications doivent donc suivre les instructions actuelles de l’API Interactions.
Non. Le résultat d’environ 40 % concerne un parcours spécifique de préparation de session en mémoire dans le benchmark de Google. L’exécution complète de 158 tours s’est améliorée de 14 %, tandis que le délai entre un nouveau processus et la première requête est resté pratiquement inchangé.
Non. Les résultats rapportés concernent des problèmes de recherche définis et des démonstrations. Ils nécessitent une validation indépendante appropriée, une revue métier et des tests de déploiement avant d’être généralisés à un usage clinique, industriel ou dans le monde physique.
Gemini 4 Argon apporte un large éventail de capacités rapportées dans le code, les projets visuels et la recherche. Ses détails pratiques immédiats comprennent un accès développeur payant, des prix de lancement qui prennent fin après novembre et un budget de contexte partagé incluant le raisonnement et la sortie.
Les éléments d’ingénierie les plus solides proviennent des modifications ADK acceptées et testées, ainsi que de leurs limites mesurées, la revue humaine restant une partie intégrante du résultat.
Partez d’une phrase et obtenez un site complet en quelques minutes.



