For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/glm-5-3-highspeed-in-zcode-490-tps-test-1-df8d564e.md.
Un nouveau nom de modèle Z.ai est apparu discrètement dans ZCode : **GLM-5.3 Highspeed**.
Un nouveau nom de modèle Z.ai est apparu discrètement dans ZCode : GLM-5.3 Highspeed.
Le modèle a fait surface dans ZCode 3.15.1, où certains abonnés sont sélectionnés aléatoirement pour un essai HighSpeed. Un utilisateur, @leo114119, a publié une exécution montrant une vitesse de sortie proche de 490 tokens par seconde, avec une autre capture affichant environ 493 tok/s.
C'est un chiffre frappant.
Si un modèle pouvait maintenir 490 tokens de sortie par seconde, générer 10 000 tokens de sortie ne prendrait qu'environ :
10,000 / 490 ≈ 20.4 secondes
Ce calcul couvre uniquement la phase de génération de tokens. Il n'inclut pas le délai avant le premier token, le raisonnement avant l'affichage de la sortie, les appels d'outils, la surcharge réseau ou les pauses dans un workflow d'agent.
Plus important encore, le résultat de 490 TPS est actuellement une observation de la communauté, et non une garantie officielle de débit de Z.ai.
Ce qui est confirmé, c'est que ZCode 3.15.1 a introduit un essai aléatoire GLM HighSpeed pour les abonnés et que l'identifiant glm-5.3-highspeed est déjà présent dans le catalogue public de modèles de Pi.
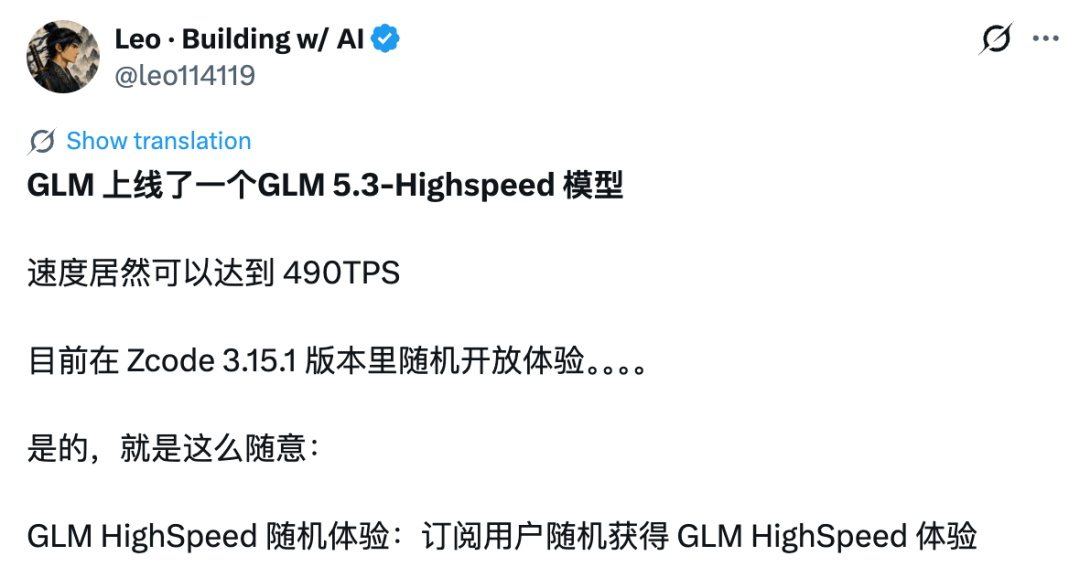
Le premier indice ne se limite pas à une capture d'écran sur les réseaux sociaux.
Les notes de version officielles de ZCode pour la version 3.15.1 indiquent :
Les abonnés peuvent désormais être sélectionnés aléatoirement pour un essai GLM HighSpeed.
Cette formulation est importante, car elle explique pourquoi l'accès varie d'un compte à l'autre.
L'article source rapporte que son auteur a essayé d'ajouter manuellement GLM-5.3 Highspeed et de basculer vers celui-ci, mais n'a pas pu l'utiliser avec un abonnement Lite.
L'interface indiquait que le modèle existait, mais que l'offre actuelle ne donnait pas accès à celui-ci.
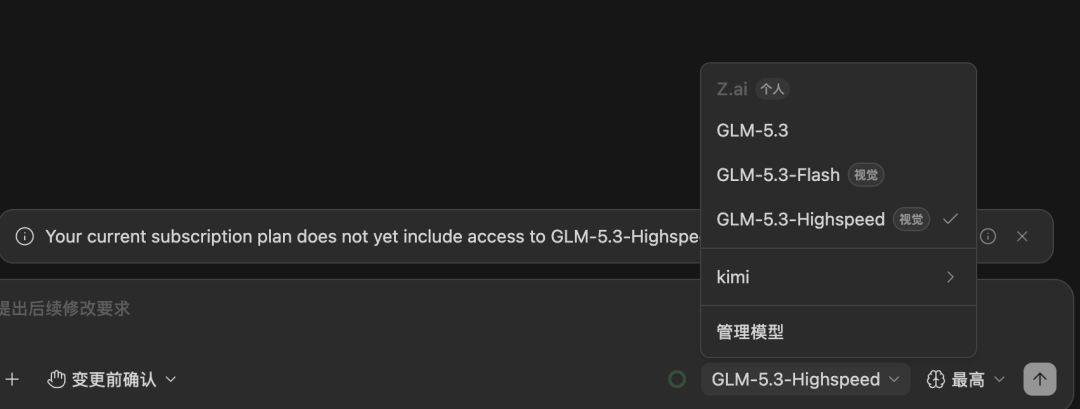
Cela est cohérent avec la stratégie de déploiement actuelle de ZCode :
Mise à jour vers ZCode 3.15.1
        ↓
Compte abonné
        ↓
Éligibilité aléatoire à l'essai HighSpeed
        ↓
L'accès à l'essai apparaît dans le client si le compte est sélectionné
Le programme n'est pas actuellement présenté comme une fonctionnalité automatiquement accessible à tous les niveaux d'abonnement payant.
Une capture communautaire résumant les propres termes de ZCode souligne le même point : l'expérience HighSpeed est un avantage attribué aléatoirement aux abonnés, et le client constitue la source de référence pour savoir si un compte particulier a été sélectionné.
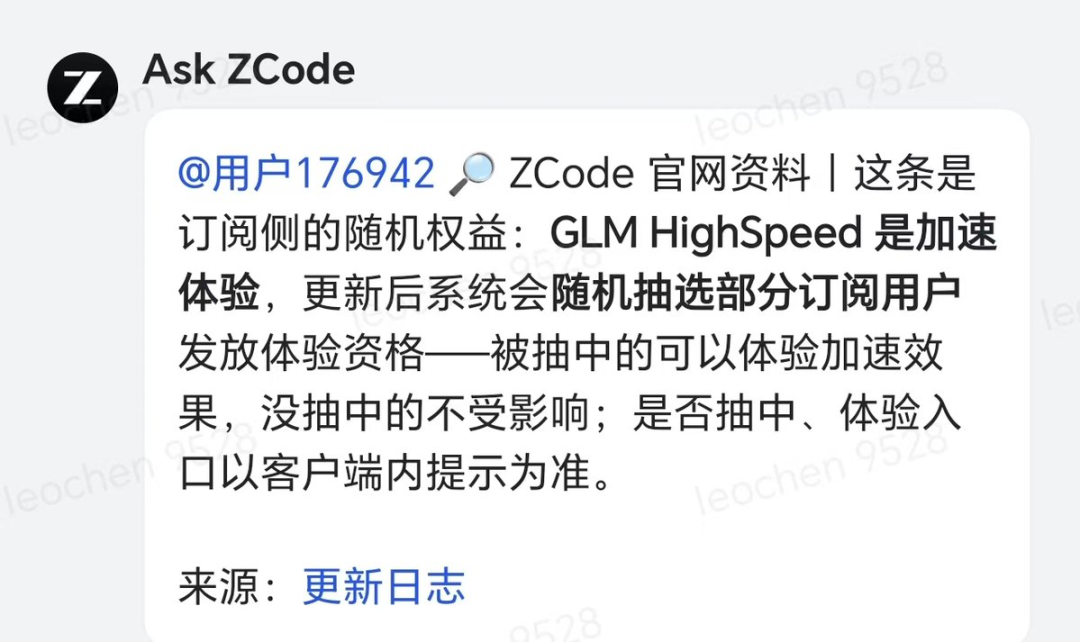
La principale raison de l'attention portée au modèle est la capture de vitesse.
L'utilisateur source a publié une exécution affichant environ 493 tok/s.
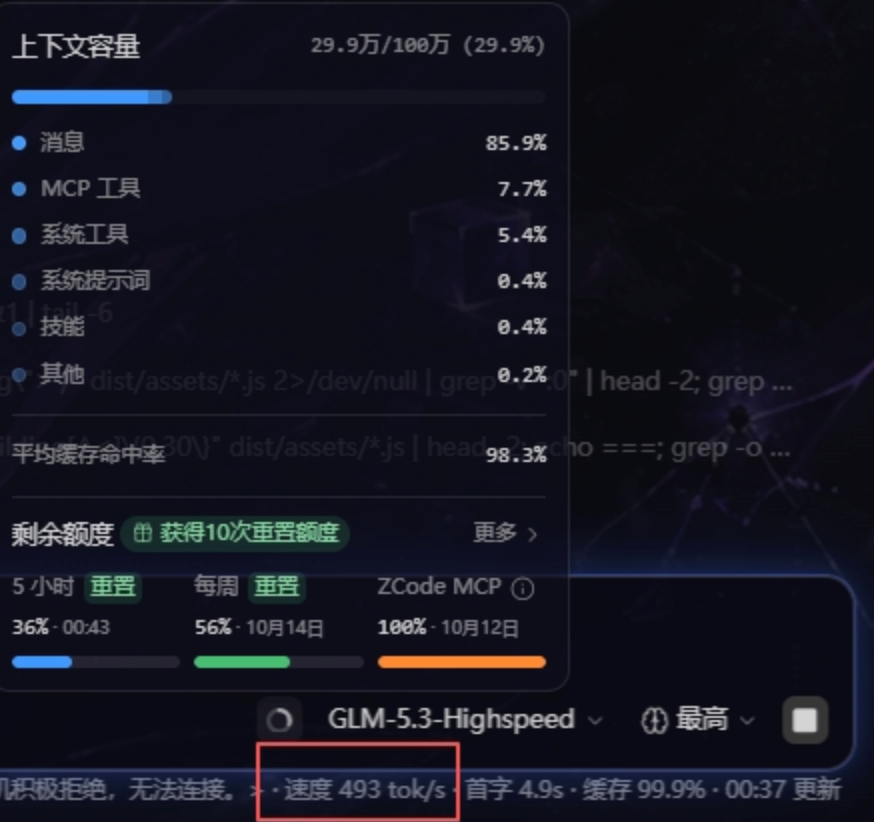
Ce chiffre est suffisamment proche des 490 TPS mis en avant dans le titre de l'article pour que l'écart ne soit pas significatif.
Il est toutefois utile d'être précis sur ce que cette capture nous indique et ce qu'elle ne démontre pas.
GLM-5.3-Highspeed.Le débit peut dépendre fortement des éléments suivants :
La bonne conclusion, à ce stade, est donc la suivante :
GLM-5.3 Highspeed a démontré un débit de sortie très élevé dans au moins un test ZCode public, mais Z.ai n'a pas encore publié de spécification officielle à 490 TPS.
Ce nombre se distingue parce que la famille GLM dispose déjà de plusieurs options de service orientées vitesse.
La documentation de Z.ai indique que GLM-5.3-FlashX peut atteindre jusqu'à 200 tokens/s. FlashX est la variante de service à haute vitesse de GLM-5.3-Flash.
La documentation de Pi et de Z.ai liste GLM-5.3-Flash avec une fenêtre de contexte de 1 M et une sortie maximale de catégorie 128 K, tandis que FlashX privilégie une latence de service plus faible et une génération plus rapide.
L'article original cite également une mesure d'Artificial Analysis d'environ 60 tokens/s pour GLM-5.3-Flash sur l'API propriétaire de Z.ai au moment de la rédaction.
Les mesures indépendantes de débit évoluent dans le temps, et des relevés ultérieurs ont présenté des écarts significatifs selon le fournisseur et la date ; un chiffre unique ne doit donc pas être considéré comme permanent.
Une comparaison utile est par conséquent la suivante :
| Modèle / chemin de service | Vitesse rapportée ou documentée | Statut |
|---|---|---|
| GLM-5.3 Highspeed dans ZCode | ~490–493 tok/s dans une capture utilisateur | Observation communautaire / essai aléatoire |
| GLM-5.3-FlashX | Jusqu'à 200 tok/s | Variante orientée vitesse documentée publiquement |
| GLM-5.3-Flash sur l'API Z.ai | Beaucoup plus faible dans des relevés indépendants de première partie | La mesure indépendante varie selon la date et le fournisseur |
L'écart est suffisamment grand pour que l'on cherche naturellement à comprendre ce que signifie réellement « Highspeed ».
glm-5.3-highspeedLe nom du modèle n'est pas apparu uniquement dans ZCode.
Le catalogue public de modèles de Pi dispose déjà d'une page pour GLM-5.3 Highspeed.
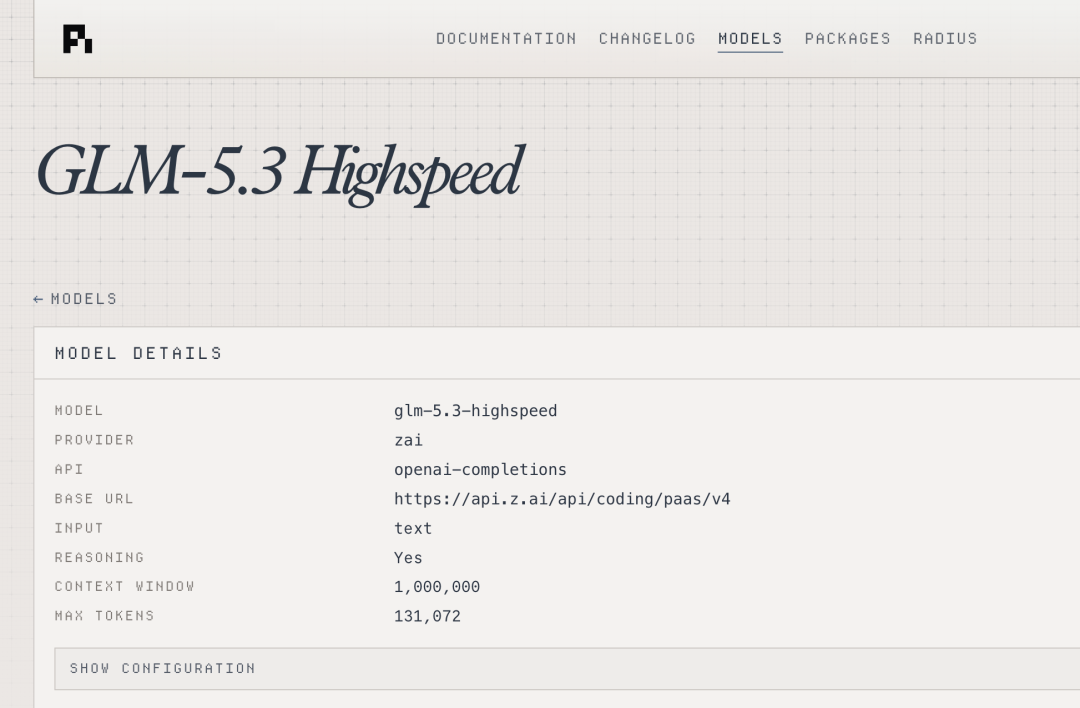
La configuration listée est la suivante :
| Champ | Valeur |
|---|---|
| ID du modèle | glm-5.3-highspeed |
| Fournisseur | zai |
| Style d'API | Complétions compatibles OpenAI |
| Entrée | Texte |
| Raisonnement | Oui |
| Fenêtre de contexte | 1 000 000 tokens |
| Sortie maximale | 131 072 tokens |
| Niveaux de raisonnement | low / high / max |
Le point de terminaison affiché par Pi est :
https://api.z.ai/api/coding/paas/v4
Pi associe également le modèle au format d'API de programmation de Z.ai.
Deux détails sont particulièrement notables.
Cela correspond à la configuration de contexte long observée dans les outils actuels de la famille GLM-5.3.
Pour les agents de programmation, un contexte de 1 M de tokens peut être utile pour :
Cela représente approximativement 128 K tokens.
Là encore, cela est cohérent avec la configuration actuelle de sortie longue de plusieurs entrées de la famille GLM-5.3.
La fiche Pi ne suggère donc pas une architecture de contexte manifestement différente de celle de la gamme GLM-5.3 habituelle.
Elle confirme surtout que l'identifiant Highspeed est suffisamment réel pour disposer d'une configuration structurée de fournisseur.
Pi associe trois paramètres de raisonnement actifs :
low
high
max
L'article source indique que ces paramètres sont également familiers dans la configuration régulière de GLM-5.3.
Cela nous donne une autre raison de ne pas supposer que Highspeed est un tout nouveau modèle de base.
Il pourrait s'agir :
Sans fiche de modèle Z.ai, ces possibilités ne peuvent pas encore être distinguées avec certitude.
Le nom seul ne suffit pas.
C'est ici que l'histoire devient spéculative.
Avant l'apparition des captures ZCode, des utilisateurs de Reddit avaient déjà repéré glm-5.3-highspeed dans le catalogue de Pi et s'étaient demandé s'il pouvait être lié à Omen Alpha.
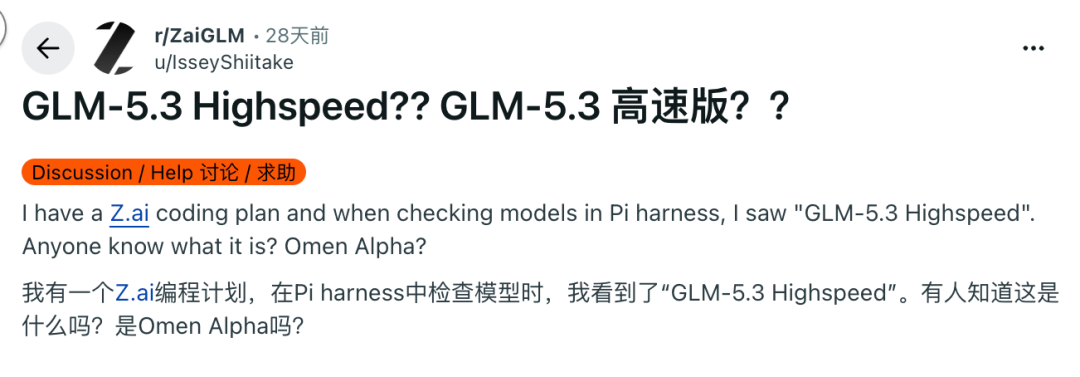
Omen Alpha est un modèle anonyme apparu dans des tests OpenCode.
Des membres de la communauté l'avaient déjà associé à Zhipu/Z.ai sur la base de son comportement observé et d'indices liés à l'infrastructure.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Une réponse sur Reddit a spéculé qu'il pourrait s'agir d'une nouvelle variante GLM à haute vitesse, avec une qualité proche de GLM-5.3-Flash mais un débit nettement supérieur.
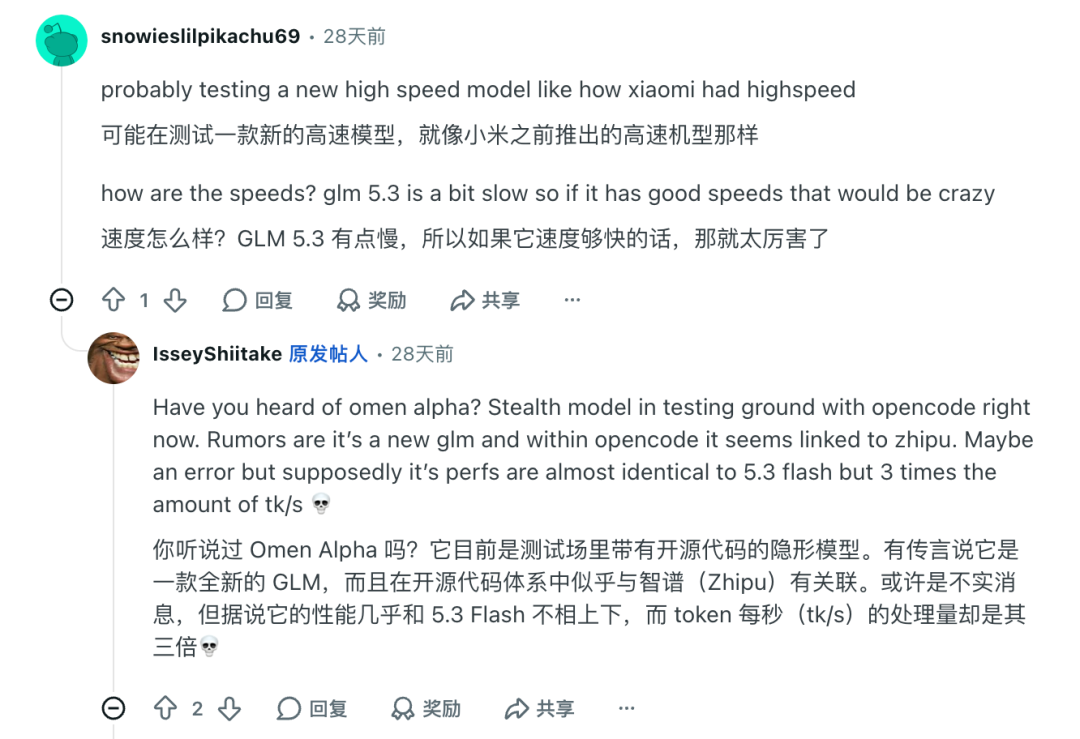
Une autre capture source montre une entrée de modèle omen-alpha connectée à une étiquette de fournisseur liée à Zhipu, ce qui a alimenté cette théorie.
Mais aucun de ces éléments n'établit l'identité de manière concluante.
L'article original énumère plusieurs hypothèses :
Ces noms doivent rester dans la catégorie des spéculations communautaires jusqu'à ce que Z.ai publie une correspondance officielle.
Deux points de terminaison peuvent sembler très similaires sans être le même modèle.
Le comportement observé peut être influencé par :
La similarité de comportement est donc un indice, mais pas une preuve.
Le nom lui-même n'est pas inhabituel pour Zhipu.
L'entreprise a déjà lancé des versions haute vitesse de modèles GLM.
L'article source renvoie à GLM-5.1-highspeed, qui a été promu avec une vitesse de sortie d'environ 400 tokens/s en mai 2026.
La famille GLM-5.3 plus récente comprend également FlashX, une variante publique orientée vitesse, documentée à jusqu'à 200 tokens/s.
Cela suggère une tendance produit plus large :
Modèle de base ou modèle phare
        ↓
Chemin de service à haute vitesse
        ↓
Latence plus faible / débit plus élevé pour les charges de travail interactives
Cette tendance rend un produit GLM-5.3 Highspeed techniquement plausible, même sans supposer l'existence de nouveaux poids de modèle.
Cela reste une inférence, et non une description officielle du produit.
Pourquoi s'intéresser à 490 TPS ?
Pour une réponse courte de 200 tokens, la différence entre 100 TPS et 500 TPS ne représente que quelques secondes.
Pour de longues sorties d'agent, la génération de code ou un raisonnement détaillé, la différence devient beaucoup plus importante.
Par exemple :
| Longueur de sortie | 100 tok/s | 200 tok/s | 490 tok/s |
|---|---|---|---|
| 1 000 tokens | 10,0 s | 5,0 s | ~2,0 s |
| 5 000 tokens | 50,0 s | 25,0 s | ~10,2 s |
| 10 000 tokens | 100,0 s | 50,0 s | ~20,4 s |
Il s'agit uniquement de calculs simplifiés du temps de décodage.
Les tâches réelles d'agent incluent aussi :
Malgré cela, un décodage plus rapide peut rendre les longs workflows itératifs beaucoup plus réactifs.
C'est particulièrement pertinent dans les agents de programmation tels que ZCode, où une requête utilisateur peut générer plusieurs appels au modèle plutôt qu'une seule réponse finale.
La capture à ~493 tok/s affiche également un taux de cache atteint extrêmement élevé.
C'est un élément à noter.
Un taux de cache atteint élevé peut réduire la quantité de traitement répétitif du prompt nécessaire dans de longues sessions d'agent.
Une session de programmation typique peut transporter de façon répétée :
instructions système
+ contexte du dépôt
+ définitions d'outils
+ conversation précédente
+ modifications récentes
Si une grande partie de ce contexte est réutilisée efficacement, le système peut consacrer moins de temps à recalculer le côté entrée à chaque tour.
Toutefois, le chiffre affiché en tok/s désigne généralement le débit de génération de sortie, et non le débit du cache de prompt à lui seul.
Le chiffre du cache reste important, car la latence globale de la session peut sembler bien meilleure lorsque la réutilisation du prompt et le décodage rapide fonctionnent tous deux efficacement.
C'est une raison supplémentaire pour laquelle une seule capture ne peut pas caractériser complètement le modèle.
GLM-5.3-FlashX fournit la comparaison publique la plus claire, car la documentation Z.ai le décrit déjà comme un modèle orienté vitesse.
Les informations actuellement publiées pour FlashX comprennent :
glm-5.3-flashx.FlashX démontre donc que Z.ai est déjà prêt à créer des variantes dédiées à un débit élevé sans les présenter comme des générations d'intelligence entièrement nouvelles.
GLM-5.3 Highspeed pourrait suivre la même logique produit à un niveau de service encore plus rapide.
Cela demeure une inférence et non une description officielle du produit.
Les éléments disponibles peuvent être séparés en trois niveaux de confiance.
glm-5.3-highspeed comme un modèle Z.ai.Cette distinction est la manière la plus prudente d'interpréter le déploiement actuel.
GLM-5.3 Highspeed est un identifiant de modèle Z.ai apparu dans ZCode et dans le catalogue public de modèles de Pi. ZCode 3.15.1 confirme officiellement un essai GLM HighSpeed aléatoire pour les abonnés, mais Z.ai n'a pas encore publié de fiche de modèle autonome complète pour GLM-5.3 Highspeed dans les sources examinées ici.
Une capture d'écran publique d'un utilisateur affiche environ 493 tok/s lors d'une exécution ZCode, ce qui constitue la base du titre à 490 TPS. C'est une observation utile, mais ce n'est pas une garantie officielle de débit soutenu et le résultat peut varier selon la charge de travail, le comportement du cache, la région et les conditions du serveur.
Pi indique actuellement une fenêtre de contexte de 1 000 000 tokens et une sortie maximale de 131 072 tokens pour glm-5.3-highspeed. Ces valeurs sont similaires à la configuration de contexte long des autres modèles actuels de la famille GLM-5.3.
Non. Le changelog officiel de ZCode v3.15.1 indique que les abonnés sont sélectionnés aléatoirement pour l'essai GLM HighSpeed. Si votre compte n'est pas sélectionné, voir le nom du modèle ne signifie pas nécessairement que vous pouvez l'exécuter.
Aucune confirmation officielle n'établit qu'il s'agit du même produit. FlashX est une variante publique à haute vitesse de GLM-5.3-Flash, documentée jusqu'à 200 tok/s, tandis que GLM-5.3 Highspeed apparaît actuellement via des essais ZCode et le catalogue de fournisseurs de programmation de Pi.
Cela reste une spéculation. Des utilisateurs de Reddit et d'OpenCode ont relié Omen Alpha à Zhipu/Z.ai, mais aucune source officielle ne confirme qu'Omen Alpha correspond à glm-5.3-highspeed.
Les agents de programmation effectuent souvent plusieurs appels longs au modèle lorsqu'ils lisent des fichiers, écrivent des correctifs, exécutent des outils et vérifient les résultats. Un débit de décodage plus élevé peut réduire le temps d'attente entre ces étapes, en particulier lorsque le modèle produit des milliers de tokens par appel.
Utilisez le client ZCode actuel après avoir effectué la mise à jour vers une version qui inclut l'essai. Les notes de version de ZCode indiquent que l'accès est attribué aléatoirement aux abonnés ; l'interface du compte ou du client constitue donc la source pratique de référence pour vérifier votre éligibilité.
glm-5.3-highspeed.GLM-5.3 Highspeed n'est plus seulement un nom de modèle isolé : ZCode 3.15.1 confirme officiellement un essai GLM HighSpeed aléatoire pour les abonnés, et Pi expose déjà une configuration structurée glm-5.3-highspeed avec une fenêtre de contexte de 1 M de tokens et une limite de sortie de 131 072 tokens.
Le chiffre frappant de 490–493 tok/s provient d'une véritable capture publique, mais il reste une observation utilisateur plutôt qu'une garantie officielle de débit de Z.ai. L'interprétation la plus prudente est que Z.ai teste un chemin de service de programmation très rapide et n'a pas encore publié la spécification complète du produit.
Le lien avec Omen Alpha n'est toujours pas résolu. Il pourrait s'avérer lié, mais les éléments actuels sont circonstanciels et portés par la communauté plutôt qu'officiels.
Ce qui est confirmé aujourd'hui est le déploiement et l'identifiant du modèle ; ce qui n'est pas encore confirmé est l'architecture exacte, la tarification publique, le débit soutenu et l'éventuelle identité commune avec Omen Alpha.
Partez d’une phrase et obtenez un site complet en quelques minutes.



