For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/glm-legal-explained-harvey-lab-scores-leg-ebeccf7b.md.
Z.ai a présenté GLM-Legal, un modèle spécialisé conçu pour des tâches telles que l’examen de contrats, le rapprochement de preuves et la pré...
Z.ai a présenté GLM-Legal, un modèle spécialisé conçu pour des tâches telles que l’examen de contrats, le rapprochement de preuves et la préparation de recherches en matière de conformité. Il se concentre sur le processus qui va des documents sources à un brouillon exploitable, plutôt que sur la réponse à une question isolée concernant un concept juridique.
Le rapport fourni met en avant des résultats de premier plan parmi les modèles à poids ouverts sur deux benchmarks juridiques. Les chiffres sous-jacents sont plus instructifs que le titre : environ 19,2 % des tâches ont été entièrement réussies sur le Legal Agent Benchmark de Harvey, et le modèle a obtenu une précision de 86,23 % sur LegalBench.
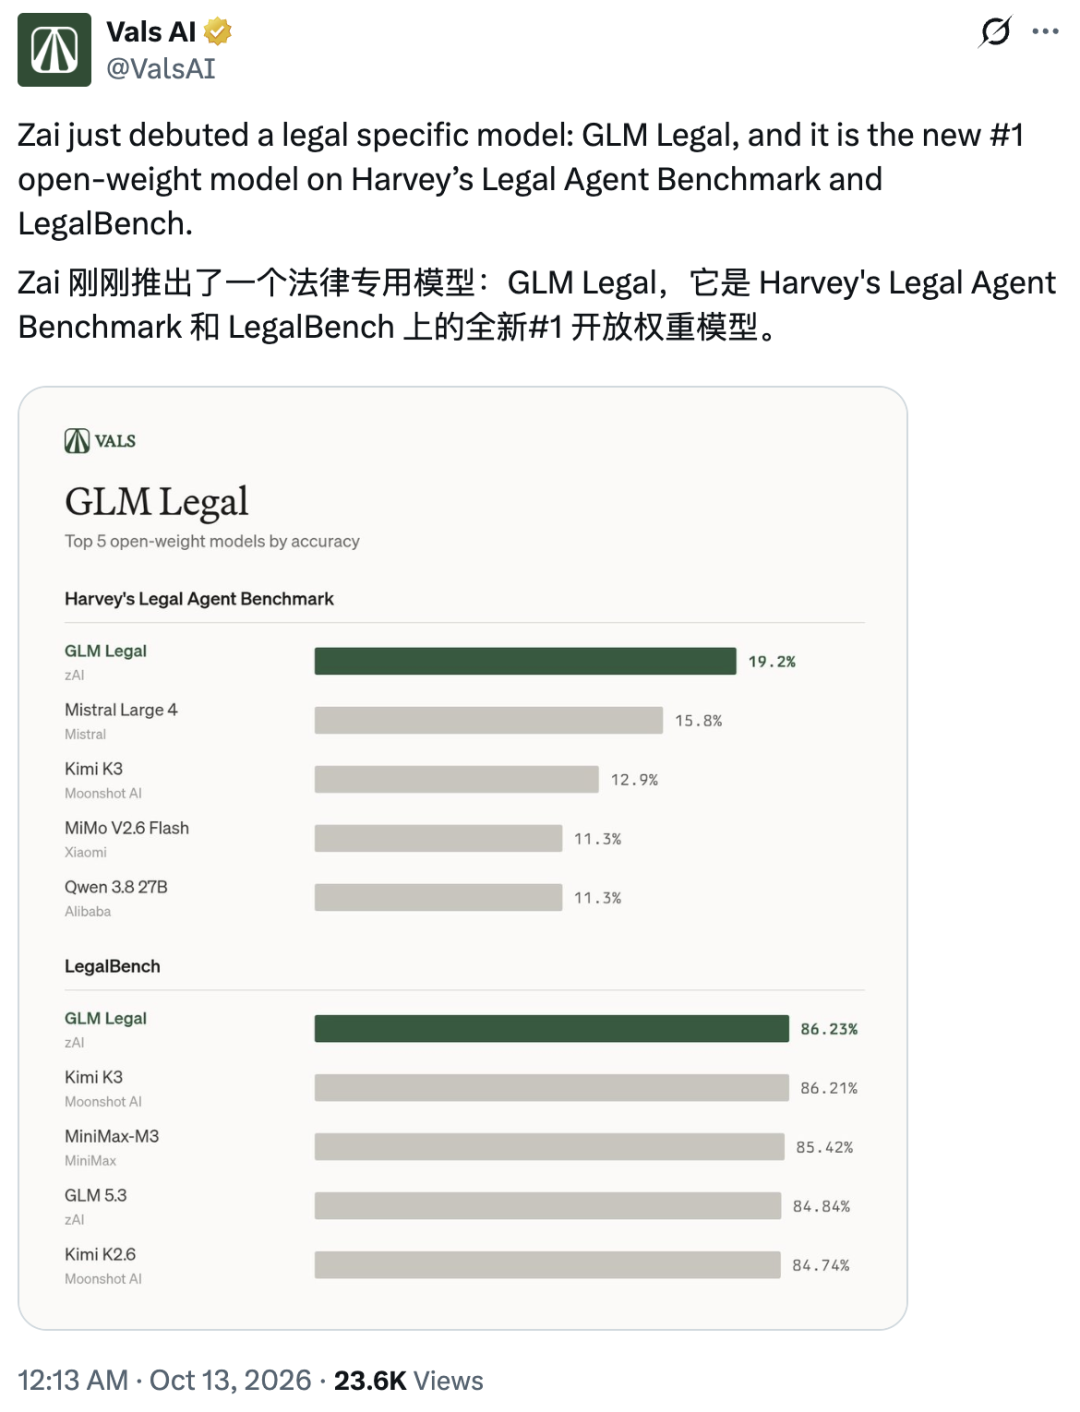
Ces pourcentages mesurent des éléments différents. Ils ne démontrent ni que le modèle est le meilleur système pour chaque juridiction, ni qu’il peut assumer seul la responsabilité d’une affaire juridique.
L’annonce officielle décrit des évaluations portant sur l’exécution de tâches complexes, le raisonnement juridique spécialisé et des flux de travail juridiques pratiques. Les résultats relatifs à la pratique juridique chinoise s’appuient sur PLawBench ; d’autres exemples concernent des documents en anglais et des enjeux de confidentialité transfrontaliers.
Ce périmètre répond à une question évidente au sujet du modèle : il n’est pas présenté comme un chatbot juridique exclusivement anglophone. Cela ne signifie toutefois pas que toutes ses réponses soient à jour ou applicables dans chaque pays. L’utilité d’un brouillon dépend toujours du droit applicable, des faits, de la date et de l’examen par un professionnel.
La première démonstration porte sur un client qui change de fournisseur de services logiciels. La tâche consiste à examiner les clauses de résiliation et de transition afin que le client puisse récupérer ses éléments et poursuivre le projet.
Par rapport à la réponse du modèle GLM-5.3-Flash de base, le modèle spécialisé propose des modifications plus concrètes. Dans cet exemple, il recommande de réduire de 60 à 30 jours le préavis de résiliation pour convenance, de supprimer le délai de remédiation pour certains manquements graves et d’ajouter jusqu’à 90 jours d’assistance à la transition.
Il relie également la restitution proposée des livrables aux dispositions existantes du contrat sur la propriété des travaux, en couvrant les travaux inachevés et non payés, et pas uniquement les livrables achevés et réglés. Le périmètre de la transition comprend le code source, la documentation, les données et le transfert des connaissances.
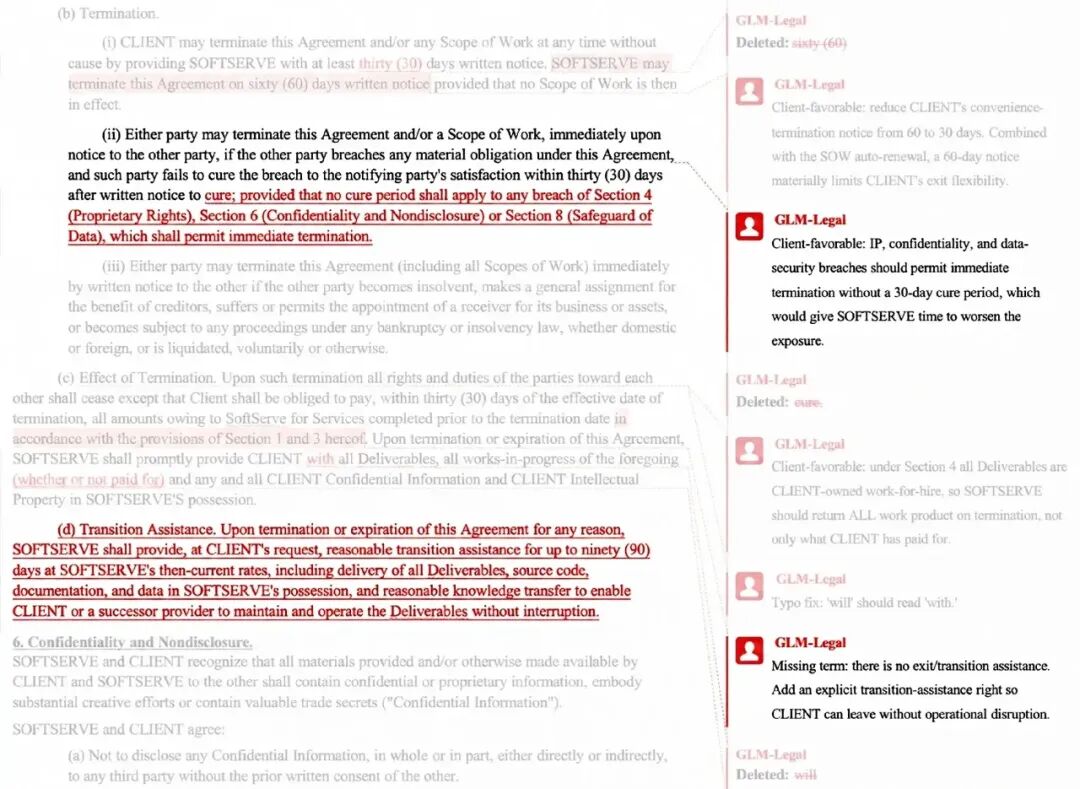
Il s’agit de positions de négociation proposées pour le contrat fourni. Un préavis de 30 jours ou une transition de 90 jours ne constitue pas une exigence juridique générale. Leur pertinence dépend de l’accord, de la position du client, du prix et du droit applicable.
La deuxième démonstration fournit à l’agent 40 documents relatifs à un litige portant sur un projet logiciel. Un rapport d’avancement destiné au client indique que le projet est achevé à 60 %, tandis qu’un état interne situe son avancement à environ 41 %.
Les modèles de base et le modèle spécialisé repèrent tous deux cet écart. GLM-Legal va plus loin en reliant le rapport d’avancement à un avertissement antérieur concernant l’étape clé, à des instructions internes sur la divulgation et la facturation, ainsi qu’aux clauses du contrat relatives au paiement et aux droits qui subsistent après la fin du contrat.
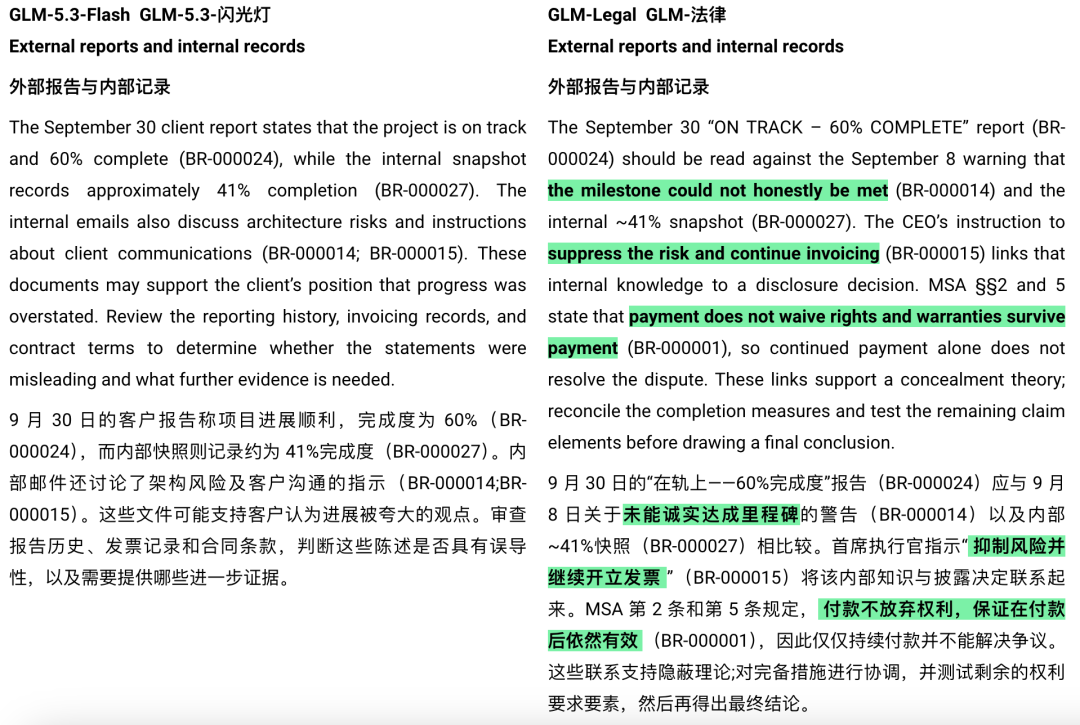
Cela permet de définir une piste d’enquête plus claire : repérer les documents originaux qui étayent chaque point, rapprocher les mesures d’avancement et vérifier les éléments restants de toute réclamation. Le résultat présente une théorie possible de l’affaire ; les seuls pourcentages contradictoires ne suffisent pas à établir définitivement une fraude ou une responsabilité.
Le troisième exemple concerne le lancement d’un site web à Singapour, en Malaisie et en Indonésie. Le flux de travail comprend le suivi, les courriels marketing et le stockage dans le cloud à l’étranger.
GLM-Legal organise plusieurs priorités à traiter avant le lancement : les avis, les registres de consentement, les autorisations distinctes pour le marketing, la suppression des abonnés désinscrits, une cartographie de la localisation des données chez les fournisseurs, ainsi que l’examen des garanties contractuelles et des mécanismes de transfert. Sa réponse distingue une base commune prudente des questions qui nécessitent encore une confirmation propre à chaque pays.
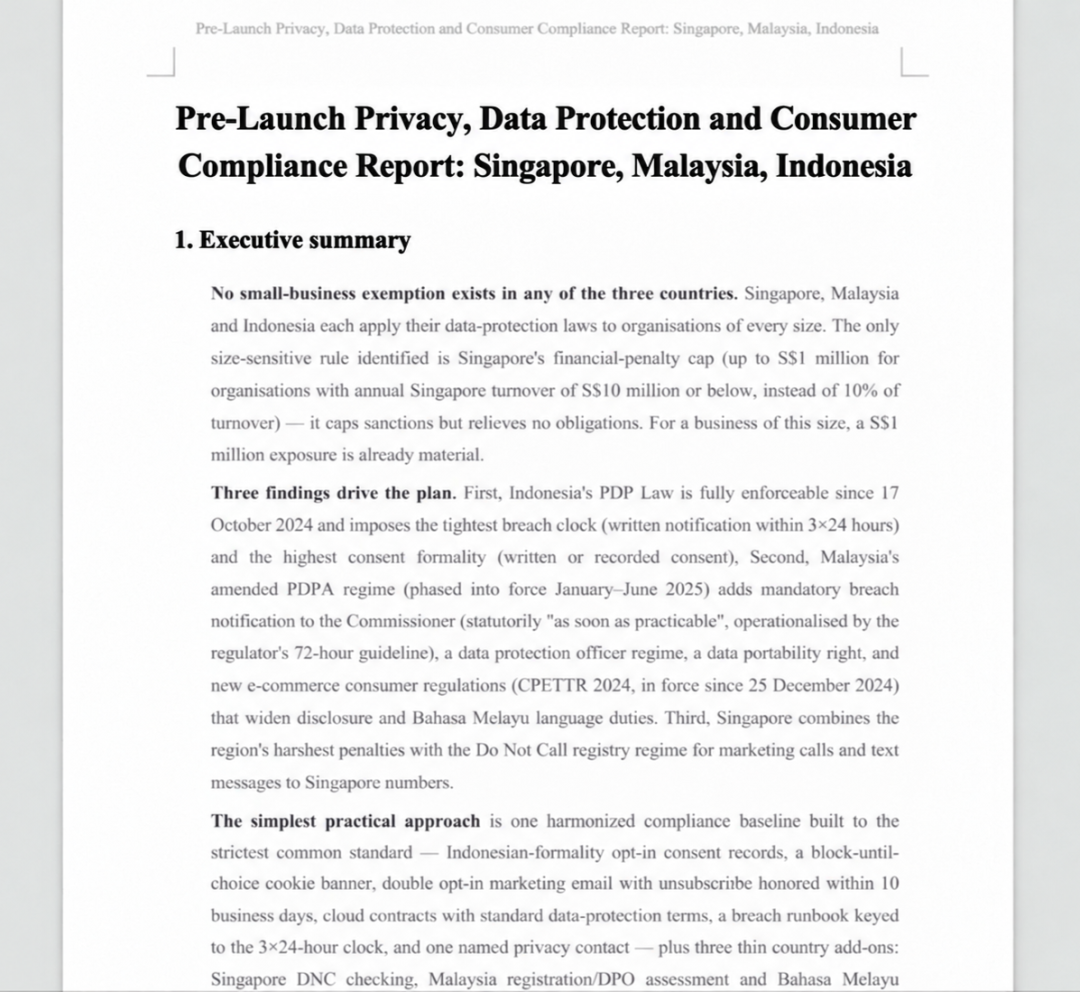
La valeur pratique tient à la production d’un brouillon comprenant des actions qu’une équipe peut attribuer et vérifier. La démonstration ne remplace pas la vérification de la législation en vigueur, des orientations des autorités de régulation, des flux de données réels ni des exigences locales applicables au service concerné.
Harvey a conçu LAB autour de tâches qu’un associé de cabinet d’avocats pourrait recevoir : une demande d’un associé principal, un dossier client accompagné de pièces justificatives et un livrable qu’une autre personne peut examiner. Sa première version comprend plus de 1 200 tâches réparties dans 24 domaines de pratique, avec plus de 75 000 critères de notation rédigés par des experts.
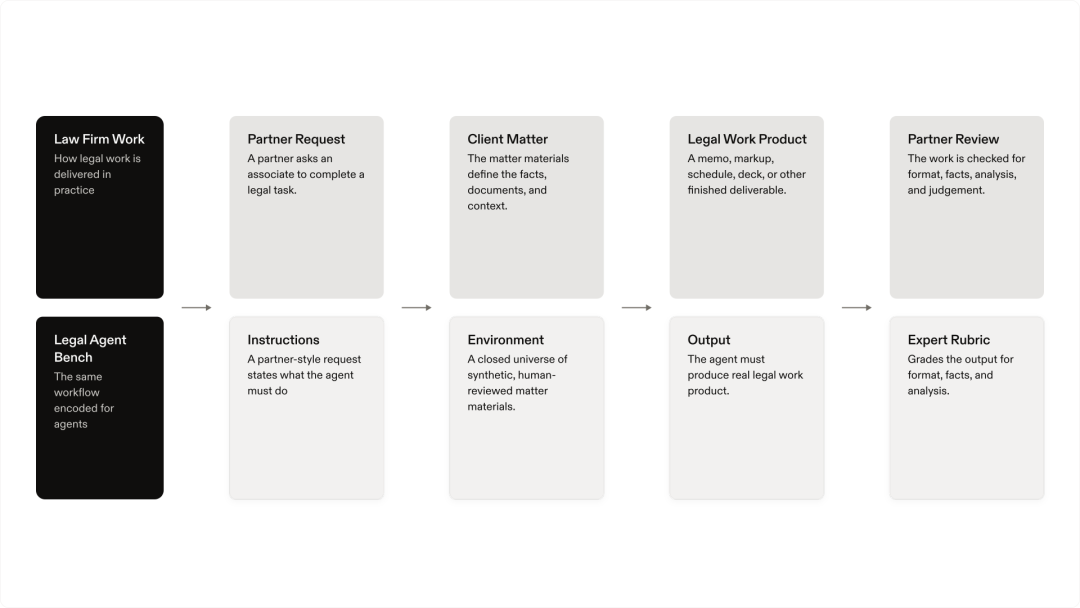
Le benchmark utilise une notation par réussite complète. Une tâche n’est considérée comme achevée que si tous les critères requis sont satisfaits. Ceux-ci portent notamment sur les faits, les citations, les conclusions, les délais, les montants financiers et le format de sortie. L’absence d’une exigence importante empêche la réussite complète de la tâche.
| Évaluation | Résultat dans les documents examinés | Ce qui est mesuré |
|---|---|---|
| Harvey LAB | 19,17 %, arrondi à 19,2 % | Part des tâches qui satisfont à tous les critères requis. |
| LegalBench | 86,23 % de précision sur la page actuelle du modèle Vals | Précision sur un ensemble distinct de tâches de raisonnement juridique. |
| PLawBench | Z.ai indique une parité avec les principaux systèmes de pointe | Évaluation de la pratique juridique chinoise ; il ne s’agit pas de la même mesure que pour les résultats de Vals. |
L’annonce initiale de Vals présente GLM-Legal comme le modèle à poids ouverts le mieux classé sur LAB et LegalBench au moment de cette comparaison. Les classements généraux comprennent des systèmes propriétaires : la page Vals examinée pour cet article le plaçait septième sur 80 pour LAB et quinzième sur 151 pour LegalBench. Les classements et le nombre d’échantillons peuvent évoluer à mesure que de nouvelles évaluations sont ajoutées.
Un taux de réussite complète de 19,2 % témoigne de progrès selon un critère strict, mais signifie aussi que la grande majorité des tâches évaluées n’ont pas satisfait à tous les critères. C’est une raison d’examiner les cas d’échec et de conserver une étape de contrôle, et non de considérer le modèle comme un cabinet d’avocats autonome.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
La source compare GLM-Legal à Gemini 4 Argon dans le classement LAB. Dans cet instantané, les résultats de réussite des tâches étaient proches, mais GLM-Legal mettait environ une demi-heure de plus et coûtait bien moins cher par test ; l’écart de coût indiqué était d’environ 70 fois.
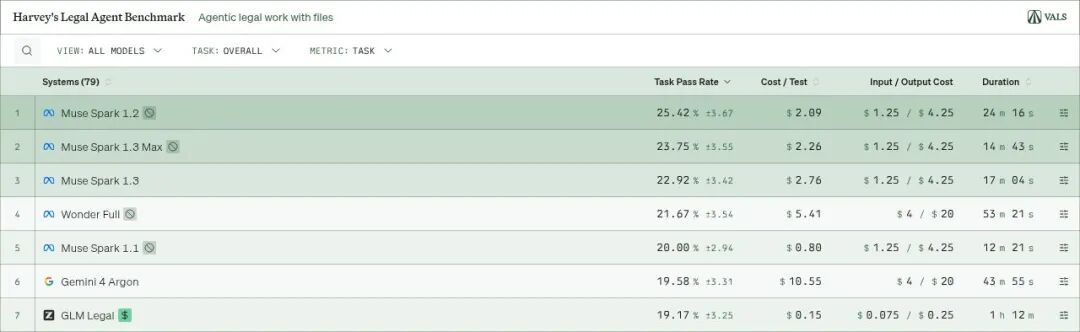
Ces chiffres mesurent des essais de benchmark ; ils ne garantissent pas les mêmes résultats sur un autre ensemble de documents ni le montant de la facture mensuelle d’une équipe. L’utilisation des outils, la conception du système d’exécution, les paramètres de raisonnement, la longueur des tâches et les nouvelles tentatives influent tous sur les coûts réels.
La description officielle de l’entraînement commence avec GLM-5.3-Flash, puis ajoute une spécialisation par étapes :
Le système d’exécution fait partie du système amélioré. Placé dans un environnement d’outils différent, un modèle identique peut ne pas reproduire la qualité de flux de travail montrée dans la démonstration.
Z.ai invite les cabinets d’avocats, les entreprises de technologie juridique, les équipes juridiques internes et les praticiens indépendants à demander l’accès à la bêta de l’API GLM-Legal. Son annonce indique également que les capacités juridiques seront intégrées à AutoClaw et présente dans ce contexte les exemples de modification de documents Word et de recherche.
Vals classe GLM-Legal parmi les modèles à poids ouverts. Cependant, les documents de lancement examinés ici ne confirment ni la disponibilité d’un point de contrôle téléchargeable, ni les conditions de licence, la pile d’inférence prise en charge ou les exigences matérielles. Il n’existe ici aucun fondement vérifié pour fournir une commande d’installation Docker ou affirmer que le déploiement local est déjà accessible au grand public.
Pour une équipe qui souhaite l’évaluer dès maintenant, la démarche concrète indiquée dans l’annonce consiste à contacter officiellement Z.ai et à demander l’accès à la bêta. Les conditions réelles d’accès à la bêta et la disponibilité d’AutoClaw doivent être vérifiées au moment de l’utilisation.
Le rapport fourni situe GLM-Legal dans la continuité des travaux antérieurs de Zhipu avec PowerLaw sur PowerLawGLM en 2023. Il cite également Tenet de Harvey comme autre exemple de spécialisation d’un modèle général au moyen d’un post-entraînement axé sur un domaine.
L’idée commune est simple : les connaissances juridiques ne suffisent pas. Un assistant utile doit organiser les documents sources, distinguer les faits des déductions, utiliser les outils de manière appropriée et produire un travail qu’un professionnel peut examiner. La version de GLM-Legal examinée ici apporte des éléments en faveur de cette approche, tout en laissant une marge importante d’amélioration pour la fiabilité des tâches complètes.
GLM-Legal est le modèle juridique spécialisé de Z.ai, construit sur GLM-5.3-Flash. L’annonce met l’accent sur des flux de travail d’agent tels que l’examen de contrats, l’analyse de preuves et la recherche en matière de conformité.
L’affirmation du rapport fourni concernant son classement porte sur une comparaison de modèles à poids ouverts selon des benchmarks précis. Les classements généraux comprennent également des systèmes propriétaires, et les classements de benchmark ne démontrent pas que le modèle convient à toutes les tâches juridiques.
Non. Le score de réussite complète de LAB mesure la proportion de tâches pour lesquelles tous les critères de notation requis ont été satisfaits. Le chiffre de 86,23 % sur LegalBench correspond à une mesure différente, issue d’une autre évaluation.
Z.ai indique avoir obtenu des résultats sur PLawBench, qui couvre la consultation juridique, l’analyse et la rédaction en droit chinois. Ces résultats correspondent au périmètre visé pour le droit chinois, mais chaque réponse doit tout de même être vérifiée au regard des faits applicables et du droit en vigueur.
Les documents examinés ne fournissent ni téléchargement vérifié du point de contrôle, ni licence, ni spécifications matérielles, ni procédure de déploiement Docker. Bien que Vals le classe parmi les modèles à poids ouverts, la voie de lancement officielle décrite ici consiste à demander l’accès à la bêta de l’API.
Dans son annonce, Z.ai présente l’intégration de GLM-Legal à AutoClaw comme une évolution à venir. Les exemples illustrent le flux de travail prévu, mais ne démontrent pas que l’accès est sans restriction pour tous les utilisateurs.
GLM-Legal associe un entraînement dans le domaine juridique à l’optimisation de flux de travail d’agent, et ses démonstrations mettent l’accent sur des livrables précis et vérifiables. Les résultats des benchmarks sont prometteurs au regard des comparaisons indiquées, tandis que le score strict de LAB met également en évidence l’écart de fiabilité qui reste à combler.
Utilisez la bêta et les résultats des benchmarks pour évaluer des flux de travail précis ; ne transformez pas une position dans un classement en affirmation générale de compétence juridique ou de disponibilité pour un déploiement.
Partez d’une phrase et obtenez un site complet en quelques minutes.



