For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/gpt-6-1-sol-500k-context-codex-usage-and-f5e586e1.md.
Les longues sessions de programmation accumulent bien plus que des messages de chat. Un agent a aussi besoin d’espace pour les fichiers sour...
Les longues sessions de programmation accumulent bien plus que des messages de chat. Un agent a aussi besoin d’espace pour les fichiers source, les sorties de commandes, les échecs de tests et les décisions prises plus tôt dans la tâche. Lorsque ce contexte de travail est plein, l’agent doit le condenser avant de pouvoir continuer.
Un rapport du média chinois d’actualité IA Xinzhiyuan, republié sur BAAI Hub, décrit une augmentation du contexte par défaut de GPT-6.1 Sol dans Codex et ChatGPT Work, passant de 272 K à 500 K tokens. Le rapport attribue l’annonce à Thibault Sottiaux d’OpenAI et indique que ce changement supprime un supplément distinct pour les contextes longs dans le cadre de l’usage par abonnement. Cette affirmation est plus précise que ce que suggère le titre initial, selon lequel la mise à niveau serait simplement « gratuite ».
La documentation officielle d’OpenAI confirme la disponibilité de GPT-6.1 Sol et explique la manière dont l’utilisation est comptabilisée. La modification exacte à 500 K et l’annonce concernant la suppression du supplément restent attribuées au rapport cité et à la capture d’écran de l’annonce ; les pages de documentation officielle consultées ne précisaient pas indépendamment cette nouvelle valeur par défaut.
Le passage de 272 000 à 500 000 tokens ajoute environ 84 % de capacité. La source arrondit cette hausse à environ 80 %. Sa capture d’écran de l’annonce mentionne également un contexte maximal d’un million de tokens et indique que les utilisateurs peuvent remplacer la valeur par défaut.
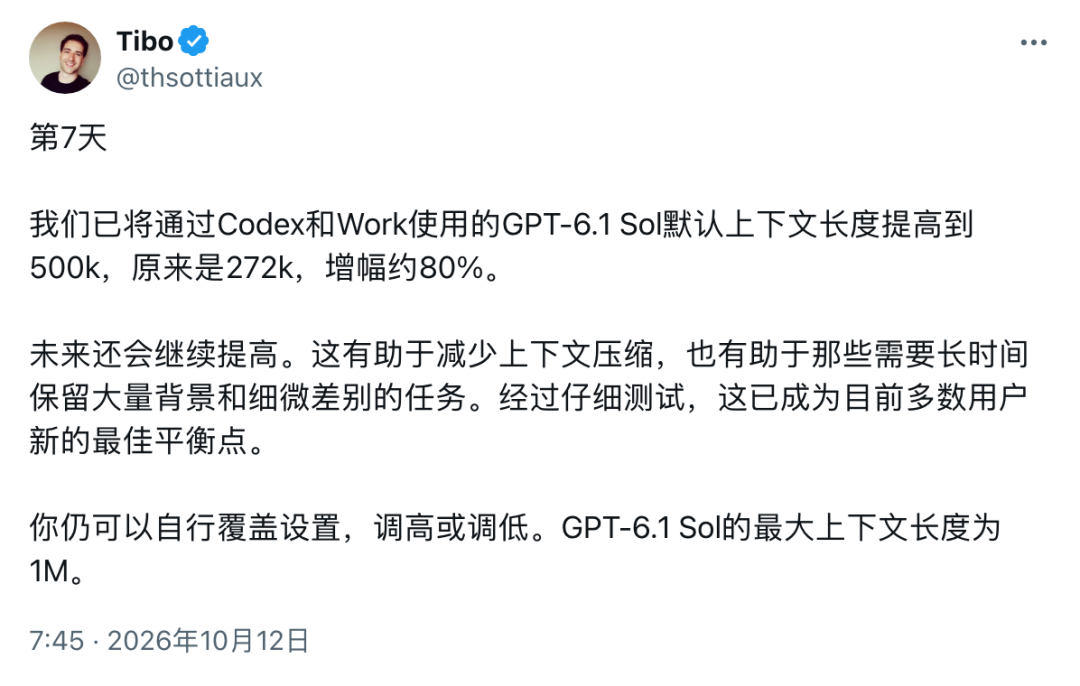
Source : une capture d’écran en chinois de l’annonce de Thibault Sottiaux, reproduite par Xinzhiyuan sur BAAI Hub ; la description en français est rédactionnelle.
L’avantage concret est de pouvoir conserver davantage d’historique de tâche disponible avant une compaction. Pour une modification dans un dépôt, cela peut inclure l’exigence de compatibilité initiale, les fichiers déjà examinés, les approches ayant échoué et les derniers résultats de tests.
Une fenêtre plus grande ne garantit pas qu’un agent retiendra chaque exigence ni qu’il effectuera des modifications correctes. Elle modifie la quantité d’informations qui peut rester dans son contexte actif, tandis que la qualité de ses décisions doit toujours être vérifiée.
La compaction remplace une partie de l’historique accumulé par une représentation plus courte. Elle permet à un agent de continuer à travailler sans conserver intégralement chaque ligne antérieure de sortie d’outil.
Le compromis est qu’un historique condensé peut perdre des détails utiles. Une tâche de programmation peut sembler terminée tout en oubliant une exigence antérieure, telle que la préservation de l’ancien format de réponse d’une API. Conserver davantage de contexte pertinent peut réduire la fréquence de ces transitions, sans toutefois supprimer la nécessité des tests de régression.
La référence de configuration d’OpenAI documente model_context_window et model_auto_compact_token_limit. Il s’agit de paramètres différents : le premier décrit le contexte disponible pour le modèle, tandis que le second détermine le moment où la compaction automatique est déclenchée. L’existence de ces paramètres ne prouve pas que chaque modèle ou compte prend en charge les mêmes valeurs.
La source distingue un supplément pour contexte long de la consommation habituelle d’un abonnement. Une tâche peut toujours utiliser un quota même lorsqu’aucun multiplicateur additionnel ne s’applique spécifiquement parce que son contexte est long.
La documentation officielle d’OpenAI sur la tarification confirme cette distinction générale. Elle indique que l’utilisation dépend du choix du modèle, du contexte, du raisonnement, de l’usage des outils, de la récupération et de la mise en cache. Les tâches longues qui conservent plus d’informations peuvent consommer sensiblement plus de quota que des requêtes courtes et ciblées.
| Concept | Ce qu’il décrit |
|---|---|
| Capacité de contexte | Quantité d’informations que le modèle peut conserver au cours d’une requête ou d’une session |
| Utilisation de l’abonnement | Manière dont une tâche consomme le quota ou les crédits inclus |
| Entrée mise en cache | Entrée déjà traitée qui peut être réutilisée à un tarif différent |
| Tarification de l’API | Frais distincts lorsque l’authentification et le paiement passent par une clé API |
Un court suivi, tel que « continue », peut déclencher une autre requête substantielle au modèle. L’agent peut avoir besoin des fichiers, exigences et résultats d’outils antérieurs pour décider de la suite. Une entrée mise en cache peut coûter moins cher à traiter, mais elle n’est pas nécessairement non comptabilisée.
La source décrit également une hausse antérieure à 372 K, qui aurait ensuite été annulée après une consommation des abonnements plus élevée que prévu. Cette information apporte un contexte utile à l’annonce, mais ne doit pas être interprétée comme une règle de facturation actuelle ni comme une promesse sur le coût d’une tâche individuelle.
La source compare la nouvelle valeur par défaut annoncée avec des configurations à un million de tokens dans Claude Code. Une comparaison utile exige davantage que le nombre le plus élevé affiché sur une fiche de modèle : les valeurs par défaut, les seuils de compaction, l’accès au compte, la tarification et le logiciel d’agent environnant peuvent tous différer.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Les limites précises de modèles Claude et le seuil de compression cités par la source n’ont pas été vérifiés indépendamment auprès de la documentation d’Anthropic pour cet article. Ils ne doivent donc pas être considérés comme une recommandation de configuration actuelle.
Pour le travail quotidien, examinez ensemble trois éléments :
Les recommandations officielles d’OpenAI concernant les modèles conditionnent également la disponibilité au forfait, au client, au déploiement progressif et aux paramètres de l’espace de travail. Une annonce de capacité ne donne pas accès à un modèle qui n’est pas disponible par ailleurs.
GPT-6.1 Sol est un modèle OpenAI documenté pour des travaux complexes sur le code, les applications et les documents. Les recommandations officielles le décrivent comme offrant des performances proches d’Astra à un coût inférieur, avec une disponibilité dépendant du forfait et du client de l’utilisateur.
Cela signifie que le modèle peut travailler avec un contexte mesuré à environ 500 000 tokens dans cette configuration. Les tokens englobent plus que le dernier message de l’utilisateur ; les fichiers, l’historique de la tâche, les sorties d’outils et les réponses peuvent tous avoir une incidence.
La source indique qu’il n’y a pas de supplément distinct pour contexte long dans l’usage par abonnement, ce qui est différent d’un accès illimité. La tâche consomme toujours le quota applicable, et l’accès à GPT-6.1 Sol dépend du forfait et du déploiement progressif.
Elle peut repousser la compaction en offrant davantage d’espace. Une session suffisamment longue peut toutefois atteindre sa limite, et le seuil de compaction configuré influence aussi le moment où la condensation intervient.
Non. OpenAI indique explicitement que les prix des tokens API sont distincts de l’utilisation par abonnement et ne doivent pas servir à estimer le nombre de tâches incluses.
Pas uniquement parce qu’un réglage plus élevé est mentionné dans un rapport. Vérifiez le modèle et la configuration pris en charge, puis comparez la qualité d’exécution, la latence et l’utilisation sur une tâche représentative avant de modifier votre configuration habituelle.
La valeur par défaut annoncée de 500 K donne à GPT-6.1 Sol davantage d’espace pour les fichiers, les exigences et l’historique de travail dans Codex et Work. Son bénéfice potentiel le plus clair est de réduire les interruptions dues à la compaction lors d’une tâche longue.
Une capacité de contexte plus élevée est utile, mais elle ne supprime ni les limites d’abonnement, ni les frais API, ni la nécessité de vérifier le résultat final.
Partez d’une phrase et obtenez un site complet en quelques minutes.



