For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/gpt-6-pro-parallel-agents-in-chatgpt-setu-69606eac.md.
La mise à jour GPT-6 Pro du 16 octobre pour ChatGPT ajoute un moyen de faire travailler plusieurs agents sur différentes parties d’une tâche...
La mise à jour GPT-6 Pro du 16 octobre pour ChatGPT ajoute un moyen de faire travailler plusieurs agents sur différentes parties d’une tâche. Les utilisateurs peuvent suivre leur progression dans la conversation et ouvrir les tâches terminées pour examiner ce que chaque agent a produit.
OpenAI annonce également des réponses plus rapides ainsi qu’une meilleure utilisation des plugins et des outils. L’entreprise ne publie toutefois pas, dans cette annonce, de mesure chiffrée de l’accélération, de nombre maximal d’agents ni d’explication complète sur la fusion des résultats.
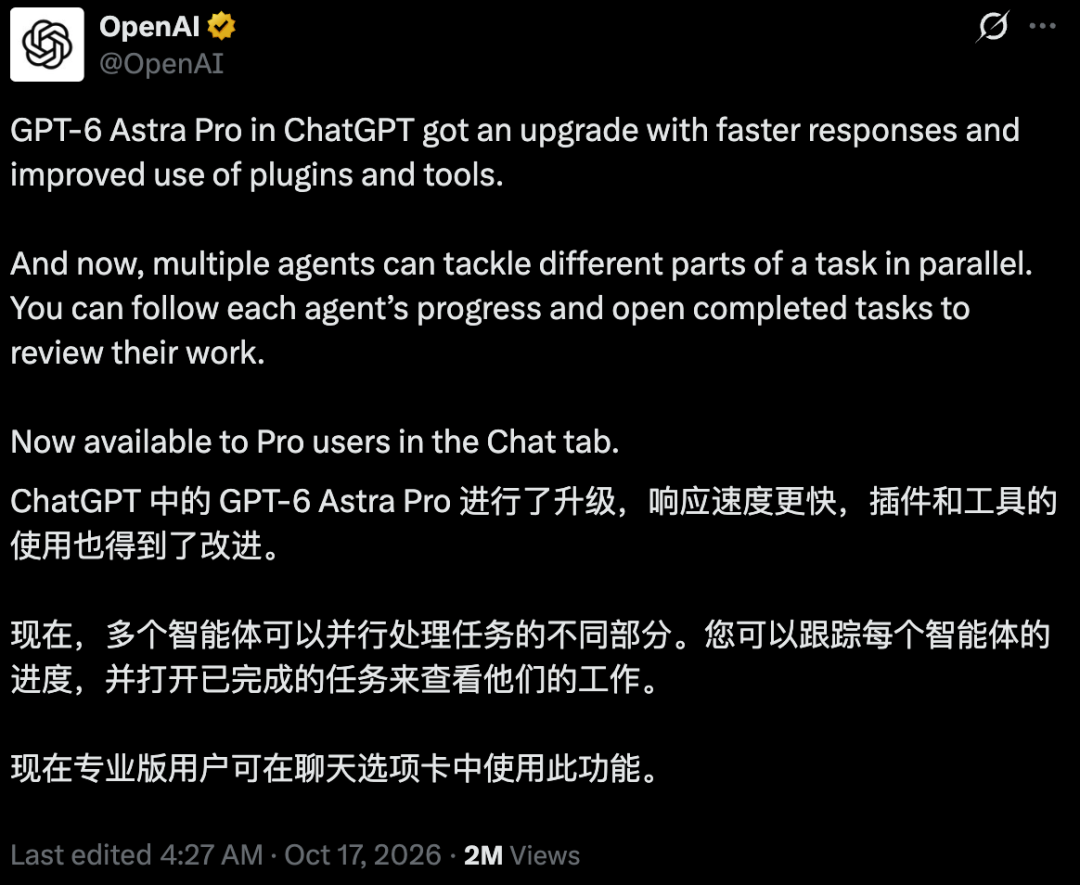
La mise à jour est progressivement déployée auprès des utilisateurs Pro éligibles. La disponibilité dans les espaces de travail administrés dépend des paramètres et de l’éligibilité au déploiement. Le fait de disposer de plusieurs agents ne signifie pas que chaque tâche sera terminée plus rapidement : les utilisateurs doivent toujours évaluer le résultat combiné.
La source décrit le parcours de sélection suivant :
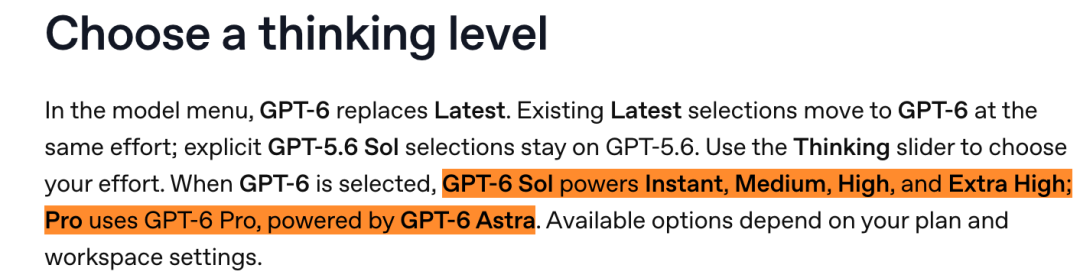
Pour GPT-6, les niveaux Instant à Extra High utilisent Sol, tandis que le niveau Pro utilise GPT-6 Pro, propulsé par Astra. Les paramètres disponibles dépendent de l’offre et de l’accès de l’espace de travail. L’annonce de la mise à jour ne précise pas de syntaxe de prompt garantissant un nombre particulier d’agents.
Le premier concerne la vitesse des réponses. « Plus rapide » est l’amélioration annoncée ; la source ne fournit pas de mesure contrôlée du temps d’exécution avant et après la mise à jour.
Le deuxième concerne l’utilisation des outils. Un modèle doit souvent effectuer des recherches, examiner des fichiers ou interagir avec un service externe pour terminer une tâche. Une meilleure gestion des outils pourrait réduire les appels échoués et les boucles bloquées, mais les plaintes individuelles concernant les boucles ne permettent pas de mesurer l’efficacité de la mise à jour.
Les services externes nécessitent toujours la connexion au compte concerné et les autorisations appropriées. La délégation n’autorise pas à elle seule l’accès à un nouveau système.
Le troisième changement concerne le travail en parallèle. Une comparaison de trois produits peut être divisée en recherches indépendantes avant d’aligner les résultats sur les prix, les fonctionnalités et les restrictions. En revanche, la lecture d’un document, le choix d’une offre à partir de ce document et la modification d’un fichier selon ce choix sont des étapes dépendantes.
La source présente l’exemple d’un utilisateur qui mène une recherche aboutissant à un document de spécifications produit et à des tickets de tâche. Il s’agit d’un flux de travail potentiellement utile : un livrable devient l’entrée de l’étape suivante.
D’autres utilisateurs soulignent le coût de gestion. Si chaque agent renvoie un rapport long et formaté différemment, l’utilisateur peut passer le temps d’attente économisé à réconcilier les résultats. Les indicateurs de progression révèlent l’activité, mais ne prouvent pas que le travail est correct.
Avant de commencer, définissez ce que signifie l’achèvement : les questions auxquelles il faut répondre, la période concernée, les sources nécessaires et le format du livrable. Un résultat qui relie les éléments de preuve aux conclusions est plus facile à examiner qu’un résultat qui se contente de déclarer la réussite.
Le rapport compare ensuite la mise à jour au système Research d’Anthropic. Le compte rendu technique publié par Anthropic en juin 2025 décrit un orchestrateur qui planifie la recherche, délègue les recherches indépendantes et synthétise les résultats reçus, avec une étape distincte consacrée aux citations.
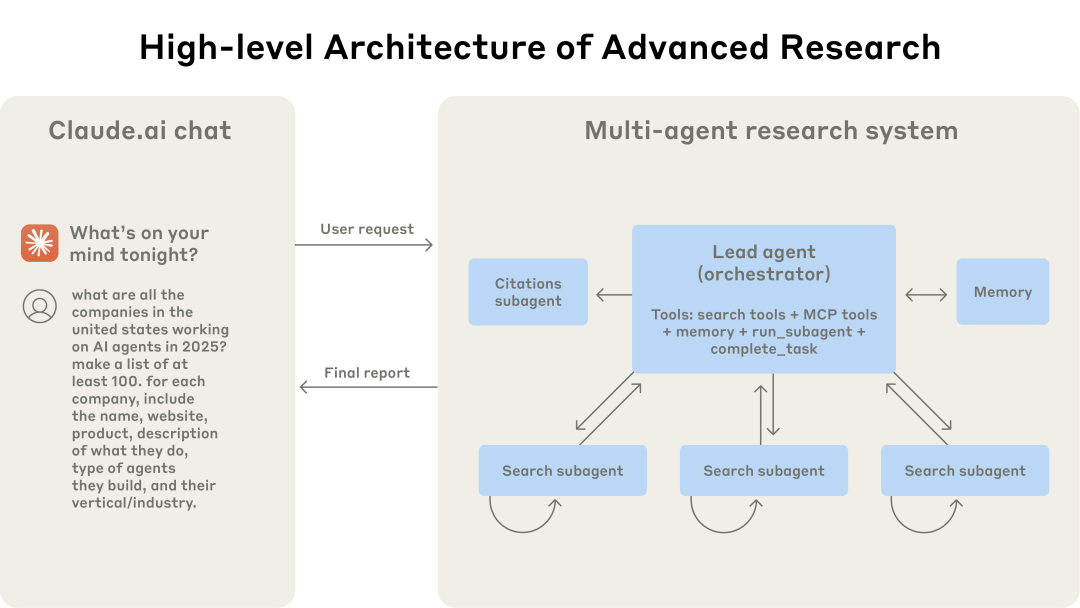
Cette conception est particulièrement utile pour les questions larges comportant plusieurs axes de recherche indépendants. Anthropic souligne également que l’utilisation d’un plus grand nombre d’agents consomme davantage de tokens et que les travaux étroitement dépendants peuvent ne pas être adaptés à cette approche.
La source étend cette comparaison à Claude Code Projects et aux flux de travail dynamiques Managed Agents. Elle cite une démonstration de recherche de bugs menée par l’entreprise sur 116 000 lignes de code contenant 70 bugs introduits : les exécutions avec un seul agent en ont trouvé respectivement 14, 15 et 27, tandis que les exécutions avec un flux de travail dynamique en ont trouvé 66 à chaque fois. Il s’agit de résultats rapportés pour cette configuration, et non d’une garantie générale ni d’une comparaison directe avec la nouvelle fonctionnalité de ChatGPT.
Les différents systèmes exposent des moyens distincts de déléguer les tâches, de conserver le contexte d’un projet et d’exécuter du travail en arrière-plan. Le fait qu’ils utilisent tous plusieurs agents ne rend pas identiques leur accès, leurs autorisations ou leur comportement à l’exécution.
Anthropic décrit un échec précoce de la délégation au cours duquel deux agents ont étudié des informations actuelles qui se recoupaient, tandis qu’un autre examinait une année différente. Le problème venait de limites de tâches insuffisamment précises.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Un brief de délégation utile précise l’objectif, les sources, le périmètre et le format de sortie. Il indique également à chaque agent ce qui relève d’un autre intervenant. Sans ces limites, l’activité parallèle peut dupliquer les recherches et laisser d’importantes lacunes.
La fusion exige le même niveau de rigueur. Les prix des produits doivent utiliser des périodes de facturation et des dates cohérentes ; les conclusions de recherche doivent distinguer les éléments de preuve contradictoires ; les modifications de code doivent respecter les mêmes interfaces et conventions de nommage. Deux agents qui modifient le même fichier peuvent créer des conflits, même si chacune des modifications semble pertinente prise isolément.
Les petites tâches ne justifient pas toujours le coût de configuration et de transmission. Une approche séquentielle est souvent appropriée lorsque le travail dépend de décisions antérieures ou lorsque les ressources, comme les onglets du navigateur, doivent être limitées.
Le rapport distingue l’accès à Astra dans Work ou Codex de l’accès à GPT-6 Pro dans Chat. L’accès Plus à Astra dans d’autres expériences ne suffit pas à établir l’éligibilité à cette fonctionnalité de Chat.
Il distingue également les quotas des modèles Pro dans Chat du pool d’utilisation de Work et Codex. Les informations d’aide reproduites décrivent une limite hebdomadaire pour GPT-6 Pro avec Pro à 200 $ et un quota hebdomadaire partagé pour les modèles Pro avec Pro à 100 $. Ces règles sont susceptibles d’évoluer ; consultez l’article officiel consacré aux modèles et la notification affichée sur votre compte avant de planifier une charge de travail.
Une anecdote concernant une baisse soudaine du quota Codex ne permet pas d’établir comment le travail d’agents parallèles dans Chat est décompté. L’annonce ne fournit aucune formule de facturation par agent. De même, un abonnement Pro payant ne doit pas être interprété comme un accès illimité à tous les modèles Pro.
La comparaison utile porte sur l’effort total nécessaire pour obtenir un résultat acceptable. Prenez en compte la coordination, les appels répétés aux outils, la consommation de ressources et le temps qu’une personne doit consacrer à corriger les omissions ou les incohérences.
Pour une recherche, vérifiez la couverture des éléments de preuve et la concordance entre les conclusions et ces éléments. Pour du code, examinez le comportement et exécutez les contrôles appropriés. La tâche est terminée lorsque le résultat répond à ses exigences, et non simplement lorsque chaque agent affiche un statut terminé.
Elle permet à plusieurs agents de traiter différentes parties d’une tâche tout en laissant la progression visible dans la conversation. Les tâches terminées peuvent être ouvertes pour inspection.
Dans un compte éligible, sélectionnez GPT-6 dans Chat et choisissez Pro avec le curseur Thinking. Si l’option n’apparaît pas, l’accès lié à l’offre, les paramètres de l’espace de travail ou le déploiement progressif peuvent l’expliquer.
Les axes de recherche indépendants peuvent bénéficier d’un travail simultané. Les étapes dépendantes, les petites tâches et les modifications de fichiers partagés peuvent entraîner un coût de coordination supérieur au temps économisé.
L’annonce de la mise à jour examinée ne précise pas de maximum. Elle ne publie pas non plus de règles garantissant le nombre d’agents déclenchés par une demande donnée.
La source et l’aide associée aux modèles décrivent les quotas applicables. Les utilisateurs doivent consulter l’avis de limite correspondant à l’expérience utilisée au lieu de supposer que Chat, Work et Codex appliquent des quotas identiques.
Un statut terminé signifie que la tâche a renvoyé un résultat. Les sources, les fichiers et les conclusions doivent tout de même être validés par rapport aux exigences, en particulier lorsque plusieurs résultats doivent être combinés.
La mise à jour de GPT-6 Pro associe le travail en parallèle à une progression visible et à des résultats inspectables. Elle annonce également des améliorations de la vitesse des réponses et de l’utilisation des outils, sans publier de ventilation complète des performances ou de la facturation.
Une bonne délégation réduit le temps d’attente uniquement lorsque les résultats sont exacts, compatibles et rapides à vérifier.
Partez d’une phrase et obtenez un site complet en quelques minutes.



