For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/gpt-6-speed-boost-astra-and-6-1-sol-gain-90356630.md.
OpenAI a lancé une série de 28 jours d’améliorations produit avec un changement que les utilisateurs peuvent ressentir immédiatement : **GPT...
OpenAI a lancé une série de 28 jours d’améliorations produit avec un changement que les utilisateurs peuvent ressentir immédiatement : GPT-6 Astra et GPT-6.1 Sol sont désormais environ 50 % plus rapides par défaut lorsqu’ils sont utilisés via des abonnements ChatGPT éligibles.
L’amélioration s’applique aux produits OpenAI et aux outils partenaires qui prennent en charge Sign in with ChatGPT, notamment OpenCode, Pi, Amp et Devin.
Aucune modification du code n’est requise.
Le responsable ingénierie d’OpenAI, Thibault « Tibo » Sottiaux, a déclaré que la vitesse par défaut des abonnements avait été optimisée d’environ 50 %. Des mesures réalisées par la communauté situent le gain pratique entre environ 30 jetons par seconde et environ 50 jetons par seconde, bien que le débit exact varie selon le modèle, la tâche, le produit et les conditions d’exécution.
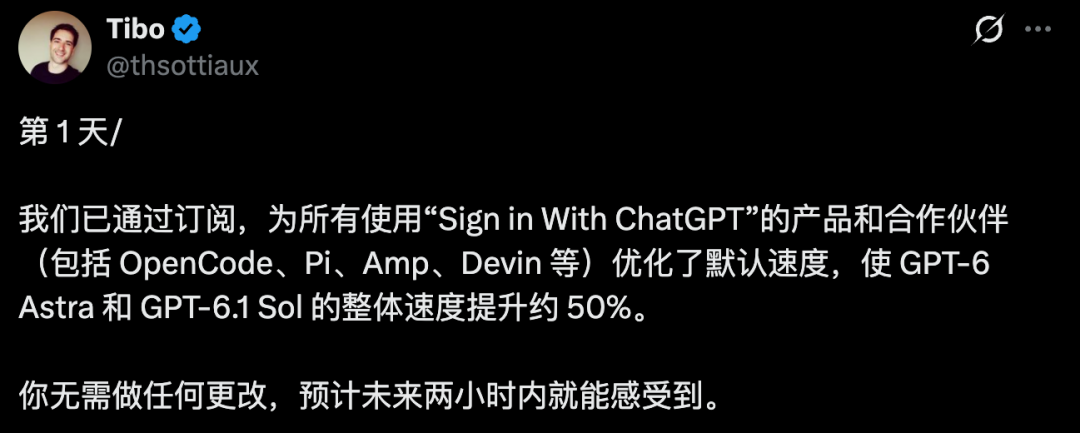
L’annonce de Tibo au premier jour indique que GPT-6 Astra et GPT-6.1 Sol sont environ 50 % plus rapides via l’accès par abonnement.
Le calendrier est notable, car une autre discussion se déroule simultanément.
SemiAnalysis a publié une étude détaillée de test des limites comparant les abonnements grand public à l’IA. Selon ses hypothèses concernant les charges de travail agentiques, les abonnements Claude Opus 5.5 offrent plus de cinq fois la valeur équivalente API des formules GPT-6.1 Sol au même prix mensuel.
OpenAI a donc accéléré les modèles.
La question plus difficile est de savoir si l’économie des abonnements reste compétitive pour les utilisateurs qui exécutent de longs flux de travail autonomes de programmation et d’agents.
La première mise à jour du programme de livraisons sur 28 jours d’OpenAI cible l’une des sources de friction les plus évidentes dans les tâches avancées de programmation et d’agents : la latence de génération.
Tibo a écrit qu’OpenAI avait optimisé d’environ 50 % la vitesse par défaut de GPT-6 Astra et GPT-6.1 Sol via l’accès par abonnement.
Le déploiement s’applique :
L’utilisateur n’a pas besoin de modifier une configuration ni de changer de point de terminaison API.
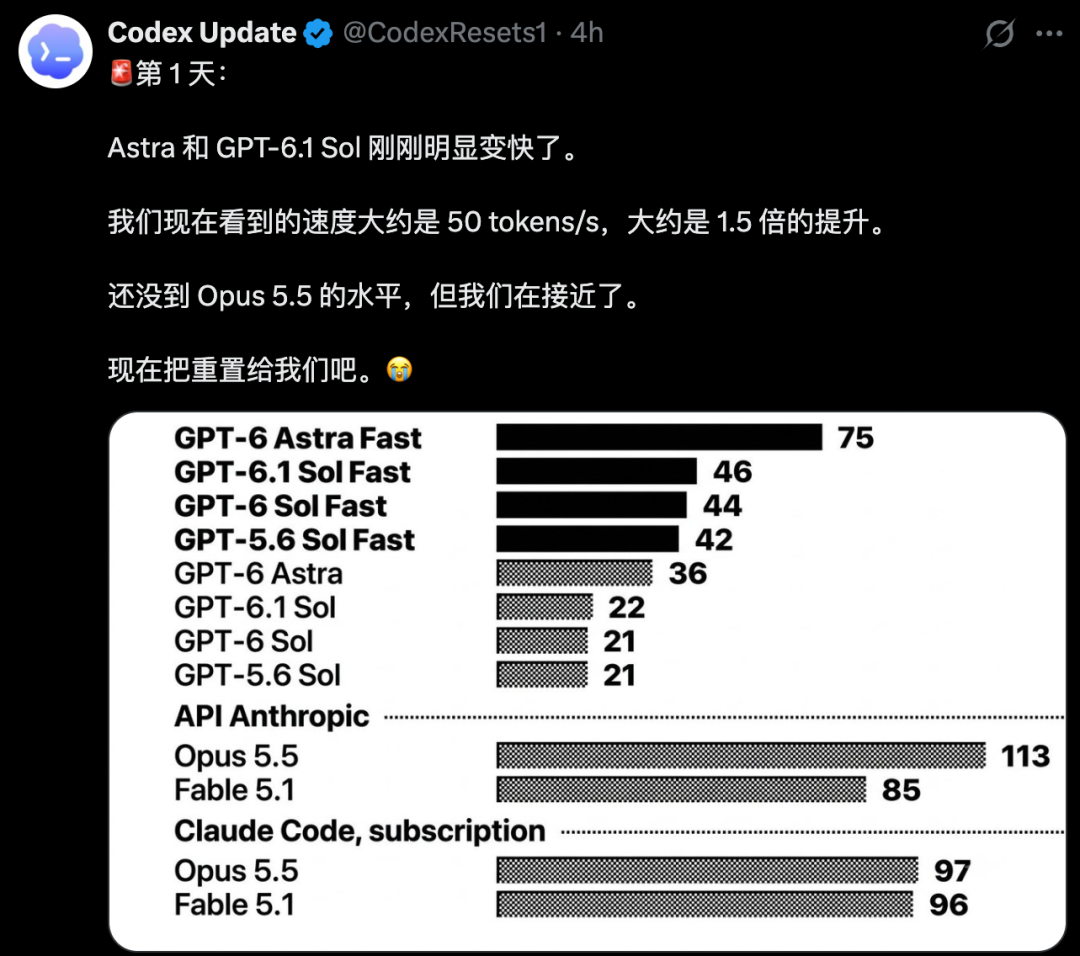
Les mesures de la communauté montrent une augmentation visible de la vitesse, bien que le débit diffère selon le modèle et le chemin d’accès.
L’article source résume le changement comme un passage approximatif de :
~30 jetons/seconde
        ↓
~50 jetons/seconde
C’est un raccourci utile, mais l’annonce officielle est formulée comme « environ 50 % plus rapide », et non comme un niveau de service fixe garanti de 50 TPS.
Différents testeurs peuvent constater des valeurs différentes.
L’amélioration de vitesse est la première entrée d’une initiative plus large sur 28 jours.
Tibo a déclaré qu’au cours des 28 jours suivants, OpenAI prévoyait de livrer soit :
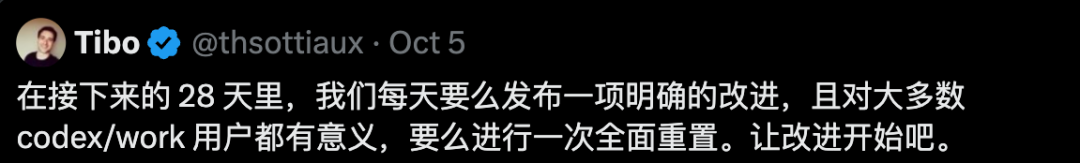
L’initiative sur 28 jours se concentre sur la simplification, l’efficacité, de nouvelles capacités et des améliorations des modèles.
Les priorités annoncées sont les suivantes :
Le message vise particulièrement les utilisateurs de Codex et de Work, pour lesquels les tâches de longue durée rendent la vitesse et les limites d’utilisation bien plus visibles que dans une courte conversation.
L’article original affirme que le changement provenait en partie d’un tokenizer optimisé « agressif » qui réduit le nombre de jetons nécessaires pour une même tâche.
Cette affirmation précise doit être traitée avec prudence.
Les déclarations publiques des équipes d’OpenAI examinées pour cet article décrivent la mise à jour du premier jour comme une optimisation de l’inférence et une amélioration de la vitesse par défaut.
Elles ne documentent pas publiquement le déploiement d’un nouveau tokenizer pour GPT-6 Astra ou GPT-6.1 Sol comme mécanisme à l’origine de ce gain particulier de 50 %.
Cette distinction est importante.
Il existe plusieurs façons d’améliorer le débit perçu :
En l’absence d’une note technique officielle, il est plus prudent d’affirmer qu’OpenAI a optimisé l’inférence plutôt que d’attribuer l’amélioration à une architecture de tokenizer précise.
Une amélioration de 50 % de la vitesse de génération du modèle ne signifie pas que chaque tâche complète se terminera 50 % plus tôt.
Les flux de travail d’agents consacrent du temps à bien plus que la génération de jetons.
Une tâche de programmation typique peut inclure :
Raisonnement du modèle
      ↓
Appel d’outil
      ↓
Commande shell ou action dans le navigateur
      ↓
Lecture/écriture de fichiers
      ↓
Attente réseau
      ↓
Nouveau tour de modèle
Si les outils, les sites web, les compilations, les tests ou les API externes dominent le temps écoulé, une génération de jetons plus rapide peut ne réduire qu’une partie de la durée totale de la tâche.
L’article source note également que certains développeurs n’ont pas immédiatement perçu une différence spectaculaire.
C’est plausible.
La vitesse perçue dépend :
La mise à jour est réelle, mais elle ne doit pas être interprétée comme une garantie universelle que chaque tâche de bout en bout se terminera en deux tiers du temps précédent.
La même semaine, SemiAnalysis a publié une comparaison détaillée des limites d’abonnements IA.
Les chercheurs ont acheté des formules d’abonnement, exécuté des charges de travail contrôlées jusqu’au mouvement des compteurs d’utilisation ou jusqu’à l’atteinte des limites, puis converti ces limites en valeur monétaire équivalente API.
Leur méthodologie mesure séparément :
Ils combinent ensuite ces tarifs au moyen d’une charge de travail agentique représentative.
SemiAnalysis a testé les limites d’abonnement chez OpenAI, Anthropic et plusieurs autres fournisseurs d’IA.
La comparaison clé de l’article source oppose GPT-6.1 Sol à Claude Opus 5.5.
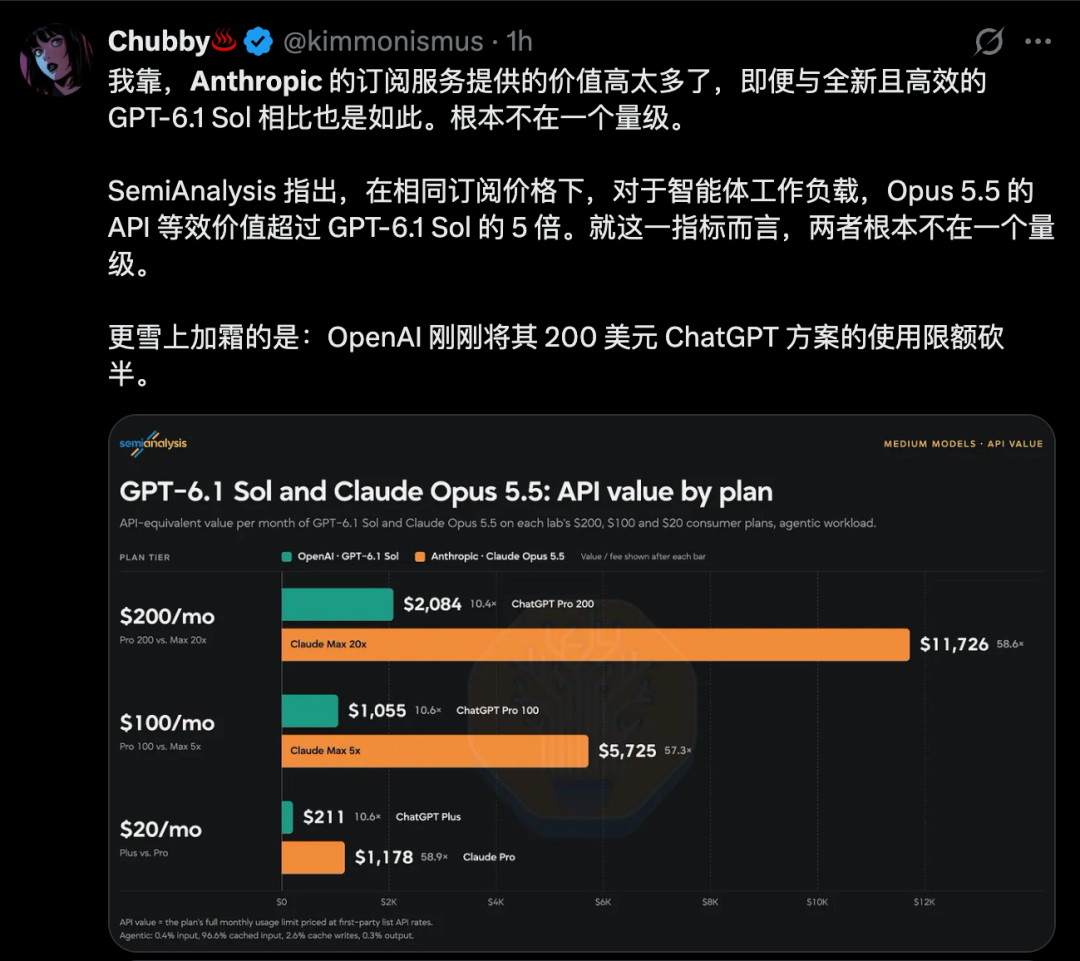
SemiAnalysis estime un avantage supérieur à cinq fois pour Claude Opus 5.5 selon ses hypothèses de charge de travail agentique.
Le graphique publié fournit l’aperçu suivant :
| Formule mensuelle | OpenAI / GPT-6.1 Sol | Anthropic / Claude Opus 5.5 | Ratio approximatif |
|---|---|---|---|
| 200 $ | 2 084 $ de valeur équivalente API | 11 726 $ | 5,6× |
| 100 $ | 1 055 $ | 5 725 $ | 5,4× |
| 20 $ | 211 $ | 1 178 $ | 5,6× |
Ces chiffres ne signifient pas qu’un abonnement Anthropic à 200 $ verse littéralement 11 726 $ au client.
Ils signifient que, selon les limites mesurées par SemiAnalysis et le mélange de charges de travail supposé, consommer la même quantité par les prix API publiés coûterait théoriquement ce montant.
Une visualisation communautaire du niveau à 200 $ rend la différence plus facile à observer.
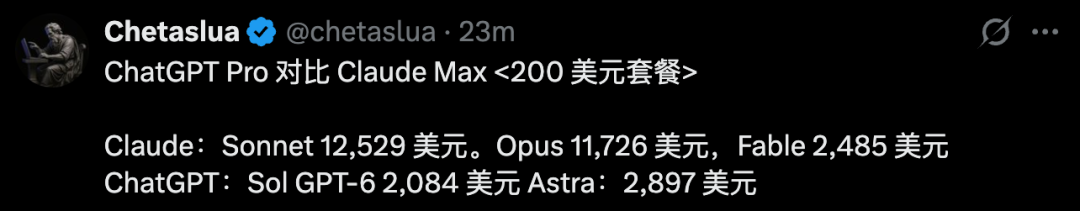
La comparaison à 200 $ varie considérablement selon le modèle utilisé.
La nuance importante est le choix du modèle.
SemiAnalysis avertit explicitement que la valeur d’un abonnement ne peut pas être résumée par un chiffre universel unique.
L’unité correcte se rapproche davantage de :
(formule, modèle, charge de travail)
Un abonnement peut sembler extrêmement généreux pour un modèle et beaucoup moins pour un autre.
SemiAnalysis indique qu’OpenAI a apporté une modification majeure à ses abonnements peu avant la publication du rapport.
Les tests de l’entreprise ont confirmé une réduction d’environ 50 % des limites de jetons de la formule OpenAI à 200 $ pour les nouveaux abonnements achetés.
Les anciennes formules à 200 $ ont temporairement bénéficié des limites précédentes jusqu’au 29 octobre.
SemiAnalysis note également qu’OpenAI a introduit un nouveau niveau à 500 $.
L’article rapporte que le niveau à 200 $ avait autrefois offert une valeur inhabituellement généreuse, notamment pour les utilisateurs intensifs de Codex.
Après la réduction, l’économie de jetons par dollar des niveaux Pro 100, Pro 200 et Pro 500 d’OpenAI est devenue bien plus similaire.
C’est l’une des raisons pour lesquelles la comparaison avec Anthropic paraît si spectaculaire.
L’usage conversationnel traditionnel est irrégulier.
Une personne pose une question, lit la réponse, réfléchit et revient plus tard.
La programmation agentique peut se comporter très différemment.
Une seule tâche peut :
Cela génère bien davantage d’activité de modèle qu’un court échange conversationnel.
SemiAnalysis soutient que les formules d’abonnement sont fortement subventionnées, car la plupart des utilisateurs ne consomment pas leur allocation théorique maximale.
Les utilisateurs intensifs d’agents mettent cette hypothèse à l’épreuve.
L’article source décrit cela comme un passage de « la plupart des utilisateurs n’utilisent pas leur quota complet » à des flux de travail capables de consommer de très grandes quantités d’inférence.
Cette orientation est cohérente avec l’analyse plus large de SemiAnalysis, même si l’utilisation exacte au seuil de rentabilité dépend d’hypothèses concernant les coûts des modèles, les marges API, le mélange de charges de travail et l’économie interne du fournisseur.
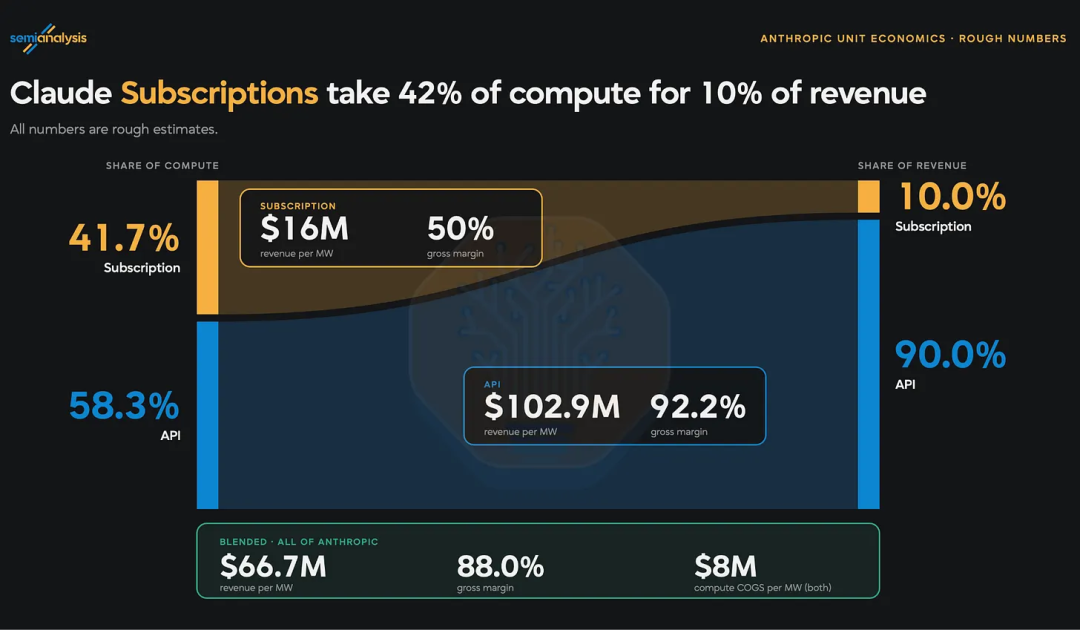
SemiAnalysis a également publié un modèle approximatif de l’économie des abonnements Anthropic.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
SemiAnalysis estime que les abonnements peuvent consommer une part bien plus importante du calcul d’inférence que leur part du chiffre d’affaires.
Ses chiffres approximatifs suggèrent que les abonnements peuvent représenter seulement environ 10 % du chiffre d’affaires tout en consommant plus de 40 % du calcul d’inférence.
Il s’agit d’estimations de modélisation, et non d’états financiers audités d’Anthropic.
Elles sont utiles, car elles expliquent la tension qui sous-tend les limites d’abonnement.
Les entreprises d’IA souhaitent rendre les produits par abonnement suffisamment attractifs pour attirer des utilisateurs, tout en empêchant les charges de travail agentiques les plus lourdes de consommer une inférence coûteuse sans limite.
Plus les agents deviennent autonomes, plus cet équilibre est difficile à maintenir.
L’article original passe ensuite de la vitesse des modèles et de l’économie des abonnements à un récit produit plus large.
Il cite une publication communautaire affirmant que Chat, Work, Codex et Dots finiront par fusionner dans une interface unique de super-application, avec des sélecteurs de modèles et des contrôles de raisonnement cachés aux utilisateurs.
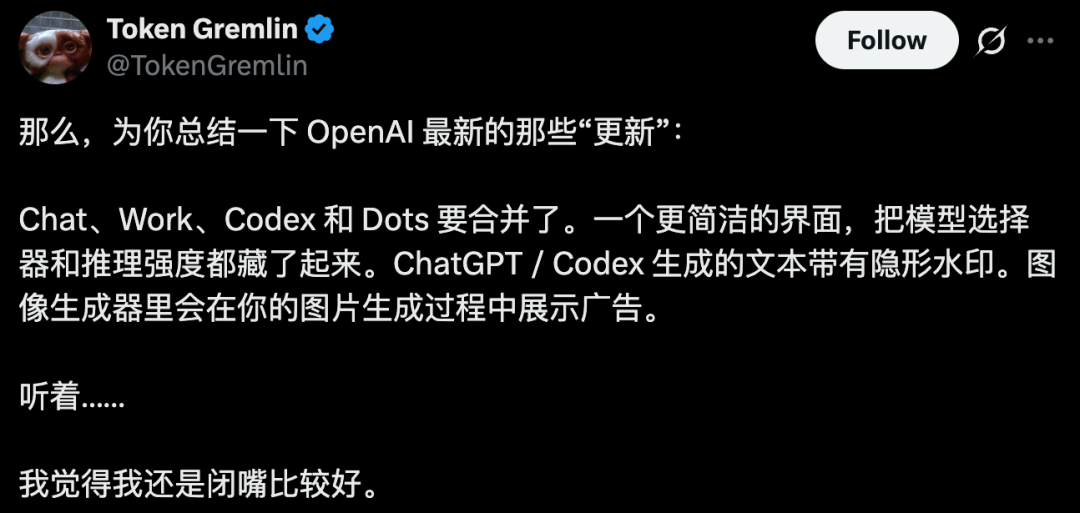
Cette publication résume des affirmations de la communauté sur une future convergence produit ; toutes ne sont pas officielles.
Cette section exige une séparation claire entre les rumeurs et la réalité actuelle du produit.
Le centre d’aide actuel d’OpenAI indique que :
L’idée d’une interface entièrement fusionnée réunissant Chat + Work + Codex + Dots n’est donc pas un état actuel du produit annoncé.
OpenAI simplifie clairement l’expérience, mais l’affirmation plus catégorique de l’article source selon laquelle « tout fusionne » relève de l’interprétation communautaire, et non d’une feuille de route publiée par OpenAI.
L’orientation officielle du produit reste significative.
OpenAI décrit désormais ChatGPT comme comprenant à la fois :
Les projets peuvent fournir un contexte partagé aux deux modes.
Work peut également :
Cela signifie que le produit s’éloigne déjà d’un monde où chaque capacité vit dans une application distincte.
La consolidation est réelle.
Sa forme finale exacte n’est pas encore publique.
L’article source laisse entendre que Codex pourrait disparaître dans une interface unifiée.
La documentation actuelle dit le contraire.
Codex reste dédié au développement logiciel et au travail technique.
Sur ordinateur, les utilisateurs basculent entre ChatGPT et Codex depuis le menu en haut à gauche.
Codex conserve ses propres flux de travail et son historique orientés développement.
Cela pourrait changer ultérieurement, mais aucune source officielle examinée pour cet article n’indique que Codex est supprimé en tant qu’expérience distincte.
Dots représentent une autre composante de la stratégie produit d’OpenAI.
Un dot est un agent toujours actif propulsé par GPT-6 Astra.
Il dispose :
Un dot peut aussi fonctionner via des canaux de messagerie et, avec autorisation, se connecter à l’ordinateur local d’un utilisateur.
Cela rapproche Dots d’un assistant persistant ou d’un collaborateur délégué plutôt que d’une session de chat normale.
Cela aide également à comprendre pourquoi les utilisateurs et observateurs s’attendent à ce que les frontières entre produits s’estompent avec le temps.
Chat, Work, Codex et Dots partagent de plus en plus des modèles, des outils, des fichiers, des autorisations et une infrastructure d’agents.
Mais une infrastructure partagée n’équivaut pas à une fusion confirmée dans une interface unique.
L’article source indique également que les textes générés par ChatGPT et Codex recevront des filigranes invisibles.
Cette affirmation est partiellement correcte, mais sa portée est bien plus limitée que ne le suggère la formulation originale.
OpenAI a officiellement annoncé un système de provenance textuelle appelé textGrain.
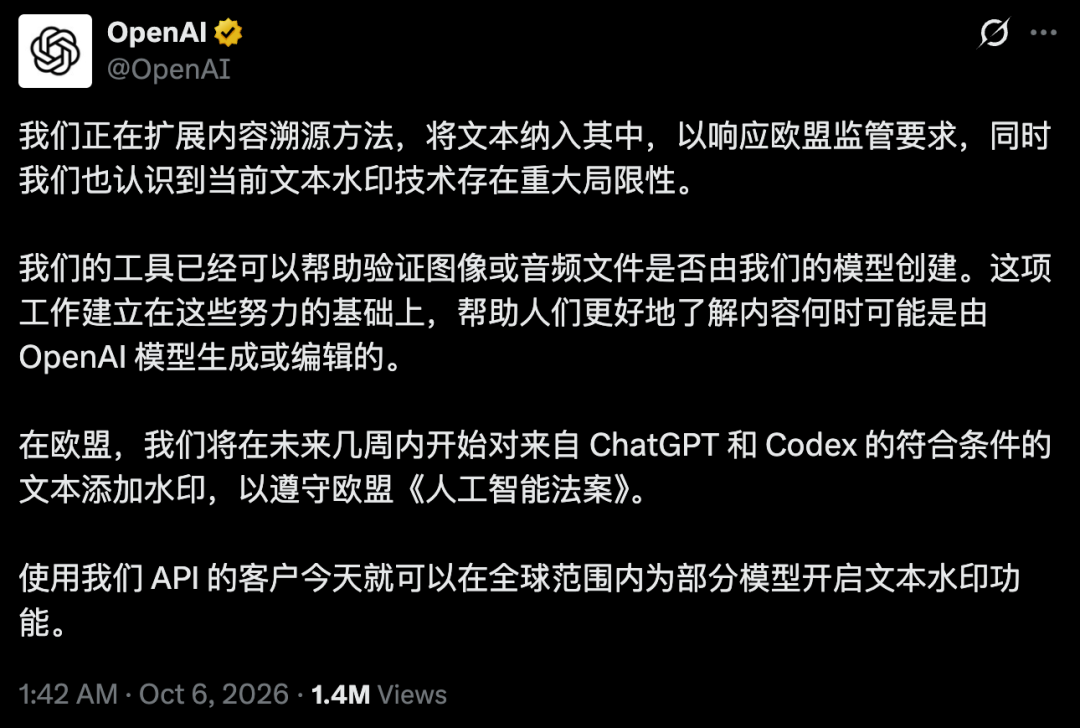
OpenAI introduit le filigrane textuel en réponse aux exigences de provenance de l’AI Act de l’Union européenne.
La politique actuelle est la suivante :
Il n’est donc pas exact d’affirmer que tous les textes de ChatGPT et Codex partout dans le monde sont obligatoirement filigranés.
OpenAI indique que textGrain n’insère pas de caractères cachés ni d’espaces invisibles.
À la place, il modifie subtilement le schéma de probabilité utilisé pour choisir les mots ou fragments de mots.
Sur un passage suffisamment long, un détecteur peut rechercher ce signal statistique.
Cette approche comporte des limites importantes.
La paraphrase, la traduction, une édition lourde ou un texte très court peuvent affaiblir le signal.
L’absence de filigrane ne prouve pas non plus qu’un humain a rédigé le texte.
OpenAI insiste elle-même sur ces limites.
La publicité constitue une autre partie de l’évolution du produit, et cet élément est officiel.
Le 5 octobre, OpenAI a annoncé un nouveau format de publicité visuelle dans ChatGPT.
L’entreprise indique qu’elle testera initialement ce format pendant la génération d’images.
Le premier déploiement est limité :
Les publicités sont étiquetées et restent séparées de l’image générée.
OpenAI indique également que la publicité n’influence pas les réponses de ChatGPT.
C’est plus précis que d’affirmer que « les utilisateurs verront des publicités en attendant la génération d’images » dans toutes les circonstances.
Il s’agit d’un test limité, lié à la formule, à la géographie et à l’état du déploiement.
L’article combine plusieurs évolutions réelles survenues à peu d’intervalle.
La manière la plus claire de les distinguer est la suivante :
| Affirmation | Statut |
|---|---|
| La vitesse par défaut des abonnements pour GPT-6 Astra et GPT-6.1 Sol a augmenté d’environ 50 % | Confirmé |
| L’amélioration s’applique aux produits OpenAI et aux partenaires utilisant Sign in with ChatGPT | Confirmé |
| Les utilisateurs doivent modifier leur code ou leurs paramètres | Non ; l’annonce officielle indique qu’aucun changement n’est nécessaire |
| Le débit par défaut est garanti à exactement 50 TPS | Non garanti ; 50 TPS est un chiffre observé ou résumé utile |
| L’accélération vient d’un nouveau tokenizer agressif | Non confirmé publiquement dans les sources officielles examinées |
| SemiAnalysis a mesuré une valeur équivalente API supérieure à 5× pour Opus 5.5 face à GPT-6.1 Sol | Confirmé pour sa méthodologie déclarée de charge de travail agentique |
| OpenAI a réduit d’environ moitié les limites des nouvelles formules à 200 $ | Confirmé par les tests de SemiAnalysis et l’annonce citée |
| Chat, Work, Codex et Dots fusionnent officiellement dans une interface unique | Non confirmé |
| La sélection de modèles est entièrement supprimée | Non confirmé ; les documents actuels de Work/Codex décrivent toujours la sélection de modèles |
| Tous les textes ChatGPT/Codex dans le monde seront filigranés | Faux en tant qu’affirmation mondiale |
| Les textes ChatGPT/Codex éligibles dans l’Union européenne recevront un filigrane invisible | Confirmé |
| Les clients API peuvent choisir d’activer le filigrane textuel | Confirmé |
| Des publicités seront testées pendant la génération d’images | Confirmé |
| Les publicités de génération d’images ciblent initialement les utilisateurs Free/Go aux États-Unis | Confirmé |
Cette distinction rend l’article original plus utile.
La véritable mise à jour est déjà substantielle, sans transformer chaque rumeur produit en feuille de route établie.
Oui. Le responsable ingénierie d’OpenAI, Tibo Sottiaux, a déclaré que GPT-6 Astra et GPT-6.1 Sol avaient été optimisés afin d’être environ 50 % plus rapides par défaut via un accès éligible par abonnement.
Aucune garantie fixe de 50 TPS n’a été annoncée. Les mesures et résumés communautaires utilisent environ 30 à 50 TPS pour illustrer le changement, mais le débit réel varie selon le modèle, la tâche, le produit et les conditions d’exécution.
L’annonce du premier jour décrit spécifiquement l’accès par abonnement sur les produits OpenAI et les partenaires utilisant Sign in with ChatGPT. Elle ne doit pas être généralisée en une affirmation selon laquelle tout le trafic API a reçu le même changement.
SemiAnalysis a mesuré les limites d’abonnement et les a converties en valeur théorique équivalente API au moyen d’une charge de travail agentique représentative. Pour Claude Opus 5.5 face à GPT-6.1 Sol, son instantané d’octobre affichait environ 5,4× à 5,6× davantage de valeur équivalente API pour des niveaux comparables de 20 $, 100 $ et 200 $.
OpenAI simplifie et connecte ces expériences, mais aucune annonce officielle n’indique que les quatre deviennent une interface unique identique. La documentation actuelle traite encore Codex comme une vue de développement séparée et Dots comme une capacité d’agent toujours actif.
Non. OpenAI indique que les textes ChatGPT et Codex éligibles dans l’Union européenne recevront un filigrane invisible textGrain, tandis que les clients API du monde entier peuvent choisir d’activer cette fonction pour certains modèles. Le filigrane API est désactivé par défaut.
OpenAI a annoncé un test de publicités visuelles pendant la génération d’images pour les utilisateurs Free et Go aux États-Unis. Le test initial commence plus tard en octobre 2026, et les publicités restent étiquetées et séparées des images générées.
Tibo a annoncé une période de 28 jours au cours de laquelle l’équipe prévoit de livrer chaque jour une amélioration claire pertinente pour la plupart des utilisateurs de Codex/Work ou une réinitialisation plus large. La première amélioration annoncée était l’augmentation de vitesse de GPT-6 Astra et GPT-6.1 Sol.
La première mise à jour du programme de livraisons sur 28 jours d’OpenAI est simple : GPT-6 Astra et GPT-6.1 Sol devraient désormais sembler environ 50 % plus rapides par défaut via un accès éligible par abonnement, y compris dans les outils partenaires pris en charge utilisant Sign in with ChatGPT.
Dans le même temps, les tests d’abonnement de SemiAnalysis montrent pourquoi la vitesse n’est qu’une partie de la concurrence. Selon ses hypothèses de charge de travail agentique, les abonnements Claude Opus 5.5 offrent actuellement plus de cinq fois la valeur équivalente API des formules GPT-6.1 Sol à des prix mensuels comparables.
La source relie également ce moment aux changements produit plus larges d’OpenAI. Certains sont officiels — le filigrane textuel européen, les publicités visuelles lors des tests de génération d’images, Work, Dots et une intégration produit plus poussée. D’autres, comme une fusion complète de Chat/Work/Codex/Dots et la disparition de la sélection de modèles, restent des spéculations communautaires plutôt qu’une politique produit annoncée.
GPT-6 est plus rapide, mais la concurrence plus large se déplace vers l’économie totale des agents : vitesse, limites, efficacité des modèles, accès aux outils et quantité de travail réel qu’un abonnement peut accomplir avant que le compteur n’arrive à son terme.
Partez d’une phrase et obtenez un site complet en quelques minutes.



