For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/grok-4-5-swe-1-7-ai-coding-agent-cost-routing.md.
Grok 4.5 et SWE-1.7 montrent que le codage IA s'éloigne d'une pensée centrée sur un seul modèle. La question pratique n'est plus seulement d...
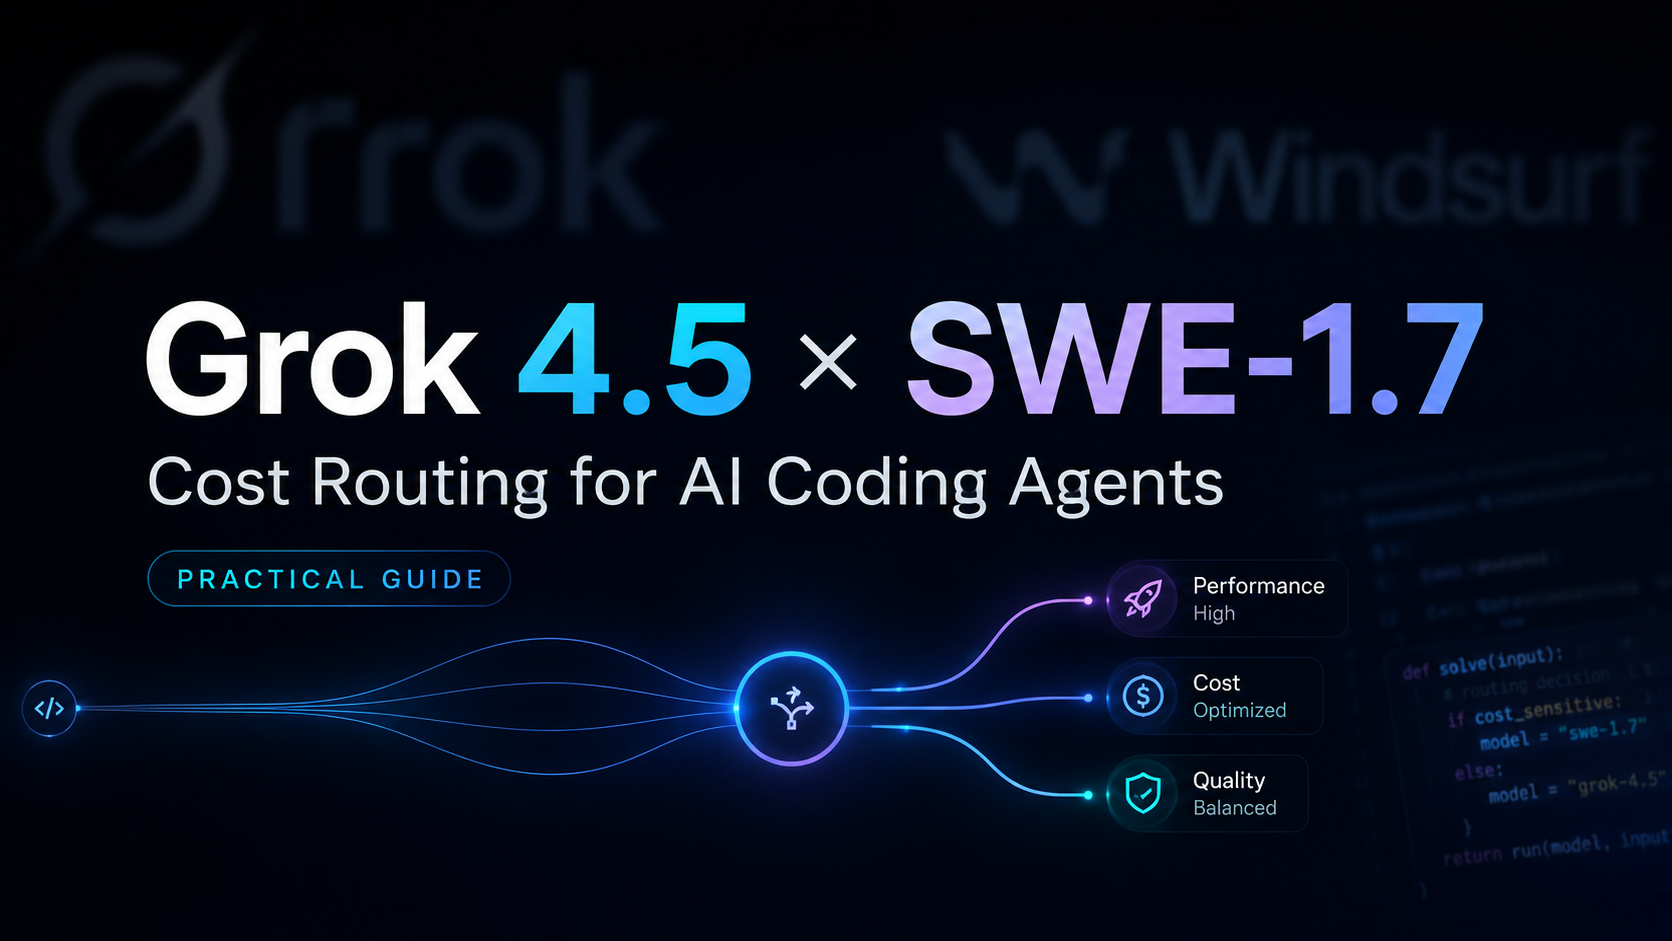
Grok 4.5 et SWE-1.7 ne sont pas simplement deux nouveaux modèles à ajouter au débat habituel sur « lequel est le plus performant ? ». Leur véritable valeur est plus pratique : ils montrent que le codage par IA est entré dans une ère de routage.
Dans cette ère, une équipe ne devrait pas confier chaque tâche d’ingénierie au même modèle avec la même invite et les mêmes autorisations. Une correction de faute de frappe, un ajustement d’interface, une refonte back-end et une modification liée à la facturation ne nécessitent pas le même niveau d’intelligence, de coût, d’accès au contexte ou de révision humaine.
La meilleure question n’est plus seulement : Quel est le meilleur modèle ?
Mais plutôt : Quel modèle devrait gérer cette tâche, sous quelles autorisations, avec quel chemin de validation et à quel coût ?
Cet article transforme cette idée en un cadre pratique pour les équipes de codage IA, en particulier celles qui utilisent des outils comme Cursor, Devin, GitHub Copilot et autres environnements de développement agentiques.
Grok 4.5 et SWE-1.7 pointent vers la même évolution majeure : les agents de codage IA deviennent des systèmes, et non de simples appels de modèles.
Grok 4.5 se distingue par son lien avec Cursor. Cursor présente Grok 4.5 comme un modèle entraîné conjointement avec SpaceXAI et conçu pour des tâches de longue durée en génie logiciel et travaux de connaissance plus larges. C’est important car l’utilisation réelle d’un IDE inclut bien plus que la complétion statique de code. Cela comprend la navigation dans les fichiers, les appels d’outils, les échecs partiels, les modifications de suivi, les boucles de débogage et les trajectoires d’agents dans des bases de code réelles.
SWE-1.7 représente une autre voie : une famille de modèles spécifiquement conçue pour les agents de génie logiciel. Cognition décrit SWE-1.7 comme son modèle le plus puissant à ce jour, optimisé pour les tâches asynchrones à long horizon et disponible dans Devin. La documentation du modèle Devin décrit également Adaptive comme un routeur de modèle intelligent qui sélectionne le modèle adapté à chaque tâche.
Ensemble, ces versions suggèrent un principe opérationnel clair :
Le codage IA devrait être routé par type de tâche, niveau de risque, force de validation et coût métier — et non par le battage médiatique autour d’un modèle par défaut.
Pour les équipes, cela signifie que la couche modèle doit devenir configurable. Un problème simple peut aller vers un modèle rapide et peu coûteux. Une modification architecturale multi-fichiers peut nécessiter un modèle plus puissant, plus de contexte, des points de contrôle et un chemin de révision plus strict. Une modification impliquant l’authentification, les paiements, le déploiement ou les données clients devrait exiger une approbation humaine et des journaux audités.
Une erreur courante consiste à rédiger des invites comme si un seul modèle serait toujours la réponse :
« Utilisez le modèle de codage le plus puissant pour accomplir cette tâche. »
Cela semble sûr, mais ce n’est pas une bonne stratégie de production. Cela peut augmenter les coûts, ralentir le travail de routine et encore échouer à protéger les zones à haut risque. Un meilleur système sépare la décision de routage de l’invite elle-même.
Au lieu de coder en dur un modèle, définissez des classes de tâches.
| Route | Idéal pour | Stratégie de modèle | Niveau de validation | Révision humaine |
|---|---|---|---|---|
| Maintenance quotidienne | Mises à jour de copie, petites corrections d’interface, corrections de bugs simples, nettoyage à faible risque | Modèle rapide et peu coûteux | Vérifications lint/test de base | Optionnelle ou par échantillonnage |
以下是翻译结果:
Implémentation standard | Fonctionnalités normales, logique backend isolée, intégrations courantes | Modèle de codage évalué en interne | Tests unitaires, revue de diff, vérifications CI | Recommandée |
| Ingénierie approfondie | Refontes multi-fichiers, changements d'architecture, débogage complexe | Modèle plus puissant avec planification et points de contrôle | Suite de tests complète, revue par étapes, plan de rollback | Requise |
| Travail à haut risque restreint | Authentification, facturation, déploiement, permissions, données clients, logique de sécurité | Permissions d'agent limitées ; le choix du modèle est secondaire | Journal d'audit, approbation manuelle, revue de sécurité | Obligatoire |
Ce tableau d'acheminement est plus utile qu'un classement générique du « meilleur modèle ». Il donne à l'équipe une méthode reproductible pour décider quand le coût importe, quand l'intelligence importe, et quand la gouvernance importe plus que les deux.
Le prix des tokens est facile à comparer, mais ce n'est pas la métrique la plus utile.
Un modèle moins cher peut devenir coûteux s'il génère des pull requests de faible qualité, nécessite des tentatives répétées ou produit des changements que les relecteurs ne peuvent pas accepter. Un modèle plus cher peut être rentable s'il réalise un travail complexe avec moins de correctifs de suivi.
La métrique la plus pratique est :
Changement accepté par dollar
Pour chaque exécution d'agent, les équipes devraient enregistrer :
| Métrique | Pourquoi c'est important |
|---|---|
| Modèle utilisé | Montre quel modèle est efficace pour quel type de tâche |
| Catégorie de tâche | Empêche de comparer des correctifs simples avec un travail d'ingénierie complexe |
| Coût des tokens | Suit les dépenses directes du modèle |
| Temps d'exécution | Capture la latence et le temps d'attente du développeur |
| Fichiers modifiés | Aide à détecter une portée de changement excessive |
| Tests exécutés | Montre la force de validation |
| Résultat de la revue | Mesure si la sortie a été effectivement acceptée |
| Correctifs de suivi | Révèle le coût caché après la première exécution de l'agent |
Une fois ces signaux en place, de nouveaux modèles peuvent être ajoutés à la file d'évaluation sans perturber les flux de production. L'équipe peut tester Grok 4.5, SWE-1.7, ou tout futur modèle de codage par rapport à des catégories de tâches internes réelles, au lieu de se fier uniquement aux affirmations des benchmarks publics.
Grok 4.5 est intéressant car il est positionné pour le codage, les tâches agentiques, et le travail de connaissance plus large. L'annonce de xAI le décrit comme un modèle construit pour le génie logiciel et les flux de travail utilisant des outils, tandis que l'annonce de Cursor met l'accent sur les tâches de longue durée et les environnements réalistes.
Pour les équipes de développement, le point clé n'est pas simplement que Grok 4.5 puisse bien performer sur les benchmarks de codage. Le point plus important est que l'entraînement sur des interactions réalistes développeur-agent peut aider un modèle à apprendre des motifs qui n'apparaissent pas dans les ensembles de données de code statiques.
Le véritable travail d'ingénierie inclut :
Si un modèle est entraîné ou renforcé autour de ces comportements, il peut être plus utile dans un IDE ou un harnais d'agent de codage. Mais il a toujours besoin d'acheminement. Même un modèle puissant ne devrait pas recevoir des permissions illimitées par défaut.
SWE-1.7 Sujets concernant les agents de génie logiciel
SWE-1.7 se concentre plus directement sur les agents de génie logiciel. Cognition le décrit comme un modèle optimisé pour les tâches asynchrones à long horizon, avec des améliorations en matière de stabilité d'entraînement, de tolérance aux pannes, de qualité des données et d'auto-compactage pour un travail prolongé.
C'est important car de nombreuses tâches de codage utiles ne sont pas des modifications ponctuelles. Elles prennent du temps. Un agent peut avoir besoin d'inspecter la base de code, de former un plan, d'exécuter des tests, de réviser l'approche et de continuer après que le contexte soit devenu important.
SWE-1.7 fait également partie de l'écosystème Devin, où le routage de modèles fait déjà partie de l'expérience produit. La documentation de Devin décrit Adaptive comme un routeur de modèles qui sélectionne le niveau d'intelligence approprié pour une invite. Cela soutient la même leçon opérationnelle : les équipes de production doivent penser en termes de portefeuilles de modèles, et non de dépendance à un seul modèle.
Pour les équipes d'ingénierie, SWE-1.7 est particulièrement pertinent pour :
La capacité du modèle n'est qu'une partie d'un système de codage IA de production. La gouvernance détermine si le système est suffisamment sûr pour être utilisé à grande échelle.
Les workflows d'agents GitHub, les passerelles d'applications de type Claude, les agents gérés de type Gemini, Devin, Cursor et des outils similaires pointent tous vers la même exigence : les agents de codage ont besoin de limites.
Un workflow d'agent de qualité production devrait inclure :
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Un modèle légèrement plus faible avec une journalisation solide et un contrôle des permissions peut être plus sûr qu'un modèle plus fort avec un accès large et non-suivi.
C'est le point que de nombreuses équipes perdent de vue. Le codage IA ne consiste pas seulement à "rendre le modèle plus intelligent". Il s'agit de construire un système d'exploitation autour de l'agent : routage, permissions, validation, métriques et restauration.
Un processus de routage simple peut ressembler à ceci :
Avant d'assigner un modèle, classifiez la tâche par risque et complexité.
Demandez :
Utilisez la table de routage pour décider si la tâche appartient à la maintenance quotidienne, à une tâche standard
implémentation, ingénierie approfondie ou travaux à haut risque restreint.
Le modèle doit être choisi après la définition de la voie, et non avant.
L'accès aux outils doit correspondre à la voie.
Par exemple :
La validation doit être automatique dans la mesure du possible.
Les bonnes vérifications incluent :
N'enregistrez pas uniquement si le modèle a terminé l'exécution. Enregistrez si la modification a été acceptée.
Un bon suivi doit inclure :
C'est ainsi que les équipes passent de l'effet de mode autour des modèles à une véritable productivité en ingénierie.
Le routage des coûts signifie envoyer différentes tâches de codage à différents modèles, niveaux de permission et chemins de validation en fonction de la complexité et du risque. L'objectif n'est pas toujours d'utiliser le modèle le plus puissant. L'objectif est d'obtenir le meilleur résultat d'ingénierie accepté pour le coût raisonnable le plus bas.
Il n'y a pas de réponse universelle. Grok 4.5 est positionné comme un modèle agentique général puissant avec des capacités de codage, tandis que SWE-1.7 est spécifiquement axé sur les agents d'ingénierie logicielle. Les équipes doivent les comparer en utilisant des tâches internes, examiner les résultats et la modification acceptée par dollar plutôt que de se fier uniquement aux benchmarks médiatiques.
Cursor est pertinent car son annonce indique que Grok 4.5 a été entraîné conjointement avec SpaceXAI et a impliqué des données d'interaction réelles entre développeurs et agents. Ce type de données peut être important car les agents de codage doivent naviguer dans les fichiers, utiliser des outils, se remettre des erreurs et travailler dans des environnements logiciels réalistes.
SWE-1.7 est le modèle d'ingénierie logicielle de Cognition conçu pour les workflows de codage agentiques. Il est particulièrement pertinent pour les tâches asynchrones de longue durée où l'agent doit inspecter une base de code, raisonner sur l'implémentation et valider les modifications en plusieurs étapes.
La modification acceptée par dollar mesure la quantité de production d'ingénierie utile et approuvée par un réviseur qu'un modèle produit pour l'argent dépensé. C'est plus pratique que le seul prix par jeton, car un modèle bon marché peut devenir coûteux si sa production nécessite de lourdes corrections.
Les modifications à haut risque peuvent impliquer l'assistance de l'IA, mais elles ne doivent pas être totalement fiables sans garde-fous. Les modifications concernant l'authentification, la facturation, le déploiement, les permissions et les données client doivent nécessiter l'approbation humaine, une journalisation solide et des chemins de restauration clairs.
Modèles ?
Les équipes devraient tester les nouveaux modèles en les confrontant à des catégories de tâches internes réelles. Il convient de suivre le coût, le temps d'exécution, les fichiers modifiés, les tests réussis, le résultat de la relecture et les correctifs de suivi. Un modèle ne devrait être mis en production qu'après avoir obtenu de bons résultats dans les parcours où il sera réellement utilisé.
Grok 4.5 et SWE-1.7 montrent que le codage IA s'éloigne d'une réflexion axée sur un modèle unique. La question pratique n'est plus simplement de savoir quel modèle est le plus performant. La meilleure question est de savoir comment chaque tâche doit être routée en fonction du coût, du risque, de la validation et des exigences de relecture.
Un workflow de codage IA utile devrait séparer la maintenance quotidienne, la mise en œuvre standard, l'ingénierie approfondie et les tâches restreintes à haut risque. Chaque parcours nécessite une combinaison différente de capacités du modèle, d'accès aux outils, de tests et d'approbation humaine.
La métrique la plus utile n'est pas le prix brut du token. C'est de savoir si le modèle produit du code que les relecteurs acceptent, que les tests peuvent vérifier et que les équipes peuvent déployer en toute sécurité.
La pile de codage IA gagnante ne sera pas celle qui possède uniquement le modèle le plus performant. Ce sera celle qui offre le meilleur routage, la meilleure gouvernance et le meilleur ratio de changements acceptés par dollar.
Partez d’une phrase et obtenez un site complet en quelques minutes.