For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/grok-4-6-released-agentic-performance.md.
SpaceXAI a publié Grok 4.6 le 12 août 2026, le positionnant comme un modèle de pointe pour la programmation, les tâches d'agent à long terme...
SpaceXAI a publié Grok 4.6 le 12 août 2026, le positionnant comme un modèle de pointe destiné à la programmation, aux tâches d'agent de longue durée et au travail intellectuel.
Le modèle s'appuie directement sur Grok 4.5, mais avec un accent plus ciblé et pragmatique : maintenir son efficacité sur des sessions de travail plus longues, utiliser des outils sur plusieurs étapes, et générer de meilleures premières versions pour les applications interactives et visuelles.
Selon SpaceXAI et Cursor, Grok 4.6 atteint désormais le niveau de GPT-5.6 Sol sur l'indice d'intelligence Artificial Analysis, tout en affichant des résultats particulièrement remarquables dans les évaluations d'agents réelles telles que GDPval-AA v2 et AA-Briefcase.
L'article original d'AIBase met également l'accent sur le prix et la vitesse de service de Grok 4.6. L'avantage tarifaire est pleinement confirmé par la documentation officielle. Les données de vitesse nécessitent en revanche une lecture plus nuancée : AIBase rapporte 80 TPS, tandis qu'Artificial Analysis mesure actuellement environ 68 tokens de sortie par seconde pour l'API première partie Grok 4.6. La vitesse d'exécution varie en fonction de l'infrastructure, de la longueur des invites, de l'intensité de raisonnement et de la charge du fournisseur.
Grok 4.6 constitue une génération de modèle incrémentale, et non la sortie d'une toute nouvelle architecture.
SpaceXAI indique que le nouveau modèle a bénéficié d'un entraînement complémentaire plus long que Grok 4.5. La composition des données d'entraînement comprend :
La société indique également que Grok 4.5 a été utilisé pour régénérer les trajectoires de supervision en STEM, ingénierie logicielle et tâches de travail intellectuel, avec des filtres basés sur modèle pour éliminer les traces problématiques.
Grok 4.5 avait déjà été entraîné à très grande échelle.
SpaceXAI a officiellement déclaré que l'entraînement de Grok 4.5 avait utilisé des dizaines de milliers de GPU NVIDIA GB300. Ses données d'entraînement couvrent la programmation, les sciences, l'ingénierie et les mathématiques, tandis que l'apprentissage par renforcement s'est principalement concentré sur les tâches d'ingénierie logicielle multi-étapes et autres travaux techniques de longue durée.
Grok 4.6 est une extension de cette base, et non un remplacement.
Le changement le plus important réside dans l'accent mis sur le comportement d'agent continu : le modèle ne doit pas seulement résoudre des problèmes de programmation isolés, mais rester cohérent tout au long de la recherche, de l'édition de fichiers, de l'utilisation d'outils, des tests de son propre travail et des itérations de feedback multi-tours.
SpaceXAI indique que Grok 4.6 a été entraîné sur un large ensemble de tâches d'apprentissage par renforcement orienté agent.
Ces environnements comprennent :
Cela aide à expliquer pourquoi le modèle excelle particulièrement dans les évaluations impliquant un travail étendu plutôt qu'un raisonnement à réponse courte.
SpaceXAI et Cursor soulignent également
la capacité du modèle à transformer des idées de produits générales en premières versions utilisables.
Lors des tests internes, Grok 4.6 a pu :
Cela ne signifie pas que chaque application générée en une seule fois atteint un niveau prêt pour la production. Cela indique simplement que l'entreprise constate que la qualité de ses sorties initiales est supérieure à celle de Grok 4.5, en particulier lorsque la tâche combine code, design, interaction et utilisation itérative d'outils.
Artificial Analysis attribue actuellement à Grok 4.6 (version haute) un score de 61 sur l'indice d'intelligence.
Cela correspond au score total de GPT-5.6 Sol (version maximale) dans la comparaison publiée par SpaceXAI.
Cet indice est le résultat agrégé de neuf évaluations, et non d'un test unique. Il constitue donc davantage un signal de comparaison large qu'une preuve que les deux modèles présentent des performances strictement identiques sur toutes les charges de travail.
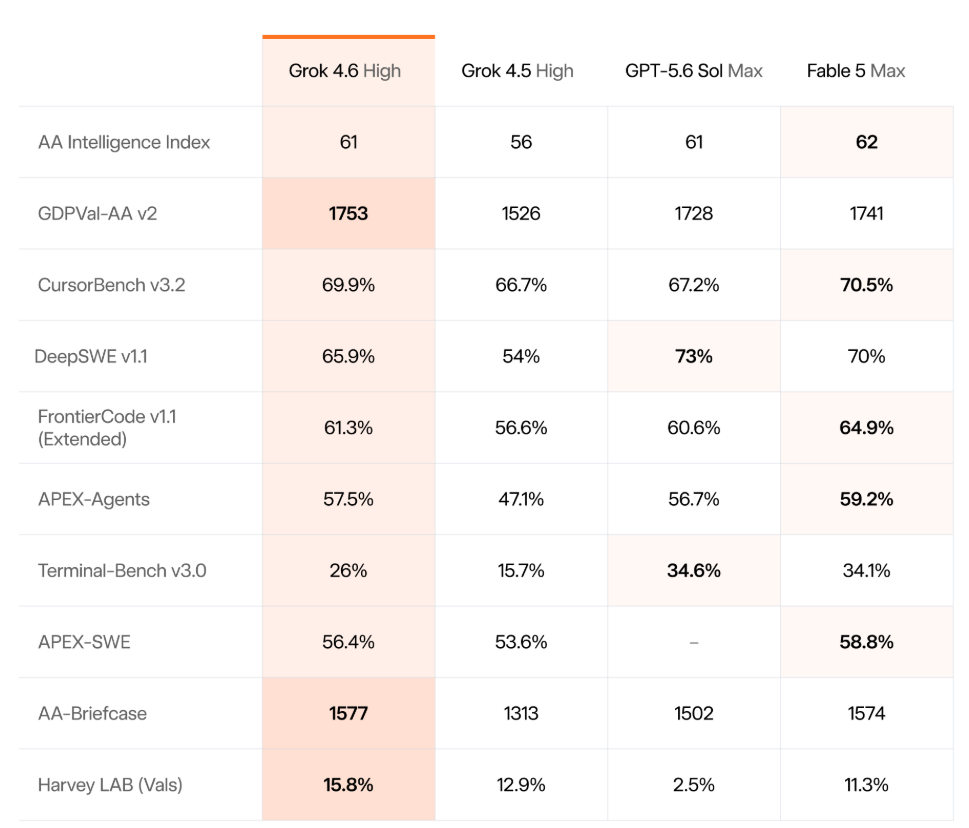
Le tableau de benchmark accompagnant la sortie comprend les résultats suivants :
| Benchmark | Grok 4.6 version haute | Grok 4.5 version haute | GPT-5.6 Sol Max | Fable 5 Max |
|---|---|---|---|---|
| Indice d'intelligence AA | 61 | 56 | 61 | 62 |
| GDPval-AA v2 | 1753 | 1526 | 1728 | 1741 |
| CursorBench v3.2 | 69,9 % | 66,7 % | 67,2 % | 70,5 % |
| DeepSWE v1.1 | 65,9 % | 54,0 % | 73,0 % | 70,0 % |
| FrontierCode v1.1 étendu | 61,3 % | 56,6 % | 60,6 % | 63,6 % |
| APEX-Agents | 57,5 % | 47,1 % | 56,7 % | 59,2 % |
| Terminal-Bench v3.0 | 26,0 % | 15,7 % | 34,6 % | 34,1 % |
| APEX-SWE | 56,4 % | 53,6 % | — | 58,8 % |
| AA-Briefcase | 1577 | 1313 | 1502 | 1574 |
| Harvey LAB (Vals) | 15,8 % | 12,9 % | 2,5 % | 11,3 % |
Les classements des benchmarks évoluent avec les mises à jour des modèles, des cadres de test et des versions d'évaluation. Le tableau ci-dessus reflète les résultats de la période de sortie et ne constitue pas un classement permanent.
Sur GDPval-AA v2, Grok 4.6 a obtenu un score de 1753 Elo.
Artificial Analysis décrit GDPval-AA v2 comme une évaluation de travail intellectuel par agent dans le monde réel, couvrant plusieurs professions spécialisées.
Au moment de l'analyse de sortie de Grok 4.6, Artificial Analysis indiquait que ce score ne se situait qu'après la série Claude Opus 5, avec des intervalles de confiance chevauchant ceux d'autres modèles de premier plan (comme Claude Fable 5 et Qwen3.8 Max).
Cette formulation est plus rigoureuse qu'une simple affirmation selon laquelle Grok 4.6 se classerait clairement deuxième.
Les évaluations basées sur Elo comportent une incertitude intrinsèque ; des scores proches peuvent se chevaucher statistiquement.
Grok 4.6 a également obtenu 1577 Elo sur AA-Briefcase.
. Ce score provient du benchmark privé d'Artificial Analysis pour le travail agentique à long terme.
Cela place sa performance —
Dans l'instantané publié, Grok 4.6 présente des performances approximativement équivalentes au niveau de Fable 5, en retrait par rapport à la série Claude Opus 5.
Son efficacité mérite également l'attention.
Artificial Analysis indique que Grok 4.6, pour accomplir ses tâches AA-Briefcase, utilise approximativement :
En comparaison, Claude Opus 5 (version maximale) utiliserait selon les rapports :
Cela ne signifie pas que Grok 4.6 est plus efficace que Claude Opus 5 dans tous les cas. Il s'agit simplement d'une observation sur un benchmark spécifique. Néanmoins, pour les agents intelligents à exécution longue, un nombre réduit de tours et un contexte cumulé moindre peuvent considérablement réduire le coût des tâches.
La tarification standard de l'API publique demeure l'un des principaux avantages concurrentiels de Grok 4.6.
Pour les requêtes inférieures au seuil de tarification des contextes longs, la documentation SpaceXAI précise :
| Type de jeton | Prix par million de jetons |
|---|---|
| Entrée | 2,00 $ |
| Entrée en cache | 0,50 $ |
| Sortie | 6,00 $ |
Artificial Analysis souligne que cette tarification publique reste inchangée par rapport à Grok 4.5, malgré une amélioration du score d'indice d'intelligence de 56 à 61.
En comparaison, au moment de la rédaction :
Cela rend Grok 4.6 particulièrement attractif pour les boucles d'agents à haut débit, où les jetons de sortie et le contexte répété représentent souvent l'essentiel du coût total.
Les notes de version officielles de SpaceXAI ajoutent un détail important que l'article AIBase ne mentionne pas.
Pour les prompts dépassant 200 000 jetons, Grok 4.6 adopte un niveau de tarification supérieur :
| Type de jeton | Prix par million de jetons pour les prompts de plus de 200 000 |
|---|---|
| Entrée | 4,00 $ |
| Entrée en cache | 1,00 $ |
| Sortie | 12,00 $ |
Ainsi, « 2 $ en entrée / 6 $ en sortie » est un prix de départ, et ne s'applique pas à toutes les requêtes de manière universelle.
Cursor indique que la variante rapide est proposée à deux fois le tarif standard.
Cette règle est distincte de celle des prompts longs. Selon la plateforme et la charge de travail, les utilisateurs doivent vérifier le niveau de vitesse et de contexte applicable avant d'estimer les coûts de production.
L'article AIBase affirme que Grok 4.6 peut fonctionner à 80 jetons par seconde.
Ce chiffre doit être pris avec prudence.
L'annonce officielle de Grok 4.6 par SpaceXAI ne publie aucune garantie de vitesse fixe de 80 TPS. Artificial Analysis mesure actuellement, sur ses charges de travail de référence, une vitesse de sortie d'environ 67,6 jetons de sortie par seconde pour Grok 4.6 (high) sur l'API propriétaire.
En comparaison, la page de lancement officielle de Grok 4.5 chez SpaceXAI indiquait explicitement que Grok 4.5 était servi à 80 TPS.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Par conséquent, la source secondaire a pu reprendre l'ancien chiffre de 80 TPS ou citer un niveau de service différent.
Le point pratique est plus simple :
Grok 4.6 offre une vitesse tout à fait correcte pour un modèle de raisonnement de pointe, mais il n'existe pas de chiffre TPS unique et fixe applicable à tous les prompts, fournisseurs, niveaux de raisonnement ou niveaux de vitesse.
La documentation de l'API SpaceXAI liste la fenêtre de contexte de grok-4.6 à 500 000 jetons.
Le modèle prend en charge :
La page officielle du modèle indique également une date limite des connaissances fixée au 1er février 2026.
La documentation du modèle Grok 4.6 de Cursor liste actuellement une fenêtre de contexte de 256 000 jetons dans Cursor.
Cela ne contredit pas les spécifications du modèle de base. Cela signifie que l'intégration de la plateforme peut exposer une limite de contexte inférieure à celle de l'API propriétaire SpaceXAI.
Lorsque vous comparez les limites des modèles, vérifiez toujours le fournisseur et l'intégration exacts utilisés.
L'identifiant officiel du modèle SpaceXAI est :
grok-4.6
Une requête minimale à l'API Responses se présente comme suit :
curl https://api.x.ai/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -d '{
    "model": "grok-4.6",
    "input": "Trouve et corrige le bug, puis explique-le : function median(a){a.sort();return a[a.length/2]}"
  }'
Le même modèle est également disponible via les SDK officiels xAI et les clients API compatibles OpenAI.
import os
from xai_sdk import Client
from xai_sdk.chat import user

client = Client(api_key=os.getenv("XAI_API_KEY"))

chat = client.chat.create(model="grok-4.6")
chat.append(
    user(
        "Trouve et corrige le bug, puis explique-le : "
        "function median(a){a.sort();return a[a.length/2]}"
    )
)

response = chat.sample()
print(response.content)
Pour les boucles d'agents à exécution longue, SpaceXAI recommande d'utiliser la mise en cache des prompts et la compression de contexte lorsque cela est approprié, afin de réduire les coûts de contexte répété.
Au moment du lancement, Grok 4.6 est disponible sur les plateformes suivantes :
SpaceXAI et Cursor proposent également 2 fois l'utilisation incluse pendant la première semaine dans Cursor et Grok Build.
Cette promotion de lancement est limitée dans le temps et ne doit pas être considérée comme une tarification permanente.
Cursor présente Grok 4.6 avec quatre niveaux d'intensité de raisonnement :
high est l'intensité de raisonnement par défaut.
Un niveau de vitesse rapide est également disponible dans les offres Cursor éligibles.
Dans Cursor, le modèle peut utiliser les outils d'agent de la plateforme pour :
C'est l'une des raisons pour lesquelles le lancement de Grok 4.6 accorde une telle importance aux benchmarks agentiques : son usage prévu ne se limite pas à des complétions de chat isolées.
Les résultats des tests de référence montrent que la plus grande avancée de Grok 4.6 ne réside pas uniquement dans le raisonnement statique.
Ses améliorations sont les plus visibles lorsque les tâches impliquent :
Cela le rend particulièrement adapté à :
Les tâches de travail basées sur la connaissance de longue durée
Pour les invites courtes et simples, cet avantage peut ne pas être évident.
Les données publiées soutiennent les conclusions claires suivantes :
Cependant, les données ne peuvent pas prouver que Grok 4.6 est universellement supérieur à GPT-5.6 Sol ou Claude sur chaque tâche.
Par exemple, le même tableau de publication montre que GPT-5.6 Sol est en tête sur DeepSWE v1.1 et Terminal-Bench v3.0, tandis que Claude Fable 5 est en tête sur plusieurs autres évaluations de programmation et d'agents.
Par conséquent, le choix du modèle doit dépendre de la charge de travail réelle, et non d'un seul score composite.
Grok 4.6 est le modèle de pointe de SpaceXAI destiné à la programmation, aux tâches d'agents et au travail de connaissances. Il s'appuie sur Grok 4.5 en ajoutant un entraînement supplémentaire, en mettant l'accent sur les agents de longue durée, une meilleure capacité de construction d'applications dès la première tentative et un travail multi-étapes plus persistant.
Cela dépend de la tâche spécifique. Dans les comparaisons publiées, Grok 4.6 est à égalité avec GPT-5.6 Sol sur l'indice d'intelligence Artificial Analysis et est en tête sur certains tests d'agents, tandis que GPT-5.6 Sol reste plus fort sur certains benchmarks de programmation. Les deux modèles présentent également des différences significatives en termes de prix et de longueur de contexte.
Le prix standard est de 2 $ par million de tokens d'entrée, 0,50 $ par million de tokens d'entrée en cache et 6 $ par million de tokens de sortie. Pour les invites dépassant 200 000 tokens, la documentation SpaceXAI spécifie des paliers de prix plus élevés, respectivement de 4 $ / 1 $ / 12 $ par million pour l'entrée, l'entrée en cache et la sortie.
L'API propriétaire de SpaceXAI prend en charge une fenêtre de contexte de 500 000 tokens. Cursor propose actuellement une fenêtre de contexte de 256 000 tokens pour sa propre intégration de Grok 4.6, donc la limite réelle dépend de la plateforme.
Oui. SpaceXAI répertorie Grok 4.6 comme prenant en charge les entrées texte et image ainsi que les sorties texte. Le modèle prend également en charge des outils tels que l'appel de fonction, la recherche Web, la recherche X et l'exécution de code, disponibles via l'API xAI.
Oui. Grok 4.6 est disponible dans Cursor et prend en charge les intensités de raisonnement xhigh, high, medium et low. Cursor lui donne également accès à sa suite d'outils d'agent pour la manipulation de fichiers, les commandes Shell, la navigation et d'autres flux de travail de programmation.
Non. Grok 4.6 est un modèle propriétaire, et SpaceXAI n'a pas divulgué ses poids de modèle ni son nombre de paramètres.
AIBase a rapporté 80 tokens par seconde, mais les mesures actuelles d'Artificial Analysis montrent que l'API propriétaire Grok 4.6 est d'environ 68 tokens de sortie par seconde sous sa charge de travail de référence. La vitesse varie en fonction de l'intensité de raisonnement, de la taille de l'invite, de la charge de l'infrastructure et du niveau de la plateforme.
Grok 4.6 est une mise à niveau ciblée de Grok 4.5, axée sur les agents de longue durée, le codage, le travail de connaissances et la qualité d'exécution dès la première tentative sur des projets interactifs. Ses résultats publiés le placent à la pointe des évaluations de modèles actuelles, avec un score de 61 sur l'indice d'intelligence Artificial Analysis, à égalité avec GPT-5.6 Sol dans les comparaisons publiées.
Le point le plus fort de ce lancement réside dans la combinaison des performances des agents et du prix. Grok 4.6 démarre à 2 $ par million de tokens d'entrée et 6 $ par million de tokens de sortie, tout en obtenant des scores élevés sur GDPval-AA v2 et AA-Briefcase. Les invites longues et les niveaux rapides peuvent entraîner des coûts plus élevés, c'est pourquoi les estimations de production doivent utiliser la configuration exacte du fournisseur.
La donnée de 80 TPS publiée doit être traitée avec prudence : les mesures indépendantes actuelles sont proches de 68 tokens de sortie par seconde, et la vitesse du service peut varier dans le temps.
**Grok 4.6
Son principal atout ne réside pas dans le fait qu'il remporte tous les tests de référence, mais dans le fait qu'il offre désormais des performances d'agent de pointe à un prix extrêmement compétitif.
Partez d’une phrase et obtenez un site complet en quelques minutes.



