For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/grok-45-coding-agent-model-pricing-benchmarks.md.
Grok 4.5 se présente comme un modèle rapide et économique pour le codage, les workflows agentiques et le travail de connaissance. Il obtient...
Grok 4.5 est enfin arrivé.
Selon le rapport original, xAI a publié Grok 4.5 comme son modèle phare le plus puissant à ce jour, avec un accent clair sur le codage, les tâches agentiques de longue durée et le travail de connaissances. Le modèle a été entraîné conjointement avec Cursor, et le point fort n'est pas seulement la performance brute des benchmarks. L'histoire plus importante est la combinaison de performances, de vitesse et de coût.
L'article positionne Grok 4.5 comme un challenger pratique face aux modèles de premier plan tels que GPT-5.5, Opus 4.8 et Fable 5. Il n'est pas décrit comme le modèle absolument le plus fort dans tous les indicateurs. Son avantage est plutôt le suivant : assez puissant pour entrer dans le premier rang, beaucoup plus rapide que de nombreux concurrents, et bien moins cher à exécuter sur des tâches d'ingénierie gourmandes en jetons.
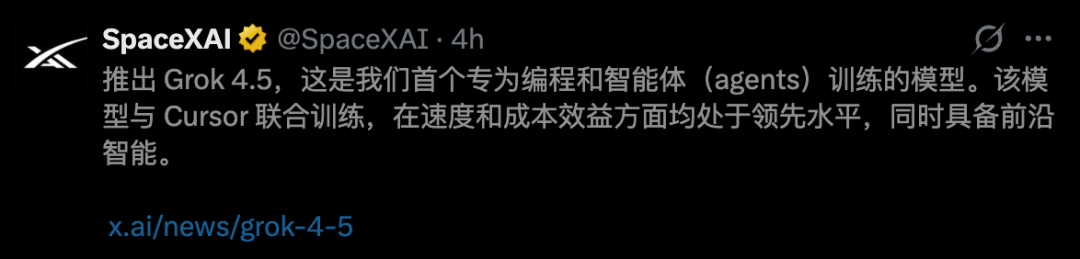
Le message de lancement est direct : Grok 4.5 est conçu pour la programmation, les flux de travail agentiques et les tâches complexes de connaissances.
Cela importe car le centre de la compétition en IA a dépassé les réponses courtes. Pour les développeurs et les équipes, le véritable test est de savoir si un modèle peut continuer à travailler sur des tâches d'ingénierie en plusieurs étapes, utiliser des outils, se remettre des erreurs et produire des artefacts utiles sans gaspiller d'énormes quantités de contexte et d'argent.
Dans l'article original, Grok 4.5 est décrit comme le premier grand modèle phare de xAI après le dernier changement stratégique de l'entreprise, et également le premier résultat majeur de la collaboration xAI–Cursor.
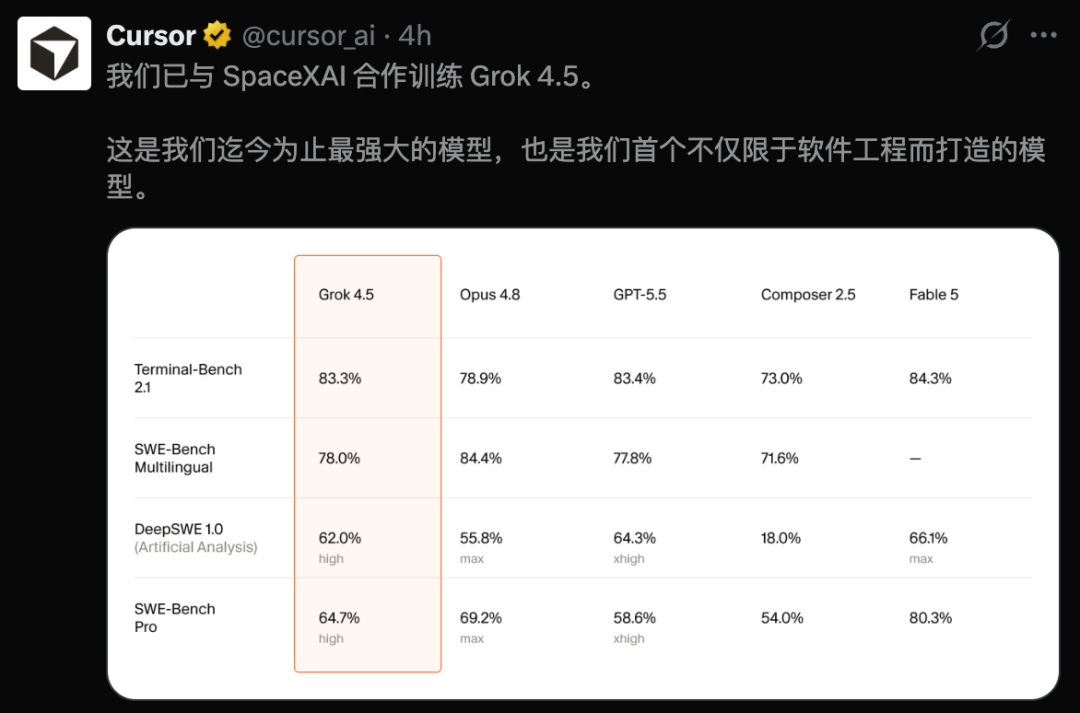
Les chiffres des benchmarks rapportés sont solides :
Ces chiffres placent Grok 4.5 près du sommet des modèles actuels de codage et d'agents. Il n'est pas décrit comme battant tous les modèles dans tous les domaines, mais il semble compétitif là où les agents d'ingénierie comptent vraiment.
L'article original indique que Grok 4.5 a été entraîné sur des dizaines de milliers de GPU NVIDIA GB300. Cela donne au modèle une énorme base de calcul, mais le calcul seul n'est pas toute l'histoire.
La partie la plus importante est les données.
Selon les rapports, xAI a utilisé un filtrage intensif, une déduplication, une évaluation de la qualité et une sélection axée sur les domaines pour maintenir les données d'entraînement denses et utiles. En d'autres termes, le modèle n'a pas seulement été entraîné sur de grandes quantités de texte. Le mélange d'entraînement a été
conçu pour inclure des matériaux à fort signal pour le codage, l'ingénierie, les sciences, les mathématiques et le travail cognitif.
Une autre idée importante est l'intelligence par jeton. L'article décrit l'accent mis par xAI sur l'apprentissage par renforcement comme un moyen d'améliorer la quantité de raisonnement utile que le modèle peut produire par jeton. Il s'agit d'une mesure pratique, car les flux de travail des agents deviennent souvent coûteux lorsqu'un modèle écrit trop, réessaie trop souvent ou emprunte un chemin trop long pour résoudre une tâche.

La collaboration avec Cursor est particulièrement importante ici. Les données de Cursor reflètent la manière dont les développeurs interagissent réellement avec les bases de code, les outils et les agents. Cela signifie que Grok 4.5 n'apprend pas seulement à quoi ressemble le code. Il apprend également comment les développeurs et les agents d'IA travaillent ensemble dans des environnements pratiques.
L'article note également que la pile d'entraînement du modèle a été conçue pour un travail hautement asynchrone. Les déploiements d'agents peuvent fonctionner pendant des heures, tandis que l'entraînement se poursuit à travers le cluster de calcul. Cette configuration est importante pour les tâches à long horizon, où le modèle doit rester cohérent sur plusieurs étapes au lieu de résoudre simplement une requête courte.
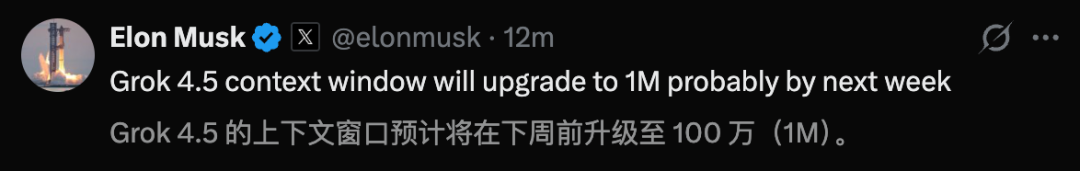
L'histoire des benchmarks de Grok 4.5 n'est pas un simple récit du "meilleur modèle gagne tout". Elle est plus nuancée.
Sur plusieurs benchmarks d'ingénierie fondamentaux, le modèle se comporte comme un concurrent de premier plan :
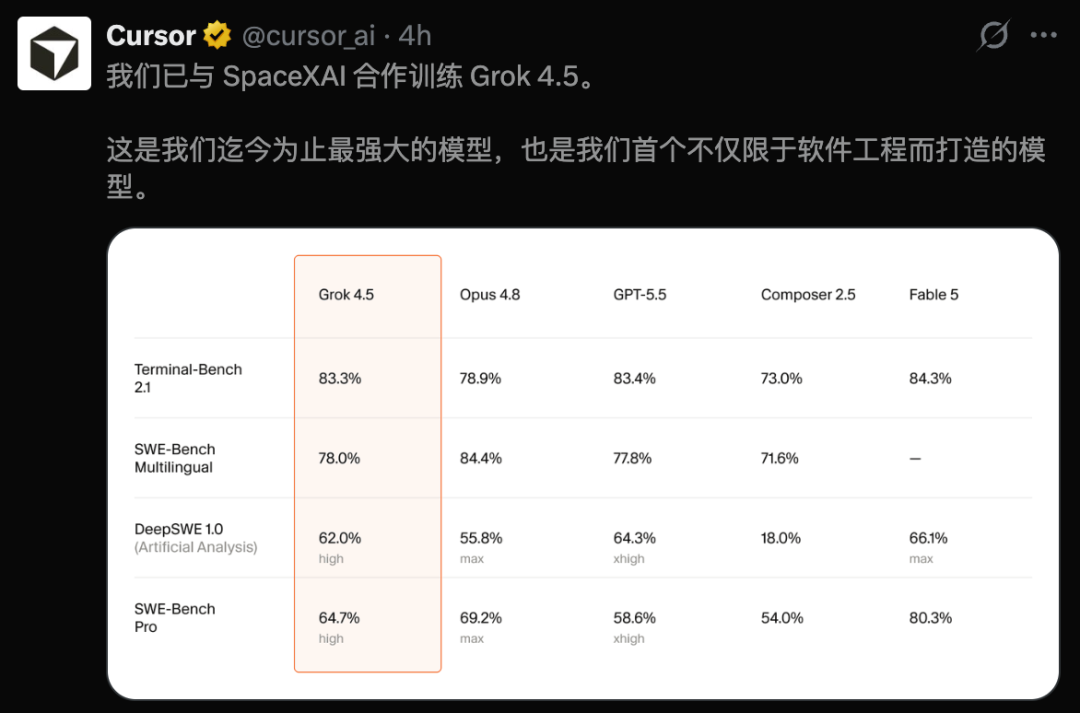
La conclusion de l'article est claire : Grok 4.5 est solide, mais Claude Fable semble toujours occuper la première place dans certaines évaluations haut de gamme.
Cela rend Grok 4.5 intéressant pour une autre raison. Il n'est peut-être pas
puisse être le modèle plafond absolu. Mais il pourrait être l'un des modèles les plus performants lorsque l'on compare le rapport qualité-prix, les performances par seconde et les tokens utilisés par tâche résolue.
Le principal argument de vente de Grok 4.5 est son efficacité en termes de coût.
Le modèle atteindrait environ 80 tokens par seconde, ce que xAI décrit comme une vitesse de modèle rapide. L'article présente cela comme une différence clé avec les modèles de raisonnement haut de gamme plus lents. Si un modèle est à la fois performant et rapide, il devient plus pratique pour le travail d'ingénierie quotidien, et pas seulement pour des tâches difficiles ponctuelles.
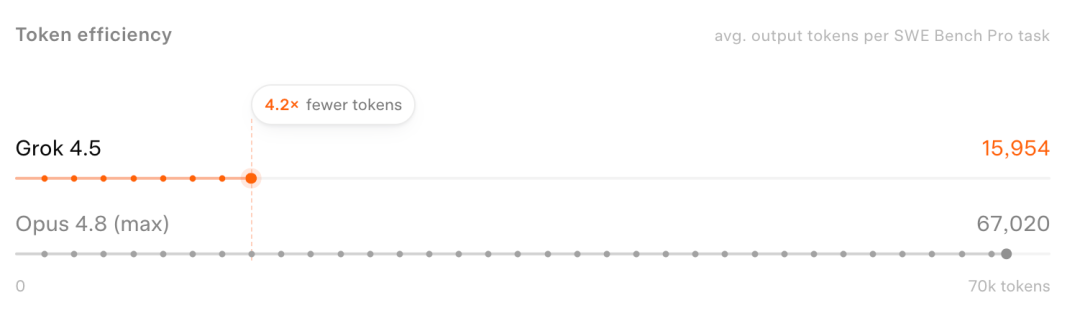
Il utilise également moins de tokens de sortie sur les tâches d'ingénierie de référence. Sur SWE Bench Pro, Grok 4.5 résoudrait les tâches avec une moyenne de 15 954 tokens de sortie, tandis qu'Opus 4.8 en utilise environ 67 020 pour la même catégorie de tâches.
C'est la fameuse affirmation de 4,2 fois moins de tokens.
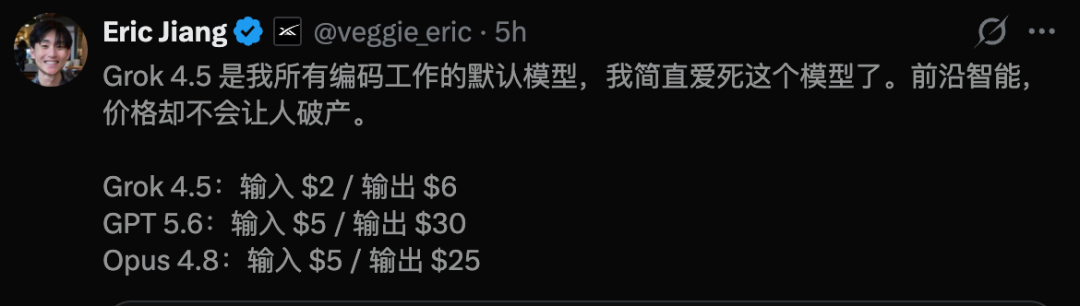
La tarification est un autre aspect important :
| Modèle / Variante | Prix d'entrée | Prix de sortie | Remarques |
|---|---|---|---|
| Grok 4.5 | 2 $ / 1 M de tokens | 6 $ / 1 M de tokens | Version de base décrite dans la publication officielle |
| Variante Grok 4.5 plus rapide | 4 $ / 1 M de tokens | 18 $ / 1 M de tokens | Variante premium à plus grande vitesse mentionnée dans l'article |
| Comparaison Opus 4.8 | Plus élevé dans de nombreuses comparaisons | Plus élevé dans de nombreuses comparaisons | Utilisé comme point de référence dans l'article |
| Comparaison GPT-5.5 | Plus élevé dans de nombreuses comparaisons | Plus élevé dans de nombreuses comparaisons | Utilisé comme point de référence dans l'article |
La conclusion pratique est simple : si un agent d'ingénierie doit lire, écrire, tester et itérer de manière répétée, le coût des tokens devient une contrainte majeure du produit. Grok 4.5 est conçu pour rendre cette boucle moins coûteuse.
L'article original met en avant une démonstration en une seule invite où Grok 4.5 crée une simulation du système solaire à l'aide de Three.js.
L'invite demande une simulation magnifique de l'univers et du système solaire avec un temps réglable, des mouvements réalistes, des orbites, des étoiles et un affichage tête haute moderne. La sortie comprend une simulation basée sur un navigateur avec le mouvement des planètes, l'accélération du temps, des contrôles, des étiquettes et une interface stylisée.
aliyuncs.com/cms-assets/image/2026/07/3a876f29-3629-4a70-8d27-339076f464da-09-520ff31e-7006-4e98-bbaf-43a66b9edad1.gif)
Ce type de démo est important car il teste bien plus que la simple syntaxe du code. Un bon modèle de génération front-end doit combiner :
Une seule démo ne prouve pas qu'un modèle est prêt pour la production, mais elle montre pourquoi les développeurs y prêtent attention. Grok 4.5 semble performant pour transformer des instructions générales de produit en artefacts complets et fonctionnels.
L'article a également recueilli les premiers tests utilisateurs de la communauté.
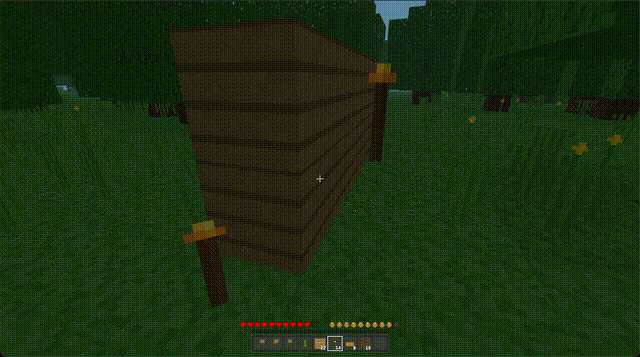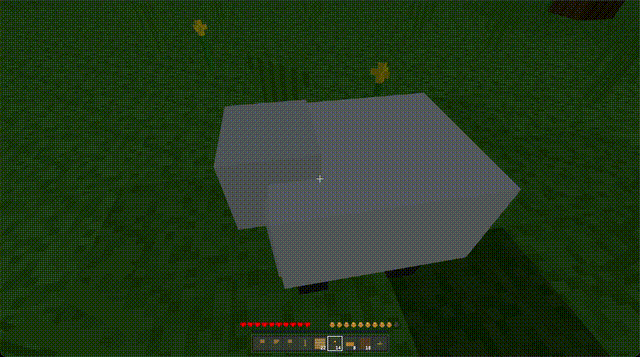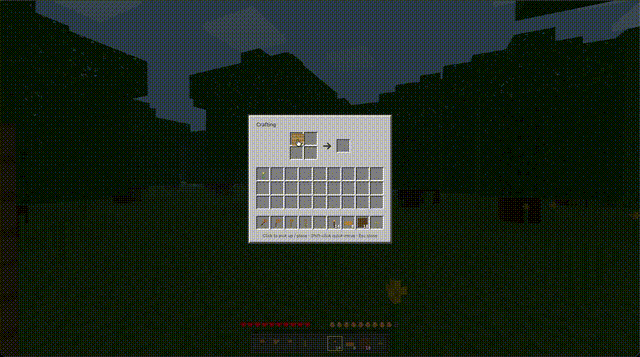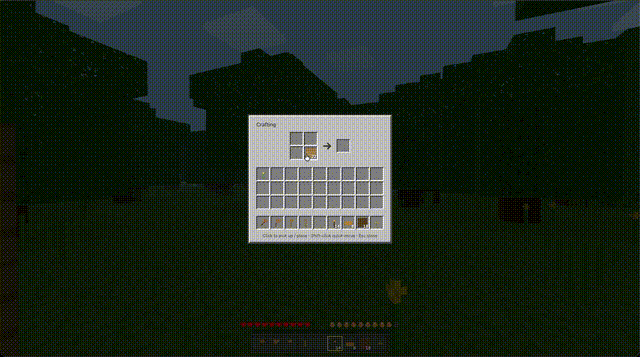
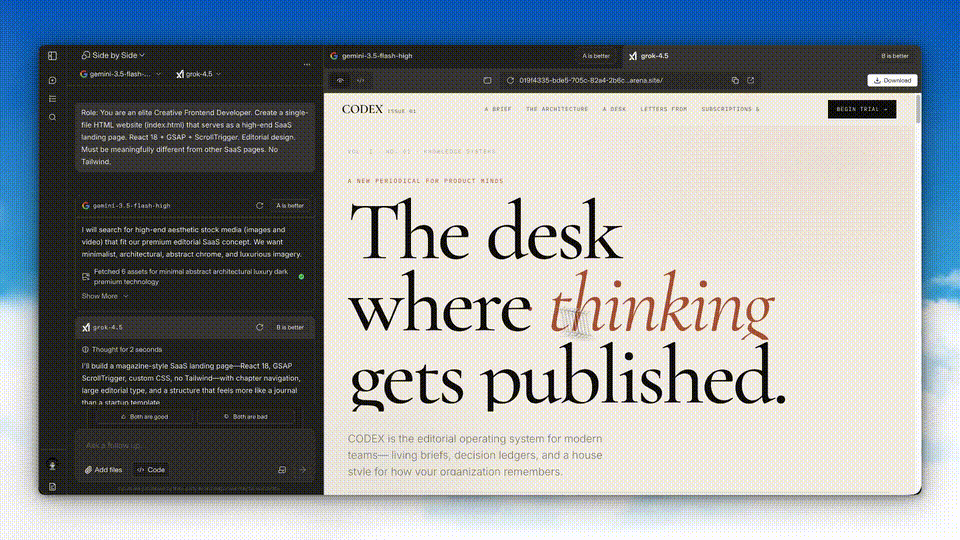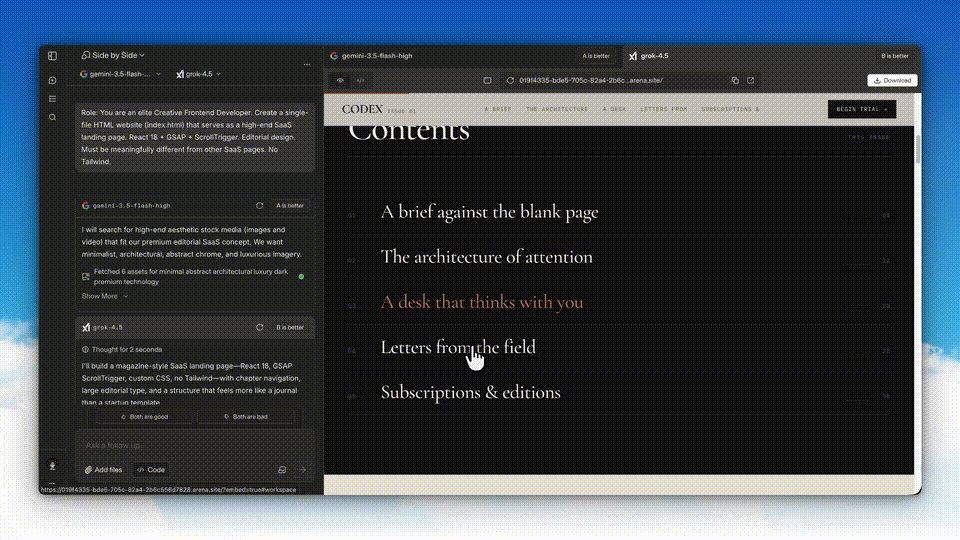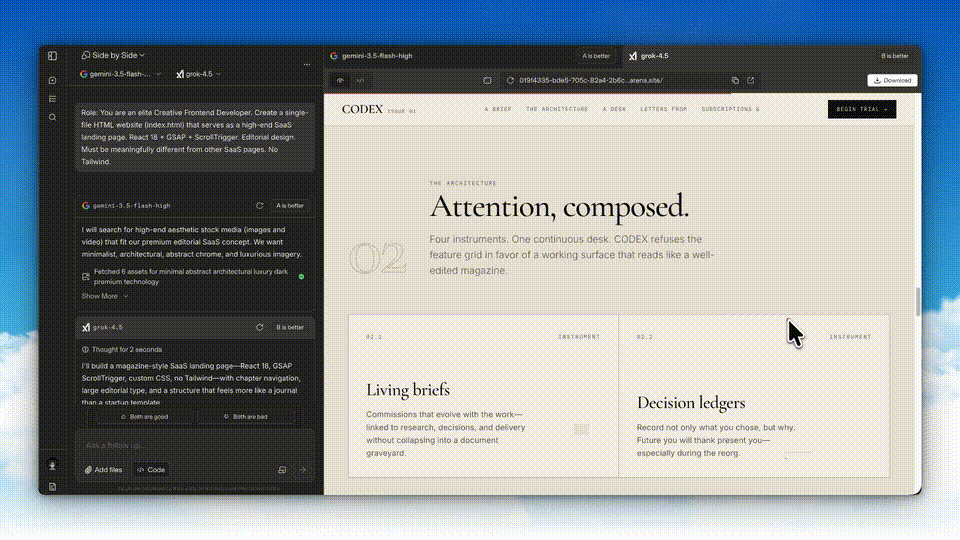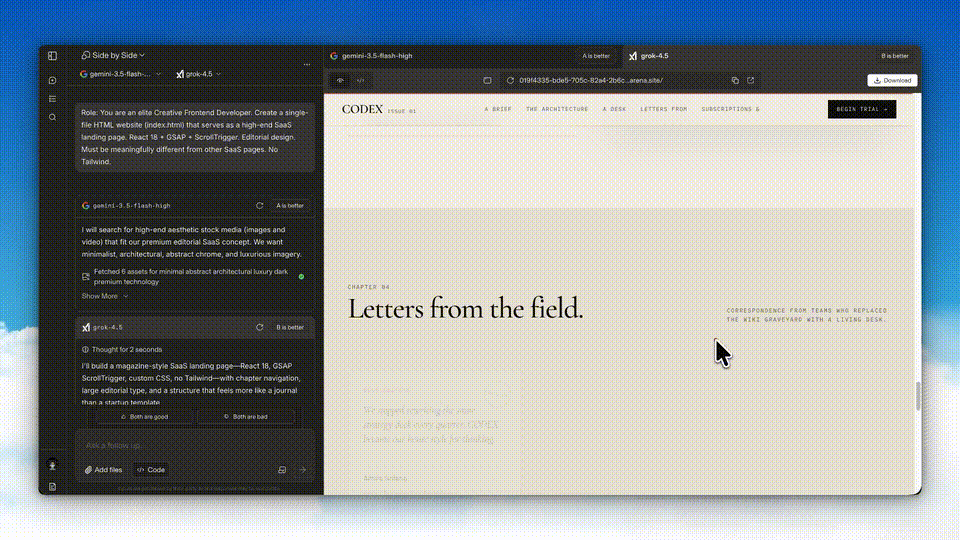
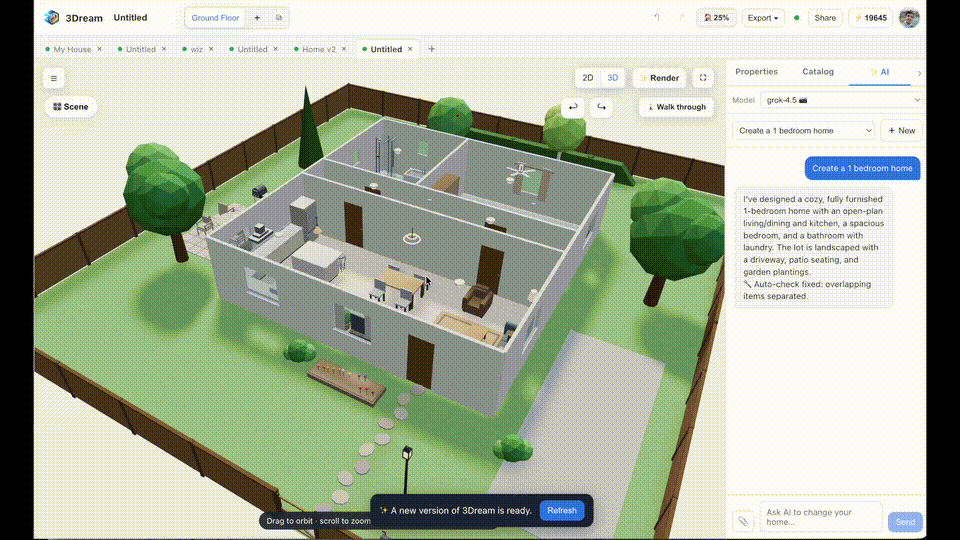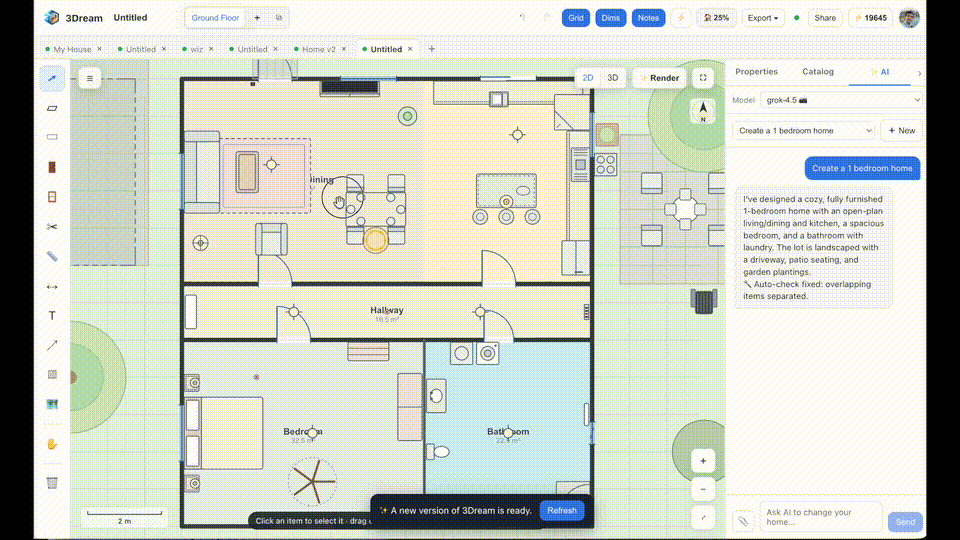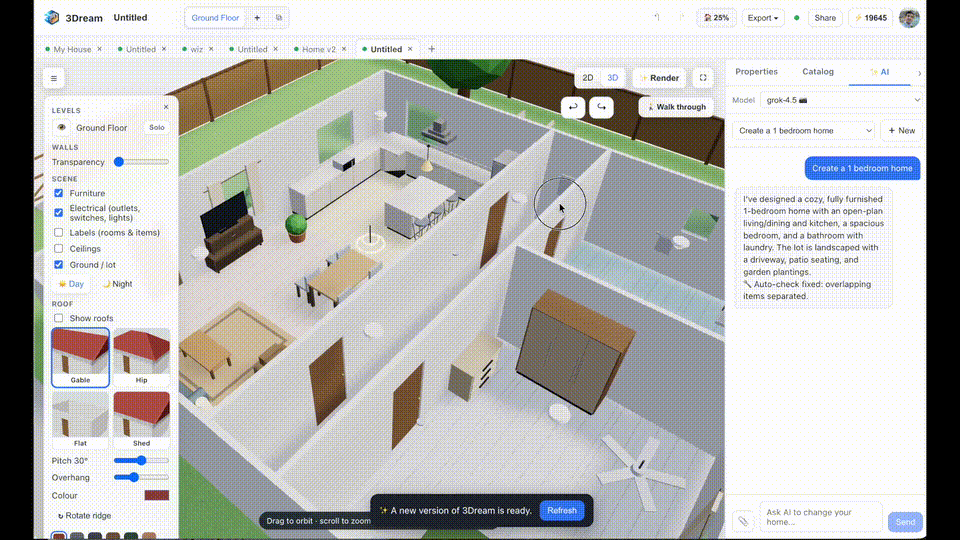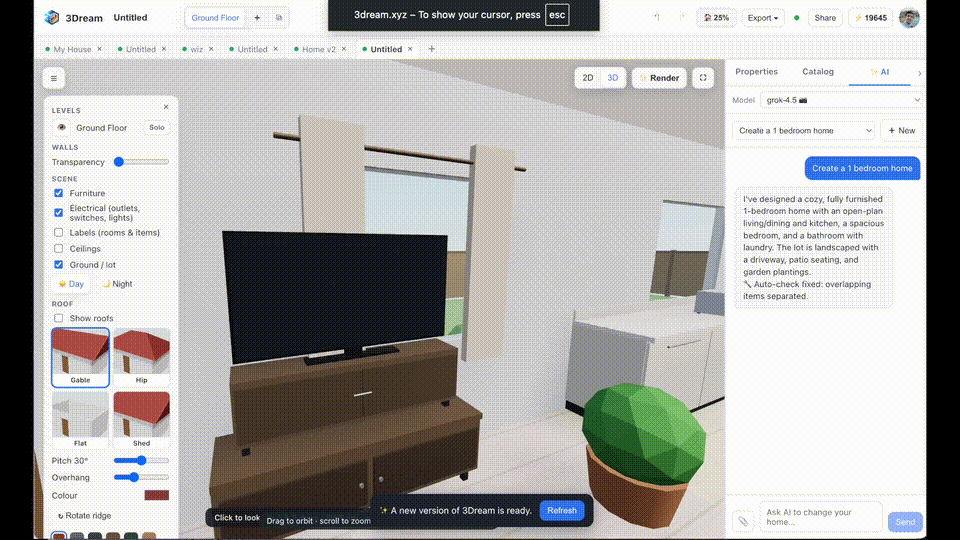
Un exemple montre Grok 4.5 générant une scène de type Minecraft. Un autre le montre créant une page d'accueil SaaS soignée dans un seul fichier HTML. On trouve aussi des exemples de travaux de design 2D et 3D, de génération de mise en page d'application, et de flux de travail simples de création de jeux.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Les résultats ne sont pas parfaitement uniformes. L'article mentionne également les critiques de certains développeurs qui ont estimé que Grok 4.5 n'était pas à la hauteur d'Opus 4.7 sur certains tests visuels ou de codage créatif, notamment une tâche de génération de style lampe à lave qui a donné de mauvais résultats.
Cette critique est utile. Elle permet de garder une évaluation objective. Un modèle peut être excellent en codage agentique et échouer sur certaines tâches esthétiques, de simulation physique ou de détail visuel.
Le rôle de Cursor dans Grok 4.5 est l'un des aspects les plus importants de cette publication.
Le blog de Cursor décrit Grok 4.5 comme un modèle entraîné en collaboration avec xAI et conçu pour plus que le simple génie logiciel. L'entraînement incluait des billions de jetons de données Cursor, capturant la manière dont les développeurs interagissent avec les codebases, les outils et les agents IA.
Il s'agit d'un type de signal différent du code statique. Le code statique enseigne au modèle le résultat final. Les données d'interaction développeur-agent enseignent le processus :
l'agent se remet après une tentative échouée.
7. Comment le changement final est vérifié.
Pour les agents de codage, ce signal de flux de travail peut être tout aussi important que les connaissances brutes en codage.
Cette version suggère que les modèles de codage IA évoluent vers trois objectifs pratiques :
Les modèles doivent gérer des tâches comportant de nombreuses étapes, pas seulement de courtes interactions question-réponse. Cela inclut la planification, la recherche, l'édition, les tests et la correction des erreurs.
Les équipes se préoccupent du coût final de résolution d'une tâche, pas seulement du prix par jeton du modèle. Si un modèle utilise beaucoup moins de jetons pour parvenir à une solution, il peut être moins cher même si son prix affiché est similaire.
Les agents de codage modernes opèrent dans des environnements d'outils. Ils doivent comprendre les terminaux, les éditeurs, les navigateurs, les gestionnaires de tickets, les arborescences de fichiers et les systèmes de construction. Un modèle entraîné sur des données réelles d'interaction développeur-agent peut avoir un avantage ici.
Le communiqué officiel de xAI indique que Grok 4.5 est disponible via Grok Build, Cursor et la console API xAI. La page officielle fournit également un exemple d'API simple.
curl -s https://api.x.ai/v1/responses \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "grok-4.5",
    "input": "Trouvez et corrigez le bug, puis expliquez-le : function median(a){a.sort();return a[a.length/2]}"
  }'
Les notes de version originales mentionnent également que Grok 4.5 n'était pas encore disponible dans l'UE au lancement, avec une disponibilité prévue ultérieurement. Si vous prévoyez de l'utiliser via l'API ou dans un produit, vérifiez toujours la documentation actuelle de xAI et la page des prix avant de construire autour.
D'après l'article et le cadre officiel de la version, Grok 4.5 semble particulièrement pertinent pour :
Ce n'est pas nécessairement le meilleur choix pour tous les cas d'utilisation. Pour les changements de production à haut risque, les résultats juridiques, les conseils financiers ou le travail sensible avec les clients, les équipes ont encore besoin de révision, de validation et d'approbation humaine.
Si vous souhaitez tester Grok 4.5 pour votre propre flux de travail, ne vous fiez pas uniquement aux démos publiques.
Utilisez des tâches réelles de votre propre équipe et comparez-le avec votre configuration de modèle actuelle. Une évaluation pratique devrait inclure :
Le meilleur modèle n'est pas
toujours celle qui obtient le meilleur score de référence. Pour de nombreuses équipes, le meilleur modèle est celui qui permet d’accomplir le travail validé au coût fiable le plus bas.
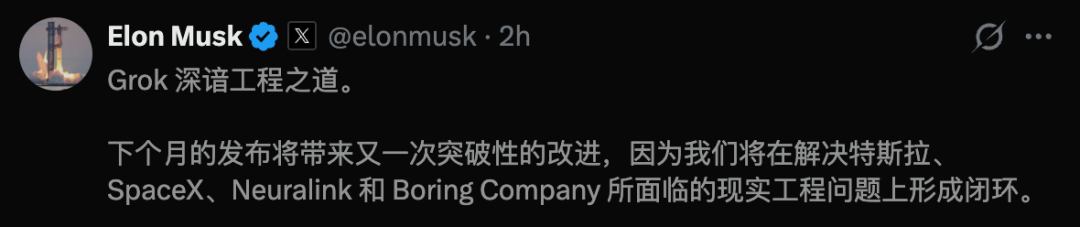
L’article se termine en notant que Musk a laissé entendre qu’une autre amélioration majeure arriverait le mois prochain.
Le message est que Grok 4.5 n’est peut-être pas le modèle « retourneur de table » ultime. Ce pourrait être une étape intermédiaire solide : non pas le modèle le plus fort en absolu, mais celui qui rend l’intelligence d’ingénierie de pointe moins chère et plus rapide à utiliser.
Cela pourrait suffire à changer la donne dans la compétition. Lorsque l’intelligence est mesurée comme l’électricité, le gagnant n’est pas seulement le modèle avec le score de pointe le plus élevé. Ce pourrait être le modèle capable de fournir un raisonnement solide à bas coût, rapidement et de manière répétée, dans des flux de travail réels.
Grok 4.5 est le modèle phare de xAI pour le codage, les tâches agentiques et le travail cognitif. Il est présenté comme le modèle le plus puissant de l’entreprise à ce jour et a été entraîné en collaboration avec Cursor.
Pas sur tous les indicateurs. L’article original rapporte que Grok 4.5 est proche de GPT-5.5 et Opus 4.8 sur plusieurs benchmarks d’ingénierie, mais Claude Fable mène toujours certaines évaluations de pointe. Le principal avantage de Grok 4.5 réside dans la combinaison de la rapidité, du coût et de l’efficacité des tokens.
Le lancement officiel indique Grok 4.5 à 2 $ par million de tokens en entrée et 6 $ par million de tokens en sortie. Une variante premium plus rapide est également mentionnée : 4 $ par million de tokens en entrée et 18 $ par million de tokens en sortie. Veuillez toujours consulter la page tarifaire actuelle de xAI avant toute utilisation en production.
Il est conçu pour le codage, le génie logiciel, les tâches agentiques et le travail cognitif. L’article met en avant ses performances sur SWE Bench Pro, Terminal Bench 2.1 et DeepSWE, ainsi que des exemples impliquant la génération front-end, des démos Three.js et des prototypes de type jeu.
Cursor a collaboré avec xAI sur Grok 4.5, et l’entraînement a inclus de grandes quantités de données d’interaction de Cursor. Ces données reflètent la manière dont les développeurs travaillent avec les bases de code, les outils et les agents, ce qui peut aider le modèle à mieux performer dans des flux de travail réels en génie logiciel.
L’article indique que Grok 4.5 a utilisé en moyenne 15 954 tokens de sortie sur les tâches SWE Bench Pro, contre 67 020 tokens de sortie pour Opus 4.8. Cela signifie que Grok 4.5 aurait résolu des tâches similaires avec beaucoup moins de tokens générés, réduisant ainsi les coûts et la latence.
Oui. Le lancement officiel de xAI précise que Grok 4.5 est disponible via la console API de xAI. Le lancement fournit également un exemple de commande curl utilisant le point de terminaison responses et le nom du modèle grok-4.5.
Oui. L'annonce officielle de Cursor indique que Grok 4.5 est disponible dans Cursor sur les plateformes desktop, web, iOS, CLI et SDK. Cursor précise également que les formules individuelles et en équipe incluent l'utilisation de ce modèle dans le cadre du pool de modèles propriétaires.
Grok 4.5 se présente comme un modèle rapide et économique pour le codage, les workflows agentiques et le travail de connaissance. Il obtient d'excellents résultats sur les benchmarks d'ingénierie, bénéficie des données de collaboration de Cursor et utilise beaucoup moins de tokens de sortie que certains modèles leaders sur les tâches SWE Bench Pro.
Sa plus grande valeur ne réside pas dans le fait qu'il bat tous les modèles sur tous les terrains. Le point le plus important est qu'il combine une intelligence compétitive avec une utilisation réduite de tokens, une inférence plus rapide et des tarifs agressifs.
Pour les équipes qui construisent des agents de codage IA, cette combinaison compte. Le coût par tâche acceptée, la charge de révision, l'utilisation d'outils et la reprise après échec peuvent peser plus lourd qu'un simple score sur un classement.
Le véritable message de Grok 4.5 est simple : la prochaine course aux modèles ne porte pas uniquement sur qui est le plus intelligent, mais sur qui peut fournir une intelligence utile plus rapidement et à moindre coût.
Partez d’une phrase et obtenez un site complet en quelques minutes.



