For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/grok-45-coding-benchmarks-token-efficiency.md.
Grok 4.5 est un modèle de pointe conçu pour le codage, les agents et le travail de connaissances. Ses principaux avantages pratiques sont la...
Grok 4.5 replace xAI au premier rang de la course aux modèles de codage.
Publié le 8 juillet 2026, ce modèle est conçu pour l'ingénierie logicielle, les tâches agentiques et le travail de connaissance plus large. Il a été entraîné avec Cursor et est désormais disponible via l'API xAI, Grok Build et Cursor. Le point principal n'est pas seulement la qualité du modèle. Grok 4.5 se distingue également par un service plus rapide, moins de tokens générés et un coût inférieur par tâche accomplie.
La documentation officielle du modèle indique une fenêtre de contexte de 500 000 tokens, une entrée texte et image, un raisonnement configurable, l'appel de fonctions, la prise en charge des sorties structurées, et une tarification API de 2 $ par million de tokens d'entrée et 6 $ par million de tokens de sortie.
Cet article explique où Grok 4.5 performe bien, comment interpréter ses affirmations d'efficacité, ce qui a changé dans l'entraînement, et pourquoi la pile d'inférence environnante pourrait devenir aussi importante que le modèle lui-même.
[L'image montre un tweet d'Elon Musk, fondateur de SpaceX AI, publié le 8 juillet 2026. Il indique que, sur la base des retours positifs des clients en phase de test, SpaceX AI publiera demain la version Grok 4.5 au public. Ce modèle appartient à la série Opus, mais fonctionne plus rapidement, avec une efficacité de traitement supérieure et un coût réduit. Le tweet affiche l'heure 14h21, la date du 8 juillet 2026, et 5,3 millions de vues. Ce tweet correspond au contenu du document présentant la publication et les caractéristiques du modèle Grok 4.5.]
Grok 4.5 est le modèle phare de xAI pour le codage, le travail agentique et les tâches de connaissance générales basées sur ordinateur. Les supports de lancement officiels le décrivent comme un modèle capable de gérer des travaux de longue durée, d'utiliser des outils, de se remettre d'erreurs et de vérifier les résultats, au lieu de s'arrêter après une seule réponse.
Cela le place dans la même catégorie générale que les modèles haut de gamme utilisés pour le codage autonome, les modifications au niveau du dépôt, la recherche technique, l'analyse de données et les workflows bureautiques en plusieurs étapes.
| Élément | Grok 4.5 |
|---|---|
| Nom du modèle | grok-4.5 |
| Cas d'utilisation principaux | Codage, tâches agentiques, travail de connaissance |
| Modalités d'entrée | Texte et images |
| Modalité de sortie | Texte |
| Fenêtre de contexte | 500 000 tokens |
| Raisonnement | Configurable |
| Appel de fonctions | Pris en charge |
| Sorties structurées | Pris en charge |
| Prix d'entrée | 2 $ par million de tokens |
| Prix d'entrée en cache | 0,50 $ par million de tokens |
| Prix de sortie | 6 $ par million de tokens |
| Vitesse de service rapportée | Jusqu'à 80 tokens par seconde |
| Disponibilité | API xAI, Grok Build, Cursor |
La fenêtre de contexte de 500K est suffisamment grande pour des bases de code substantielles, de longs documents techniques, des investigations multi-fichiers et des historiques d'agents étendus. Une grande fenêtre de contexte ne garantit pas automatiquement de meilleurs résultats, mais elle donne aux outils plus de marge pour fournir du matériel source pertinent sans troncature agressive.
L'annonce officielle de xAI publie les résultats de plusieurs évaluations en génie logiciel. Grok 4.5 n'est pas le meilleur modèle sur tous les benchmarks, mais il reste compétitif avec d'autres systèmes de pointe.
| Benchmark | Grok 4.5 | Résultats de comparaison sélectionnés |
|---|---|---|
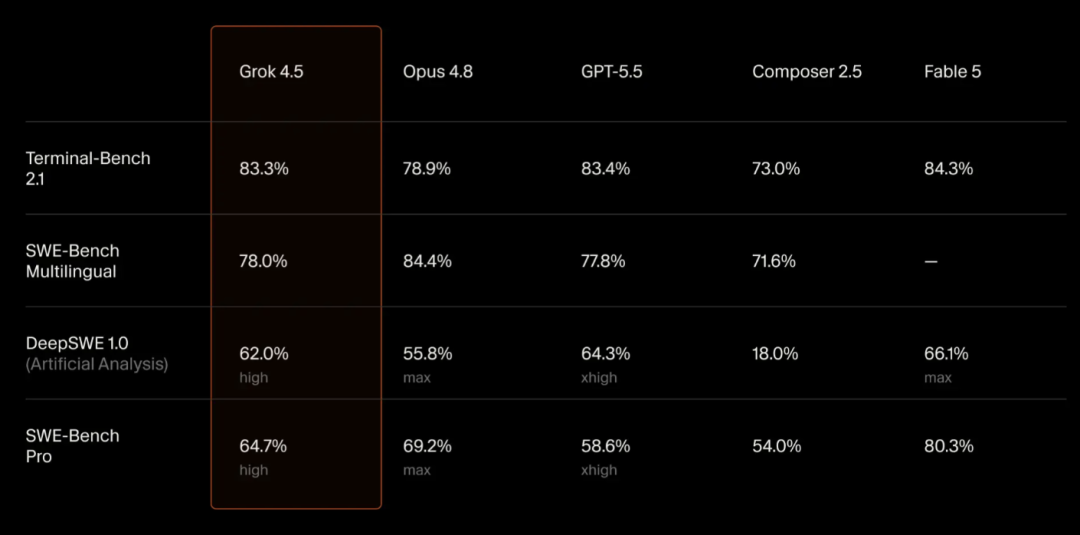
| DeepSWE 1.0 | 62,0 % | Fable max 66,1 % ; GPT-5.5 xhigh 64,31 % ; Opus 4.8 max 55,75 % |
| DeepSWE 1.1 | 53,0 % | Fable max 70 % ; GPT-5.5 xhigh 67 % ; |
Opus 4.8 max 59 % |
| Terminal-Bench 2.1 | 83,3 % | Fable max 84,3 % ; GPT-5.5 xhigh 83,4 % ; Opus 4.8 max 78,9 % |
| SWE-Bench Pro | 64,7 % | Fable max 80,4 % ; Opus 4.8 max 69,2 % ; Opus 4.7 max 64,3 % |
| SWE Marathon | 29,0 % | Opus 4.8 max 26,0 % ; Fable max 24,0 % ; Opus 4.7 max 16,0 % |
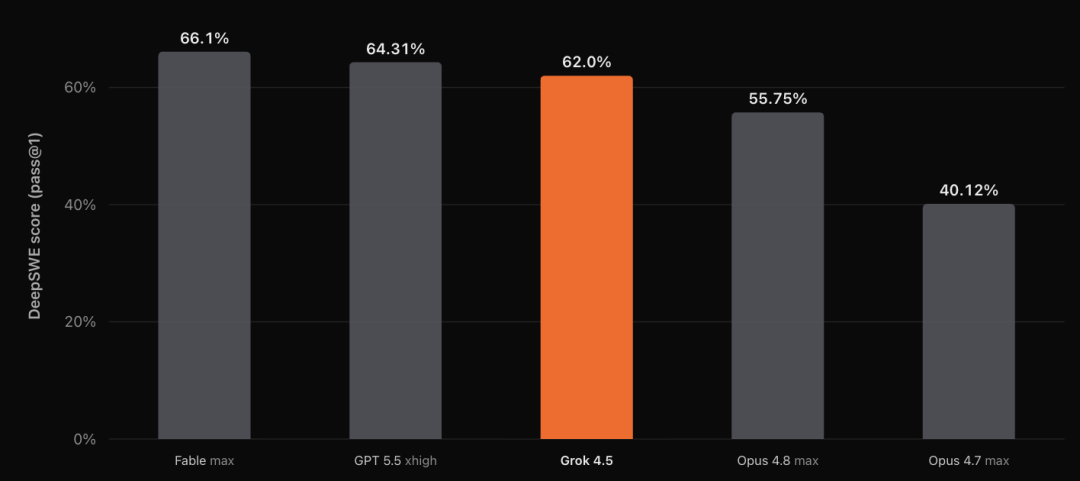
Ces chiffres suggèrent un modèle particulièrement performant pour les tâches en terminal, les tâches d'ingénierie pratique et les workflows agentiques plus longs. Ils doivent néanmoins être interprétés avec prudence. Les environnements de test, les paramètres de raisonnement, l'accès aux outils et les configurations spécifiques au fournisseur peuvent influencer les résultats.
Cursor a également révélé qu'un instantané plus ancien de la base de code de Cursor était accidentellement présent dans les données d'entraînement, ce qui pourrait affecter CursorBench. L'entreprise a exclu ce benchmark de sa comparaison publique et a déclaré que ces données ne seraient pas utilisées pour les futurs modèles.
L'affirmation la plus pratique concernant Grok 4.5 est son efficacité.
xAI indique que le modèle sert jusqu'à 80 tokens par seconde. C'est suffisamment rapide pour rendre les longues traces de raisonnement, les modifications de dépôt et les boucles agentiques itératives plus réactives que les modèles premium plus lents.
L'entreprise rapporte également que Grok 4.5 a utilisé en moyenne 15 954 tokens de sortie par tâche SWE-Bench Pro, contre 67 020 tokens de sortie pour Opus 4.8 dans son réglage maximal. Cela représente environ 4,2 fois moins de tokens de sortie sur la charge de travail mesurée.
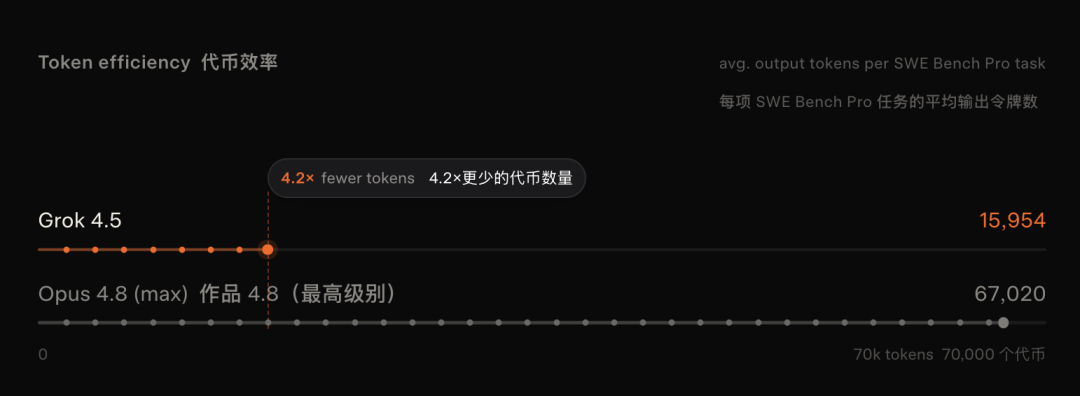
L'efficacité des tokens est importante pour trois raisons :
La métrique importante n'est pas simplement le prix par million de tokens. Les équipes doivent comparer le coût de réalisation de la même tâche à un niveau de qualité acceptable. Un modèle avec un prix de token catalogue plus élevé peut encore être moins cher s'il nécessite moins de tentatives, moins d'appels d'outils ou moins de
jetons générés.
Le prix de base de l'API est le suivant :
| Type de jeton | Prix |
|---|---|
| Entrée | 2 $ par million de jetons |
| Entrée en cache | 0,50 $ par million de jetons |
| Sortie | 6 $ par million de jetons |
Cursor propose également une variante plus rapide à 4 $ par million de jetons d'entrée** et 18 $ par million de jetons de sortie dans sa propre offre de modèles. Les prix et la disponibilité peuvent varier selon la plateforme, les équipes de production doivent donc confirmer le taux dans l'environnement qu'elles utilisent réellement.
Grok 4.5 est conçu pour faire plus que compléter une fonction ou expliquer une erreur. Les exemples officiels incluent :
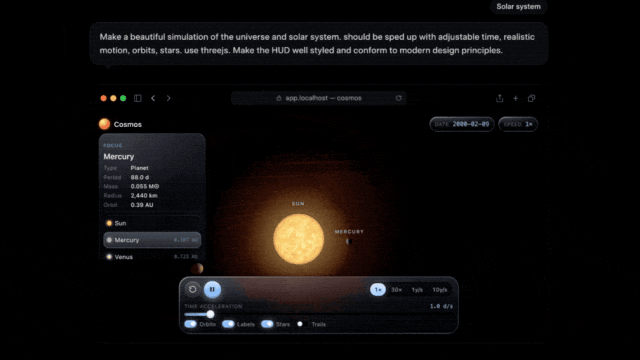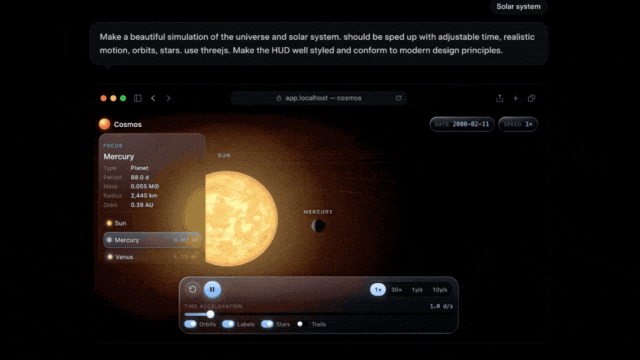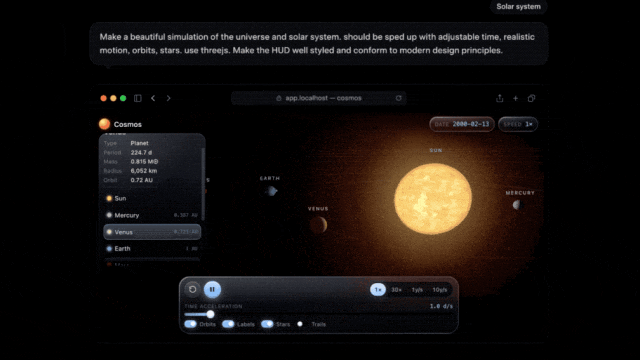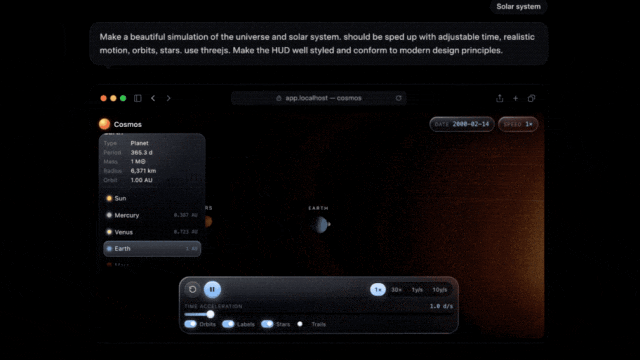
La démo du système solaire est utile car elle combine le design, le code front-end, le rendu 3D, les contrôles et la logique d'interaction. Ce n'est pas la preuve que chaque application issue d'une seule invite sera prête pour la production, mais cela montre le type de tâche intégrée que le modèle est optimisé pour gérer.
Grok 4.5 s'étend également au travail de bureau. Dans les documents de lancement, il crée des diapositives structurées de revue d'entreprise et travaille avec des feuilles de calcul impliquant des formules, des recherches web et plusieurs feuilles.

Pour les équipes de développement, un flux de travail pratique pourrait ressembler à ceci :
Un modèle peut être rapide et performant tout en produisant des hypothèses incorrectes, des changements dangereux ou une validation incomplète. La meilleure utilisation des modèles de codage agentiques est généralement l'automatisation structurée avec des preuves visibles, et non l'autonomie sans restriction.
Les gains d'efficacité ne sont pas présentés comme une simple optimisation de service. xAI et Cursor décrivent tous deux des changements dans l'architecture du modèle, la préparation des données, l'apprentissage par renforcement et l'entraînement distribué.
Cursor décrit Grok 4.5 comme un modèle à mélange d'experts. Dans un système MoE, seule une partie du réseau est activée pour un jeton ou une tâche donnée. Cela peut augmenter la capacité totale du modèle sans exiger que chaque paramètre participe à chaque étape d'inférence.
Les sources officielles ne publient pas suffisamment de détails d'implémentation pour calculer la puissance de calcul exacte utilisée par jeton. Il est donc plus précis de se concentrer sur le comportement mesuré — vitesse, qualité des benchmarks et consommation de jetons — plutôt que de déduire les performances d'un nombre de paramètres non vérifié.
xAI indique que Grok 4.5 a été entraîné sur des dizaines de milliers de GPU NVIDIA GB300. Un entraînement à cette échelle nécessite plus que du matériel brut. Les longues durées d'exécution exigent des systèmes distribués stables, une reprise après point de contrôle, une mise en réseau, des pipelines de données et une surveillance capables de maintenir des milliers d'accélérateurs productifs.
L'annonce met l'accent sur les techniques de stabilité conçues pour les très grands entraînements. Cela est important car une défaillance dans une expérience longue peut gaspiller une grande quantité de calcul si le système ne peut pas récupérer efficacement.
Le pipeline d'entraînement comprenait :
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
L'objectif est d'améliorer la densité des signaux d'entraînement utiles au lieu de se fier uniquement au volume brut de jetons. Les données répétées, de faible qualité ou faiblement pertinentes peuvent augmenter le coût d'entraînement sans apporter la même amélioration que des exemples soigneusement sélectionnés.
Cursor indique que le modèle a été entraîné avec des billions de jetons de données Cursor. Selon l'entreprise, l'ensemble de données capture les interactions entre utilisateurs, bases de code, outils logiciels et agents.
Cette distinction est importante. Un ensemble de données uniquement basé sur du code enseigne la syntaxe, les motifs, les bibliothèques et les implémentations courantes. Les données d'interaction peuvent également enseigner la séquence de travail :
Cela aide à expliquer pourquoi Grok 4.5 est positionné autour du génie logiciel plutôt que de la complétion de code isolée.
xAI indique que son programme d'apprentissage par renforcement couvre des centaines de milliers de tâches, en se concentrant sur le génie logiciel multi-étapes et d'autres travaux techniques.
Cursor décrit des environnements qui entraînent le modèle à :
Les entreprises ont également construit des systèmes d'agents distribués pour générer, tester et affiner ces environnements d'entraînement à grande échelle. Certains déploiements d'agents peuvent durer des heures tandis que le processus d'entraînement plus large se poursuit de manière asynchrone.
Il s'agit d'un changement significatif par rapport à l'optimisation étroite des benchmarks. Le modèle est entraîné non seulement à produire une réponse finale correcte, mais aussi à naviguer dans le processus qui y mène.
à un.
Les poids des modèles ne sont qu'une partie du produit final.
Une déclaration publique d'Elon Musk a indiqué que Grok 4.5 n'utilisait pas encore le logiciel d'inférence en C/C++ développé en interne par xAI, spécifiquement adapté au matériel GB300. Il a suggéré que la pile optimisée pourrait potentiellement doubler la vitesse de service, voire l'améliorer encore.
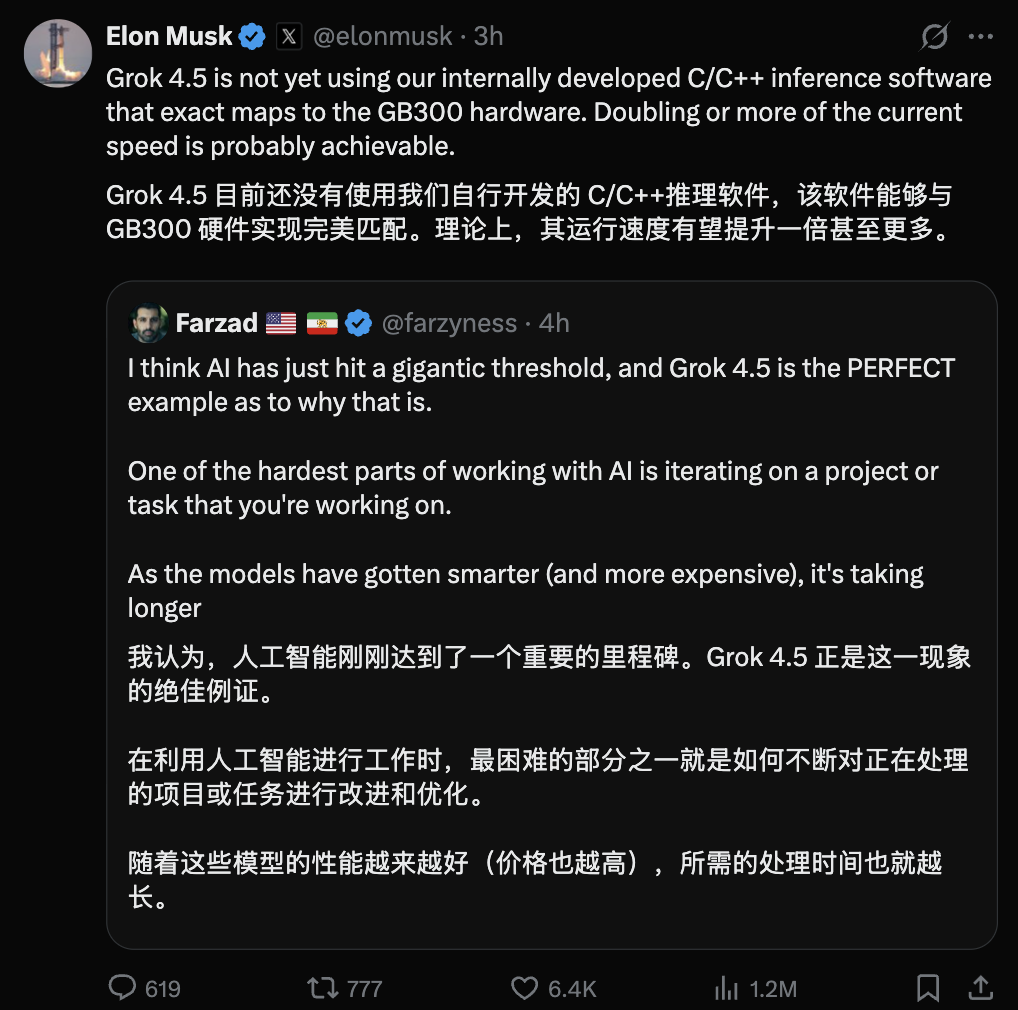
Il s'agit d'une affirmation prospective plutôt que d'un résultat de production mesuré, elle ne doit donc pas être considérée comme une performance garantie. Néanmoins, cela met en évidence la direction que prend la compétition entre les modèles.
Lorsque les modèles de pointe se rapprochent en termes de qualité des références, le système environnant peut créer un avantage pratique :
Pour les utilisateurs, cela signifie que les comparaisons de modèles devraient inclure plus qu'un simple score d'intelligence. Un modèle qui répond plus rapidement, produit moins de jetons, utilise efficacement le cache et accomplit des tâches avec moins de tentatives peut offrir une meilleure valeur réelle, même si un autre modèle domine sur un benchmark.
Grok 4.5 est disponible via l'API Responses de xAI. L'exemple Python suivant utilise l'interface client compatible OpenAI :
import os
from openai import OpenAI

api_key = os.environ.get("XAI_API_KEY")
if not api_key:
    raise RuntimeError("Définissez d'abord la variable d'environnement XAI_API_KEY.")

client = OpenAI(
    api_key=api_key,
    base_url="https://api.x.ai/v1",
)

response = client.responses.create(
    model="grok-4.5",
    input=(
        "Examinez cette fonction JavaScript, corrigez le bug, "
        "et expliquez le changement : "
        "function median(values) { values.sort(); "
        "return values[values.length / 2]; }"
    ),
)

print(response.output_text)
Avant d'utiliser le modèle en production :
Grok 4.5 est le modèle de pointe de xAI pour le codage, les tâches agentiques et le travail de connaissance. Il prend en charge l'entrée de texte et d'images, le raisonnement configurable, l'appel de fonctions et les sorties structurées.
La documentation officielle du modèle xAI répertorie une fenêtre de contexte de 500 000 jetons. La fenêtre de contexte réellement utilisable peut dépendre du format de la requête, de la sortie des outils et des limites spécifiques à la plateforme.
Le prix de base publié est de 2 $ par
1 million de tokens en entrée, 0,50 $ par million de tokens en entrée mis en cache, et 6 $ par million de tokens en sortie. Les variantes spécifiques à une plateforme ou les services prioritaires peuvent appliquer des tarifs différents.
La réponse dépend des critères de référence et du flux de travail. Grok 4.5 est compétitif sur plusieurs tests d'ingénierie et mène dans certaines comparaisons, tandis que d'autres modèles restent en tête sur d'autres aspects. La vitesse, l'utilisation des tokens, la fiabilité des outils et le coût d'achèvement des tâches doivent être évalués parallèlement aux scores des benchmarks.
xAI rapporte que Grok 4.5 a utilisé en moyenne 15 954 tokens de sortie par tâche SWE-Bench Pro, contre 67 020 pour Opus 4.8 dans son réglage maximal. Cela représente environ 4,2 fois moins de tokens de sortie pour la charge de travail mesurée.
Oui. La page officielle du modèle répertorie l'entrée de texte et d'images avec une sortie de texte. Cela le rend adapté à des tâches telles que l'analyse de captures d'écran, la révision de documents et le contexte visuel dans un flux de travail agentique.
Oui. Cursor indique que Grok 4.5 est disponible dans ses expériences de bureau, web, iOS, CLI et SDK. Les limites d'utilisation et les tarifs dépendent du plan Cursor sélectionné.
Il peut être utilisé comme modèle de raisonnement au sein d'un agent de production, mais le système environnant nécessite toujours des contrôles d'autorisation, une validation, une observabilité, des tentatives et une approbation humaine pour les actions à fort impact. La force du benchmark ne supprime pas la nécessité de garde-fous opérationnels.
Grok 4.5 est un modèle de pointe destiné au codage, aux agents et au travail de connaissance. Ses avantages pratiques les plus marquants sont
La combinaison de performances d'ingénierie compétitives, d'un service capable de délivrer jusqu'à 80 tokens par seconde, d'une fenêtre contextuelle de 500 000 tokens et d'une consommation moindre de tokens dans la comparaison publiée de SWE-Bench Pro.
L'approche d'entraînement combine une infrastructure à grande échelle, des données organisées, les traces d'interaction de Cursor et l'apprentissage par renforcement dans des environnements réalistes d'utilisation d'outils. Cela aide le modèle à passer de la génération de code isolée à des flux de travail plus longs et de bout en bout.
L'histoire principale n'est pas seulement que Grok est devenu plus performant ; c'est que xAI rivalise sur le coût total et la rapidité d'exécution des tâches réelles.
Partez d’une phrase et obtenez un site complet en quelques minutes.



