For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/h-jepa-explained-hierarchical-jepa-world-f7e48311.md.
La start-up de modèles du monde de Yann LeCun, **Advanced Machine Intelligence (AMI)**, a publié l’un de ses premiers résultats de recherche...
La start-up de modèles du monde de Yann LeCun, Advanced Machine Intelligence (AMI), a publié l’un de ses premiers résultats de recherche majeurs.
Dans l’article H-JEPA: End-to-End Learning of Hierarchical World Models for Visual Planning, des chercheurs d’AMI, de l’Université de New York, d’INRIA Paris et de l’Université Brown présentent un modèle du monde hiérarchique composé de plusieurs JEPA conditionnés par l’action.
L’idée centrale est simple : au lieu de contraindre une seule représentation latente à gérer à la fois le contrôle moteur immédiat et la planification à long terme, H-JEPA attribue à chaque niveau de la hiérarchie une échelle temporelle et un espace de représentation différents.
Les niveaux supérieurs se projettent plus loin dans l’avenir et planifient à un niveau plus abstrait. Les états intermédiaires prédits deviennent des sous-objectifs pour les niveaux inférieurs, qui les affinent progressivement jusqu’à ce que le système produise des actions exécutables.
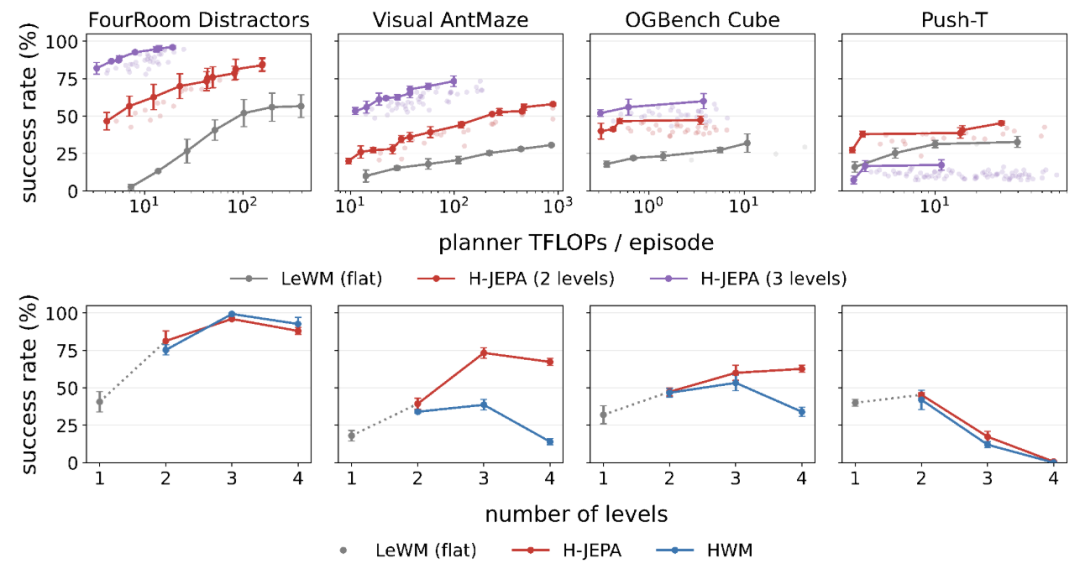
Sur Visual AntMaze, H-JEPA à trois niveaux atteint environ 73,3 % de réussite en planification, contre 18,0 % pour la référence LeWorldModel plate, tout en offrant un meilleur compromis entre réussite et puissance de calcul.
Le projet s’inscrit dans l’orientation de recherche ouverte mise en avant par AMI depuis son lancement. Les auteurs ont publié le code d’entraînement et d’évaluation, les points de contrôle préentraînés ainsi que les jeux de données associés.
Le dépôt GitHub officiel est distribué sous licence MIT. Le dépôt des points de contrôle H-JEPA publié sur Hugging Face est également indiqué sous licence MIT, tandis que le dépôt de données associé est publié sous licence CC BY 4.0.
LeCun défend la planification hiérarchique depuis plusieurs années.
L’intuition sous-jacente ressemble à la manière dont les humains planifient des tâches complexes dans le monde réel.
Imaginez que vous soyez assis dans un bureau de l’Université de New York et que vous décidiez de vous rendre à Paris.
Au niveau le plus élevé, les informations importantes sont la destination, le vol et l’horaire. Une fois cette décision prise, le niveau suivant devient plus concret : quitter le bureau, descendre, rejoindre l’aéroport et monter dans l’avion.
Au niveau le plus bas, l’attention se déplace encore. Descendre un escalier exige des informations sur le sol, la marche suivante et les mouvements du corps. Des détails qui étaient sans importance lors du choix d’un vol transatlantique deviennent soudainement essentiels.
Le même problème apparaît en robotique.
Un planificateur de haut niveau doit comprendre l’objectif de la tâche, les relations spatiales et la direction générale du déplacement. Un contrôleur de bas niveau a besoin d’informations précises sur le mouvement immédiat et la configuration du corps.
Si une seule représentation doit préserver chaque détail à toutes les échelles temporelles, la planification devient inutilement difficile.
Par exemple, un quadrupède peut déjà se trouver au bon endroit alors que la pose de ses pattes diffère de celle de l’image cible. Une représentation qui accorde trop d’importance aux détails des pattes, qui évoluent rapidement, peut conclure à tort que le robot est éloigné de la cible, même si sa position pertinente pour la tâche est déjà correcte.
L’article H-JEPA aborde ce problème en posant une question plus précise :
Chaque niveau peut-il apprendre les informations qui comptent à sa propre échelle temporelle, tout en permettant au plan de haut niveau d’être traduit en actions de bas niveau ?
H-JEPA attribue trois composants principaux à chaque niveau de la hiérarchie :
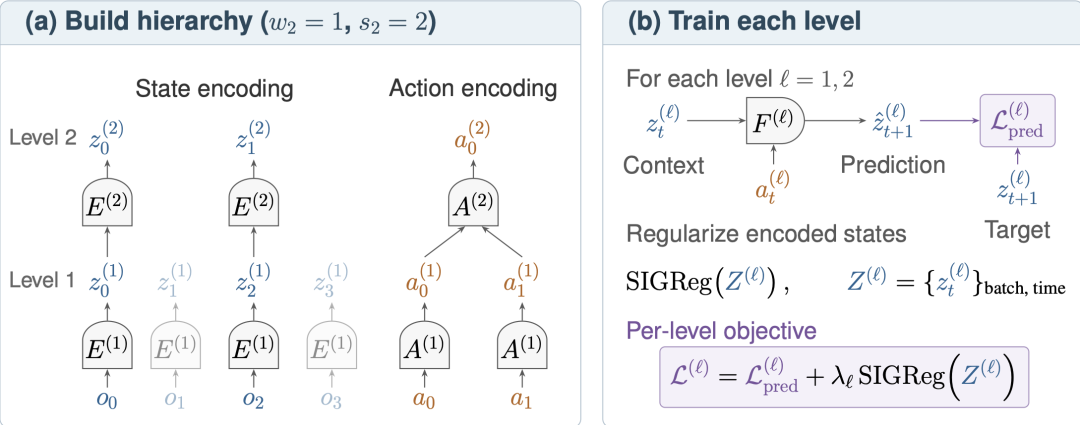
L’encodeur d’état extrait une représentation latente de l’environnement.
Au niveau le plus bas, l’encodeur fonctionne directement sur les observations visuelles. Les niveaux supérieurs reçoivent les représentations des niveaux inférieurs et apprennent des versions progressivement plus abstraites de l’état.
Cela permet aux niveaux supérieurs d’écarter les détails qui évoluent rapidement, qui sont difficiles à prédire sur de longues périodes ou qui ne sont pas pertinents pour la planification à long terme.
Dans les expériences Visual AntMaze, les niveaux supérieurs suppriment progressivement les informations relatives à la pose des pattes de la fourmi, tout en conservant les informations sur sa position et la configuration du labyrinthe.
C’est exactement le type d’abstraction que la hiérarchie est censée apprendre.
L’encodeur d’action décrit l’effet des actions à chaque échelle temporelle.
Au niveau le plus bas, les actions correspondent à des changements de contrôle relativement concrets. Aux niveaux supérieurs, plusieurs actions de bas niveau sont compressées en une représentation plus grossière de la manière dont l’état évolue sur une période plus longue.
Chaque couche dispose ainsi d’une résolution temporelle différente.
Dans la configuration présentée, une étape de prédiction de niveau supérieur couvre davantage d’étapes de l’environnement que le niveau inférieur.
Le prédicteur combine l’état latent actuel et l’action encodée afin d’estimer l’état latent futur.
Chaque niveau apprend donc son propre modèle du monde conditionné par l’action.
La principale différence avec un modèle du monde plat est que H-JEPA ne demande pas à chaque niveau de prédire dans un espace latent partagé.
Au contraire, chaque niveau peut développer une représentation adaptée à son propre horizon temporel.
Au moment de l’inférence, la planification progresse du sommet de la hiérarchie vers le bas.
Le niveau supérieur recherche d’abord un chemin grossier vers l’objectif final.
L’état intermédiaire qu’il prédit devient ensuite un sous-objectif pour le niveau inférieur. Celui-ci recherche un plan plus précis permettant d’atteindre le sous-objectif attribué, puis le processus continue jusqu’à ce que le niveau le plus bas produise des actions élémentaires.
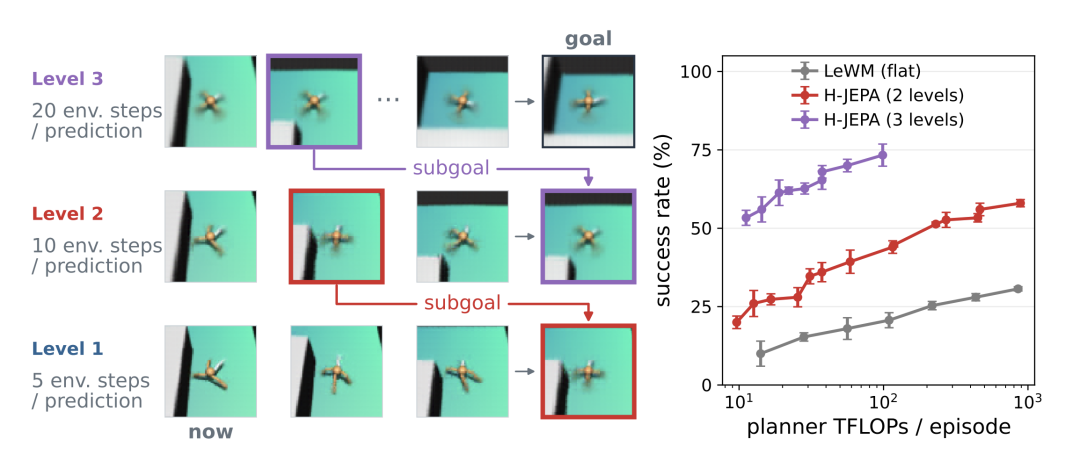
Cette méthode produit un processus de planification allant du général au particulier :
Après l’exécution d’un préfixe d’action, le système observe le nouvel état et planifie à nouveau.
Cette replanification répétée permet à la hiérarchie de réagir à l’environnement réel plutôt que de s’engager dans un unique plan en boucle ouverte de longue durée.
La hiérarchie est entraînée de bout en bout.
Cela signifie que les niveaux ne sont pas entraînés comme des modules isolés. Les objectifs de niveau supérieur peuvent influencer les encodeurs de niveau inférieur, ce qui permet à l’ensemble de la hiérarchie de représentation de se développer conjointement.
Cependant, l’entraînement des modèles du monde présente un mode d’échec classique : l’effondrement des représentations.
Si un encodeur associe chaque état d’entrée au même vecteur latent, un prédicteur peut produire trivialement ce même vecteur et obtenir une faible erreur de prédiction sans rien apprendre d’utile sur l’environnement.
H-JEPA répond à ce problème en utilisant SIGReg, ou Sketched Isotropic Gaussian Regularization, introduite dans les travaux antérieurs LeJEPA de Randall Balestriero et Yann LeCun.
SIGReg contraint la distribution latente afin que différentes observations ne s’effondrent pas sur une même représentation.
Le modèle LeWorldModel antérieur appliquait ce type de régularisation à l’entraînement de bout en bout d’un modèle du monde à partir de pixels. H-JEPA utilise LeWorldModel comme fondation de son niveau le plus bas, puis ajoute des niveaux JEPA supplémentaires au-dessus.
Cela préserve le principe fondamental de JEPA : prédire des représentations utiles du futur plutôt que de reconstruire chaque pixel futur.
L’article évalue H-JEPA dans quatre environnements simulés de navigation et de manipulation :
Il évalue également la planification hors ligne sur des trajectoires de robots réels issues du jeu de données DROID.
Visual AntMaze met le plus clairement en évidence l’avantage de la hiérarchie.
Selon le dépôt officiel, H-JEPA à trois niveaux atteint 73,3 % de réussite en planification, contre 18,0 % pour la référence LeWorldModel plate.
La hiérarchie améliore également le compromis entre le taux de réussite et le coût de calcul du planificateur.
Ce point est important, car un planificateur hiérarchique n’est utile que si l’ajout de niveaux ne rend pas la planification excessivement coûteuse.
La hiérarchie améliore également les résultats par rapport à la référence plate dans les autres environnements simulés, mais un modèle plus profond n’est pas toujours préférable.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
L’article source présente Push-T comme un contre-exemple important : le modèle à deux niveaux obtient de meilleurs résultats que la référence plate, tandis que l’ajout d’un troisième ou d’un quatrième niveau peut réduire les performances.
L’article attribue en partie ce résultat à la longueur des tâches. Les trajectoires plus courtes fournissent moins d’échantillons pertinents aux niveaux très élevés qui fonctionnent sur de longs horizons.
Cela révèle une limite importante :
La hiérarchie est utile lorsque la tâche présente une véritable structure à plusieurs échelles temporelles. Ajouter des niveaux de manière mécanique ne garantit pas de meilleures performances.
Les données robotiques réelles créent un autre problème de représentation.
Dans des vidéos diversifiées, un objectif purement prédictif peut accorder une grande importance aux informations d’arrière-plan stables, car l’arrière-plan est facile à prédire. Le robot en mouvement, pourtant essentiel au contrôle, peut recevoir une capacité de représentation moindre.
Pour résoudre ce problème, les chercheurs ajoutent une supervision par dynamique inverse dans les expériences DROID.
Le modèle est entraîné non seulement à prédire les états latents futurs, mais aussi à déduire l’action qui relie deux états latents consécutifs.
Cela encourage la représentation à préserver les informations relatives au mouvement du robot et à son état contrôlable.
La page du projet H-JEPA indique que le deuxième niveau appris améliore la fidélité de la planification hors ligne par rapport à la référence plate, tout en réduisant le coût de calcul du planificateur.
L’évaluation DROID est hors ligne : l’article compare les trajectoires prédites de l’effecteur terminal aux trajectoires d’experts, sans revendiquer une réussite de tâches robotiques réelles en boucle fermée.
Cette distinction est importante pour interpréter les résultats.
Les auteurs ont publié l’implémentation de H-JEPA sur GitHub.
Le dépôt officiel comprend le code d’entraînement et de planification pour :
Il fournit également des scripts permettant de reproduire certaines figures et certains tableaux de l’article.
Le dépôt de points de contrôle sur Hugging Face comprend actuellement des modèles préentraînés pour LeWorldModel plat, des variantes H-JEPA à deux, trois et quatre niveaux, ainsi que des références HWM à espace partagé pour les tâches simulées, en plus de points de contrôle DROID.
Le dépôt de données H-JEPA associé contient les données de simulation, les tâches d’évaluation de planification, les jeux de données de sondage et les données liées à DROID nécessaires à la publication.
Le projet va donc au-delà d’une simple démonstration publiée dans un article : les chercheurs peuvent examiner l’implémentation, charger les modèles entraînés et tenter de reproduire les résultats de planification rapportés.
H-JEPA s’inscrit dans la même orientation de recherche générale que celle que LeCun défend depuis plusieurs années.
JEPA signifie Joint-Embedding Predictive Architecture.
Un modèle de langage standard apprend en prédisant les futurs tokens. Un JEPA visuel apprend plutôt les représentations des observations et prédit les représentations cibles dans l’espace latent.
Pour les modèles du monde tels que H-JEPA, les actions sont ajoutées au processus afin que le modèle puisse prédire comment sa représentation interne du monde évolue après l’exécution d’une action.
Un planificateur peut alors comparer les conséquences prédites de différentes actions et rechercher un chemin vers l’objectif.
Cette approche reflète la position défendue de longue date par LeCun, selon laquelle l’intelligence exige davantage que la génération de langage. Dans son programme de recherche, les systèmes doivent comprendre le monde, prédire les conséquences des actions, mémoriser les états pertinents et planifier dans le temps.
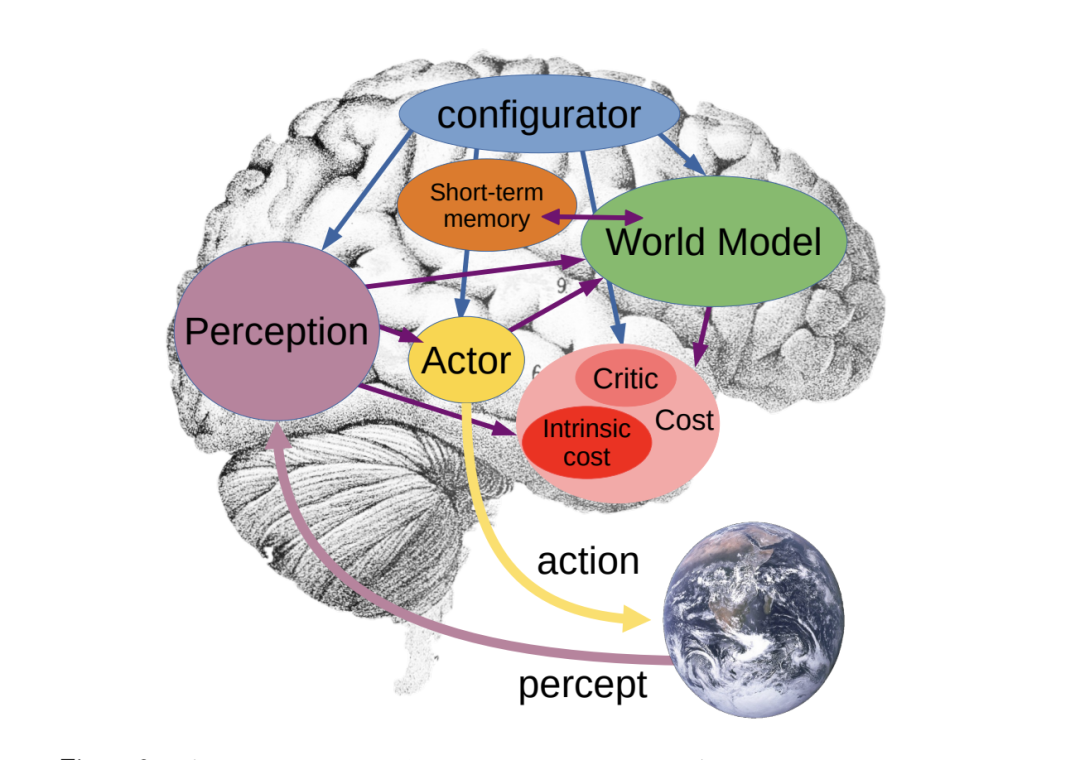
L’article original rappelle également les critiques répétées de LeCun à l’égard de l’idée selon laquelle la seule mise à l’échelle des LLM conduirait nécessairement à une intelligence de niveau humain. Dans le même temps, il a reconnu que les outils fondés sur les LLM sont extrêmement utiles en pratique.
H-JEPA doit donc être compris non pas comme une tentative de remplacer dès aujourd’hui tous les modèles de langage, mais comme une expérience concrète dans le cadre de l’architecture alternative défendue par LeCun.
Cette orientation de recherche fait désormais partie de la stratégie commerciale d’AMI.
AMI a levé 1,03 milliard de dollars en mars 2026 pour une valorisation pré-money de 3,5 milliards de dollars, selon Reuters et d’autres articles publiés à la même période.
L’entreprise est dirigée par une équipe comprenant :
Michael Rabbat est également l’un des auteurs de l’article H-JEPA.
AMI présente son objectif comme la construction de systèmes capables de comprendre le monde, de conserver une mémoire persistante, de raisonner et de planifier, tout en restant contrôlables et sûrs.
Au moment de la publication de l’article source de BAAI, l’entreprise se présentait encore principalement à travers ses travaux de recherche, son équipe et ses recrutements, plutôt qu’au moyen d’un produit public largement disponible.
H-JEPA est donc important notamment parce qu’il fournit un résultat technique concret issu de la thèse d’AMI sur les modèles du monde.
L’article source termine en comparant AMI à une autre entreprise de modèles du monde très suivie : World Labs, fondée par Fei-Fei Li.
Le 28 septembre 2026, AMD a annoncé un accord définitif visant à acquérir World Labs.
Le document déposé par AMD auprès de la SEC évalue la transaction entièrement en actions à environ 8,2 milliards de dollars, sous réserve des ajustements habituels.
Les deux entreprises suivent des trajectoires organisationnelles différentes, mais reflètent toutes deux l’importance croissante des modèles du monde, de l’intelligence spatiale, de la robotique, de la simulation et de l’IA physique.
AMI continue de développer son propre programme de recherche autour de modèles prédictifs hiérarchiques, tandis que World Labs se dirige vers une intégration avec une grande entreprise spécialisée dans les capacités de calcul pour l’IA.
Pour H-JEPA, la question immédiate est davantage technique que corporate : jusqu’où la planification hiérarchique dans l’espace latent peut-elle évoluer, du contrôle simulé et des vidéos robotiques hors ligne vers des systèmes plus riches fonctionnant en boucle fermée dans le monde réel ?
C’est le prochain test de cette architecture.
H-JEPA est un modèle du monde hiérarchique de bout en bout destiné à la planification visuelle. Il empile plusieurs JEPA conditionnés par l’action afin que les niveaux supérieurs prédisent plus loin dans le futur et transmettent des sous-objectifs latents aux niveaux inférieurs.
Un modèle du monde plat utilise une seule représentation et une seule échelle de planification. H-JEPA apprend des espaces latents distincts à plusieurs échelles temporelles, ce qui permet aux niveaux supérieurs de se concentrer sur une structure lente et pertinente pour la tâche, tandis que les niveaux inférieurs préservent les détails nécessaires au contrôle.
Le dépôt GitHub officiel rapporte environ 73,3 % de réussite en planification pour H-JEPA à trois niveaux, contre 18,0 % pour la référence LeWorldModel plate. La hiérarchie offre également un meilleur compromis entre la réussite et le coût de calcul du planificateur.
SIGReg signifie Sketched Isotropic Gaussian Regularization. Cette méthode a été introduite dans LeJEPA afin de contraindre les distributions latentes et d’empêcher l’effondrement des représentations, phénomène par lequel un encodeur associe de nombreux états différents à des représentations presque identiques.
Oui. La publication du code GitHub officiel utilise la licence MIT, et des points de contrôle préentraînés sont disponibles sur Hugging Face. Le dépôt de données H-JEPA associé est publié sous licence CC BY 4.0.
L’article étend l’approche à des vidéos diversifiées de robots réels issues de DROID en utilisant une supervision par dynamique inverse. Ces expériences évaluent la fidélité de la planification hors ligne, et non la réussite complète de tâches robotiques en boucle fermée. Il ne faut donc pas présenter ce résultat comme un déploiement autonome dans le monde réel.
Non. L’article montre que les hiérarchies plus profondes sont utiles lorsque la tâche présente une structure significative à plusieurs échelles temporelles, mais que des hiérarchies très profondes peuvent nuire aux tâches plus courtes comme Push-T, car les niveaux supérieurs peuvent recevoir trop peu de signaux d’entraînement utiles.
H-JEPA s’inscrit dans la thèse de LeCun sur les JEPA et les modèles du monde : apprendre des représentations compactes du monde, prédire les états latents futurs plutôt que chaque pixel et utiliser ces prédictions pour planifier. H-JEPA ajoute une hiérarchie explicite afin que les différents niveaux puissent fonctionner avec des échelles temporelles et des degrés d’abstraction différents.
H-JEPA transforme l’idée de modèle du monde JEPA en une hiérarchie explicite de planification. Les niveaux supérieurs fonctionnent sur des horizons plus longs et avec des représentations plus abstraites, tandis que les niveaux inférieurs traduisent ces plans en sous-objectifs et en actions de plus en plus concrets.
Le résultat le plus marquant apparaît sur Visual AntMaze, où H-JEPA à trois niveaux atteint environ 73 % de réussite en planification contre 18 % pour la référence LeWorldModel plate, tout en améliorant l’efficacité de la planification. Les travaux montrent également qu’une hiérarchie n’est pas automatiquement utile : l’échelle temporelle de la tâche et la disponibilité des données déterminent si l’ajout de niveaux apporte un bénéfice.
Le projet est particulièrement reproductible pour une publication de recherche récente, avec du code, des points de contrôle et des jeux de données déjà accessibles au public.
La principale contribution de H-JEPA n’est pas simplement d’obtenir un meilleur score dans un labyrinthe ; c’est de démontrer concrètement que les modèles du monde peuvent tirer parti de représentations différentes selon les horizons de planification.
Partez d’une phrase et obtenez un site complet en quelques minutes.