For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/harness2-explained-recursive-agent-harnes-65188473.md.
Harness², également écrit Harness2, explore une forme pratique d’amélioration récursive : modifier les logiciels autour d’un modèle de langa...
Harness², également écrit Harness2, explore une forme pratique d’amélioration récursive : modifier les logiciels autour d’un modèle de langage figé. Son environnement d’exécution modifiable comprend les prompts, les garde-fous, la mémoire, les compétences, les instructions de gestion des outils, les scripts, les sous-agents et les intergiciels.
Cette recherche provient de Google Cloud AI Research et de la Northwestern University. Plutôt que d’entraîner un nouveau modèle après chaque échec, le système étudie l’exécution d’un agent, teste des changements apportés à son harness et conserve des éléments permettant d’identifier les changements qui ont été utiles.
Les auteurs indiquent qu’une étape d’amélioration fait passer le score moyen de GLM-5 sur WorkBuddy-Bench de 64,2 à 75,7 avec OpenCode. Il s’agit d’un gain de 11,5 points dans une évaluation donnée, et non d’une amélioration garantie pour tous les modèles ou toutes les applications.
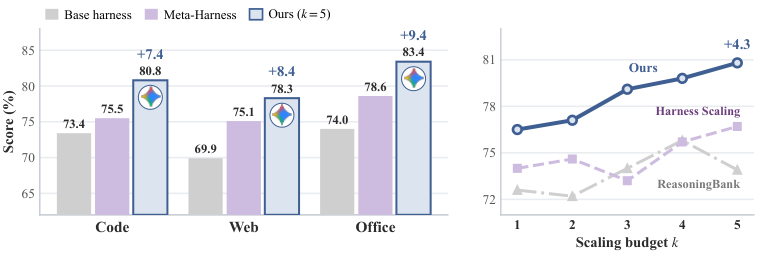
Figure de l’équipe de recherche, reproduite dans le rapport de QbitAI/BAAI.
Deux problèmes motivent ce travail.
Harness2 sépare le harness d’exécution utilisé pour la tâche actuelle du processus qui l’améliore. Une tâche ultérieure commence avec le harness de base commun ; le système d’amélioration sélectionne les éléments pertinents dans les expériences antérieures au lieu de reprendre aveuglément toutes les règles précédentes.
Le système enregistre d’abord une exécution de référence avec le harness initial. Il utilise ensuite cette trace pour identifier les faiblesses et tester des réparations potentielles.
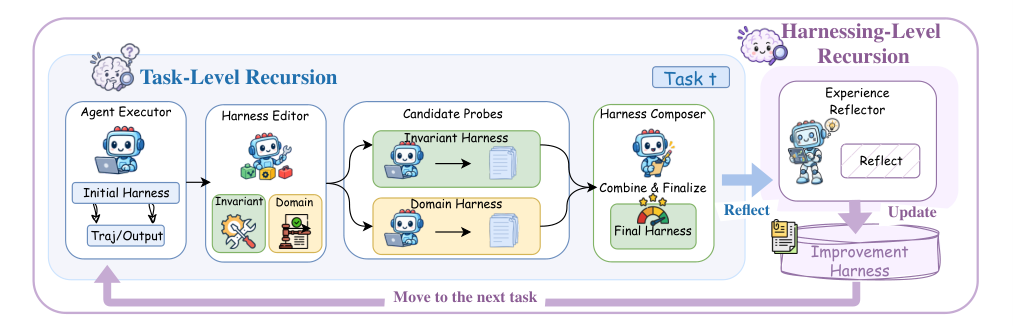
L’étape d’amélioration comprend trois phases :
La comparaison comportementale remplace les retours issus d’une vérité terrain indisponible pendant l’adaptation. Elle ne constitue pas un juge infaillible de la correction finale. Une évaluation externe sur benchmark reste importante pour mesurer l’efficacité de la méthode.
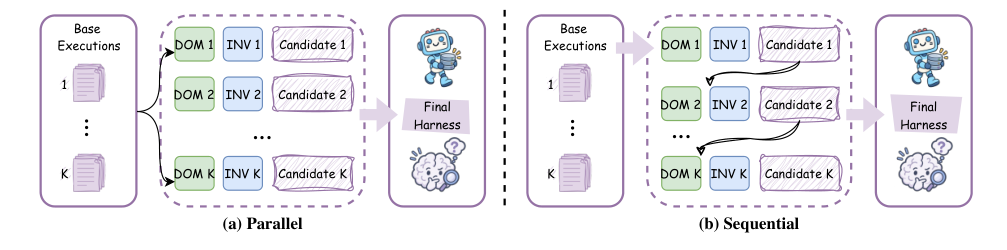
La méthode peut explorer plus largement grâce à la récursion parallèle ou effectuer des révisions successives grâce à la récursion séquentielle. Avec un budget parallèle k, elle teste k candidats généraux et k candidats propres au domaine, puis produit k compositions. Un plus grand nombre de candidats nécessite davantage de calcul.
Après une tâche, un réflecteur d’expérience examine la trace de référence, les modifications proposées, les éléments issus des tests et les décisions de composition. Il enregistre des composants réutilisables et des enseignements, notamment dans EXPERIENCE.md.
La tâche suivante reçoit le harness d’exécution de base, mais le processus d’édition peut récupérer ces enseignements antérieurs. Ce qui persiste est la connaissance des situations dans lesquelles une réparation est utile, plutôt que l’hypothèse selon laquelle la configuration complète de la dernière tâche devrait devenir permanente.
Les paramètres du modèle restent inchangés. Il s’agit d’une adaptation de l’environnement d’exécution au moyen de fichiers et d’éléments issus de l’exécution, et non d’une démonstration d’entraînement autonome des poids du modèle.
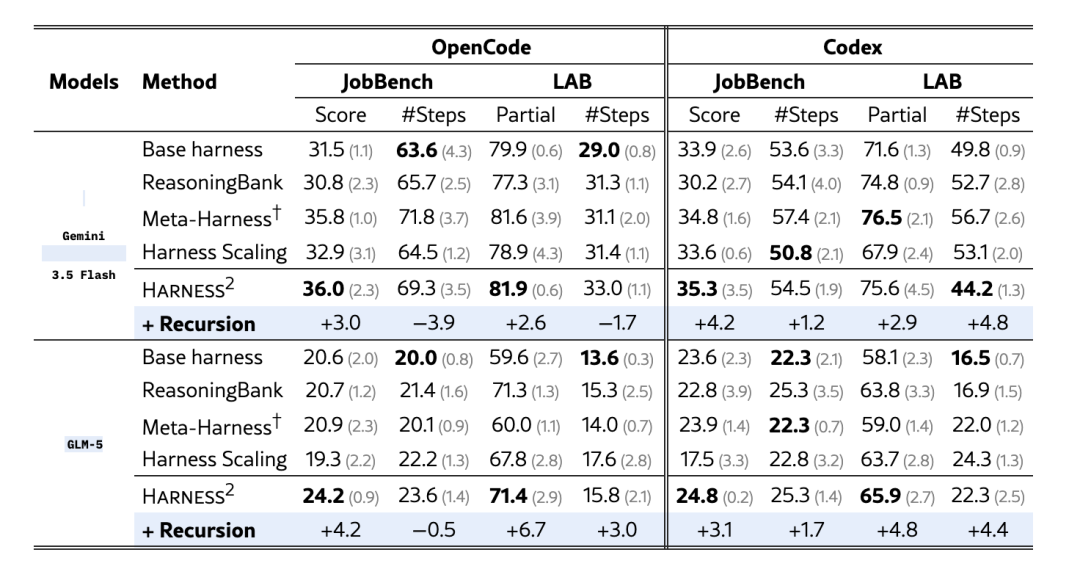
L’étude évalue les livrables de code, web et bureautique de WorkBuddy-Bench, les tâches professionnelles de JobBench et le Legal Agent Benchmark de Harvey. Elle utilise GLM-5 et Gemini 3.5 Flash avec OpenCode et Codex comme harnesses d’exécution.
L’éditeur par défaut est Claude Opus 4.8 avec OpenCode. Par conséquent, les résultats principaux concernent un système d’amélioration placé autour de l’exécutant ; ils ne doivent pas être décrits comme une augmentation gratuite des capacités de l’exécutant seul.
| Modèle exécutant | Harness initial | Moyenne WorkBuddy de base | Une étape Harness2 | Gain |
|---|---|---|---|---|
| GLM-5 | OpenCode | 64,2 | 75,7 | 11,5 points |
| GLM-5 | Codex | 64,4 | 75,3 | 10,9 points |
| Gemini 3.5 Flash | OpenCode | 72,4 | 77,5 | 5,1 points |
| Gemini 3.5 Flash | Codex | 74,5 | 77,5 | 3,0 points |
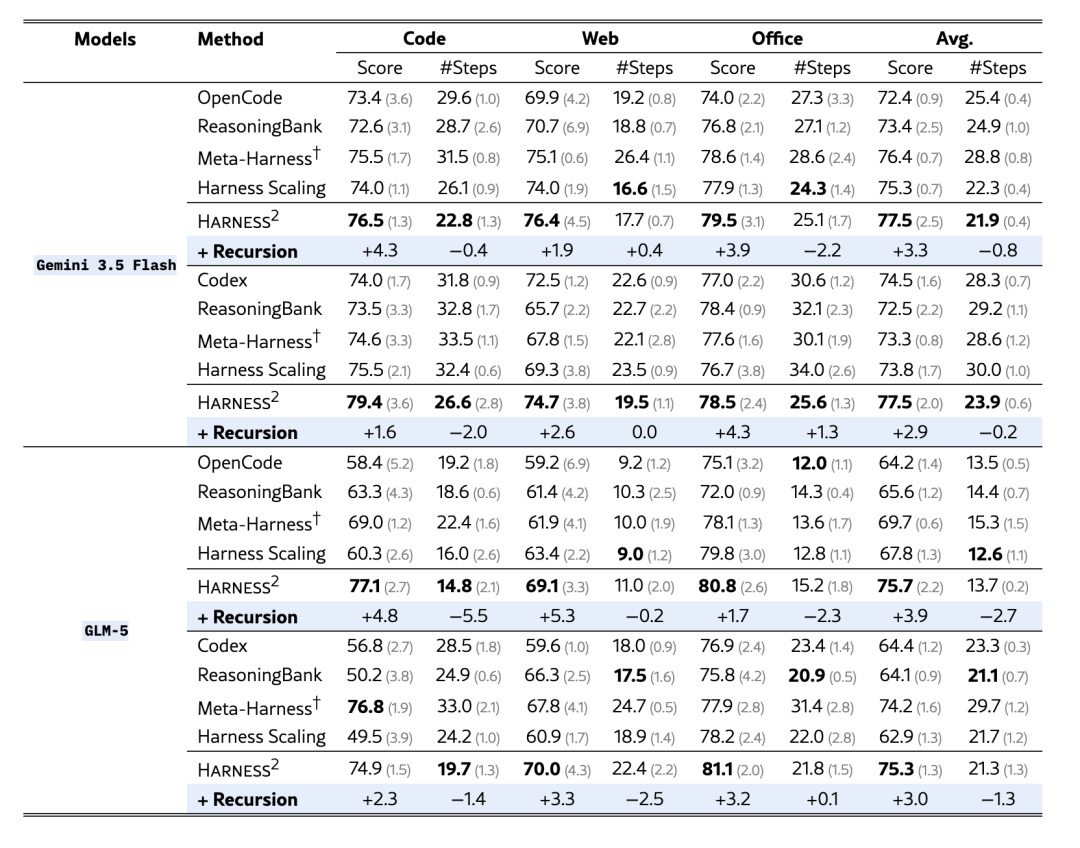
Dans cette comparaison, GLM-5 avec le harness amélioré dépasse la référence Gemini correspondante sans modification. Cela illustre l’influence que la conception de l’environnement d’exécution peut avoir sur le classement des modèles ; cela ne démontre pas que GLM-5 est plus performant pour toutes les tâches.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
L’article rapporte des gains en une étape allant jusqu’à 4,5 points sur JobBench et 11,8 points de pourcentage sur LAB Partial, le taux de réussite par critère. Partial diffère de la proportion de tâches satisfaisant l’ensemble des critères.
L’augmentation du budget parallèle à k=5 ajoute jusqu’à 3,9 points WorkBuddy, 4,2 points JobBench et 6,7 points de pourcentage LAB Partial par rapport à une seule étape. Les tableaux principaux présentent les moyennes et les écarts types de trois exécutions dont l’ordre des tâches a été mélangé.
L’expérience de transfert est également utile. Une bibliothèque constituée sur JobBench améliore le raffinement en une étape de WorkBuddy de 0,6 point pour le code, de 0,5 point pour le web et de 2,9 points pour la bureautique, sans test supplémentaire dans cette comparaison.
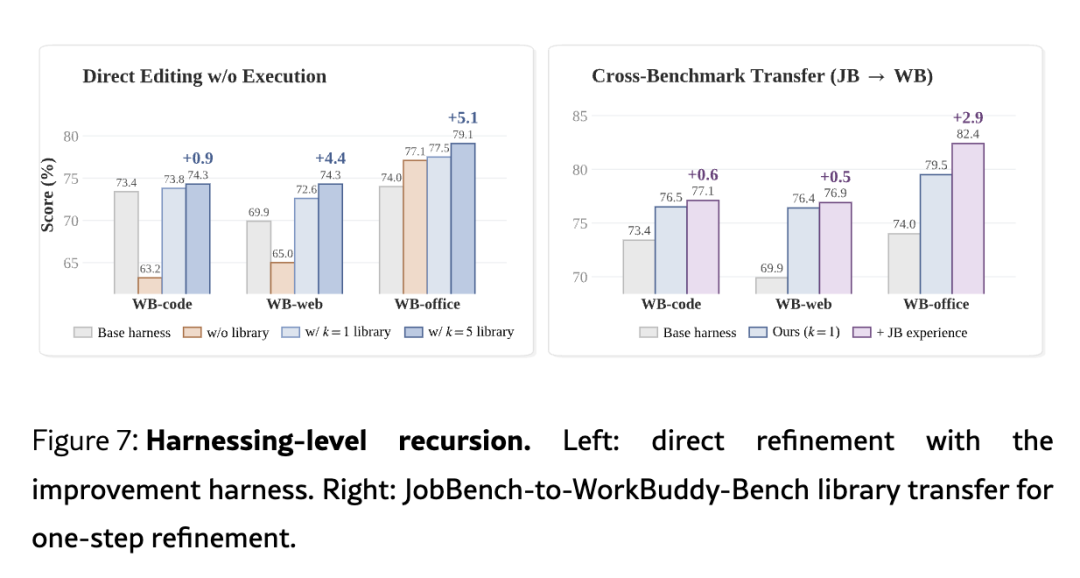
Ces résultats soutiennent la réutilisation sélective des expériences d’amélioration. Ils ne montrent pas que chaque règle accumulée est transférable et ne suppriment pas la nécessité de vérifier un harness adopté sur la distribution réelle des tâches.
L’article répertorie neuf auteurs : Ruiyao Xu, Yanfei Chen, Zhongying CuiZhu, Bhavana Dalvi Mishra, Yifei Ming, Han Yu, Rujun Han, Chen-Yu Lee et Tomas Pfister. La source présente Xu comme doctorant à la Northwestern University, ainsi que Chen et CuiZhu comme chercheurs chez Google Cloud.
Le dépôt public prend en charge les deux harnesses d’exécution et les deux modes de récursion. Il précise qu’il faut utiliser Linux, Python 3.12 et uv ; les benchmarks s’appuyant sur des modèles ont des dépendances et des coûts d’API supplémentaires. WorkBuddy nécessite Docker, tandis que LAB requiert notamment Pandoc et Poppler.
Le README avertit également que l’accès réseau de l’exécutant est illimité et que la sandbox d’exécution de Codex est désactivée dans cette configuration. Les utilisateurs des benchmarks doivent configurer des restrictions empêchant l’accès aux réponses et aux grilles d’évaluation avant de mesurer les résultats. Les améliorations de l’environnement d’exécution décrites dans l’article doivent être évaluées en tenant compte de ces conditions d’exécution et d’évaluation.
Il modifie l’environnement d’exécution autour d’un modèle de langage, notamment les prompts, les outils, la mémoire et les compétences. Les poids du modèle sous-jacent restent figés.
La récursion au niveau de la tâche teste et compose des réparations pour la tâche actuelle. La récursion au niveau de l’orchestration conserve des éléments probants et des enseignements réutilisables afin d’améliorer les décisions d’édition ultérieures.
Sa méthode d’adaptation utilise les différences entre les traces d’exécution plutôt qu’un vérificateur fondé sur une vérité terrain. Cela rend les éléments probants disponibles lorsque les étiquettes sont absentes, mais ne garantit pas que l’artefact obtenu soit correct.
Non. Il s’agit de l’amélioration moyenne rapportée dans l’étude pour GLM-5/OpenCode sur WorkBuddy. D’autres combinaisons de modèles, de harnesses et de benchmarks produisent des gains différents.
Il ajoute des exécutions de candidats et du travail d’amélioration. L’article analyse les performances avec le calcul total, notamment les tokens d’exécution et d’amélioration.
Le dépôt indique que Docker est requis pour WorkBuddy-Bench. Sa démonstration locale déterministe et les autres benchmarks ont des exigences différentes ; il faut donc suivre les instructions correspondant au workflow sélectionné.
Harness2 combine l’expérimentation propre à chaque tâche avec une bibliothèque d’enseignements sur l’amélioration des environnements d’exécution des agents. Les gains rapportés montrent que les prompts, la gestion des outils et la structure d’exécution peuvent modifier sensiblement les résultats, même lorsque les poids du modèle restent inchangés.
Les éléments disponibles soutiennent une meilleure conception des harnesses dans les conditions testées, tout en laissant visibles les limites liées au calcul, à la vérification et au transfert.
Partez d’une phrase et obtenez un site complet en quelques minutes.



