For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/houmo-m50-open-source-software-for-local-1781bd08.md.
Déplacer une charge de travail d’IA sur un appareil local exige plus qu’un accélérateur performant. Les développeurs ont besoin de moyens po...
Déplacer une charge de travail d’IA sur un appareil local exige plus qu’un accélérateur performant. Les développeurs ont besoin de moyens pour préparer les modèles, les exécuter efficacement, connecter plusieurs composants et maintenir le produit final.
La dernière annonce de Houmo concernant son écosystème traite cette couche logicielle. Selon le rapport fourni, l’entreprise prévoit de publier sa pile logicielle d’IA par étapes, avec 15 projets dont la publication est prévue d’ici janvier 2027. Plusieurs dépôts sont déjà publics, notamment des exemples de modèles, des outils de quantification et des adaptations de frameworks d’inférence connus.
La distinction entre la feuille de route et le code disponible aujourd’hui est importante. Un projet d’ouverture de l’ensemble de la pile ne signifie pas que chaque composant est déjà publié ni que toutes les dépendances d’exécution ont disparu.
Le rapport organise la pile en quatre couches :
| Couche | Rôle dans un déploiement |
|---|---|
| Préparation des modèles | Quantification, compilation, contrôles de précision et conversion vers un format pris en charge |
| Framework d’inférence, opérateurs et environnement d’exécution | Exécution et ordonnancement sur le matériel Houmo |
| Kits métier, pipelines et middleware | Coordination entre les modèles et les composants applicatifs |
| Déploiement et opérations | Mises à jour, supervision et gestion des appareils déployés |
Un assistant de réunion illustre pourquoi ces couches doivent fonctionner ensemble. La reconnaissance vocale doit alimenter un modèle de langage, le modèle de langage doit produire un compte rendu utile, puis l’application doit l’enregistrer ou l’afficher. Chaque étape possède ses propres exigences de mémoire, de latence et de compatibilité.
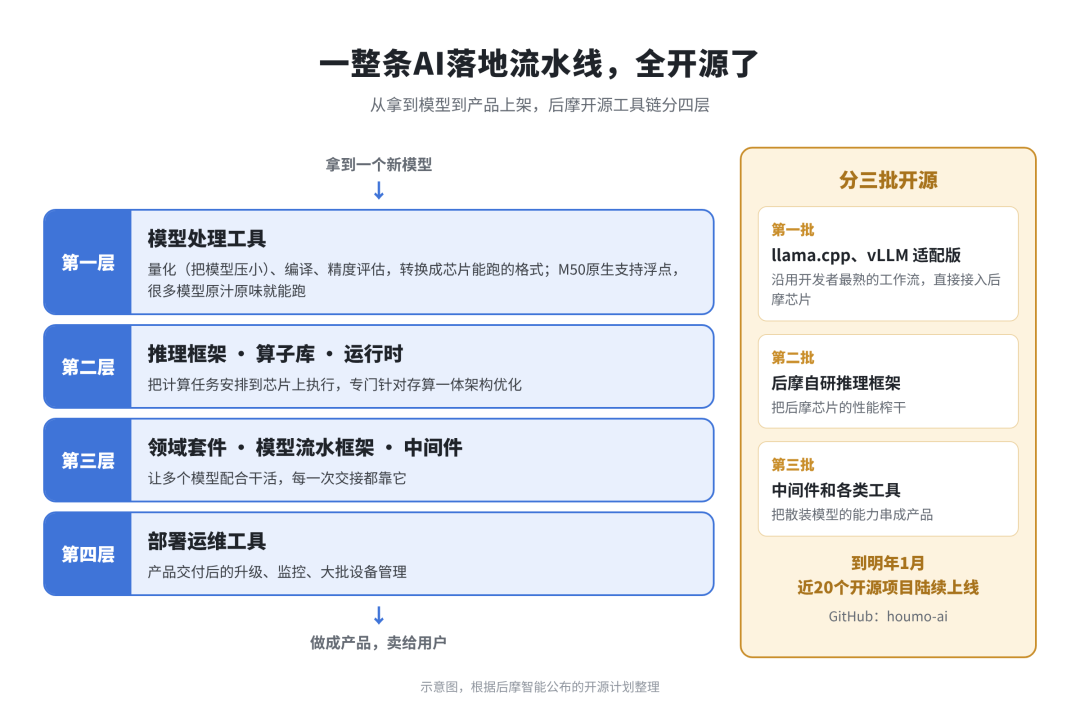
Schéma de la pile logicielle issu du rapport Xinzhiyuan/BAAI ; ses libellés d’origine sont en chinois.
La séquence de publication rapportée commence par des adaptations de llama.cpp et vLLM, suivies du propre framework d’inférence de Houmo, puis de middleware et d’autres outils. La feuille de route plus large inclut également une infrastructure de gestion des accélérateurs et des clusters.
Le dépôt public postmo-modelzoo décrit des exemples couvrant la quantification, la compilation, l’évaluation de précision, la mesure des performances et le déploiement d’applications. Ses catégories de modèles comprennent la reconnaissance vocale, la génération vocale, les modèles de langage, les modèles vision-langage, les représentations vectorielles, l’OCR, la segmentation et la génération d’images.
Parmi les autres dépôts visibles figurent postmo-quantflow, postmo-gptqmodel, vllm-postmo, ainsi que les forks Houmo de llama.cpp et vLLM. Les développeurs doivent consulter le README et la branche actuelle de chaque dépôt plutôt que de supposer des procédures d’installation ou des niveaux de prise en charge identiques.
Le README des exemples de modèles indique plusieurs contraintes concrètes :
houmo-tcim-runtime et de houmo-drv.Ces exigences sont importantes pour la planification. Un dépôt d’exemples ouvert fournit un code d’intégration inspectable, mais ne constitue pas un environnement d’exécution indépendant du matériel.
La source indique que plus de 100 clients et plus de 150 produits terminaux planifiés sont associés au M50. Ces chiffres décrivent le pipeline d’écosystème rapporté, plutôt que des livraisons auditées.
Le rapport décrit le P7 de Lenovo comme un ordinateur d’IA d’environ 300 grammes, doté d’une puissance système maximale annoncée de 30 W. Il fait état d’une exécution locale d’un modèle de 122 milliards de paramètres à 50 jetons par seconde, avec prise en charge d’un contexte de 128K.
Ces chiffres doivent être considérés avec leurs conditions de test manquantes. L’article ne fournit pas suffisamment de détails sur l’architecture du modèle, la précision, la charge de travail et la configuration de mesure pour les considérer comme une garantie générale de performance. En particulier, le seul nombre de paramètres ne permet pas de déterminer la quantité de mémoire nécessaire à un déploiement.
Le M50 est lui-même décrit comme offrant 160 TOPS de performance INT8, une consommation typique de 10 W et la prise en charge de jusqu’à 48 Go de mémoire LPDDR5/5X. La consommation de l’accélérateur, la consommation totale du système, le débit théorique et la vitesse de génération de jetons mesurent des choses différentes.
Parmi les autres produits rapportés figurent une version M50 du Truffle 1 de Deepshard, le HomeAgent HA100 Pro d’Ugreen et le ClawHouse X1. Leurs exemples sont centrés sur la mémoire locale, le traitement multimédia domestique et les interfaces d’agents personnels. Les services connectés, comme les e-mails, dépendent toujours de l’authentification et de l’accès au réseau, même lorsqu’un modèle s’exécute localement.
Le rapport décrit un ordinateur portable Great Wall N90 Pro exécutant Kylin V11 et un modèle de 35B hors ligne à 30 jetons par seconde. Il évoque également un robot compagnon utilisant le traitement local pour la perception et la mémoire, ainsi qu’un appareil éducatif construit autour de cartes accélératrices LM5040, chacune intégrant quatre puces M50.
Les chiffres de calcul et de mémoire rapportés pour le système éducatif s’appliquent à la machine assemblée, et non à un seul M50. Les lecteurs qui comparent des produits doivent demander le nombre réel de cartes, la topologie mémoire, la précision et la charge de travail mesurée.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
La discussion sur l’architecture distingue les modèles de type mélange d’experts des modèles denses. Un modèle MoE peut activer un sous-ensemble d’experts pour un jeton tout en exigeant le stockage de son ensemble plus large de paramètres. Les modèles denses utilisent généralement une plus grande part de leurs paramètres à chaque étape, ce qui fait du trafic mémoire un facteur majeur.
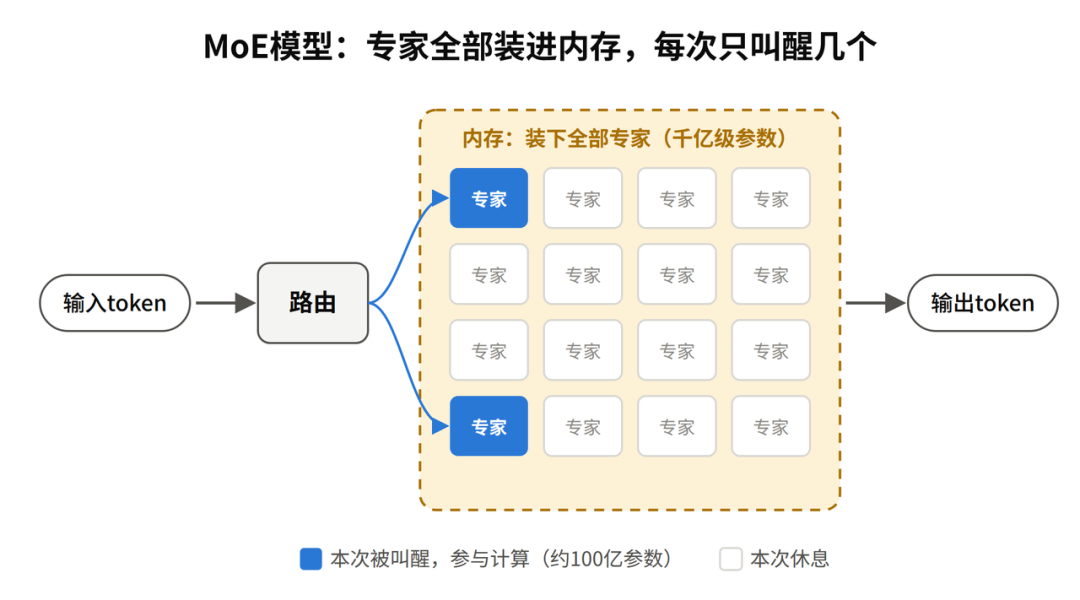
Illustration MoE issue du rapport source ; les libellés d’origine expliquent les experts stockés et activés.
Houmo présente deux voies de développement : le calcul en mémoire 2D, qui met l’accent sur la capacité et le calcul avec une mémoire externe, et le calcul en mémoire 3D, qui met l’accent sur la bande passante grâce à une conception empilée. Le rapport décrit le calcul fondé sur SRAM dans la couche logique comme une caractéristique distinctive de cette dernière approche.
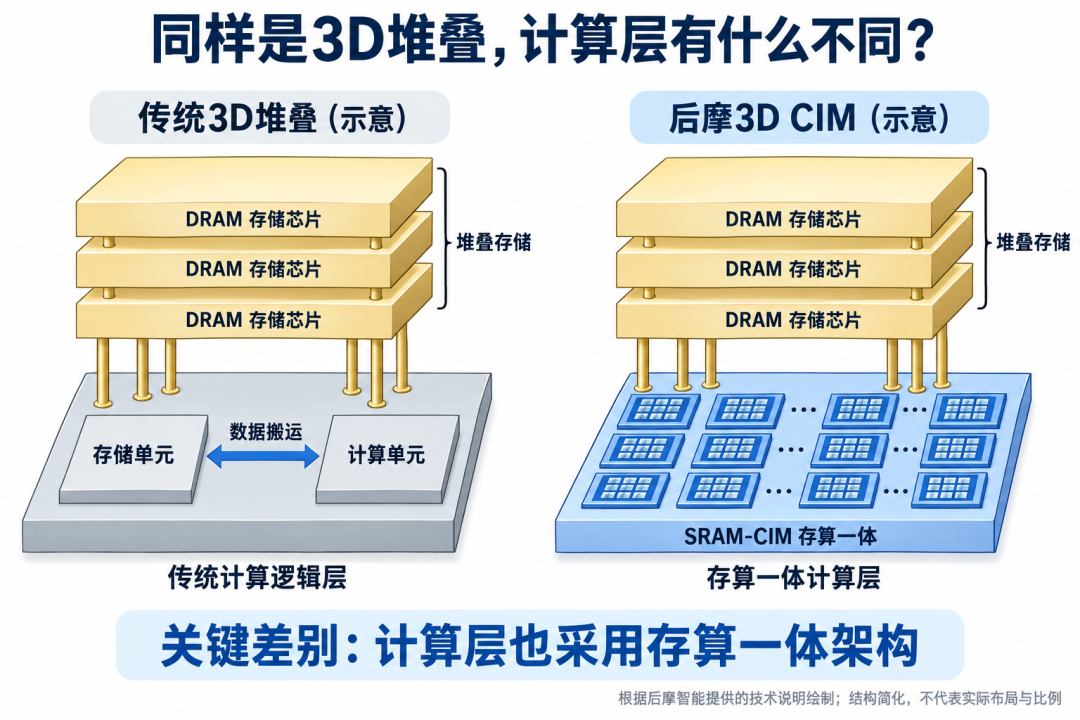
Comparaison d’architecture reproduite dans le rapport Xinzhiyuan/BAAI, et non un benchmark indépendant.
Les comparaisons de surface et de consommation de l’entreprise dépendent de ce qui est comparé. Elles ne doivent pas être appliquées à chaque puce ou modèle sans une configuration de mesure divulguée. Les références futures à Flash ou RRAM décrivent également une direction de développement, et non une garantie de disponibilité actuelle des produits.
La source relie cette annonce aux travaux antérieurs du fondateur et PDG Qiang Wu sur GPGPU et OpenCL. Plus concrètement, la publication d’outils permet aux développeurs d’examiner le comportement d’intégration, d’adapter les exemples et de contribuer à des correctifs.
Cet accès peut réduire le travail répété entre les fabricants d’appareils. Il n’élimine pas la nécessité de tester la qualité, les contraintes thermiques, l’utilisation de la mémoire, les licences, le fonctionnement hors ligne et le comportement de récupération dans le produit final. Un exemple reproductible sur le matériel visé constitue un meilleur point de départ qu’un chiffre de paramètres mis en avant dans un titre.
Le M50 est un accélérateur d’IA en périphérie utilisé dans les scénarios sur appareil local décrits par le rapport. Les exemples incluent des ordinateurs agentiques, des ordinateurs portables, des systèmes domestiques, des robots et des appareils d’inférence en périphérie.
Le rapport décrit un plan de publication par étapes s’étendant jusqu’en janvier 2027. Plusieurs dépôts sont publics aujourd’hui, mais les développeurs doivent vérifier le statut réel de publication et la licence de chaque composant.
Le dépôt comprend des outils de préparation et d’évaluation ayant différentes exigences de plateforme. Ses exemples d’inférence nécessitent le matériel Houmo pris en charge et les bibliothèques d’exécution ; la quantification de grands modèles nécessite également un GPU.
L’inférence locale peut fonctionner sans service de modèle dans le cloud lorsque les ressources requises sont installées. Les tâches impliquant des e-mails en direct, la messagerie ou d’autres services en ligne nécessitent toujours une connectivité et une autorisation.
Non. Les TOPS constituent une mesure de débit d’opérations à une précision donnée, tandis que la vitesse des jetons dépend de l’architecture du modèle, du trafic mémoire, de la précision et du comportement logiciel. Comparez les résultats mesurés pour le même modèle et la même charge de travail.
Non. Le README indique que la plupart des jeux de données tiers doivent être obtenus séparément et utilisés selon leurs propres conditions. La licence du dépôt n’accorde pas de droits commerciaux sur l’ensemble des données ou ressources de modèles référencées.
L’annonce de Houmo vise à rendre plus réutilisable le parcours allant de la préparation des modèles à un produit d’IA en périphérie opérationnel. Les dépôts publics fournissent déjà des exemples utiles, tandis que la pile plus large reste un plan de publication par étapes.
Les appareils M50 rapportés illustrent plusieurs formats de déploiement possibles, mais la décision pratique dépend toujours des modèles exacts, du matériel et des exigences d’exécution. Commencez par un exemple pris en charge et mesurez la charge de travail du produit complet.
Partez d’une phrase et obtenez un site complet en quelques minutes.
