La société Safe Superintelligence a passé plus de deux ans à révéler très peu de choses sur ce qu’elle construit. Ce silence pourrait bientô...
Safe Superintelligence Inc. a passé plus de deux ans à garder le silence sur ses travaux de recherche.
Ce silence pourrait bientôt prendre fin.
Gavin Baker, associé gérant et directeur des investissements d'Atreides Management, a déclaré lors d'une récente conversation avec l'investisseur et animateur de podcast Patrick O'Shaughnessy que SSI a indiqué prévoir de publier un modèle en août.
Cette déclaration a immédiatement attiré l'attention, car SSI n'avait jamais annoncé publiquement de date précise pour la sortie d'un modèle.
Fondée en 2024 par l'ancien scientifique en chef d'OpenAI Ilya Sutskever, Daniel Gross et Daniel Levy, SSI est bâtie autour d'une mission exceptionnellement ciblée. Son site web décrit toujours l'entreprise comme un laboratoire en "sprint direct" avec un seul objectif et un seul produit : la superintelligence sûre.
C'est pourquoi toute discussion concernant un premier modèle revêt une importance particulière.
Cependant, il faut d'emblée clarifier une distinction essentielle :
Au 7 août 2026, SSI n'a pas encore publié d'annonce officielle sur son site web confirmant la sortie d'un modèle en août.
Le calendrier d'août provient des déclarations de Baker, et non d'une communication officielle de SSI.
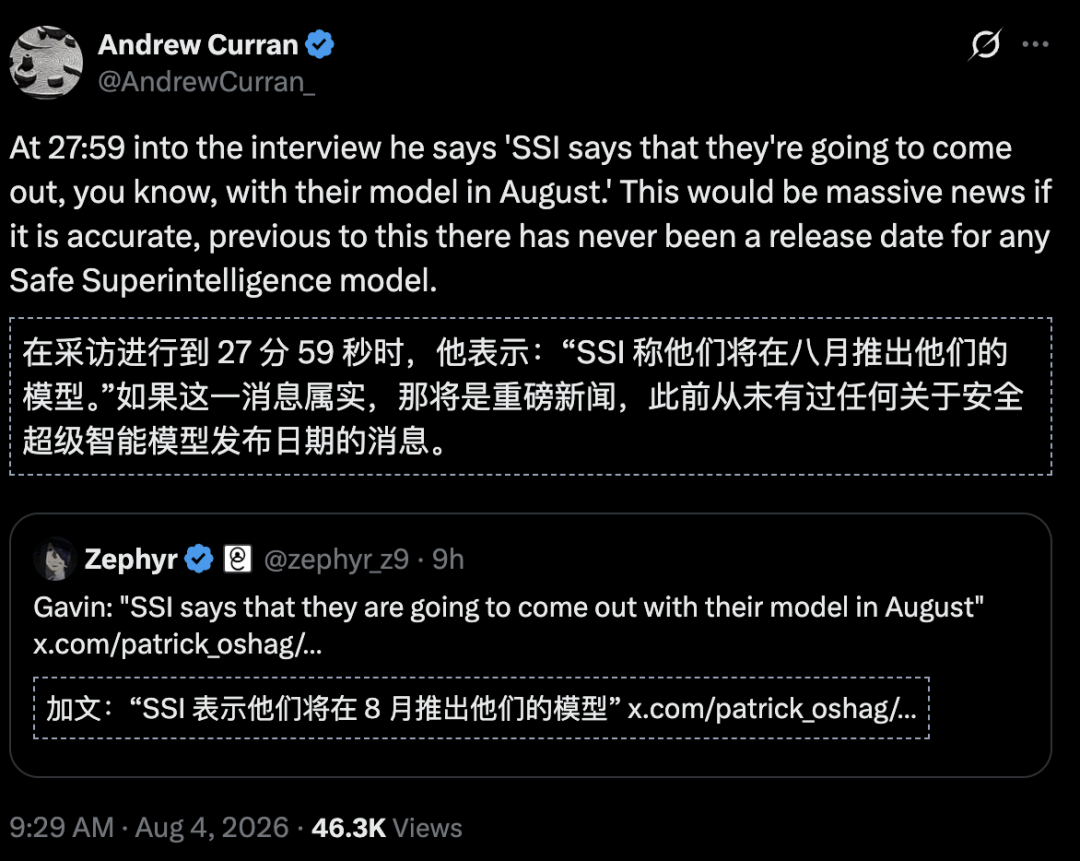
Si les informations de Baker sont exactes, ce serait la première fois que le monde extérieur pourrait entrevoir les résultats technologiques de l'un des laboratoires d'IA de pointe les plus mystérieux et les plus suivis.
Cette déclaration cruciale a été faite presque en passant au cours d'une discussion plus large sur les infrastructures d'IA, la demande de semi-conducteurs, l'apprentissage continu et l'apprentissage efficace en termes d'échantillons.
Baker estime que si les modèles peuvent apprendre efficacement après leur déploiement, plutôt que de s'appuyer principalement sur un pré-entraînement à grande échelle, le paysage économique de l'IA de pointe pourrait connaître des changements majeurs.
En développant cette possibilité, il a indiqué que SSI avait déclaré qu'elle allait "lancer" un modèle en août.
Cette déclaration laisse de nombreuses questions sans réponse.
Elle ne nous dit pas :
L'article source interprète cette déclaration comme la première publication d'un modèle par SSI.
C'est une lecture raisonnable, mais la forme précise de cette publication reste inconnue.
La déclaration de mission officielle de SSI est exceptionnellement directe.
L'entreprise affirme avoir été fondée pour poursuivre une superintelligence sûre, sans être distraite par :
Sa feuille de route publique n'est pas une série de chatbots, d'outils de programmation, de produits de recherche ou de services d'entreprise.
Sa feuille de route déclarée est la superintelligence sûre elle-même.
C'est pourquoi la déclaration d'août suscite tant de spéculations.
Si SSI publie un modèle frontière traditionnel avant d'atteindre la superintelligence, cela pourrait indiquer que la stratégie produit de l'entreprise a évolué.
Si le modèle n'est qu'une démonstration des travaux de recherche que SSI poursuit, cette publication pourrait viser à montrer ses progrès plutôt qu'à lancer une plateforme commerciale étendue.
À l'heure actuelle, ces deux interprétations restent spéculatives.
La phrase concernant la publication du modèle est apparue dans le contexte où Baker discutait de l'apprentissage continu et de l'apprentissage efficace en termes d'échantillons.
Ces deux sujets de recherche pourraient avoir une importance économique plus grande pour l'IA que n'importe quel résultat de benchmark.
Les modèles de fondation typiques sont entraînés par grandes phases.
Voici le processus simplifié :
Un modèle déployé peut utiliser les informations de sa fenêtre contextuelle ou de sa mémoire externe, mais ses poids sous-jacents ne sont généralement pas mis à jour en continu à partir de chaque interaction.
L'apprentissage continu vise un objectif plus ambitieux.
Un système d'apprentissage continu acquiert constamment des capacités ou des connaissances utiles au fil du temps, sans avoir à être reconstruit de zéro et sans oublier catastrophiquement les connaissances existantes.
Cela nécessite de résoudre plusieurs défis :
Ainsi, un modèle capable d'apprentissage continu dans le monde réel serait bien plus qu'un chatbot doté d'une mémoire à long terme.
L'efficacité en termes d'échantillons désigne la capacité à apprendre à partir de moins d'exemples.
Les humains peuvent généralement comprendre une nouvelle règle après une ou deux démonstrations.
Les modèles frontières actuels nécessitent souvent des quantités extrêmement importantes de données d'entraînement et de puissance de calcul pour réaliser des améliorations généralisées.
Un modèle plus efficace en termes d'échantillons pourrait extraire davantage de valeur d'apprentissage de chaque élément :
Si l'apprentissage continu et l'efficacité en termes d'échantillons progressent ensemble, le rôle du pré-entraînement pourrait changer.
Plutôt que de construire presque toutes les capacités avant le déploiement, les laboratoires pourraient peut-être entraîner un modèle de base puissant, puis le laisser s'améliorer continuellement grâce à l'expérience.
Baker relie cette direction de recherche à la demande de semi-conducteurs.
Son idée fondamentale est la suivante :
Pré-entraînement massif ponctuel
        ↓
Déploiement du modèle
        ↓
Le modèle apprend efficacement de l'expérience du monde réel
        ↓
Réduction du besoin de ré-entraînements massifs répétés
Dans ce scénario, le pré-entraînement frontière traditionnel pourrait devenir une part plus réduite du calcul total de l'IA.
L'inférence et l'apprentissage continu pourraient devenir plus importants.
com/cms-assets/image/2026/08/978abe63-4b06-4c22-b491-72bdbd9f94ed-39b95ad5-109d-47b5-b0a1-c1c78a939098.png)
Beck a décrit cela comme une éventuelle fracture dans les besoins d'entraînement.
C'est une thèse d'investissement, et non une conclusion technique établie.
Pour que ce scénario devienne réalité, plusieurs conditions doivent être réunies :
Même dans ce cas, la demande totale en calcul ne diminuerait pas nécessairement.
Un modèle devenant nettement plus utile après déploiement pourrait générer davantage d'inférences, d'activités d'agents, de simulations, de génération de données et de charges de travail d'apprentissage par renforcement.
La structure du calcul pourrait changer, mais le marché global ne se contracterait pas nécessairement.
L'article source reprend une comparaison chiffrée frappante issue de la discussion de Beck : les premiers modèles comptaient environ des dizaines de milliards de tokens, tandis que les échelles d'entraînement modernes atteignent des centaines de milliers de milliards.
Cette comparaison ne doit pas être considérée comme une donnée historique vérifiée de l'entraînement de Llama.
La documentation officielle de Meta indique :
Beck lui-même a présenté les chiffres plus petits comme des informations rapportées, et non comme des statistiques officielles de fiches modèles.
De même, les laboratoires de pointe ne divulguent pas le nombre total de tokens d'entraînement pour chacun de leurs modèles propriétaires actuels.
Même sans s'appuyer sur la comparaison précise « 20 milliards contre 300 billions », le point essentiel reste valable :
Le développement des modèles de pointe repose de plus en plus sur des ensembles de données massifs et d'importantes puissances de calcul ; par conséquent, si une percée permettait aux systèmes déployés d'apprendre efficacement à partir d'une quantité bien moindre de nouvelles expériences, cela pourrait modifier substantiellement l'économie de l'infrastructure de l'IA.
NVIDIA
bénéficie de multiples charges de travail d'IA variées :
La réduction d'une catégorie ne signifie pas automatiquement une baisse de la demande totale en accélérateurs.
C'est précisément pour cela que Beck décrit l'apprentissage continu comme un scénario méritant d'être soumis à des tests de résistance, plutôt que comme une prédiction qu'il tient pour certaine.
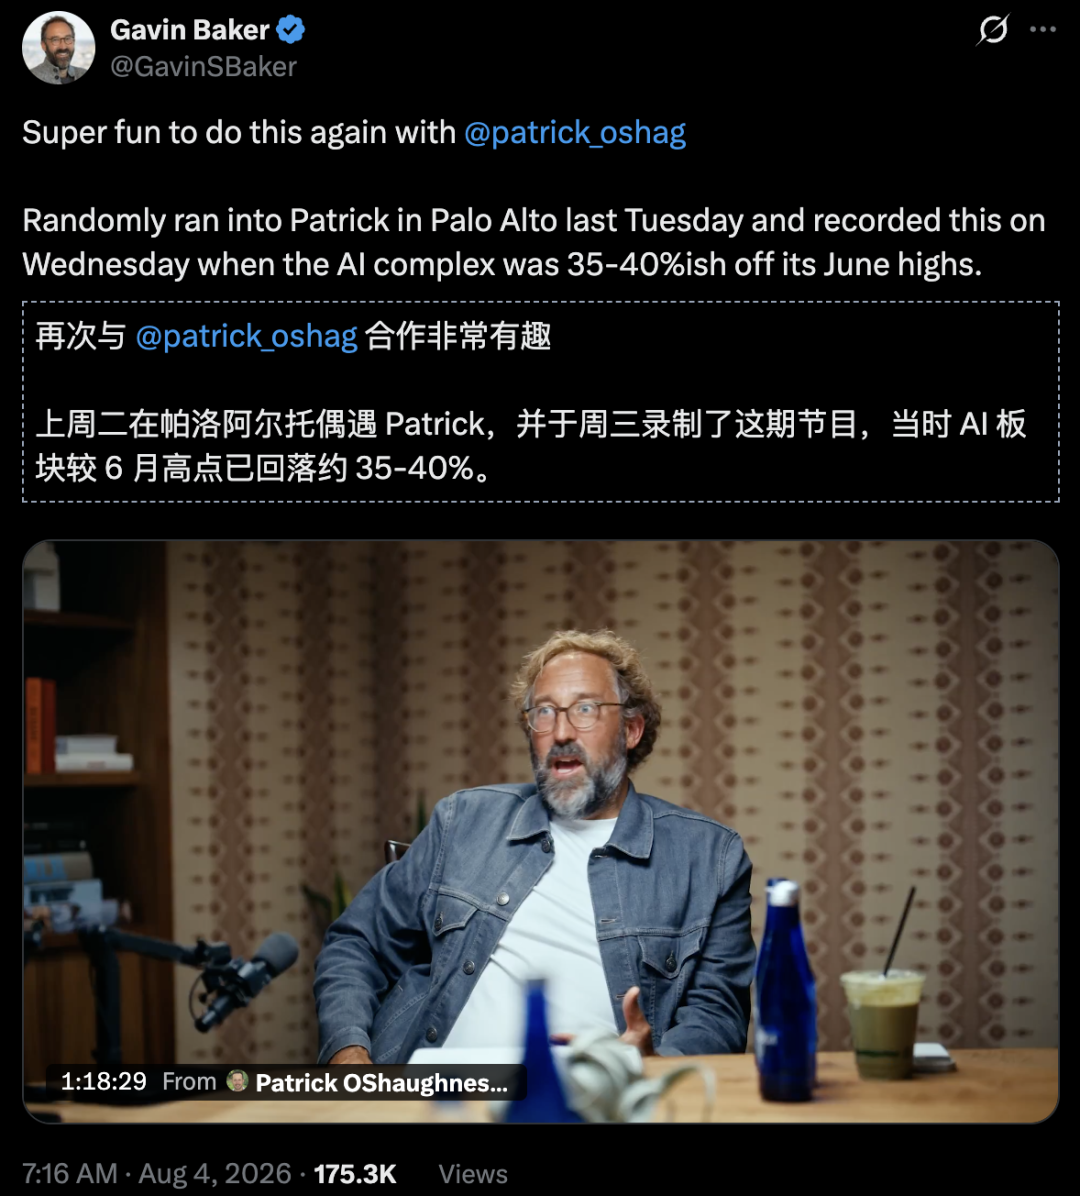
Beck a enregistré cette conversation à une période de forte faiblesse des actions liées à l'IA.
Dans son message sur les réseaux sociaux promouvant l'interview, il a indiqué qu'au moment de l'enregistrement, le « secteur de l'IA » avait chuté d'environ 35 % à 40 % par rapport à son sommet de juin.
La source de BAAI a comparé la vitesse de ce repli à une compression du marché baissier de 2022 sur une période plus courte.
L'objectif de Beck dans cette discussion était de chercher des éléments pour déterminer si la thèse d'investissement sous-jacente de l'IA s'était dégradée.
Il a abordé les indicateurs suivants :
Son argument n'est pas que le marché ne peut pas baisser davantage.
C'est plutôt qu'une véritable fracture technologique — comme un apprentissage continu efficace — pourrait compter davantage pour la logique de calcul à long terme que les fluctuations boursières à court terme.
La source a passé beaucoup de temps à expliquer pourquoi les remarques de Beck sur SSI ont attiré l'attention.
Beck n'est ni employé ni porte-parole officiel de SSI.
C'est un investisseur sur les marchés publics.
Il est actuellement directeur général associé et directeur des investissements d'Atreides Management, société qu'il a fondée en 2019.
Auparavant, il a travaillé chez Fidelity Investments de 1999 à 2017.
Ses fonctions là-bas comprenaient :
Son parcours de longue date dans les semi-conducteurs est particulièrement pertinent pour cette discussion, car Beck suit NVIDIA depuis plusieurs ères de l'informatique.
Ces ères comprennent :
Lors de la conférence GTC 2026 de NVIDIA, Jensen Huang a présenté publiquement Beck comme le tout premier investisseur institutionnel majeur de NVIDIA.
Cette affirmation peut être vérifiée indépendamment grâce aux enregistrements des discours d'ouverture GTC de NVIDIA.
La source a également souligné le vaste réseau de relations de Beck au sein des entreprises technologiques, des fondateurs, des investisseurs et de l'écosystème des semi-conducteurs.
Ces canaux peuvent expliquer pourquoi les acteurs du marché prennent au sérieux une remarque informelle sur SSI.
Mais cela ne signifie pas pour autant que cette déclaration équivaut à une annonce officielle de l'entreprise.
La hiérarchie correcte des preuves est la suivante :
| Source | Fiabilité concernant la date de sortie de SSI |
|---|---|
| Annonce officielle de SSI | La plus élevée |
| Déclarations directes d'Ilya Sutskever ou de la direction de SSI | Très élevée |
| Annonce conjointe NVIDIA mentionnant la sortie | Élevée si spécifique |
| Gavin Baker décrivant ce que SSI a dit | Déclaration de seconde main crédible |
| Relais des commentaires de Baker sur les réseaux sociaux | Seconde main |
| Spéculations anonymes | Faible |
Au 7 août, les éléments de preuve restent au niveau d'une « déclaration de seconde main crédible ».
Le mystère entourant SSI est l'une des raisons pour lesquelles les attentes externes sont exceptionnellement élevées.
La société a été fondée en juin 2024 par :
Sutskever avait auparavant cofondé OpenAI et occupé le poste de scientifique en chef.
SSI a initialement levé environ 1 milliard de dollars.
Un tour de financement ultérieur, signalé fin 2025, aurait permis de lever 2 milliards de dollars supplémentaires, pour une valorisation d'environ 32 milliards de dollars.
En juillet 2026, NVIDIA et SSI ont annoncé un nouveau partenariat stratégique.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Reuters a ensuite rapporté, citant des sources, que l'investissement de NVIDIA s'élevait à environ 5 milliards de dollars, bien que les deux sociétés aient seulement indiqué que l'investissement était substantiel, sans divulguer de montant financier précis dans l'annonce officielle.
Cette combinaison est inhabituelle dans le secteur :
Il en résulte que la valeur perçue de l'entreprise repose en grande partie sur la confiance accordée à son équipe de recherche et sur la possibilité que ses méthodes diffèrent substantiellement des parcours classiques des modèles de pointe.
L'annonce NVIDIA–SSI du 27 juillet offre l'un des signaux publics les plus forts que SSI estime être entrée dans une nouvelle phase.
NVIDIA a déclaré avoir conclu ce partenariat après avoir obtenu un accès rare aux recherches strictement confidentielles de SSI.
Les deux sociétés ont annoncé :
Sutskever a indiqué que SSI dispose de recherches « dignes d'être mises à l'échelle ».
Cette annonce ne révèle toujours pas :
Mais il confirme bien que SSI est passé de l'exploration pure à la mise à l'échelle d'une direction de recherche qu'elle juge prometteuse.
La plateforme Vera Rubin de NVIDIA est la prochaine architecture de calcul IA de l'entreprise.
NVIDIA indique que Rubin améliore :
Concrètement pour SSI, l'annonce officielle du partenariat précise que la combinaison de l'investissement et de l'accès à Vera Rubin augmentera la capacité de calcul de l'entreprise d'un ordre de grandeur.
C'est de là que vient l'affirmation largement répandue d'un « calcul multiplié par 10 ».
Le choix des mots est important.
NVIDIA n'a pas déclaré que SSI recevrait exactement dix fois plus de GPU.
Elle a déclaré que le partenariat
permettra d'augmenter la capacité de calcul globale de SSI d'un ordre de grandeur.
Le calendrier suscite naturellement des spéculations.
Voici la chronologie :
| Date | Événement |
|---|---|
| Juin 2024 | Création de SSI |
| 2024–2025 | SSI lève des milliards de dollars |
| 27 juillet 2026 | SSI et NVIDIA annoncent un partenariat stratégique à long terme |
| 27 juillet 2026 | NVIDIA déclare que SSI aura accès à Vera Rubin et verra sa capacité de calcul multipliée par environ 10 |
| 4 août 2026 | Les commentaires de Gavin Baker sur un modèle d'août commencent à circuler largement |
| 7 août 2026 | Aucune annonce publique de sortie de modèle par SSI |
Le partenariat avec NVIDIA pourrait soutenir une prochaine sortie de modèle ou une phase d'expansion future.
Il n'existe actuellement aucune preuve publique que cet accord matériel ait été signé spécifiquement pour soutenir une sortie en août.
La conclusion la plus solide est la suivante :
Le partenariat offre à SSI une infrastructure considérablement accrue au moment où un investisseur influent suggère que l'entreprise pourrait publier un modèle, mais le lien entre ces événements n'a pas encore été officiellement expliqué.
Ensuite, la source est passée de SSI à une observation plus large de Baker sur l'IA et les marchés financiers.
Il a comparé Claude à Walter Cronkite — ce journaliste télévisé américain influent associé à un haut niveau de confiance publique à l'ère de la radiodiffusion.
Le point de Baker n'est pas que Claude détermine réellement la vérité du marché.
Il décrit la perte potentielle de diversité dans l'analyse financière.
Un rapport de résultats complexe, un document de politique sur les semi-conducteurs ou une annonce réglementaire pouvait être interprété indépendamment par :
Ces personnes produisaient des divergences.
Des hypothèses différentes produisaient des perspectives de marché différentes.
Aujourd'hui, de nombreux acteurs du marché peuvent envoyer le même document à un petit groupe de modèles de pointe.
Ils posent des questions similaires :
Qu'est-ce que cela signifie ?
Est-ce haussier ou baissier ?
Quelles entreprises en bénéficient ?
Quels sont les effets de second ordre ?
Qu'est-ce qui a changé par rapport aux attentes ?
Si beaucoup de personnes s'appuient fortement sur le même modèle, elles peuvent obtenir des cadres d'analyse similaires et des conclusions similaires.
Cela pourrait créer une consensus médié par les modèles.
Les marchés financiers dépendent de la divergence.
Les acheteurs et les vendeurs ont des différences de :
Si une grande partie de l'analyse devient standardisée via le même système d'IA, plusieurs choses peuvent se produire :
Baker décrit cela comme un déclin de la diversité analytique.
C'est une hypothèse intéressante, et non une règle empirique démontrée sur les marchés modernes.
Il existe une autre possibilité.
Les outils d'IA peuvent
permettre à un analyste de tester plus de scénarios, d'examiner plus de documents, de traduire plus de sources et de remettre en question le consensus plus rapidement.
Les utilisateurs peuvent également comparer les sorties de modèles ou d'outils tels que :
L'IA augmentera ou diminuera la diversité du marché selon la manière dont les gens l'utilisent.
Le risque réside dans l'externalisation du jugement vers le même modèle, sans vérification indépendante.
Si SSI publie effectivement un modèle en août, les questions les plus intéressantes ne seront probablement pas les questions standard de classement.
Les gens compareront naturellement sur :
Mais la mission déclarée de SSI rend plusieurs questions plus profondes encore plus importantes.
Les commentaires de Baker ont été formulés dans le cadre d'une discussion sur l'apprentissage continu.
Cela ne prouve pas que le modèle de SSI démontrera un apprentissage continu.
Si c'est le cas, les chercheurs voudront savoir :
Si SSI a trouvé un moyen d'apprendre plus à partir de moins d'exemples, cela pourrait affecter l'économie de l'entraînement.
Des preuves solides nécessitent des évaluations transparentes, pas des anecdotes.
SSI déclare que la sécurité et les capacités doivent progresser ensemble.
Une sortie créerait une opportunité de montrer ce que cela signifie en pratique.
Les domaines possibles incluent :
SSI n'a pas encore divulgué publiquement lesquels de ces mécanismes définissent son approche.
Une API publique indiquerait une orientation produit.
Un article, une démonstration, des benchmarks ou une publication de recherche limitée signifieraient autre chose.
Tant que SSI ne s'exprime pas elle-même, l'expression « sortie de modèle » est trop vague pour répondre à cette question.
SSI est l'un des rares laboratoires de pointe dont la prémisse fondatrice est explicitement : éviter la compétition produit ordinaire jusqu'à ce que son objectif de recherche central soit prêt.
Cela fait d'une sortie plus qu'un simple test de qualité de modèle.
Cela testera plusieurs convictions qui entourent l'entreprise depuis 2024 :
Le partenariat avec NVIDIA augmente les attentes car NVIDIA déclare avoir vu les résultats de recherche de SSI avant d'y engager des capitaux importants et la prochaine génération de puissance de calcul.
Les commentaires de Baker ajoutent un calendrier possible.
Ni l'un ni l'autre ne nous disent ce qu'est réellement ce modèle.
Sutskever, Daniel Gross et Daniel Levy en 2024.
La société Safe Superintelligence publiera-t-elle un modèle en août 2026 ?
Lors d'une récente interview, Gavin Baker a indiqué que SSI prévoyait de lancer un modèle en août. À la date du 7 août 2026, SSI n'a pas encore publié d'annonce officielle sur son site Web confirmant cette date.
Si un modèle est publié, ce sera le premier modèle ou système de niveau produit de SSI à être dévoilé publiquement. Depuis sa création, l'entreprise fonctionne essentiellement de manière confidentielle et n'a pas publié de gamme de modèles classique.
Non. La mission officielle de SSI est de construire une superintelligence sûre, mais aucune information publique ne confirme que le modèle évoqué pour août a atteint ce niveau. Les capacités, l'architecture, les benchmarks et le format de diffusion de ce modèle restent inconnus.
L'apprentissage continu désigne la capacité d'un système à continuer d'apprendre en permanence à partir de nouvelles expériences au fil du temps, sans avoir à être réentraîné à plusieurs reprises depuis le début et sans oublier les compétences précédemment acquises. Un apprentissage continu fiable reste un sujet de recherche actif, en particulier pour les grands modèles déjà déployés.
Si les modèles déployés finissent par être capables d'apprendre efficacement, une partie du calcul pourrait passer d'un pré-entraînement périodique à grande échelle vers l'inférence, l'apprentissage en ligne, la simulation et le post-entraînement. Cela modifierait la composition de la demande en accélérateurs, sans nécessairement réduire la demande globale en calcul pour l'IA.
Oui. NVIDIA et SSI ont officiellement annoncé en juillet 2026 un investissement majeur et un partenariat à long terme. Reuters a rapporté que le montant de l'investissement s'élevait à environ 5 milliards de dollars, mais les deux sociétés n'ont pas divulgué ce montant dans leurs annonces officielles.
NVIDIA a indiqué que SSI aura accès à sa prochaine plateforme Vera Rubin, et que cette collaboration permettra d'accroître la puissance de calcul de SSI d'environ un ordre de grandeur. Les deux sociétés développeront également conjointement de futures plateformes de calcul.
Gavin Baker est associé gérant et directeur des investissements chez Atreides Management.
Il a auparavant travaillé chez Fidelity Investments pendant près de vingt ans. Lors de la conférence NVIDIA GTC 2026, Jensen Huang l'a présenté comme le premier investisseur institutionnel important de NVIDIA.
Gavin Baker a fourni la première indication publique crédible concernant le calendrier de lancement de Safe Superintelligence, affirmant que SSI prévoit de dévoiler un modèle en août 2026. À la date du 7 août, SSI n'a pas encore confirmé publiquement ce calendrier ; cette date doit donc toujours être considérée comme une déclaration rapportée par les médias, et non comme une annonce officielle de lancement.
Ce commentaire est important en partie en raison de son contexte. Baker s'exprimait alors sur l'apprentissage continu et l'apprentissage efficace en termes d'échantillons — des axes de recherche qui pourraient faire évoluer le calcul IA d'une prédominance du pré-entraînement à grande échelle vers des systèmes capables d'apprendre en continu après leur déploiement.
SSI vient également de conclure un partenariat stratégique majeur avec NVIDIA. Cet accord formel donne à l'entreprise accès aux systèmes Vera Rubin, avec une puissance de calcul attendue en hausse d'environ un ordre de grandeur, NVIDIA indiquant avoir décidé de ce partenariat après avoir obtenu un accès spécial aux recherches privées de SSI.
Le fait clé d'aujourd'hui n'est pas que SSI a confirmé avoir atteint la superintelligence, mais qu'un investisseur particulièrement bien connecté suggère que son premier modèle pourrait enfin être proche — et que l'entreprise dispose désormais de ressources de calcul considérablement accrues pour mettre à l'échelle ce qu'elle construit.
Partez d’une phrase et obtenez un site complet en quelques minutes.



