For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/infinihand-streaming-3d-hand-motion-from-53c55163.md.
Une caméra portée sur la tête capture la manière dont les personnes manipulent des objets, mais convertir cet enregistrement en mouvement 3D...
Une caméra portée sur la tête capture la manière dont les personnes manipulent des objets, mais convertir cet enregistrement en mouvement 3D exploitable est difficile. Les mains bougent, la caméra bouge, les doigts disparaissent derrière les objets et deux mains peuvent se masquer mutuellement.
InfiniHand combine la localisation des mains, la reconstruction détaillée des mains et l'estimation du mouvement de la caméra dans un cadre de traitement en flux continu. Son objectif est de placer les poses successives des mains dans un système de coordonnées mondial partagé, afin de rendre le mouvement plus exploitable pour l'annotation à grande échelle et de potentiels workflows d'apprentissage incarné.
Ces travaux proviennent de chercheurs affiliés au Shanghai Artificial Intelligence Laboratory, à la Shanghai Jiao Tong University et à plusieurs autres universités. La page du projet fournit des comparaisons visuelles synchronisées ainsi qu'un visualiseur de mouvement 3D.
Une image recadrée d'une main est utile pour identifier l'articulation des doigts, mais elle contient peu d'informations sur la position de la main dans la scène environnante. De même, un déplacement dans l'image peut résulter d'une main qui bouge, d'une tête qui tourne, ou des deux.
Les pipelines traditionnels combinent souvent un détecteur de mains, un estimateur de pose, un système de suivi de caméra et une étape d'alignement. Les erreurs d'une étape peuvent se propager : une main manquée modifie la reconstruction, et une trajectoire de caméra imprécise modifie le mouvement global apparent.
InfiniHand partage le contexte géométrique entre ces tâches. Un backbone LingBot-Map préentraîné extrait des caractéristiques de l'image entière, qui servent à localiser les mains gauche et droite. Le composant de reconstruction des mains combine ces caractéristiques avec des informations visuelles centrées sur les mains afin de récupérer une articulation plus fine.
Sa représentation des mains utilise les paramètres MANO pour la pose, la forme et l'orientation. Une supervision auxiliaire par repères 2D aide à contraindre la manière dont les mains 3D prédites se reprojettent dans l'image. Les estimations de caméra permettent ensuite d'exprimer les mains reconstruites dans le même repère mondial au fil du temps.
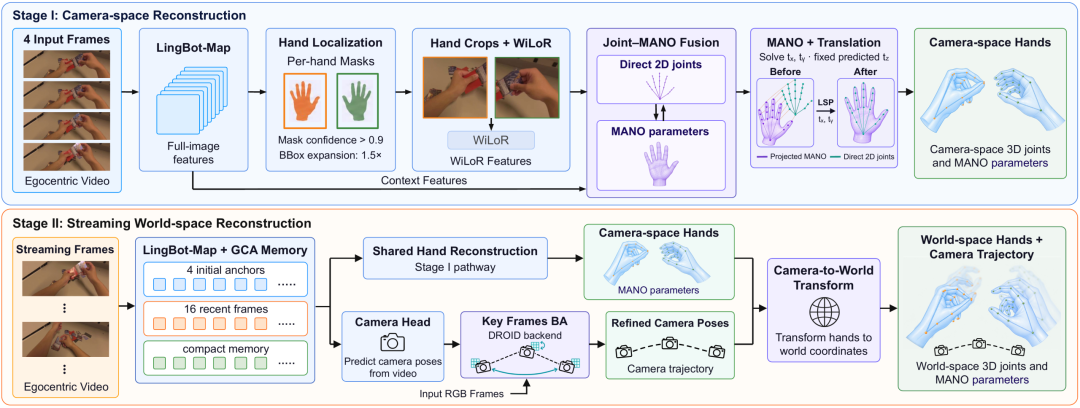
Figure de méthode InfiniHand, reproduite dans le rapport QbitAI/BAAI.
Les chercheurs ont rassemblé environ 5 000 heures de vidéos égocentriques publiques issues de neuf jeux de données, dont ARCTIC, HOT3D et EgoDex. Combiner ces sources demande davantage que de concaténer des fichiers : l'ordre des mains, les conventions de coordonnées et les types d'annotations peuvent différer.
Le pipeline de prétraitement normalise les images disponibles, les paramètres des mains, les articulations, les masques et les boîtes englobantes. Lorsque cela est possible, il ajuste les paramètres MANO manquants à partir des articulations 3D. Les séquences disposant de trajectoires de caméra peuvent aussi fournir une supervision dans l'espace mondial.
La qualité des annotations constitue une préoccupation distincte. L'équipe utilise Sapiens 2 pour prédire des repères 2D des mains et les compare aux annotations d'origine projetées dans l'image. Un désaccord persistant peut indiquer de mauvaises associations, des projections incorrectes ou des poses peu plausibles.
Selon l'article, ce processus élimine environ 30 à 40 % des données candidates d'entraînement, les cas incertains étant réservés à une inspection manuelle. La figure décrit le processus de nettoyage des candidats ; elle ne doit pas servir à déduire un total précis d'heures conservées que les auteurs ne fournissent pas ici.
L'entraînement se déroule ensuite en deux étapes :
Cette organisation permet à des jeux de données ayant une couverture d'annotation différente de contribuer aux parties du modèle qu'ils peuvent superviser.
InfiniHand traite la vidéo entrante par fenêtres tout en conservant une mémoire géométrique. Son contexte comprend des informations de référence initiales, des caractéristiques détaillées récentes et des informations compressées issues d'observations plus anciennes.
L'implémentation fait se chevaucher deux tâches de prédiction : un worker traite la fenêtre à venir dans le backbone, tandis qu'un autre décode les prédictions de mains et de caméra de la fenêtre précédente. La réutilisation des caractéristiques et la réduction des temps d'inactivité contribuent à un débit plus élevé.
L'article rapporte un débit de prédiction de 11,19 FPS, contre 5,48 FPS pour HaWoR, soit une amélioration de 2,04 fois dans la comparaison présentée. Il ne s'agit ni d'une affirmation de fonctionnement universel en temps réel à 30 FPS, ni d'une vitesse garantie sur un matériel quelconque.
Pour les séquences plus longues, un worker distinct effectue un ajustement de faisceaux clairsemé afin d'affiner la trajectoire de la caméra. Un pool binaire d'images clés conserve des observations récentes ainsi que certaines images antérieures sélectionnées. Cette optimisation en arrière-plan entraîne un coût de calcul supplémentaire au-delà du débit de prédiction rapporté.
L'évaluation dans l'espace caméra couvre 34 scènes ARCTIC, 10 scènes HOT3D, 166 scènes HOI4D et 100 scènes EgoDex. Les chercheurs comparent leur méthode à plusieurs approches de reconstruction existantes.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Le rapport met en avant PA-p, une mesure qui intègre l'erreur de pose et une pénalité pour les détections manquées. Des valeurs plus faibles sont meilleures dans la comparaison rapportée :
| Jeu de données et métrique | Méthode de comparaison | InfiniHand | Réduction rapportée |
|---|---|---|---|
| ARCTIC PA-p | ViDiHand : 9,82 mm | 7,72 mm | 21,4 % |
| EgoDex PA-p | ViDiHand : 17,22 mm | 7,29 mm | 57,7 % |
| EgoDex W-MPJPE dans l'espace mondial | Dyn-HaMR : 78,41 mm | 28,77 mm | 63,3 % |
Ces lignes concernent des jeux de données et des métriques différents ; elles ne doivent pas être moyennées pour produire une seule affirmation de précision. InfiniHand rapporte également le W-MPJPE le plus faible parmi les méthodes comparées sur ARCTIC, HOT3D et EgoDex.
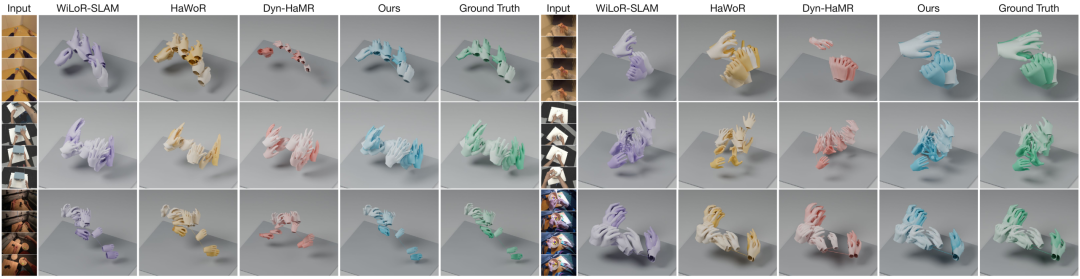
Comparaison qualitative alignée : le bleu représente InfiniHand et le vert la référence. L'alignement fait partie de la visualisation et doit être pris en compte lors de l'interprétation de la concordance apparente.
La source présente aussi des exemples Ego4D en scènes naturelles impliquant de l'occlusion et des interactions avec des objets. Une comparaison hors ligne illustrée utilise une localisation externe des mains pour InfiniHand. Les lecteurs doivent distinguer cette configuration des affirmations de localisation du modèle unifié ; les démos interactives du projet fournissent le contexte visuel pertinent.
La récupération de démonstrations humaines en 3D peut aider à préparer des données pour la manipulation dextre, le transfert de mouvement et la recherche sur l'apprentissage par imitation. Convertir des mains reconstruites en données d'entraînement pour robots exige néanmoins des contrôles qualité et une adaptation à la structure physique du robot.
Les auteurs identifient plusieurs limites. LingBot-Map ne récupère pas intrinsèquement l'échelle métrique ; un modèle d'alignement auxiliaire est donc nécessaire et peut introduire des erreurs. Les changements de point de vue rapides, les occlusions sévères et la visibilité intermittente des mains restent difficiles, car les données d'entraînement appropriées sont limitées.
La supervision monoculaire peut également introduire dans l'entraînement une dérive d'échelle variant dans le temps. Le raffinement clairsemé aide, mais il ne transforme pas chaque trajectoire récupérée en mesure physique exacte.
Il estime les emplacements des mains, les paramètres MANO des mains et les trajectoires de caméra à partir de vidéo égocentrique. Ces estimations permettent de représenter le mouvement des mains dans un système de coordonnées mondial partagé.
Le mouvement des mains dans l'espace caméra varie avec le mouvement de la caméra. Un repère mondial partagé facilite la comparaison des trajectoires des mains entre les images tout en tenant compte du déplacement du point de vue.
Le cadre proposé inclut son propre composant de localisation. Toutefois, la source identifie un exemple qualitatif hors ligne utilisant une localisation externe des mains ; les lecteurs doivent donc vérifier la configuration de chaque comparaison affichée.
Non. Il s'agit du débit de prédiction dans l'évaluation rapportée par les auteurs. L'ajustement de faisceaux clairsemé en arrière-plan implique un travail supplémentaire, et les performances dépendent de la configuration d'exécution.
Les chercheurs comparent les annotations projetées avec des prédictions de repères 2D des mains basées sur l'image et rejettent les séquences présentant des incohérences persistantes. Ils indiquent avoir supprimé environ 30 à 40 % des données candidates et réservé les cas ambigus à des vérifications manuelles.
L'article présente des recherches sur la reconstruction et l'annotation, et non un système validé de contrôle direct de robot. Une utilisation robotique nécessiterait un retargeting, des contraintes physiques et une vérification spécifique à la tâche.
InfiniHand combine la géométrie de la scène, l'apparence détaillée des mains et l'estimation de la caméra afin de récupérer le mouvement des mains à partir de vidéo à la première personne. Sa conception en flux continu et son pipeline de nettoyage des données ciblent le défi pratique de l'annotation de vastes collections vidéo.
Les améliorations de précision et de débit rapportées constituent des résultats de recherche prometteurs, avec des conditions importantes liées à la récupération d'échelle et au raffinement en arrière-plan. La sortie est une estimation de reconstruction utile qui nécessite encore une validation pour les tâches physiques en aval.
Partez d’une phrase et obtenez un site complet en quelques minutes.
