For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/jev-decision-model-typesafe-ai-870m-serie-7b7d7513.md.
En quelques semaines seulement, TypeSafe AI est passée d’une relative obscurité à l’une des start-up d’infrastructure les plus surveillées d...
En quelques semaines seulement, TypeSafe AI est passée d’une relative obscurité à l’une des start-up d’infrastructure les plus surveillées du secteur de l’IA.
L’entreprise vient d’annoncer une série A de 870 millions de dollars, pour une valorisation post-money de 7,5 milliards de dollars.
Ce serait remarquable dans n’importe quelles circonstances. Ce qui rend cette histoire inhabituelle, c’est le produit à l’origine de cette dynamique : Jev, un modèle qui ne cherche pas à être un chatbot, qui ne génère pas de longs textes et qui n’est pas principalement conçu pour écrire du code.
Sa mission est beaucoup plus ciblée.
Il prend des décisions.
Une requête Jev typique ressemble davantage à :
À partir de cet état,
quelle option le logiciel doit-il choisir ?
qu’à :
Veuillez me rédiger une explication détaillée.
TypeSafe présente Jev comme un modèle System One : un modèle conçu pour prendre rapidement des décisions structurées et limitées que les logiciels peuvent utiliser directement.
Au lieu de texte libre, Jev renvoie notamment :
Cette spécialisation permet à Jev d’être suffisamment peu coûteux et rapide pour fonctionner dans des workflows logiciels à fort volume, là où un grand modèle de langage généraliste de pointe serait inutilement lent ou coûteux.
Et la réaction du marché a été spectaculaire.
TypeSafe AI a été fondée en 2024 à San Francisco.
Avant le lancement de Jev, l’entreprise avait passé environ deux ans en mode furtif.
Son émergence publique a eu lieu le 15 septembre 2026, lorsque TypeSafe a présenté son premier modèle System One et expliqué l’approche d’entraînement utilisée : le Reinforcement Learning for Calibrated Decisions, ou RLCD.
La source originale indique que TypeSafe avait précédemment annoncé une levée de fonds d’amorçage de 40 millions de dollars autour du lancement de Jev. Moins d’un mois plus tard, l’entreprise a annoncé une série A beaucoup plus importante.
La publication officielle de TypeSafe confirme les éléments suivants :
| Élément | Détail confirmé |
|---|---|
| Série A | 870 millions de dollars |
| Valorisation post-money | 7,5 milliards de dollars |
| Investisseur principal | Andreessen Horowitz |
| Autres participants cités | Sequoia Capital, DCVC, investisseurs providentiels |
| Nouveau membre du conseil | Martin Casado |
L’entreprise indique qu’elle utilisera ces nouveaux capitaux pour :
L’élément important est que les investisseurs ne misent pas uniquement sur un nouveau modèle généraliste de pointe.
Ils misent sur une autre catégorie de modèles.
L’idée centrale de Jev est simple : de nombreux systèmes logiciels n’ont pas besoin de paragraphes.
Ils ont besoin d’une décision.
Exemples :
Les LLM traditionnels peuvent répondre à ces questions, mais ils le font généralement au moyen d’une génération de texte autorégressive.
TypeSafe considère cette approche comme inefficace lorsque l’application connaît déjà la forme attendue de la réponse.
La conception de Jev ressemble plutôt à ceci :
État structuré
      ↓
Questions typées
      ↓
Calcul de décision parallèle
      ↓
Probabilités + sorties limitées
      ↓
L’application suit une branche selon le résultat
TypeSafe décrit cette approche comme une intelligence « native pour les machines » : le modèle est optimisé pour être intégré au code plutôt que pour produire du langage destiné à être lu par un humain.
TypeSafe affiche actuellement Jev aux tarifs suivants :
Entrée : 0,042 $ / 1 million de tokens
Sortie : gratuite / non facturée
Ce tarif est très inférieur à celui de la plupart des modèles généralistes de pointe.
La raison est architecturale.
Jev ne génère pas du texte arbitraire token par token. TypeSafe indique que son échantillonneur renvoie en parallèle les sorties limitées correspondant à une décision.
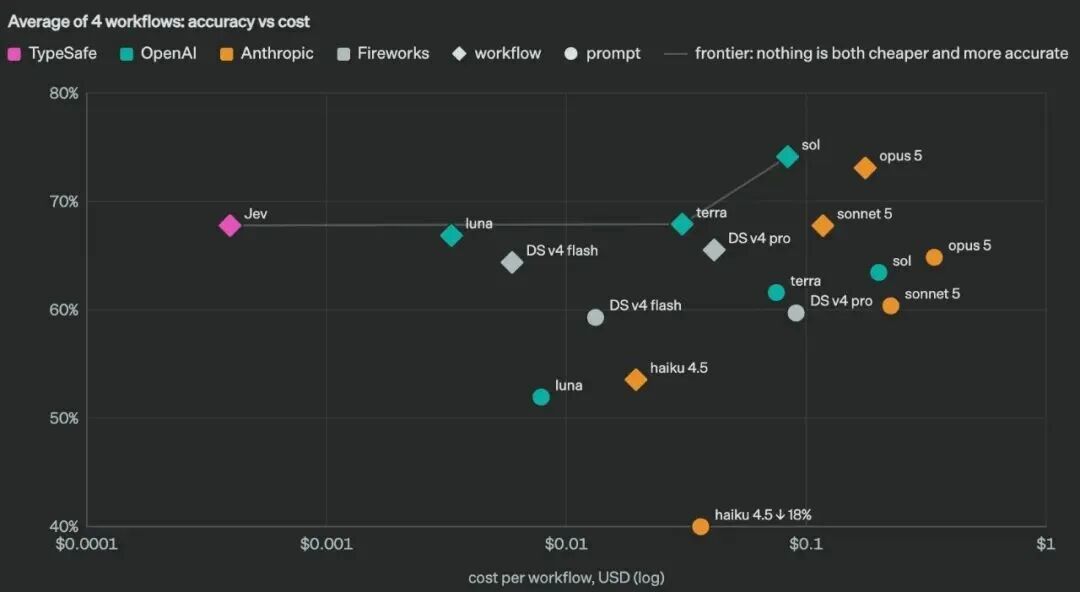
L’entreprise revendique une latence de bout en bout comprise approximativement entre 70 et 500 ms pour son service et affirme que Jev peut être 40 à 200 fois plus rapide pour des workloads comparables de type System One.
Ces chiffres proviennent de l’évaluation publiée par TypeSafe et doivent être considérés comme des affirmations du fournisseur pour le type de tâches auquel Jev est destiné.
L’une des affirmations les plus fortes de TypeSafe est que Jev ne produit pas d’erreurs de type.
Cette affirmation doit être interprétée avec précision.
Cela signifie que si l’application déclare un schéma de sortie limité, Jev renvoie une valeur conforme à ce contrat de sortie.
Par exemple :
Réponse autorisée :
- approuver
- examiner
- rejeter
Jev ne devrait pas soudainement renvoyer :
Voici un essai de cinq paragraphes expliquant mon raisonnement...
Il s’agit d’une propriété de fiabilité importante pour les logiciels de production.
Mais la sécurité de type ne signifie pas que la décision sémantique est toujours correcte.
Un modèle peut renvoyer une valeur valide rejeter tout en prenant la mauvaise décision métier.
C’est pourquoi Jev renvoie également des probabilités et des informations de confiance, ce qui permet à l’application de définir des seuils tels que :
confiance >= 0,95
→ automatiser

0,70 <= confiance < 0,95
→ contrôle secondaire

confiance < 0,70
→ examen humain
L’utilité du modèle dépend donc à la fois de la qualité de la classification et de son calibrage.
Le signal d’adoption indépendant le plus fort de l’article original provient de Vercel.
Vercel a ajouté Jev à AI Gateway peu après son lancement et a suivi la vitesse à laquelle les équipes payantes ont commencé à l’utiliser.
Selon Vercel, Jev a atteint près de 13 % des équipes payantes en 24 heures.
C’était plus de deux fois la portée de tout lancement de modèle précédent dans l’histoire d’AI Gateway à ce moment-là.
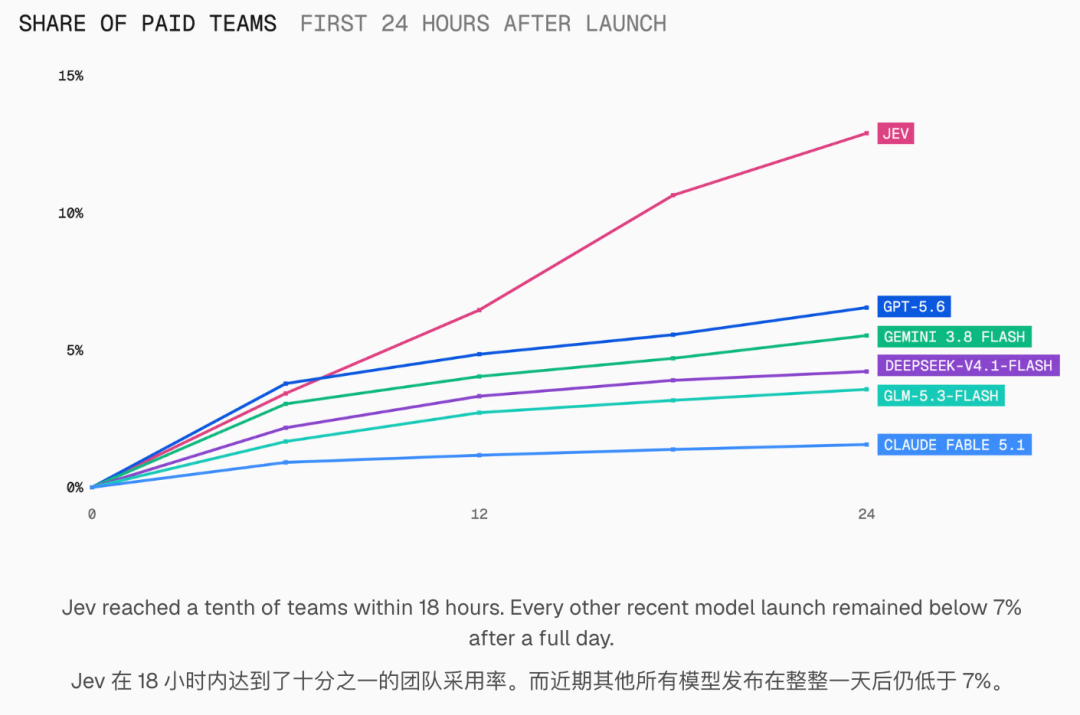
Vercel a également indiqué que Jev avait dépassé chacun des modèles de comparaison au cours de ses 12 premières heures et continuait d’accroître son avance le premier jour.
Cela importe parce que l’utilisation de Jev est différente de l’adoption occasionnelle d’un chatbot.
Un humain peut essayer un nouveau chatbot quelques fois, puis arrêter.
Un modèle intégré à un logiciel peut continuer à recevoir des requêtes en permanence.
Cela crée un modèle d’utilisation très différent :
Chatbot utilisé par un humain :
l’utilisateur ouvre l’application
→ envoie un message
→ attend
→ ferme l’application

Modèle de décision intégré à un logiciel :
une requête arrive
→ le modèle de décision s’exécute
→ l’application suit une branche
→ le cycle se répète toute la journée
L’article source résume cette idée par une observation simple :
Les humains dorment. Le code, lui, ne dort pas.
L’article original cite également TypeSafe et des investisseurs affirmant que Jev a atteint environ un billion de tokens traités en trois jours après son lancement.
TypeSafe a ensuite décrit le trafic comme soutenu plutôt que comme un pic ponctuel.
La publication de la série A de l’entreprise indique désormais qu’environ un tiers des entreprises du Fortune 500 utilisent ou intègrent Jev et affirme que les clients ont déjà économisé des millions de dollars en coûts de production.
Il s’agit de métriques commerciales propres à TypeSafe et non de chiffres audités de manière indépendante, mais elles permettent de comprendre pourquoi les investisseurs ont considéré Jev comme davantage qu’une démonstration virale destinée aux développeurs.
Le modèle d’utilisation suggère une demande de machine à machine.
Une fois intégré à :
Jev peut être appelé chaque fois que le logiciel environnant atteint cette branche.
C’est précisément le workload pour lequel TypeSafe l’a conçu.
L’histoire des origines de Jev est particulièrement symétrique.
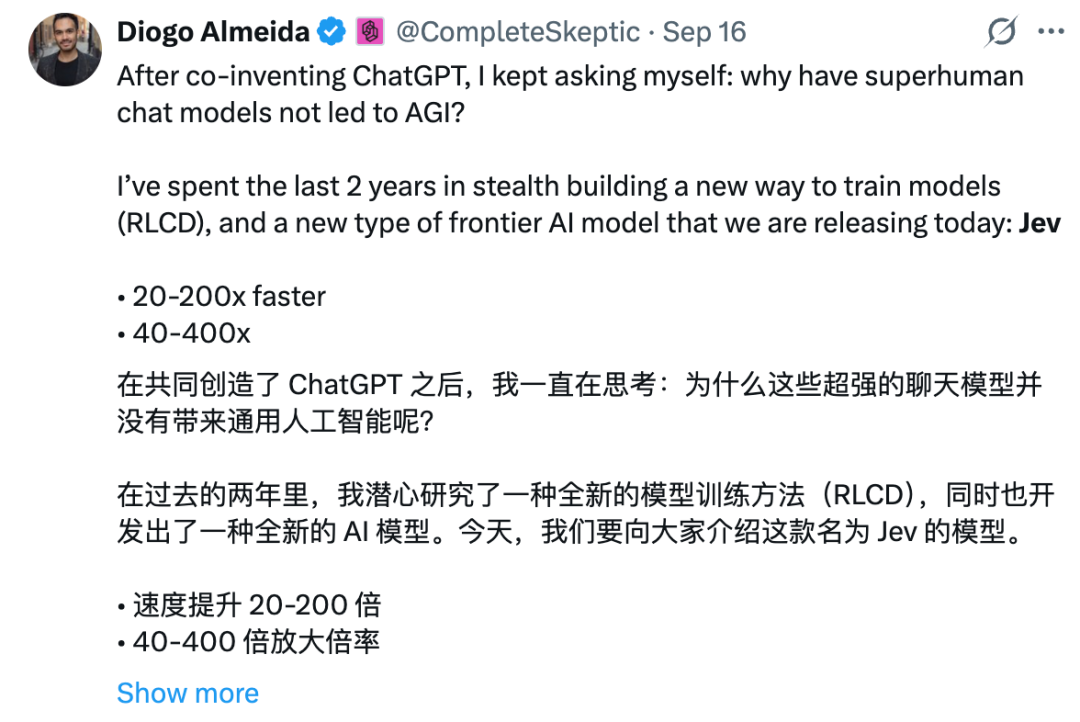
Le cofondateur et PDG de TypeSafe, Diogo Almeida, a précédemment travaillé chez Google Brain et OpenAI.
La page officielle de l’équipe TypeSafe le présente comme le co-inventeur de RLHF et d’InstructGPT, des travaux qui ont contribué à ChatGPT et GPT-4.
Chez OpenAI, Almeida a travaillé sur les méthodes qui ont contribué à transformer des modèles de langage bruts en systèmes capables de suivre des instructions et d’interagir naturellement avec les utilisateurs.
Après avoir quitté OpenAI, il est devenu de plus en plus sceptique quant à l’idée que le dialogue devrait être l’interface par défaut de l’intelligence intégrée aux logiciels.
Il a résumé cette évolution dans la publication de lancement de Jev de TypeSafe : si les modèles étaient devenus extrêmement performants dans la conversation, pourquoi l’automatisation n’avait-elle pas progressé au même rythme ?
Un chatbot est optimisé pour la flexibilité.
Cette flexibilité est précieuse lorsqu’un humain lit la sortie.
Mais les logiciels de production veulent souvent l’inverse :
La position de TypeSafe est que la génération de langage généraliste constitue souvent une abstraction inutilement puissante pour ces tâches.
Au lieu de demander à un modèle de pointe de rédiger une réponse structurée, puis de valider le texte, Jev est conçu pour prendre directement la décision limitée.
Le slogan de l’entreprise résume cette philosophie :
Construire pour la production, pas pour Dieu.
La formulation est volontairement provocatrice, mais l’idée sous-jacente est pratique : optimiser des logiciels qui fonctionnent de manière fiable en production plutôt que de considérer chaque produit d’IA comme une étape vers un modèle universel.
TypeSafe appelle sa méthode d’entraînement Reinforcement Learning for Calibrated Decisions (RLCD).
L’entreprise la compare à deux approches familières :
| Orientation de l’entraînement | Objectif d’optimisation principal |
|---|---|
| RLHF | Réponses préférées par les humains |
| RLVR | Résultats de raisonnement vérifiables |
| RLCD | Décisions structurées et calibrées |
Dans le cas de Jev, le calibrage est central.
Si un modèle indique 0,90, l’objectif est que les événements recevant approximativement ce niveau de confiance soient effectivement corrects environ 90 % du temps sur une distribution d’évaluation appropriée.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Cela est beaucoup plus utile pour concevoir des workflows automatisés qu’une simple étiquette non calibrée.
Une application peut alors transformer l’incertitude du modèle en politique :
confiance élevée
→ automatiser

confiance moyenne
→ interroger un autre modèle ou appliquer davantage de règles

confiance faible
→ transmettre à une personne
C’est l’une des raisons pour lesquelles les modèles de décision sont intéressants pour les systèmes à fort volume.
Ils ne suppriment pas l’incertitude.
Ils la rendent plus facile à exploiter par les logiciels.
L’article original souligne également le scepticisme d’Almeida à l’égard de la compétition fondée sur les benchmarks publics.
TypeSafe publie bien des évaluations, mais ses supports de lancement consacrent une place inhabituelle à la documentation des réserves méthodologiques.
Par exemple, l’entreprise précise explicitement que :
Cette distinction est utile.
TypeSafe commercialise toujours son modèle de manière offensive, mais ne prétend pas que Jev devrait remplacer partout les LLM de pointe.
Sa propre documentation positionne les produits différemment :
LLM génératif
→ écrire, raisonner, expliquer, coder, converser

Modèle de décision
→ classifier, orienter, noter, vérifier, contrôler, prioriser
Les deux peuvent fonctionner ensemble au sein d’un même système.
La direction de TypeSafe ne se limite pas à Almeida.
La page officielle de l’équipe mentionne :
L’équipe élargie comprend des personnes issues d’entreprises telles qu’OpenAI, Google Brain, Meta/FAIR, Stripe, Airbnb, Plaid et Docker.
Ce parcours aide à expliquer l’accent mis sur le produit.
Jev vise moins à créer une nouvelle interface grand public qu’à fournir un outil que les développeurs peuvent enfouir profondément dans l’infrastructure.
L’adoption rapide de Jev a également eu un second effet.
Elle a validé la catégorie suffisamment vite pour que de grandes entreprises d’infrastructure et de modèles commencent à lancer des produits concurrents en quelques semaines.
L’article original s’achève précisément sur cette évolution.
Microsoft a annoncé Microsoft-Decision-1, un modèle conçu spécifiquement pour l’évaluation structurée des décisions.
Le modèle est basé sur Qwen3.5-9B et est disponible en préversion publique dans Microsoft Foundry.
Il prend en charge des tâches telles que :
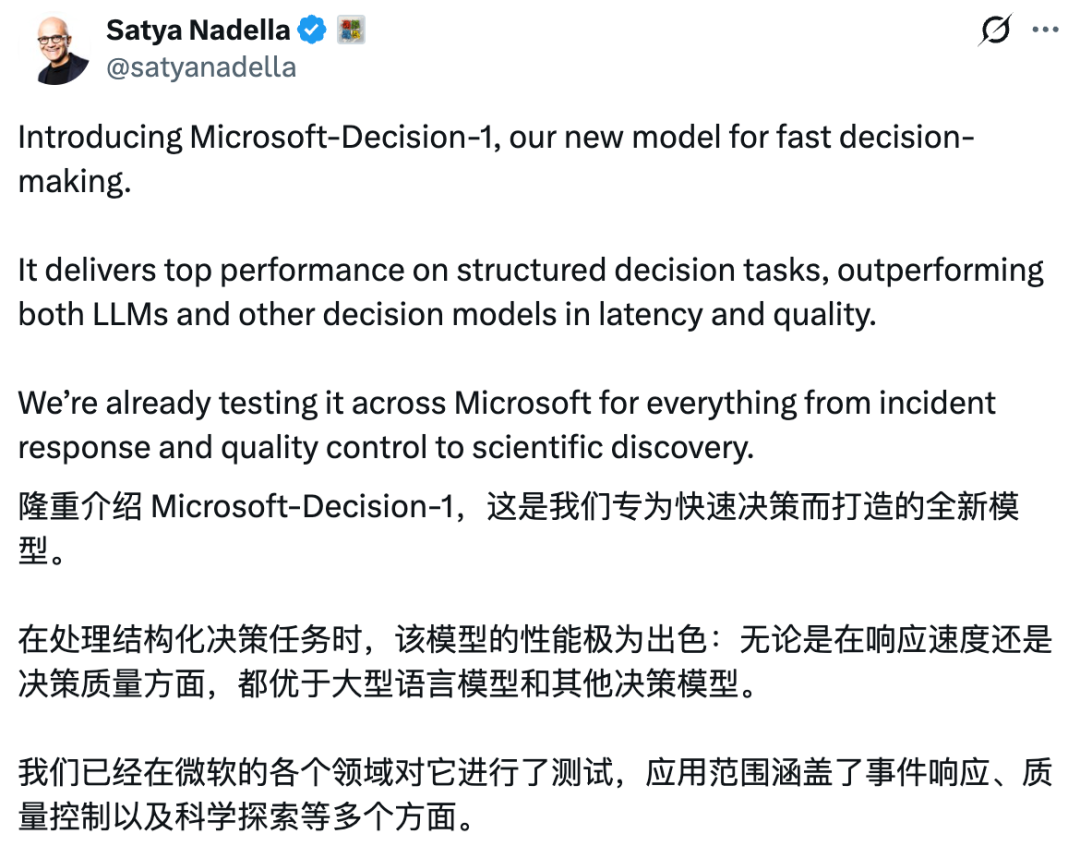
Lorsqu’un ensemble fixe d’options lui est fourni, Microsoft-Decision-1 renvoie des scores de probabilité calibrés pour ces options.
Microsoft indique que le modèle a obtenu la meilleure précision dans sa comparaison de 36 benchmarks portant sur près de 150 000 questions et affirme qu’il était nettement plus rapide que GPT-6 Sol dans son évaluation interne.
Ces chiffres proviennent des propres benchmarks de Microsoft. Les développeurs doivent donc valider le modèle sur leurs propres workloads avant de les considérer comme des classements de performance universels.
OpenAI a évolué dans la même direction avec son API Decisions, publiée en bêta publique le 6 octobre 2026.
L’API est alimentée par GPT-6 Luna et accepte du texte, des images ou les deux.
Elle prend en charge trois types de questions structurées :
| Type | Résultat |
|---|---|
| Prédicat | Probabilité qu’une condition soit vraie |
| Choix | Une sélection parmi les options fournies, accompagnée de probabilités |
| Score | Score pondéré par les probabilités sur des niveaux ordonnés |
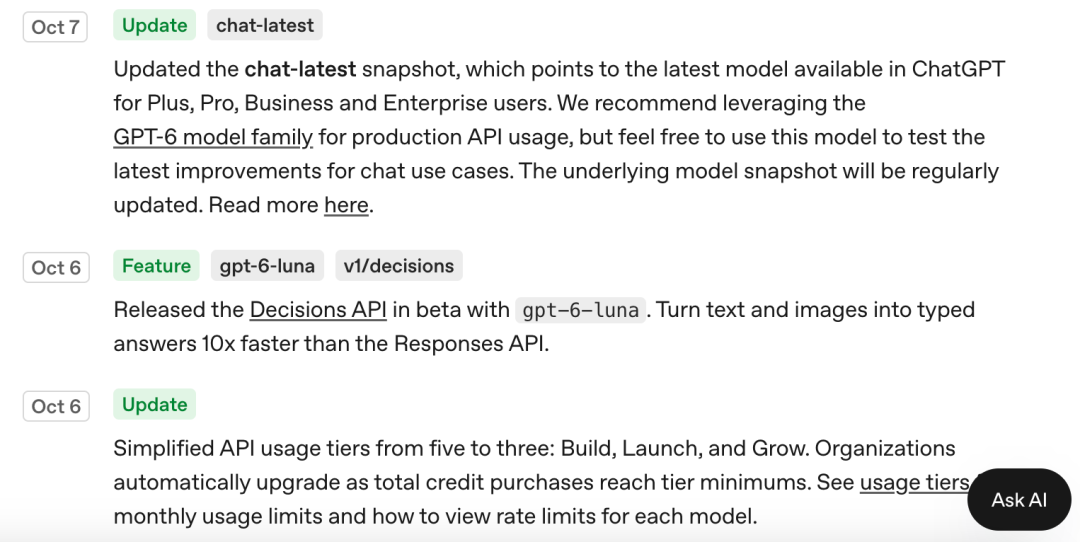
OpenAI affirme que l’API dédiée peut renvoyer des décisions environ 10 fois plus rapidement que GPT-6 Luna via l’API Responses pour le type de tâches concerné.
Sa tarification bêta est particulièrement simple :
Entrée : 0,10 $ / 1 million de tokens
Sortie : aucun coût de tokens de sortie
Lecture du cache : aucun coût
Écriture dans le cache : aucun coût
La principale différence avec Jev est architecturale.
Jev est la famille de modèles System One conçue spécifiquement par TypeSafe.
L’API Decisions d’OpenAI expose au contraire une interface de décision spécialisée autour de GPT-6 Luna.
Du point de vue d’un développeur d’applications, les deux répondent toutefois à un besoin similaire :
état en entrée
→ décision typée et limitée en sortie
Cloudflare est entré encore plus tôt dans la course en annonçant Clef et Clef-flash le 1er octobre.
Tous deux sont des modèles de décision disponibles sur Workers AI, et Cloudflare a également publié leurs poids sous licence Apache 2.0.
Ils suivent une forme d’API compatible avec Jev, ce qui facilite leur remplacement dans des workflows conçus autour de requêtes de décision de type System One.
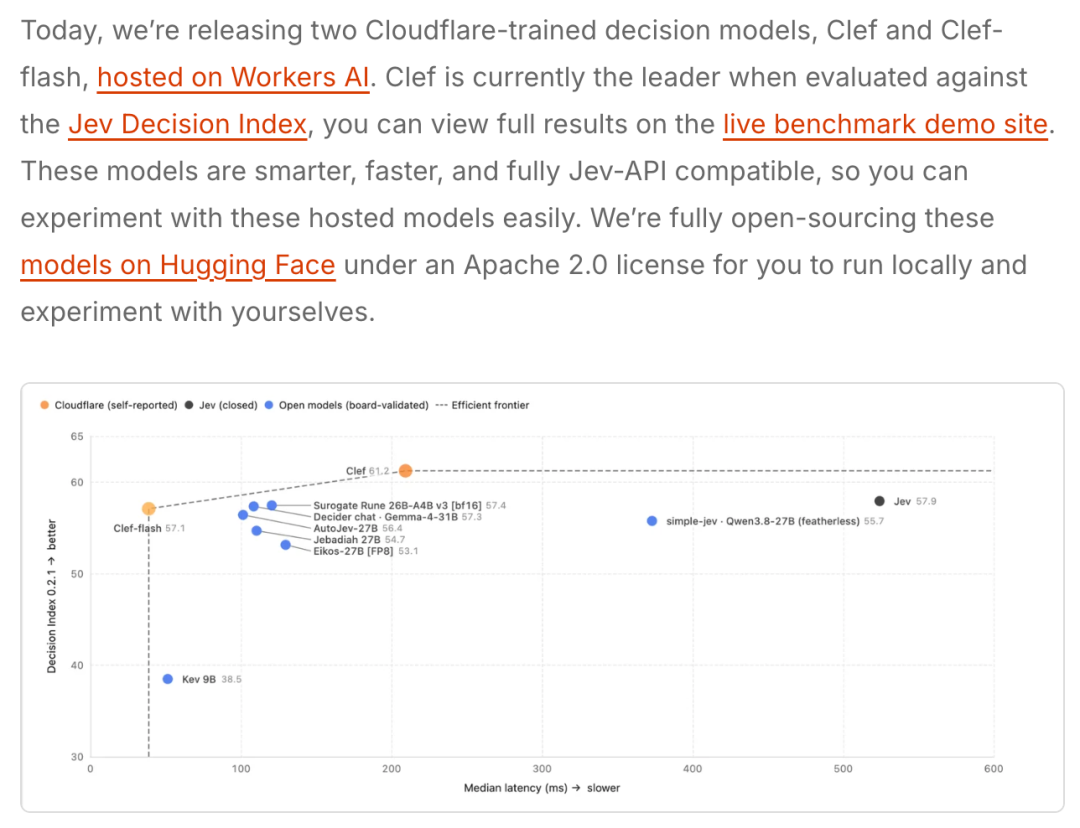
Cloudflare publie les informations suivantes :
| Modèle | Taille | Contexte | Orientation prévue |
|---|---|---|---|
| Clef | 27B | 64K | Qualité de décision supérieure |
| Clef-flash | 9B | 64K | Très faible latence |
Dans sa propre suite de tests, Cloudflare indique que Clef ou Clef-flash sont arrivés en tête de 7 des 10 benchmarks de décision mis en avant, tandis que Jev restait plus performant sur certaines tâches individuelles telles que When2Call et BRIGHT.
Cloudflare a également rapporté les latences médianes suivantes :
Clef :       209,3 ms
Clef-flash : 38,8 ms
Jev :        524,1 ms
Là encore, ces chiffres proviennent de l’environnement d’évaluation de Cloudflare.
Ils constituent un indicateur concurrentiel utile, mais ne garantissent pas une latence universelle pour chaque déploiement.
Le point central de l’article source n’est pas seulement que Jev a levé une somme considérable.
C’est qu’une catégorie de modèles est passée de l’inhabituel à la saturation concurrentielle presque immédiatement.
En quelques semaines, le marché comptait :
Chaque implémentation est différente, mais elles partagent une même intuition :
Toutes les requêtes d’IA n’ont pas besoin de texte génératif.
De nombreuses tâches de production ressemblent davantage à des instructions if intelligentes.
Par exemple :
si probabilité_de_fraude > 0,98 :
    bloquer()
sinon si probabilité_de_fraude > 0,70 :
    examiner()
sinon :
    autoriser()
La difficulté n’est pas d’écrire la branche.
Elle consiste à produire une probabilité utile et calibrée à partir d’un contexte réel désordonné.
Les modèles de décision cherchent à rendre cette capacité suffisamment peu coûteuse pour être exécutée partout.
À première vue, les modèles de décision spécialisés semblent représenter une menace pour les LLM généralistes.
En pratique, ils pourraient augmenter la consommation totale d’IA.
Un agent généraliste peut utiliser un modèle de décision pour les points de contrôle fréquents :
Requête utilisateur
→ le modèle de décision choisit la route
→ le LLM ne prend en charge le raisonnement complexe que lorsque cela est nécessaire
→ le modèle de décision évalue la sortie
→ le workflow continue ou est transmis à un humain
Cela permet aux développeurs de réserver le raisonnement coûteux aux éléments qui en ont réellement besoin.
Tout le reste peut être traité par des modèles limités moins chers.
Le résultat pourrait être un plus grand nombre d’appels à l’IA, et non moins.
Cette idée est cohérente avec le nom Jev, qui fait référence, selon TypeSafe, à l’économiste William Stanley Jevons et au paradoxe de Jevons : l’amélioration de l’efficacité peut augmenter la consommation totale parce que la baisse des coûts ouvre de nouveaux cas d’usage.
Dans l’infrastructure d’IA, cette logique pourrait se présenter ainsi :
décisions moins coûteuses
→ davantage de décisions deviennent économiquement viables
→ davantage de logiciels bénéficient de points de contrôle par l’IA
→ l’usage total de l’intelligence machine augmente
Jev est le premier modèle System One de TypeSafe AI, conçu pour prendre rapidement des décisions structurées plutôt que pour générer du texte libre. Il reçoit l’état de l’application ainsi que des questions typées et renvoie des réponses limitées accompagnées de probabilités et d’informations de confiance.
TypeSafe affiche actuellement Jev à 0,042 dollar par million de tokens d’entrée et ne facture pas les tokens de sortie. Ce tarif s’applique à l’interface de décision structurée de Jev, et non à un modèle généraliste de génération de texte.
L’affirmation formelle la plus forte de TypeSafe concerne la sécurité de type des sorties : un schéma limité empêche le modèle d’émettre une sortie arbitraire ou malformée. Cela ne signifie pas que chaque décision sémantique est correcte, d’où l’importance du calibrage, des seuils, de l’évaluation et de l’examen humain.
Vercel indique que près de 13 % des équipes payantes ont utilisé Jev dans les 24 heures suivant son lancement sur AI Gateway. Vercel l’a décrit comme le modèle adopté le plus rapidement dans l’histoire d’AI Gateway à ce moment-là.
L’API Decisions est un endpoint OpenAI en bêta publique alimenté par GPT-6 Luna. Elle accepte des éléments de preuve textuels et visuels et renvoie des probabilités de prédicat, des choix ou des scores. OpenAI affirme une latence environ 10 fois inférieure à celle de GPT-6 Luna utilisé via l’API Responses pour ces tâches de décision.
Microsoft-Decision-1 est un modèle de décision structurée disponible en préversion publique dans Microsoft Foundry. Il est basé sur Qwen3.5-9B et conçu pour la classification, l’orientation, le classement, l’évaluation, la vérification et le contrôle des workflows.
Cloudflare présente Clef et Clef-flash comme des modèles de décision open source ou à poids ouverts et les a publiés sous licence Apache 2.0. Ils sont également hébergés via Workers AI et utilisent un style d’API System One compatible avec Jev.
En général, non. Les modèles de décision sont particulièrement adaptés aux décisions limitées et à fort volume, tandis que les LLM généralistes restent plus performants pour la génération, l’explication, le raisonnement complexe et l’utilisation ouverte d’outils. De nombreux systèmes de production utiliseront les deux.
La série A de 870 millions de dollars de TypeSafe AI est importante parce qu’elle valide plus qu’une seule start-up. Elle valide une catégorie de modèles : des systèmes de décision rapides, limités et lisibles par les machines, conçus pour s’intégrer au cœur des logiciels de production.
L’adoption rapide de Jev sur Vercel, son faible prix d’entrée, ses sorties structurées et sa conception centrée sur le calibrage expliquent pourquoi les développeurs s’y intéressent. Cependant, ses affirmations de performance les plus fortes doivent encore être lues dans leur contexte : certaines proviennent directement de TypeSafe, tandis que Vercel, Cloudflare, Microsoft et OpenAI publient leurs propres mesures dans des conditions différentes.
Le signal de marché le plus important est la rapidité avec laquelle les concurrents ont suivi. En l’espace de quelques semaines, Microsoft, OpenAI et Cloudflare proposaient tous des produits visant le même problème fondamental.
La plus grande réussite de Jev n’est peut-être ni un benchmark ni une levée de fonds : c’est peut-être d’avoir démontré qu’une grande partie de l’IA de production n’a pas besoin de parler.
Partez d’une phrase et obtenez un site complet en quelques minutes.